
Toiminnot R-ohjelmoinnissa esimerkin avulla
 Toimituksellinen tiimi
⚡ Älykäs yhteenveto
R-funktiot pakkaavat joukon ohjeita yhden nimen alle, joten toistuva tehtävä suoritetaan yhdellä kutsulla. Sisäänrakennetut matematiikka- ja tilastoapuohjelmat, käyttäjän määrittämät funktiot, ympäristön scoping, ja ehdollisia argumentteja käsitellään tässä esimerkkien avulla.
Mikä on funktio R:ssä?
A toiminto, ohjelmointiympäristössä, on joukko ohjeita. Ohjelmoija rakentaa funktion, jota vältetään saman tehtävän toistaminentai vähentää monimutkaisuus.
Toiminnon pitäisi olla
- kirjoitettu tietyn tehtävän suorittamiseksi
- voi sisältää argumentteja tai ei
- sisältää ruumiin
- voi palauttaa tai olla palauttamatta yhden tai useamman arvon.
Yleinen lähestymistapa funktioon on käyttää argumenttiosaa as tuloa, Ruoki elin osa ja lopuksi palauta an ulostulo. Funktion syntaksi on seuraava:
function (arglist)  {
  #Function body
}
R tärkeitä sisäänrakennettuja toimintoja
R:ssä on paljon sisäänrakennettuja toimintoja. R sovittaa syöteparametrisi funktion argumentteineen joko arvon tai sijainnin mukaan ja suorittaa sitten funktion rungon. Funktioargumenteilla voi olla oletusarvoja: jos et määritä näitä argumentteja, R ottaa oletusarvon.
Huomautuksia:
On mahdollista nähdä funktion lähdekoodi ajamalla itse funktion nimi konsolissa.
Typing Hakasulkeista riippumaton funktion nimi tulostaa lähdekoodin, kuten alla oleva konsoli osoittaa.

Näemme kolme toimintoryhmää toiminnassa
- Yleinen toiminto
- Matemaattinen funktio
- Tilastollinen funktio
Yleiset toiminnot
Tunnemme jo yleiset funktiot, kuten cbind(), rbind() ja range(), järjestellä(), ja order(). Jokaisella näistä funktioista on tietty tehtävä, ja ne ottavat argumentteja tulosteen palauttamiseksi. Seuraavat ovat tärkeitä funktioita, jotka on tiedettävä -
diff()-funktio
Jos työskentelet Aikasarja, sinun on pysäytettävä sarja ottamalla niiden viivearvot. kiinteä prosessi sallii vakion keskiarvon, varianssin ja autokorrelaation ajan kuluessa. Tämä parantaa pääasiassa aikasarjan ennustamista. Tämä voidaan tehdä diff()-funktiolla. Voimme rakentaa satunnaisen aikasarjadatan trendillä ja käyttää sitten diff()-funktiota sarjan stationoimiseen. Diff()-funktio hyväksyy yhden argumentin, vektorin, ja palauttaa sopivan viiveellä lasketun ja iteroidun erotuksen.
HuomautuksiaMeidän on usein luotava satunnaista dataa, mutta oppimisen ja vertailun vuoksi haluamme lukujen olevan identtisiä eri koneilla. Jotta voimme varmistaa, että kaikki tuottavat saman datan, käytämme set.seed()-funktiota mielivaltaisilla arvoilla 123. set.seed() määrittää pseudo-satunnaislukugeneraattorin lähtöpisteen, joten jokainen kone tuottaa saman sekvenssin. Ilman set.seed()-funktiota jokainen suoritus palauttaa eri sekvenssin.
set.seed(123)
## Create the data
x = rnorm(1000)
ts <- cumsum(x)
## Stationary the serie
diff_ts <- diff(ts)
par(mfrow=c(1,2))
## Plot the series
plot(ts, type='l')
plot(diff(ts), type='l')
Kahdessa alla olevassa paneelissa alkuperäinen kumulatiivinen aikasarja on sijoitettu erotusaikasarjan viereen, joka nyt vaihtelee vakion keskiarvon ympärillä.

pituus()-funktio
Monissa tapauksissa haluamme tietää vektorin pituuden laskentaa varten tai for-silmukassa käytettäväksi. length()-funktio laskee rivien lukumäärän vektorissa x. Seuraavat koodit tuovat cars-tietojoukon ja palauttavat rivien lukumäärän.
Huomautuksia: length() palauttaa vektorin elementtien lukumäärän. Jos funktio annetaan matriisi tai datakehyksen, palautetaan sarakkeiden lukumäärä.
dt <- cars
## number columns
length(dt)
lähtö:
## [1] 1
## number rows
length(dt[,1])
lähtö:
## [1] 50
Matemaattiset toiminnot
Yleisten apufunktioiden lisäksi R:ssä on joukko matemaattisia funktioita, jotka suorittavat vektorin toimintoja elementti elementiltä.
| OperaTor | Tuotetiedot |
|---|---|
| abs (x) | Ottaa x:n itseisarvon |
| loki(x,kanta=y) | Ottaa x:n logaritmin kantaluvulla y; jos kantaa ei ole määritetty, palauttaa luonnollisen logaritmin |
| exp (x) | Palauttaa x:n eksponentiaalin |
| sqrt (x) | Palauttaa x:n neliöjuuren |
| tekijä(x) | Palauttaa x:n kertoimen (x!) |
# sequence of number from 44 to 55 both including incremented by 1
x_vector <- seq(45,55, by = 1)
#logarithm
log(x_vector)
lähtö:
##  [1] 3.806662 3.828641 3.850148 3.871201 3.891820 3.912023 3.931826
##  [8] 3.951244 3.970292 3.988984 4.007333
#exponential
exp(x_vector)
#squared root
sqrt(x_vector)
lähtö:
##  [1] 6.708204 6.782330 6.855655 6.928203 7.000000 7.071068 7.141428
##  [8] 7.211103 7.280110 7.348469 7.416198
#factorial
factorial(x_vector)
lähtö:
##  [1] 1.196222e+56 5.502622e+57 2.586232e+59 1.241392e+61 6.082819e+62
##  [6] 3.041409e+64 1.551119e+66 8.065818e+67 4.274883e+69 2.308437e+71
## [11] 1.269640e+73
Tilastotoiminnot
Kun matemaattiset funktiot muuntavat arvoja, tilastolliset funktiot tiivistävät ne. R:n vakioasennus sisältää laajan valikoiman tilastollisia funktioita. Tässä opetusohjelmassa tarkastelemme lyhyesti tärkeimpiä.
Tilastolliset perusfunktiot
| OperaTor | Tuotetiedot |
|---|---|
| keskiarvo (x) | x:n keskiarvo |
| mediaani(x) | x:n mediaani |
| var(x) | x:n varianssi |
| sd(x) | x:n keskihajonta |
| mittakaava (x) | x:n vakiopisteet (z-pisteet). |
| kvantiili(x) | X:n kvartiilit |
| yhteenveto(x) | Yhteenveto x:stä: keskiarvo, min, max jne. |
speed <- dt$speed
speed
# Mean speed of cars dataset
mean(speed)
lähtö:
## [1] 15.4
# Median speed of cars dataset
median(speed)
lähtö:
## [1] 15
# Variance speed of cars dataset
var(speed)
lähtö:
## [1] 27.95918
# Standard deviation speed of cars dataset
sd(speed)
lähtö:
## [1] 5.287644
# Standardize vector speed of cars dataset
head(scale(speed), 5)
lähtö:
##           [,1]
## [1,] -2.155969
## [2,] -2.155969
## [3,] -1.588609
## [4,] -1.588609
## [5,] -1.399489
# Quantile speed of cars dataset
quantile(speed)
lähtö:
##   0%  25%  50%  75% 100%
##    4   12   15   19   25
# Summary speed of cars dataset
summary(speed)
lähtö:
##    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
##     4.0    12.0    15.0    15.4    19.0    25.0
Tähän mennessä olemme oppineet paljon R sisäänrakennettuja toimintoja.
HuomautuksiaOle varovainen :n kanssa argumentin luokka, eli numeerinen, totuusarvo tai merkkijono. Jos esimerkiksi meidän on välitettävä merkkijonoarvo, meidän on laitettava merkkijono lainausmerkkeihin: ”ABC”.
Kirjoita funktio R:llä
Joissakin tapauksissa meidän on kirjoitettava oma funktio, koska meidän on suoritettava tietty tehtävä eikä valmista funktiota ole olemassa. Käyttäjän määrittelemä funktio sisältää nimi, perustelut ja elin.
function.name <- function(arguments)
{
    computations on the arguments
    some other code
}
Huomautuksia: Hyvä käytäntö on nimetä käyttäjän määrittämä funktio eri tavalla kuin sisäänrakennettu funktio. Se välttää hämmennystä.
Yksi argumenttifunktio
Seuraavassa katkelmassa määritämme yksinkertaisen neliöfunktion. Funktio hyväksyy arvon ja palauttaa arvon neliön.
square_function<- function(n)
{
  # compute the square of integer `n`
  n^2
}
# calling the function and passing value 4
square_function(4)
Code Selitys
- Funktio on nimeltään neliöfunktio; sitä voidaan kutsua miksi haluamme.
- Se saa argumentin "n". Me ei määrittänyt muuttujan tyyppiä, jotta käyttäjä voi välittää kokonaisluvun, vektorin tai matriisin
- Funktio ottaa syötteen "n" ja palauttaa syötteen neliön. Kun olet lopettanut funktion käytön, voimme poistaa sen rm()-funktiolla.
# funktion luomisen jälkeen
rm(square_function)
square_function
Konsolissa näemme virheilmoituksen :Error: objektia 'square_function' ei löydy, mikä kertoo, että toimintoa ei ole olemassa.
Ympäristötutkimusping
Kirjassa R, ympäristö on kokoelma objekteja, kuten funktioita, muuttujia, datakehyksiä jne.
R avaa ympäristön joka kerta, kun RStudio käynnistetään.
Käytettävissä oleva huipputason ympäristö on globaali ympäristö, nimeltään R_GlobalEnv. Ja meillä on paikallinen ympäristö.
Voimme luetella nykyisen ympäristön sisällön.
ls(environment())
ulostulo
## [1] "diff_ts"         "dt"              "speed"           "square_function"
## [5] "ts"              "x"               "x_vector"
Näet kaikki R_GlobalEnv:ssä luodut muuttujat ja funktiot.
Yllä oleva luettelo vaihtelee RStudiossa suorittamasi historiallisen koodin mukaan.
Huomaa, että n, neliöfunktiofunktion argumentti ei ole tässä globaalissa ympäristössä.
Jokaiselle funktiolle luodaan uusi ympäristö. Yllä olevassa esimerkissä funktio square_function() luo uuden ympäristön funktion sisälle. globaali ympäristö.
Selventämään eroa maailmanlaajuinen ja paikallinen ympäristössä, tutkitaan seuraavaa esimerkkiä
Nämä funktiot ottavat arvon x argumenttina ja lisäävät sen y-määritteeseen funktion ulkopuolella ja sisällä

Funktio f palauttaa lähdön 15. Tämä johtuu siitä, että y on määritelty globaalissa ympäristössä. Mitä tahansa globaalissa ympäristössä määritettyä muuttujaa voidaan käyttää paikallisesti. Muuttujan y arvo on 10 kaikkien toimintokutsujen aikana, ja se on käytettävissä milloin tahansa.
Katsotaan mitä tapahtuu, jos muuttuja y määritellään funktion sisällä.
Meidän on pudotettava "y" ennen tämän koodin suorittamista komennolla rm r
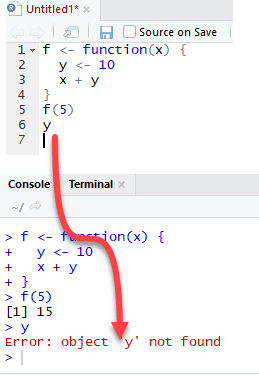
Tulos on myös 15, kun kutsumme f(5):tä, mutta palauttaa virheen, kun yritämme tulostaa arvon y. Muuttuja y ei ole globaalissa ympäristössä.
Lopuksi R käyttää viimeisintä muuttujan määritelmää kulkeakseen funktion rungon sisällä. Tarkastellaanpa seuraavaa esimerkkiä:

R jättää huomioimatta funktion ulkopuolella määritetyt y-arvot, koska loimme eksplisiittisesti ay-muuttujan funktion runkoon.
Moniargumenttitoiminto
Voimme kirjoittaa funktion useammalla kuin yhdellä argumentilla. Harkitse funktiota nimeltä "ajat". Se on yksinkertainen funktio, joka kertoo kaksi muuttujaa.
times <- function(x,y) {
  x*y
	}
times(2,4)
lähtö:
## [1] 8
Milloin meidän pitäisi kirjoittaa funktio?
Datatieteilijöiden on suoritettava monia toistuvia tehtäviä. Useimmiten kopioimme ja liitämme koodinpätkiä toistuvasti. Esimerkiksi muuttujan normalisointi on erittäin suositeltavaa ennen kuin suoritamme koneoppiminen algoritmi. Kaava muuttujan normalisoimiseksi on:

Tiedämme jo kuinka käyttää min()- ja max()-funktioita R:ssä. Käytämme tibble-kirjastoa tietokehyksen luomiseen. Tibble on toistaiseksi kätevin toiminto tietojoukon luomiseen tyhjästä.
library(tibble)
# Create a data frame
data_frame <- tibble(
  c1 = rnorm(50, 5, 1.5),
  c2 = rnorm(50, 5, 1.5),
  c3 = rnorm(50, 5, 1.5),
)
Laskemme yllä kuvatun funktion kahdessa vaiheessa. Ensimmäisessä vaiheessa luomme muuttujan nimeltä c1_norm, joka on c1:n skaalaus. Toisessa vaiheessa kopioimme ja liitämme c1_normin koodin ja muutamme sen c2:ksi ja c3:ksi.
Yksityiskohta funktiosta sarakkeella c1:
Nimittäjä: : data_frame$c1 -min(data_frame$c1))
Nimittäjä: max(data_frame$c1)-min(data_frame$c1))
Siksi voimme jakaa ne sarakkeen c1 normalisoidun arvon saamiseksi:
(data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
Voimme luoda c1_norm, c2_norm ja c3_norm:
Create c1_norm: rescaling of c1
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
# show the first five values
head(data_frame$c1_norm, 5)
lähtö:
## [1] 0.3400113 0.4198788 0.8524394 0.4925860 0.5067991
Se toimii. Voimme kopioida ja liittää
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
muuta sitten c1_norm arvoksi c2_norm ja c1 arvoksi c2. Teemme samoin c3_normin luomiseksi
data_frame$c2_norm <- (data_frame$c2 - min(data_frame$c2))/(max(data_frame$c2)-min(data_frame$c2))
data_frame$c3_norm <- (data_frame$c3 - min(data_frame$c3))/(max(data_frame$c3)-min(data_frame$c3))
Skaalasimme täydellisesti muuttujat c1, c2 ja c3.
Tämä menetelmä on kuitenkin altis virheille. Saatamme kopioida ja unohtaa muuttaa sarakkeen nimen liittämisen jälkeen. Siksi hyvä käytäntö on kirjoittaa funktio joka kerta, kun sama koodi on liitettävä useammin kuin kaksi kertaa. Voimme järjestää koodin kaavaksi ja kutsua sitä aina tarvittaessa. Oman funktion kirjoittamiseksi meidän on annettava:
- Nimi: normalisoida.
- argumenttien määrä: Tarvitsemme vain yhden argumentin, joka on sarake, jota käytämme laskennassamme.
- Keho: tämä on yksinkertaisesti kaava, jonka haluamme palauttaa.
Jatkamme askel askeleelta luodaksemme funktion normalisoinnin.
Vaihe 1) Luomme nimittäjän, joka on x – min(x). R:ssä voimme tallentaa nimittäjän muuttujaan, kuten tässä:
nominator <- x-min(x)
Vaihe 2) Laskemme nimittäjän: max(x) – min(x). Voimme toistaa vaiheen 1 idean ja tallentaa laskutoimituksen muuttujaan:
denominator <- max(x)-min(x)
Vaihe 3) Teemme jaon nimeäjän ja nimittäjän välillä.
normalize <- nominator/denominator
Vaihe 4) Palauttaaksemme arvon kutsuvaan funktioon meidän on läpäistävä normalise inside return(), jotta saadaan funktion tulos.
return(normalize)
Vaihe 5) Olemme valmiita käyttämään funktiota wrap-komennollaping kaikki kiinnikkeen sisällä.
normalize <- function(x){
  # step 1: create the nominator
  nominator <- x-min(x)
  # step 2: create the denominator
  denominator <- max(x)-min(x)
  # step 3: divide nominator by denominator
  normalize <- nominator/denominator
  # return the value
  return(normalize)
}
Testataan funktiota muuttujalla c1:
normalize(data_frame$c1)
Se toimii täydellisesti. Loimme ensimmäisen toimintomme.
Funktio on kattavampi tapa suorittaa toistuva tehtävä. Voimme käyttää normalisointikaavaa eri sarakkeissa, kuten alla:
data_frame$c1_norm_function <- normalize (data_frame$c1)
data_frame$c2_norm_function <- normalize	(data_frame$c2)
data_frame$c3_norm_function <- normalize	(data_frame$c3)
Vaikka esimerkki on yksinkertainen, voimme päätellä kaavan tehon. Yllä oleva koodi on helpompi lukea ja siinä vältetään koodin liittämiseen liittyvät virheet.
Toimii ehdon kanssa
normalize()-funktio tekee aina saman asian. Joskus meidän on lisättävä funktioon ehtoja, jotta koodi voi palauttaa erilaisia tulosteita.
Koneoppimistehtävissä meidän on jaettava tietojoukko junajoukon ja testijoukon kesken. Junasarja antaa algoritmille mahdollisuuden oppia tiedoista. Testaaksemme mallimme suorituskykyä voimme käyttää testisarjaa suorituskyvyn mittauksen palauttamiseen. R:llä ei ole toimintoa kahden tietojoukon luomiseksi. Voimme kirjoittaa oman funktiomme tätä varten. Funktiomme ottaa kaksi argumenttia ja on nimeltään split_data(). Idea on yksinkertainen, kerromme aineiston pituus (eli havaintojen lukumäärä) 0.8:lla. Jos esimerkiksi haluamme jakaa tietojoukon 80/20 ja tietojoukossamme on 100 riviä, funktiomme kertoo 0.8*100 = 80. 80 riviä valitaan harjoitustiedoksemme.
Käytämme ilmanlaatutietoaineistoa testataksemme käyttäjän määrittämää toimintoamme. Ilmanlaatutietojoukossa on 153 riviä. Näemme sen alla olevalla koodilla:
nrow(airquality)
lähtö:
## [1] 153
Jatketaan seuraavasti:
split_data <- function(df, train = TRUE)
Arguments:
-df: Define the dataset
-train: Specify if the function returns the train set or test set. By default, set to TRUE
Funktiollamme on kaksi argumenttia. Argumenttijono on Boolen parametri. Jos se on TOSI, funktiomme luo junatietojoukon, muussa tapauksessa testitietojoukon.
Voimme jatkaa samalla tavalla kuin normalize()-funktion kanssa. Kirjoitamme koodin ikään kuin se olisi kertakäyttöistä koodia ja sitten lisäämme kaiken ehdon sisään funktion runkoon luodaksemme funktion.
Vaihe 1:
Meidän on laskettava tietojoukon pituus. Tämä tehdään funktiolla nrow(). Nrow palauttaa tietojoukon rivien kokonaismäärän. Kutsumme muuttuvaa pituutta.
length<- nrow(airquality)
length
lähtö:
## [1] 153
Vaihe 2:
Kerrotaan pituus 0.8:lla. Se palauttaa valittavien rivien määrän. Sen pitäisi olla 153 * 0.8 = 122.4
total_row <- length*0.8
total_row
lähtö:
## [1] 122.4
Haluamme valita 122 riviä ilmanlaatutietojoukon 153 rivistä. Luomme luettelon, joka sisältää arvot 1 - total_row. Tallennamme tuloksen muuttujaan nimeltä split
split <- 1:total_row
split[1:5]
lähtö:
## [1] 1 2 3 4 5
split valitsee tietojoukosta ensimmäiset 122 riviä. Voimme esimerkiksi nähdä, että muuttujajakomme kerää arvot 1, 2, 3, 4, 5 ja niin edelleen. Nämä arvot ovat indeksi, kun valitsemme palautettavat rivit.
Vaihe 3:
Meidän on valittava ilmanlaatutietojoukon rivit jaettuun muuttujaan tallennettujen arvojen perusteella. Tämä tehdään näin:
train_df <- airquality[split, ]
head(train_df)
lähtö:
##[1]    Ozone Solar.R Wind Temp Month Day
##[2]  51    13     137 10.3   76     6  20
##[3]  15    18      65 13.2   58     5  15
##[4]  64    32     236  9.2   81     7   3
##[5]  27    NA      NA  8.0   57     5  27
##[6]  58    NA      47 10.3   73     6  27
##[7]  44    23     148  8.0   82     6  13
Vaihe 4:
Voimme luoda testitietojoukon käyttämällä jäljellä olevia rivejä, 123:153. Tämä tehdään käyttämällä - splitin edessä.
test_df <- airquality[-split, ]
head(test_df)
lähtö:
##[1] Ozone Solar.R Wind Temp Month Day
##[2]  123    85     188  6.3   94     8  31
##[3]  124    96     167  6.9   91     9   1
##[4]  125    78     197  5.1   92     9   2
##[5]  126    73     183  2.8   93     9   3
##[6]  127    91     189  4.6   93     9   4
##[7]  128    47      95  7.4   87     9   5
Vaihe 5:
Voimme luoda ehdon funktion runkoon. Muista, että meillä on argumenttijuna, joka on oletuksena TOSI, joka palauttaa junajoukon. Ehdon luomiseen käytämme if-syntaksia:
  if (train ==TRUE){
    train_df <- airquality[split, ]
      return(train)
  } else {
    test_df <- airquality[-split, ]
      return(test)
  }
Tässä se, voimme kirjoittaa funktion. Meidän tarvitsee vain muuttaa ilmanlaatu df:ksi, koska haluamme kokeilla toimintoamme mihin tahansa datakehys, ei vain ilmanlaatua:
split_data <- function(df, train = TRUE){
  length<- nrow(df)
  total_row <- length *0.8
  split <- 1:total_row
  if (train ==TRUE){
    train_df <- df[split, ]
      return(train_df)
  } else {
    test_df <- df[-split, ]
      return(test_df)
  }
}
Kokeillaan funktiotamme ilmanlaatudatajoukolla. Meillä pitäisi olla yksi 122 rivin junajoukko ja 31 rivin testijoukko.
train <- split_data(airquality, train = TRUE)
dim(train)
lähtö:
## [1] 122 6
test <- split_data(airquality, train = FALSE)
dim(test)
lähtö:
## [1] 31 6
