
Fuzz-testauksen (fuzzing) opetusohjelma
 Thomas Hamilton
⚡ Älykäs yhteenveto
Fuzz Testing syöttää ohjelmaan virheellistä, odottamatonta tai satunnaista dataa ja tarkkailee kaatumisia, jumiutumisia ja muistivirheitä paljastaen tietoturva-aukkoja, joihin skriptatut toiminnalliset testit eivät melkein koskaan itse löydä.
Mitä on Fuzz-testaus?
Fuzz-testaus tai fuzzing on ohjelmistotestaustekniikka, jossa ohjelmistojärjestelmään lisätään virheellistä tai satunnaista dataa, jota kutsutaan nimellä FUZZ, koodausvirheiden ja tietoturva-aukkojen löytämiseksi. Fuzz-testauksen tarkoituksena on lisätä dataa automatisoitujen tai puoliautomaattisten tekniikoiden avulla ja testata järjestelmää erilaisten poikkeusten, kuten järjestelmän kaatumisten tai sisäänrakennetun koodin virheiden, varalta.
Fuzz-testauksen kehitti alun perin Barton Miller Wisconsinin ja Madisonin yliopistosta. Hän loi termin sen jälkeen, kun modeemilinkin linjakohina kaatoi hänen käyttämänsä ohjelmat. Hänen opiskelijansa ajoivat ensimmäiset fuzz-testaukset vuonna 1989 ja havaitsivat, että noin kolmannes heidän kohdistamista UNIX-apuohjelmista kaatui tai jumiutui. Fuzz-testaus on ohjelmistojen testaus tekniikka, ja se on eräänlainen Suojaustestaus.
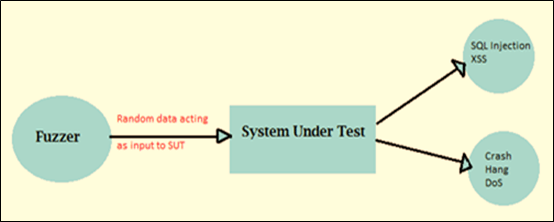
Alla oleva kaavio näyttää fuzzing-silmukan perusmuodon, jossa luotu data syötetään testattavaan sovellukseen ja vastetta tarkkaillaan.
Miksi tehdä Fuzz-testaus?
Fuzzing ansaitsee paikkansa testaussuunnitelmassa, koska se tutkii syötteitä, joita varten kukaan ei ole ajatellut kirjoittaa testitapausta. Tärkeimmät syyt, miksi tiimit ottavat sen käyttöön, on lueteltu alla.
- Fuzz-testaus löytää yleensä vakavimmat tietoturvaviat ja -puutteet, koska kaatuminen on suora todiste käsittelemättömästä syöttöpolusta.
- Fuzz-testaus antaa tehokkaamman tuloksen, kun sitä käytetään yhdessä Musta Box Testaus, beta-testaus ja muut virheenkorjausmenetelmät.
- Fuzz-testausta käytetään ohjelmistojen haavoittuvuuksien tarkistamiseen, ja se on erittäin kustannustehokas testaustekniikka, koska syötteet generoidaan käsin kirjoitettujen sijaan.
- Fuzz-testaus on yksi mustan laatikon testaustekniikoista. Fuzz on myös yksi yleisimmistä menetelmistä, joita hakkerit käyttävät järjestelmän haavoittuvuuksien löytämiseen, joten sen suorittaminen ensin poistaa hyökkääjän helpoimman reitin sisään.
Fuzz-testauksen tyypit
Fuzzerit ryhmitellään yleensä sen mukaan, kuinka paljon ne tietävät hyökkäämästään ohjelmasta. Mitä enemmän fuzzeri tietää, sitä syvemmälle koodiin se voi työntää.
| Tyyppi | Mitä sumuttaja tietää | Tyypillinen käyttö |
| Mustan laatikon sumeus | Ei mitään sisäosista; se näkee vain tulot ja lähdöt. | Quick Smoke suoritetaan binääritiedostoa tai live-päätepistettä vastaan. |
| Valkoisen laatikon sumentuminen | Täysi lähdekoodi, usein yhdistettynä symboliseen suoritukseen vaikeasti tavoitettavien haarojen ratkaisemiseksi. | Syvällinen analyysi komponentista, jonka lähde on saatavilla. |
| Harmaan laatikon sumentuminen | Ei lähdekoodin tarkistusta, mutta ajonaikaista palautetta, kuten mihin koodihaaraan syöte päätyi. | Oletusarvo moderneille hakukoneille, kuten AFL++ ja libFuzzer. |
Toinen, vanhempi ero erottaa tyhmä hölynpöly alkaen älykäs sumeusTyhmä fuzzeri kääntää bittejä taaksepäin ilman mitään käsitystä syöttömuodosta, joten ensimmäinen kohtaama jäsennin hylkää suurimman osan sen datasta. Älykäs fuzzeri ymmärtää tarkistussummat, pituuskentät ja viestirakenteen, joten sen syötteet selviävät validoinnista ja saavuttavat alla olevan logiikan. Kattavuusohjattu sumeus on harmaan laatikon hienosäätö, joka teki fuzzingista valtavirtaa: moottori instrumentoi binäärikoodin, säilyttää kaikki uuteen haaraan johtavat syötteet ja mutatoi eloonjääneet, joten korpus kehittyy tasaisesti kohti tutkimatonta koodia sen sijaan, että se käynnistyisi uudelleen satunnaisesta kohinasta.
Kuinka tehdä Fuzz-testaus
Fuzz-testauksen vaiheet sisältävät testauksen perusvaiheet:
Vaihe 1) Tunnista kohdejärjestelmä — valitse hyökkäyksen kohteena oleva binääri-, kirjasto-, palvelu- tai protokollapäätepiste ja vahvista, että sinulla on lupa testata sitä.
Vaihe 2) Tunnista tulot — listaa kaikki aloituskohdat, joista kohde lukee: tiedostot, komentoriviargumentit, ympäristömuuttujat, verkkopaketit, lomakekentät ja API-hyötykuormat.
Vaihe 3) Luo sumea data — tuottaa virheellisesti muotoiltuja syötteitä muuntamalla kelvollisia näytteitä, luomalla ne formaatin mallista tai yhdistämällä molempia.
Vaihe 4) Suorita testi käyttämällä sumeaa dataa — ajaa kohdetta luotuja syötteitä vasten, mieluiten silmukassa, joka käynnistää prosessin automaattisesti uudelleen jokaisen virheen jälkeen.
Vaihe 5) Tarkkaile järjestelmän toimintaa — tarkkaile kaatumisia, jumiutumisia, vahvistusvirheitä, ylikuormitettua muistinkäyttöä ja puhdistusraportteja pelkän tulosteen tarkistamisen sijaan.
Vaihe 6) Loki viat — tallenna tarkka syöte, joka laukaisi kunkin vian, kutista se pienimpään toistuvaan tapaukseen ja arkistoi se pinoon trace liitteenä.
Esimerkkejä Fuzzereista
Fuzzerit luokitellaan myös sen mukaan, miten ne rakentavat syötteen, ja alla olevat kolme lähestymistapaa ovat ne, joihin törmäät useimmin.
- Mutaatiopohjaiset sumuttimet muokata olemassa olevia datanäytteitä luodakseen uutta testidataa. Tämä on hyvin yksinkertainen ja suoraviivainen lähestymistapa: se aloittaa valideilla protokollan näytteillä ja jatkaa jokaisen tavun tai tiedoston muokkaamista.
- Sukupolvipohjaiset fuzzerit määrittelevät uutta dataa mallin syötteen perusteella. He alkavat tuottaa syötettä tyhjästä spesifikaation perusteella.
- Protokollapohjaiset fuzzerit riippuvat testattavan protokollamuodon yksityiskohtaisesta tiedosta, ja tämä ymmärrys tulee spesifikaatiosta. Se tarkoittaa spesifikaation taulukon kirjoittamista työkaluun ja sitten mallipohjaisen testigenerointitekniikan käyttöä spesifikaation läpikäymiseksi ja epäsäännöllisyyksien lisäämiseksi tietosisältöön, järjestykseen jne. Tätä kutsutaan myös syntaksitestaukseksi, kielioppitestaukseksi tai kestävyystestaukseksi. Fuzzer voi luoda testitapauksia olemassa olevasta tai se voi käyttää kelvollisia tai virheellisiä syötteitä.
Protokollapohjaisella fuzzingilla on kaksi rajoitusta:
- Testausta ei voi jatkaa ennen kuin spesifikaatio on kypsä.
- Monet hyödylliset protokollat ovat julkaistujen protokollien laajennuksia. Jos fuzz-testaus perustuu julkaistuihin spesifikaatioihin, Testin kattavuus uusille protokollille on rajoitettu.
Yksinkertaisin sumeustekniikan muoto on lähettää ohjelmistolle satunnaista syötettä joko protokollapaketteina tai tapahtumana. Tämä satunnaisen syötteen välittämiseen perustuva tekniikka on erittäin tehokas virheiden löytämiseen monista sovelluksista ja palveluista. Saatavilla on myös muita tekniikoita, ja ne on erittäin helppo toteuttaa. Näiden tekniikoiden toteuttamiseksi meidän tarvitsee vain muuttaa olemassa olevia syötteitä, ja voimme muuttaa syötettä yksinkertaisesti vaihtamalla sen bittejä.
Fuzz-testauksen havaitsemat bugityypit
Koska sumeus arvioi suoritusajan ohjelman käyttäytymisen eikä odotusarvon perusteella, sen havaitsemat viat ryhmittyvät kolmeen perheeseen.
- Väitevirheet ja muistivuodot: Tätä menetelmää käytetään laajalti suurissa sovelluksissa, joissa virheet vaikuttavat muistin turvallisuuteen, mikä on vakava haavoittuvuus. Buffer Ylivuoto-, käyttö-vapautuksen jälkeen- ja rajojen ulkopuoliset lukemat näkyvät kaikki tässä.
- Virheellinen syöte: Fuzz-testauksessa fuzzeja käytetään virheellisen syötteen luomiseen, jota käytetään virheenkäsittelyrutiinien testaamiseen, ja tämä on tärkeää ohjelmistoille, jotka eivät hallitse syötettään. Yksinkertainen fuzzing voidaan nähdä tapana automatisoida negatiivinen testi.
- Oikeellisuusvirheet: Sumennusta voidaan käyttää myös tietyntyyppisten "oikeellisuusvirheiden", kuten vioittuneen tietokannan tai heikkojen hakutulosten, havaitsemiseen. Differentiaalisumennusta käytetään yleensä siten, että sama syöte syötetään kahteen toteutukseen ja vastauksia vertaillaan.
Fuzz-testaustyökalut
Verkkoturvallisuudessa käytettyjä työkaluja voidaan käyttää laajalti fuzz-testauksessa, kuten Burp Suite ja Peach Fuzzer. Useat alla olevista klassikkonimistä on nyt arkistoitu, joten niiden nykyinen tila ilmoitetaan jokaisen merkinnän yhteydessä.
- Peach FuzzerPeach Fuzzer tarjoaa vankemman suojauksen kuin skanneri. Muut testaustyökalut voivat etsiä vain tunnettuja uhkia, kun taas Peach Fuzzer mahdollistaa käyttäjien löytää tunnettuja ja tuntemattomia uhkia. GitLab osti Peach Techin, eikä Community Edition v3:a enää ylläpidetä; ylläpidetty seuraaja on GitLab Protocol Fuzzer -yhteisöversio.
- Spike-välityspalvelin: ammattilaistason työkalu, joka etsii sovellustason haavoittuvuuksia verkkosovelluksista. SPIKE Proxy kattaa perusasiat, kuten SQL Injektio ja sivustojen välinen komentosarjatuotto täysin avoimella alustalla Python infrastruktuuri, ja se oli käytettävissä Linux ja WindowsSitä ei ole ylläpidetty moneen vuoteen, ja se on sisällytetty tähän historiallisen kontekstin vuoksi.
- WebSkarabeeWebScarab on kirjoitettu kielellä Java ja on siksi siirrettävissä monille alustoille. WebScarab-kehys kommunikoi HTTP- ja HTTPS-protokollien avulla ja toimii sieppaavana välityspalvelimena: se antaa operaattorille mahdollisuuden tarkastella ja muokata selaimen luomia pyyntöjä ennen kuin palvelin vastaanottaa ne, sekä tarkastella ja päivittää palvelimen luomia vastauksia ennen kuin selain vastaanottaa ne. Kaikki WebScarabin löytämät porsaanreiät lisätään raportoitujen ongelmien luetteloon. Tietovarasto arkistoitiin huhtikuussa 2024 ja on nyt vain luku -tilassa.
- OWASP WSFuzzerWSFuzzer on GPL-lisensoitu ohjelma, joka on kirjoitettu Python joka kohdistui verkkopalveluihin ja viimeisimmässä versiossaan HTTP-pohjaiseen SOAP palvelut olivat pääkohde. Se toimitettiin osana WebScarabia ja poistettiin sen mukana; OWASP ZAP ja sen Fuzzer-lisäosa ovat suositeltuja vaihto-osia.
- Säilytetyt vaihtoehdot: AFL++ ja libFuzzer ovat natiivikoodin vakiomuotoisia kattavuusohjattuja moottoreita, OSS-Fuzz suorittaa niitä jatkuvasti ja maksutta avoimen lähdekoodin projekteissa, ja buzz kattaa verkkoprotokollan sumennuksen PythonLaajempi luettelo on koottu oppaaseen tietoturvatestaustyökalut.
Fuzz-testauksen parhaat käytännöt
Kohteeseen suunnattu ja rauhaan jätetty fuzzer löytää harvoin paljoakaan. Alla olevat käytännöt erottavat kampanjan, joka tuottaa arkistoituja vikoja, kampanjasta, joka vain kuluttaa prosessoriaikaa.
- Aloita hyvästä siemenrungosta. Kerää aitoja, kelvollisia syötteitä, jotka sovellus jo hyväksyy. Aidon tiedoston muuntaminen jäsentää koodia paljon nopeammin kuin satunnaisten tavujen muuntaminen.
- Kirjoita pieni, nopea valjaat. Aloituspisteen tulisi tehdä yksi asia suorituskertaa kohden, välttää verkkokutsuja ja levylle kirjoituksia sekä palata nopeasti, koska läpäisykyky mitataan suoritusten määränä sekunnissa.
- Ota desinfiointiaineet käyttöön. Hiljainen muistin vioittuminen ei usein aiheuta kaatumista. AddressSanitizer ja UndefinedBehaviorSanitizer muuttavat sen välittömäksi, diagnosoitavaksi viaksi.
- Juokse pitkään ja juokse jatkuvasti. Yhden tai kahden tunnin ajolla nappaa matalalla sijaitsevat ötökät; syvät polut vaativat yleensä useita tunteja, minkä vuoksi fuzzing kuuluu iltaiseen CI-työhön manuaalisen istunnon sijaan.
- Minimoi ja poista jokaisen kaatumisen kaksoiskappaleet. Pienennä virheellinen syöte pienimpään muotoonsa ja ryhmittele kaatumiset pinon mukaan tracmuuten yksi vika saapuu satoina tiketteinä.
- Pidä regressiokorpus yllä. Lisää jokainen toistuva syöte pysyvään joukkoon, joka suoritetaan jokaisella koonnilla, jotta korjattu vika ei voi palata huomaamattomasti.
- Mittaa kohde laillisesti. Kolmannen osapuolen palvelun toiminnassa olevan sisällön sumentaminen ilman kirjallista lupaa on sama asia kuin hyökkäys.
Fuzz-testauksen edut
Realististen odotusten pohjalta käytettynä fuzzing lisää arvoa, jota muilla tekniikoilla on vaikea saavuttaa.
- Fuzz-testaus parantaa ohjelmistojen tietoturvatestausta.
- Fuzzingissa löytyvät virheet ovat joskus vakavia ja usein samoja, joita hyökkääjät käyttävät, mukaan lukien kaatumiset, muistivuotoja ja käsittelemättömiä poikkeuksia.
- Jos testaajat eivät huomaa bugeja ajan ja resurssien rajallisuuden vuoksi, ne löytyvät myös fuzz-testauksesta.
- Kone tuottaa syötteet, joten peitto kasvaa yön yli ilman ylimääräistä manuaalista työtä.
Fuzz-testauksen haitat
Samat ominaisuudet, jotka tekevät fuzzingista halpaa, myös kattavat sen, mitä se voi todistaa.
- Pelkkä sumea testaus ei voi antaa täydellistä kuvaa yleisestä tietoturvauhasta tai joukosta virheitä.
- Fuzz-testaus on vähemmän tehokasta sellaisten tietoturvauhkien käsittelyssä, jotka eivät aiheuta ohjelmien kaatumisia, kuten jotkut virukset, madot ja troijalaiset.
- Fuzz-testaus voi havaita vain suhteellisen yksinkertaisia vikoja tai uhkia, eikä se analysoi liiketoimintalogiikkaa.
- Tehokkaan toiminnan takaamiseksi se vaatii merkittävästi koneaikaa.
- Reuna-arvoehdon asettaminen satunnaisilla syötteillä on erittäin ongelmallista, vaikka testaajat ratkaisevatkin nykyään suuren osan tästä käyttäjän syötteiden ohjaamilla deterministisillä algoritmeilla.
Fuzz-testaus vs. penetraatiotestaus
Molemmat toiminnot etsivät tietoturva-aukkoja, mutta ne vastaavat eri kysymyksiin ja ovat harvoin keskenään vaihdettavissa.
| Kriteeri | Fuzz-testaus | Läpäisyn testaus |
| Ohjaama | Automaattinen moottori tuottaa virheellisesti muotoiltua syötettä | Taitava testaaja pohtii järjestelmää |
| Etsii | Kaatumiset, jumiutumiset ja muistin turvallisuusongelmat | Hyödynnettävissä olevat heikkoudet, mukaan lukien logiikka- ja konfiguraatiovirheet |
| Syvyys | Hyvin laaja syötevalikoima, pinnallinen päättely | Kapea kattavuus, syvällinen päättely |
| ulostulo | Tulojen ja pinon toistaminen traces | Löydösraportti, jossa on hyväksikäyttöpolut ja riskiluokitukset |
| Paras hetki | Jatkuvasti rakennusputkessa | Ajoittain, julkaisuehdokasta vastaan |
Käytännössä nämä kaksi ruokkivat toisiaan: fuzzing poistaa halvat, automaattisesti syntyvät kaatumiset, jolloin testaajan rajalliset tunnit käytetään virheisiin, jotka vain ihminen havaitsee.
