
Hive Deltagelse & SubQuery Selvstudium med eksempler
 Redaktionelle team
⚡ Smart opsummering
Hive-joins kombinerer rækker fra to eller flere tabeller i en matchende kolonne, og underforespørgsler indlejrer én forespørgsel i en anden, så begge demonstreres her på to eksempeltabeller, der er indlæst fra almindelige tekstfiler.

Deltag i forespørgsler
Join-forespørgsler kan udføres på to tabeller, der findes i HiveFor at forstå join-koncepter tydeligt opretter vi to tabeller her:
- sample_joins (relateret til kundeoplysninger)
- sample_joins1 (relateret til ordreoplysninger afgivet af medarbejdere)
Trin 1) Oprettelse af tabellen “sample_joins” med kolonnenavnene Id, Navn, Alder, adresse og løn for medarbejderne. Skærmbilledet nedenfor viser CREATE TABLE-sætningen og dens bekræftelse.

Trin 2) Indlæsning og visning af data. Det næste skærmbillede viser indlæsningskommandoen efterfulgt af indholdet af tabellen.
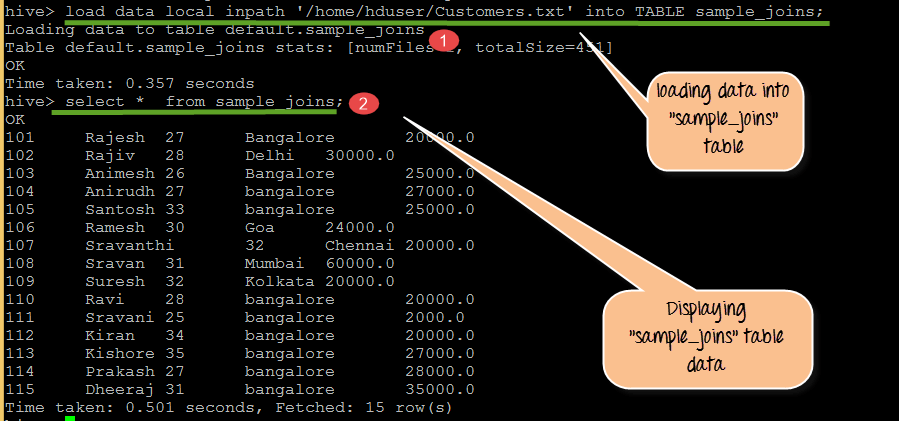
Fra ovenstående skærmbillede:
- Indlæser data i sample_joins fra Customers.txt
- Viser sample_joins tabelindhold
Trin 3) Oprettelse af sample_joins1-tabellen, derefter indlæsning og visning af dens data, som vist på skærmbilledet nedenfor.

Fra ovenstående skærmbillede kan vi observere følgende:
- Oprettelse af tabellen sample_joins1 med kolonnerne Orderid, Date1, Id og Amount
- Indlæser data i sample_joins1 fra orders.txt
- Viser poster til stede i sample_joins1
Fremadrettet vil vi se på de forskellige typer joins, der kan udføres på de tabeller, vi har oprettet. Inden da skal du overveje følgende punkter om joins.
Nogle punkter at være opmærksom på ved joins:
- Kun ligestillingsforbindelser er tilladt i forbindelser
- Mere end to tabeller kan forbindes i samme forespørgsel
- LEFT-, RIGHT- og FULL OUTER-joins findes for at give mere kontrol over ON-klausulen, som der ikke er noget match for.
- Joins er ikke kommutative
- Joins er venstre-associative, uanset om de er LEFT eller RIGHT joins
Lighedsbegrænsningen afspejler Hive, som det var i mange år. Fra Hive 2.2.0 og fremefter understøttes komplekse udtryk i ON-klausulen (HIVE-15211), så en ikke-lighedsbetingelse accepteres i en nuværende udgivelse. I ældre udgivelser skal betingelsen være en lighedstest, hvor alt andet flyttes til en WHERE-klausul.
Forskellige typer sammenføjninger
Der findes 4 typer joins. Disse er:
- Indvendig sammenføjning
- Venstre ydre samling
- Højre ydre sammenføjning
- Fuld ydre samling
Hver type demonstreres nedenfor mod de samme to tabeller, så det eneste, der ændrer sig mellem eksemplerne, er hvilke ikke-matchede rækker, der overlever.
Indvendig sammenføjning
De poster, der er fælles for begge tabeller, hentes af denne inner join. Resultatet i skærmbilledet nedenfor indeholder kun de kunder, der har en matchende ordre.

Fra ovenstående skærmbillede kan vi observere følgende:
- Her udfører vi en join-forespørgsel ved hjælp af JOIN-nøgleordet mellem tabellerne sample_joins og sample_joins1 med den matchende betingelse (c.Id = o.Id).
- Outputtet viser de fælles poster, der findes i begge tabeller, valgt ved at kontrollere den betingelse, der er nævnt i forespørgslen.
Forespørgsel:
SELECT c.Id, c.Name, c.Age, o.Amount FROM sample_joins c JOIN sample_joins1 o ON(c.Id=o.Id);
Venstre ydre samling
- HiveQL LEFT OUTER JOIN returnerer alle rækker fra venstre tabel, selvom der ikke er nogen match i højre tabel
- Hvis ON-klausulen matcher nul poster i den højre tabel, returnerer join'en stadig en post i resultatet med NULL i hver kolonne fra den højre tabel.
Skærmbilledet nedenfor viser, at alle kunder vises, inklusive dem, der ikke har bestilt noget.

Fra ovenstående skærmbillede kan vi observere følgende:
- Her udfører vi en join-forespørgsel ved hjælp af nøgleordet "LEFT OUTER JOIN" mellem tabellerne sample_joins og sample_joins1 med den matchende betingelse (c.Id = o.Id). For eksempel bruger vi her medarbejder-id'et som reference; det kontrollerer, om id'et er fælles for både den højre og den venstre tabel. Det fungerer som den matchende betingelse.
- Outputtet viser de poster, der er valgt af den betingelse, der er nævnt i forespørgslen. NULL-værdier i ovenstående output er kolonner uden værdier fra den højre tabel, det vil sige sample_joins1.
Forespørgsel:
SELECT c.Id, c.Name, o.Amount, o.Date1 FROM sample_joins c LEFT OUTER JOIN sample_joins1 o ON(c.Id=o.Id)
Højre ydre samling
- HiveQL RIGHT OUTER JOIN returnerer alle rækker fra den højre tabel, selvom der ikke er nogen match i den venstre tabel
- Hvis ON-klausulen matcher nul poster i den venstre tabel, returnerer join'en stadig en post i resultatet med NULL i hver kolonne fra den venstre tabel.
- RIGHT-joins returnerer altid poster fra den højre tabel og matchende poster fra den venstre tabel. Hvis den venstre tabel ikke har nogen værdi, der svarer til kolonnen, returnerer den NULL-værdier på den plads.
Skærmbilledet nedenfor viser spejlbilledet af det forrige resultat: alle ordrer vises, uanset om de matcher eller ej.

Fra ovenstående skærmbillede kan vi observere følgende:
- Her udfører vi en join-forespørgsel ved hjælp af nøgleordet "RIGHT OUTER JOIN" mellem tabellerne sample_joins og sample_joins1 med den matchende betingelse (c.Id = o.Id).
- Outputtet viser de poster, der er valgt ved at kontrollere den betingelse, der er nævnt i forespørgslen.
Forespørgsel:
SELECT c.Id, c.Name, o.Amount, o.Date1 FROM sample_joins c RIGHT OUTER JOIN sample_joins1 o ON(c.Id=o.Id)
Fuld ydre tilslutning
Den kombinerer poster fra både tabellerne sample_joins og sample_joins1 baseret på den JOIN-betingelse, der er angivet i forespørgslen.
Den returnerer alle poster fra begge tabeller og udfylder NULL-værdier for de kolonner, hvis matchende værdier mangler på begge sider, som skærmbilledet nedenfor viser.

Fra ovenstående skærmbillede kan vi observere følgende:
- Her udfører vi en join-forespørgsel ved hjælp af nøgleordet "FULL OUTER JOIN" mellem tabellerne sample_joins og sample_joins1 med den matchende betingelse (c.Id = o.Id).
- Outputtet viser alle de poster, der findes i begge tabeller, valgt ved at kontrollere den betingelse, der er nævnt i forespørgslen. NULL-værdier i outputtet her angiver de manglende værdier fra kolonnerne i begge tabeller.
Forespørgsel:
SELECT c.Id, c.Name, o.Amount, o.Date1 FROM sample_joins c FULL OUTER JOIN sample_joins1 o ON(c.Id=o.Id)
Underforespørgsler
Joins placerer tabeller side om side. En underforespørgsel gør noget anderledes: den indlejrer én forespørgsel i en anden, så den ydre forespørgsel kan arbejde ud fra et resultat, der allerede er beregnet.
En forespørgsel, der er til stede i en forespørgsel, kaldes en underforespørgsel. Hovedforespørgslen afhænger af de værdier, der returneres af underforespørgslen.
Underforespørgsler kan opdeles i to typer:
- Underforespørgsler i FROM-klausulen
- Underforespørgsler i WHERE-klausulen
Hvornår skal du bruge:
- For at få en bestemt værdi kombineret fra to kolonneværdier fra forskellige tabeller
- Afhængighed af én tabels værdier af andre tabeller
- Sammenlignende kontrol af værdierne i én kolonne mod andre tabeller
Syntaks:
Subquery in FROM clause
SELECT <column names 1, 2…n>From (SubQuery) <TableName_Main >
Subquery in WHERE clause
SELECT <column names 1, 2…n> From<TableName_Main>WHERE col1 IN (SubQuery);
Eksempel:
SELECT col1 FROM (SELECT a+b AS col1 FROM t1) t2
Her er t1 og t2 tabelnavne. Den indre sætning er den underforespørgsel, der udføres på tabel t1. Her er a og b kolonner, der tilføjes i underforespørgslen og tildeles til kolonne1. Kol1 er den kolonneværdi, der findes i hovedtabellen. Denne kolonne "kol1", der findes i underforespørgslen, svarer til hovedtabelforespørgslen i kolonne kol1.
Indlejring af brugerdefinerede scripts
Hvor en underforespørgsel omformer data alene med HiveQL, overfører et integreret script rækker til kode skrevet uden for Hive.
Hive gør det muligt at skrive brugerspecifikke scripts til klientkrav. Brugere kan skrive deres egne map- og reduce-scripts til disse krav. Disse kaldes indlejrede brugerdefinerede scripts. Kodningslogikken er defineret i det brugerdefinerede script, og vi kan bruge det script på ETL-tidspunktet.
Hvornår skal man vælge indlejrede scripts:
- Hvor klientspecifikke krav betyder, at udviklere skal skrive og implementere scripts i Hive
- Hvor Hive-indbyggede funktioner ikke fungerer til specifikke domænekrav
Til dette bruger Hive TRANSFORM-klausulen til at integrere både map- og reducer-scripts.
I disse indlejrede brugerdefinerede scripts skal vi være opmærksomme på følgende punkter:
- Kolonner vil blive transformeret til strenge og afgrænset med TAB, før de gives til brugerscriptet.
- Standardoutputtet fra brugerskriptet vil blive behandlet som TAB-separerede strengkolonner
Eksempel på indlejret script:
FROM (
	FROM pv_users
	MAP pv_users.userid, pv_users.date
	USING 'map_script'
	AS dt, uid
	CLUSTER BY dt) map_output

INSERT OVERWRITE TABLE pv_users_reduced
	REDUCE map_output.dt, map_output.uid
	USING 'reduce_script'
	AS date, count;
Ud fra ovenstående script kan vi observere følgende. Dette er kun et eksempelscript til forståelse.
- pv_users er tabellen "users", som indeholder felter som "userid" og "date", som nævnt i map_script.
- Reducer-scriptet er defineret ud fra datoen og antallet i pv_users-tabellen.
