
Opret og slip INDEX ind Cassandra
 David Carter
⚡ Smart opsummering
Opret og slip indeks i Cassandra muliggør filtrering på kolonner, der ikke er en del af primærnøglen. Denne side dækker kommandoerne CREATE INDEX og DROP INDEX, navngivningsregler, tilgængelige indekstyper og de tilfælde, hvor et indeks er det forkerte svar.
Cassandra Opret indeks
Kommandoen 'Opret indeks' opretter et indeks på kolonnen angivet af brugeren. Hvis dataene allerede findes for den kolonne, du vil indeksere, Cassandra opretter indekser på dataene under udførelsen af 'create index'-sætningen.
- Efter oprettelse af et indeks, Cassandra indekserer automatisk nye data, når data indsættes.
- Indekset kan ikke oprettes på primærnøgle, da en primærnøgle allerede er indekseret.
- Indekser på samlingskolonner understøttes ved hjælp af formularerne NØGLE, VÆRDIER eller INDSTIGNINGER, afhængigt af hvad der skal søges i.
- Uden indeksering på kolonnen, Cassandra kan ikke filtrere den kolonne, medmindre det er en primærnøgle.
Derfor, for filtrering af kolonner i Cassandra, der skal oprettes indekser.
Syntaks
CREATE INDEX IndexName ON KeyspaceName.TableName (ColumnName);
Eksempel
Her er det øjebliksbillede, hvor det blev forsøgt at filtrere "dept"-kolonnen uden at oprette indekset. Som svar blev fejlen returneret.

Her er det øjebliksbillede, hvor indeks oprettes på afd. kolonne.

CREATE INDEX DeptIndex ON University.Student (dept);
Her er et øjebliksbillede, hvor det med succes vil blive filtreret 'dept' kolonne.

SELECT * FROM University.Student WHERE dept = 'CS';
Indeksnavnet er valgfrit. Hvis det udelades, kan Cassandra generere en automatisk, hvilket er vigtigt, når indekset senere skal slettes.
CREATE INDEX IF NOT EXISTS ON University.Student (dept);
Cassandra Drop Index
Kommandoen 'Drop index' dropper det angivne indeks. Hvis indeksnavnet ikke blev givet under oprettelsen af indekset, er indeksnavnet TableName_ColumnName_idx.
- Hvis indekset ikke eksisterer, vil det returnere en fejl, medmindre IF EXISTS bruges, vil det returnere no-op.
- Du skal angive nøglerumsnavnet sammen med indeksnavnet, ellers vil indekset blive søgt efter i det aktuelle nøglerum.
Syntaks
DROP INDEX IF EXISTS KeyspaceName.IndexName;
Eksempel
Her er et øjebliksbillede af den udførte kommando 'Drop index', der dropper indekset DeptIndex.
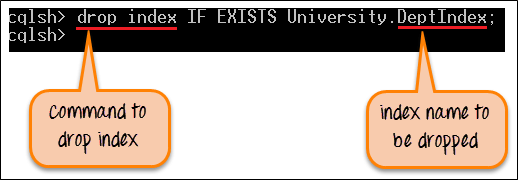
DROP INDEX IF EXISTS University.DeptIndex;
Efter vellykket udførelse af kommandoen vil DeptIndex blive slettet fra tasterummet. Nu kan data ikke filtreres af kolonneafdelingen.
For at bekræfte hvilke indekser der findes før dropping for det første, beskriv tabellen og læs indeksdefinitionerne nederst i outputtet.
DESCRIBE TABLE University.Student;
Typer af indeks i Cassandra
Kommandoen ovenfor opretter et standard sekundært indeks, men der findes tre forskellige mekanismer, og de opfører sig meget forskelligt.
| Type | Sådan fungerer det | Bedste for |
|---|---|---|
| Sekundært indeks | Hver node indekserer kun sine egne lokale data, så en forespørgsel uden en partitionsnøgle skal kontakte hver node. | Moderate kardinalitetskolonner forespørges sammen med en partitionsnøgle. |
| SASI-indeks | Et vedhæftet indeks, der understøtter matchning af LIKE-præfikser og -suffikser samt numeriske intervaller. | Tekstsøgemønstre. Stadig markeret som eksperimentel, så test før brug i produktion. |
| Storage Attached Index (SAI) | Indført i Cassandra 5.0, der deler én indeksstruktur på tværs af kolonner med lavere skriveoverhead. | Den moderne erstatning for begge ovenstående Cassandra 5 klynger. |
Indeksering af en samlingskolonne bruger en modifikator, der angiver, hvilken del der skal indekseres.
CREATE INDEX ON University.Teacher (VALUES(Email));
CREATE INDEX ON University.Course (KEYS(prereq));
CREATE INDEX ON University.Course (ENTRIES(prereq));
VÆRDIER søger i elementerne i et sæt eller en liste, KEYS søger i kortnøgler, og ENTRIES matcher et nøgle- og værdipar sammen. Samlingsindeksering er dækket yderligere i Cassandra kollektioner tutorial.
Hvornår man ikke skal bruge et indeks Cassandra
Et sekundært indeks er praktisk, men det er ikke et relationelt indeks, og det at bruge et på det forkerte sted er en almindelig årsag til langsomme klynger. Fire situationer kræver en anden tilgang.
- Meget høj kardinalitet. Indeksering af noget, der er tæt på unikt, såsom en e-mailadresse, betyder, at næsten hver partition indeholder én matchende række, så forespørgslen spreder sig ud over hele klyngen for at returnere en enkelt post.
- Meget lav kardinalitet. Indeksering af et flag med to værdier, såsom aktiv eller inaktiv, producerer enorme indekspartitioner, og læsning af én af dem returnerer halvdelen af tabellen.
- Hyppigt opdaterede kolonner. Hver ændring skriver en indekspost og en tombstone til den gamle, så tombstone-ophobning forringer læsninger over tid.
- Forespørgsler uden partitionsnøgle. Uden en sådan skal koordinatoren kontakte alle noder og flette resultaterne sammen, hvilket ikke skaleres, efterhånden som noder tilføjes.
Det holdbare alternativ er en anden tabel, der er indtastet af den kolonne, der skal søges i, og som skrives samtidig med den første. Det følger forespørgsels-først-princippet, der er beskrevet i Cassandra regler for datamodeller, og den gemmer hver læsning til en enkelt partition på en enkelt node.
Som en arbejdsregel passer et indeks til en kolonne med moderat kardinalitet, der forespørges sammen med en kendt partitionsnøgle. Alt uden for denne beskrivelse er bedre tjent med en specialbygget tabel.
