
TensorFlow ile Doğrusal Regresyon Eğitimi [Örnekler]
 Evelyn Clarke
⚡ Akıllı Özet
TensorFlow'da doğrusal regresyon, sayısal özellikler ile sürekli bir hedef değer arasındaki ilişkiyi modeller. Bu kılavuz, Pandas, NumPy ve LinearRegressor tahmincisi ile yerel TensorFlow giriş işlem hatlarını kullanarak Boston konut fiyatı tahmincisi modelini üç ayrı şekilde eğitmeyi göstermektedir.
Doğrusal Regresyon nedir?
Doğrusal regresyon İki değişken arasındaki ilişkileri modellemek için kullanılan bir istatistik yaklaşımıdır. Bu modelleme, skaler bir yanıt değişkeni ile bir veya daha fazla açıklayıcı değişken arasında yapılır. Tek bir açıklayıcı değişkenle olan ilişkiye basit doğrusal regresyon, birden fazla açıklayıcı değişkenle olan ilişkiye ise çoklu doğrusal regresyon denir.
TensorFlow, hesaplamalar üzerinde tam kontrole sahip olmanızı sağlayacak araçlar sağlar. Bu, düşük seviyeli API ile yapılır. Üstelik TensorFlow, birçok işlemi gerçekleştirmek için çok çeşitli API'lerle donatılmıştır. makine öğrenme Algoritmalar. Bu, üst düzey API'dir ve TensorFlow bunlara tahminciler der.
- Düşük seviyeli APIModelin mimarisini ve optimizasyonunu sıfırdan oluşturmak. Bu, yeni başlayanlar için karmaşık bir iştir.
- Üst düzey APIAlgoritmayı tanımlayın. Kullanıcı dostudur. TensorFlow, "toolbox" adı verilen bir araç kutusu sağlar. tahminci inşa etmek, eğitmek, değerlendirmek ve tahminde bulunmak.
Bu eğitimde şunları kullanacaksınız: yalnızca tahmincilerHesaplamalar daha hızlı ve uygulanması daha kolaydır. İlk bölümde, TensorFlow'da doğrusal regresyonu eğitmek için gradyan iniş optimizasyon algoritmasının nasıl kullanılacağı açıklanmaktadır. İkinci bölümde ise, TensorFlow tahmincisi kullanarak Boston veri setini kullanarak bir evin fiyatını tahmin edeceksiniz.
Doğrusal regresyon modeli nasıl eğitilir
Modeli eğitmeye başlamadan önce, doğrusal regresyonun aslında ne olduğuna bir göz atalım.
İki değişkeniniz olduğunu, x ve y, ve göreviniz x'in değerini bilerek y'nin değerini tahmin etmek olduğunu hayal edin. Verileri grafiğe dökerseniz, aşağıdaki saçılım grafiğinde gösterildiği gibi, bağımsız değişkeniniz x ile bağımlı değişkeniniz y arasında pozitif bir ilişki olduğunu görebilirsiniz.

x=1 olduğunda y'nin yaklaşık 6'ya, x=2 olduğunda ise y'nin yaklaşık 8.5'e eşit olacağını gözlemleyebilirsiniz.
Bu yöntem çok doğru bir yöntem değildir ve özellikle yüz binlerce nokta içeren bir veri kümesinde hataya yatkındır.
Doğrusal bir regresyon bir denklemle değerlendirilir. Y değişkeni bir veya daha fazla ortak değişkenle açıklanır. Örneğinizde yalnızca bir bağımlı değişken var. Bu denklemi yazmanız gerekirse, şöyle olacaktır:

İle:
 Bu, sapmadır. Yani, eğer x=0 ise, y=
 x ile ilişkili ağırlıktır.
 Bu, modelin hatası veya kalıntısıdır. Modelin verilerden öğrenemediği şeyleri içerir.
Modele uyduğunuzu ve aşağıdaki çözümü bulduğunuzu hayal edin:
- = 3.8
- = 2.78
Bu sayıları denklemde değiştirebilirsiniz ve sonuç şu şekilde olur:
y= 3.8 + 2.78x
Artık y değerlerini bulmak için daha iyi bir yönteminiz var. Yani, y'yi tahmin etmek için x'i istediğiniz herhangi bir değerle değiştirebilirsiniz. Aşağıdaki resimde, denklemdeki x'i veri kümesindeki tüm değerlerle değiştirdik ve sonucu grafiğe döktük.

Kırmızı çizgi, her x değeri için y değerlerini, yani tahmin edilen değeri temsil eder. y'yi tahmin etmek için x değerini görmenize gerek yoktur; her x için kırmızı çizgiye ait bir değer vardır. Ayrıca 2'den büyük x değerleri için de tahmin yapabilirsiniz.
Doğrusal regresyonu daha fazla kovaryata genişletmek isterseniz, modele daha fazla değişken ekleyerek bunu yapabilirsiniz. Geleneksel analiz ile doğrusal regresyon arasındaki fark, doğrusal regresyonun her bir x değişkeni için y'nin nasıl tepki vereceğine bağımsız olarak bakmasıdır.
Bir örnek üzerinden ilerleyelim. Bir dondurma dükkanının satışlarını tahmin etmek istediğinizi düşünün. Veri seti, hava durumu (yağmurlu, güneşli, bulutlu) ve müşteri bilgileri (maaş, cinsiyet, medeni durum) gibi farklı bilgiler içeriyor.
Geleneksel analiz, örneğin her değişken için ortalama hesaplayarak ve farklı senaryolar için satışı tahmin etmeye çalışarak satışı öngörmeye çalışacaktır. Bu, zayıf tahminlere yol açacak ve analizi seçilen senaryoyla sınırlayacaktır.
Doğrusal regresyon kullanırsanız şu denklemi yazabilirsiniz:
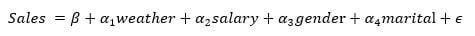
Algoritma, ağırlıklar için en iyi çözümü bulacaktır; yani, uydurulan çizgi ile veri noktaları arasındaki fark olan maliyeti en aza indirmeye çalışacaktır.
Algoritma nasıl çalışır?
Aşağıdaki diyagram, algoritmanın tekrarladığı döngüyü özetlemektedir: ağırlıkları seç, y'yi tahmin et, hatayı ölç ve ağırlıkları düzelt.

Algoritma her biri için rastgele bir sayı seçecektir.  hem de
 ve y'nin tahmin edilen değerini elde etmek için x'in değerini değiştirin. Veri kümesinde 100 gözlem varsa algoritma 100 tahmin edilen değeri hesaplar.
Belirtilen hatayı hesaplayabiliriz  Modelin hata oranı, tahmin edilen değer ile gerçek değer arasındaki farktır. Pozitif bir hata, modelin y'nin tahminini olduğundan düşük gösterdiğini, negatif bir hata ise modelin y'nin tahminini olduğundan yüksek gösterdiğini ifade eder.

Amacınız hatanın karesini en aza indirmektir. Algoritma, hatanın karesinin ortalamasını hesaplar. Bu adıma hatanın en aza indirilmesi denir. Doğrusal regresyon için bu, Ortalama Kare HatasıMSE olarak da adlandırılır. Matematiksel olarak:

Nerede:
 Ağırlıklar bunlar, yani
 tahmin edilen değeri ifade eder
- y gerçek değerlerdir
- m, gözlem sayısıdır.
 tahmin edilen değeri ifade eder
Bunu not et  matrislerin devriğini kullandığı anlamına gelir.
 ortalamanın matematiksel gösterimidir.
Amaç en iyiyi bulmak  Bu, MSE'yi en aza indirir.
Ortalama hatanın büyük olması modelin kötü performans gösterdiği ve ağırlıkların doğru seçilmediği anlamına gelir. Ağırlıkları düzeltmek için bir optimize edici kullanmanız gerekir. Geleneksel optimize ediciye denir Dereceli alçalma.
Gradyan iniş algoritması türevi alır ve ağırlığı azaltır veya artırır. Türev pozitifse, ağırlık azaltılır. Türev negatifse, ağırlık artırılır. Model ağırlıkları günceller ve hatayı yeniden hesaplar. Bu işlem, hata artık değişmeyene kadar tekrarlanır. Her geçişe "eğimli iniş" denir. tekrarlamaAyrıca, gradyanlar öğrenme hızını gösteren bir öğrenme oranıyla çarpılır.
Öğrenme oranı çok düşükse, algoritmanın yakınsaması çok uzun sürer çünkü çok daha fazla yineleme gerektirir. Öğrenme oranı çok yüksekse, algoritma asla yakınsamayabilir. Aşağıdaki kayıp eğrisi, bu veri seti için hata ile yineleme sayısı arasındaki ilişkiyi göstermektedir.

Yukarıdaki resimde de görülebileceği gibi, model ağırlıklar için istikrarlı bir değer bulana kadar işlemi yaklaşık 20 kez tekrarlıyor ve böylece en düşük hataya ulaşıyor.
Hatanın sıfıra eşit olmadığını, ancak 5 civarında sabitlendiğini unutmayın. Bu, modelin tipik olarak 5 hata verdiğini gösterir. Hatayı azaltmak istiyorsanız, modele daha fazla değişken gibi daha fazla bilgi eklemeniz veya farklı tahminciler kullanmanız gerekir.
İlk denklemi hatırlıyorsunuz:

Son ağırlıklar 3.8 ve 2.78'dir. Aşağıdaki video, gradyan iniş yönteminin bu ağırlıkları bulmak için kayıp fonksiyonunu nasıl optimize ettiğini göstermektedir.
TensorFlow ile Doğrusal Regresyon nasıl eğitilir
Artık arka planda neler olduğunu daha iyi anladığınıza göre, TensorFlow kullanarak ilk doğrusal regresyonunuzu eğitmek için TensorFlow tarafından sağlanan tahmin aracı API'sini kullanmaya hazırsınız.
Sürüm notu: Aşağıda gösterilen tahminleyici iş akışı, TensorFlow 1.x ve 2.x'in ilk sürümlerine göre yazılmıştır. TensorFlow, tf.estimator hem de tf.feature_column API'ler 2.12 sürümünde tamamen kullanımdan kaldırıldı ve Estimator'lar 2.16 sürümünde kaldırıldı. Mevcut bir kurulumda, bu kodu TensorFlow 1.15 veya 2.x-with- içinde çalıştırın.tf.compat.v1 ya da Keras'a taşıyın, burada tf.keras.layers.Dense(1) Ayrıca ön işleme katmanları, LinearRegressor ve özellik sütunlarının yerini alıyor. Özellikler, etiketler, gruplar, dönemler, MSE ve gradyan inişi gibi kavramlar değişmeden kalıyor.
Aşağıdaki değişkenleri içeren Boston Veri Setini kullanacaksınız.
| Değişken | Açıklama |
| suç | Şehirlere göre kişi başına düşen suç oranı |
| zn | 25,000 metrekarenin üzerindeki parseller için imar edilen konut arazilerinin oranı. |
| indus | kasaba başına perakende olmayan iş alanı oranı. |
| nox | nitrik oksit konsantrasyonu |
| rm | konut başına ortalama oda sayısı |
| yaş | 1940'tan önce inşa edilen, sahibi tarafından kullanılan birimlerin oranı |
| dis | beş Boston istihdam merkezine olan ağırlıklı mesafeler |
| vergi | Dolar başına tam değerli emlak vergisi oranı 10,000 |
| ptratio | şehre göre öğrenci-öğretmen oranı |
| Medv | Sahibi tarafından kullanılan evlerin ortalama değeri bin dolar |
Üç farklı veri kümesi oluşturacaksınız:
| veri kümesi | nesnel | şekil |
| Eğitim | Modeli eğitin ve ağırlıkları alın | 400, 10 |
| Değerlendirme | Modelin görünmeyen veriler üzerindeki performansını değerlendirin | 100, 10 |
| Tahmin | Yeni verilere göre evin değerini tahmin etmek için modeli kullanın | 6, 10 |
Amaç, veri setindeki özellikleri kullanarak evin değerini tahmin etmektir.
Bu eğitimin ikinci bölümünde, TensorFlow'u kullanarak verileri içe aktarmanın üç farklı yolunu öğreneceksiniz:
- Pandalarla
- İle Dizi
- Sadece TensorFlow
Üç seçeneğin de aynı sonucu verdiğini unutmayın.
TensorFlow doğrusal regresyon modelini oluşturmak, eğitmek ve değerlendirmek için üst düzey API'yi nasıl kullanacağınızı öğreneceksiniz. Alt düzey API'yi kullanıyor olsaydınız, şunları elle tanımlamanız gerekirdi:
- Kayıp fonksiyonu
- Optimizasyon algoritması: gradyan inişi
- Matris çarpımı
- Grafik ve tensör
Bu, yeni başlayanlar için sıkıcı ve daha karmaşık bir süreçtir.
Pandas Çözümü
Modeli eğitmek için gerekli kütüphaneleri içe aktarmanız gerekir.
import pandas as pd
from sklearn import datasets
import tensorflow as tf
import itertools
) 1 Adım Verileri şununla içe aktarın: Pandalar.
Sütun adlarını tanımlayıp COLUMNS değişkenine kaydedersiniz. Verileri içe aktarmak için pd.read_csv() fonksiyonunu kullanabilirsiniz.
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
           "dis", "tax", "ptratio", "medv"]
Her bir çağrıyı daha önce indirdiğiniz CSV dosyalarına yönlendirin.
training_set = pd.read_csv("E:/boston_train.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
test_set = pd.read_csv("E:/boston_test.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
prediction_set = pd.read_csv("E:/boston_predict.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
Verilerin şeklini yazdırabilirsiniz.
print(training_set.shape, test_set.shape, prediction_set.shape)
Çıktı
(400, 10) (100, 10) (6, 10)
Etiketin, yani y'nin, veri setine dahil olduğunu unutmayın. Bu nedenle iki farklı liste tanımlamanız gerekiyor: biri yalnızca özellikleri içeren, diğeri ise yalnızca etiketin adını içeren. Bu iki liste, tahmincinize veri setindeki özelliklerin neler olduğunu ve hangi sütun adının etiket olduğunu söyleyecektir.
Aşağıdaki kod ile yapılıyor.
FEATURES = ["crim", "zn", "indus", "nox", "rm",
                 "age", "dis", "tax", "ptratio"]
LABEL = "medv"
) 2 Adım Verileri dönüştür
Sayısal değişkenleri uygun biçime dönüştürmeniz gerekiyor. TensorFlow, sürekli bir değişkeni dönüştürmek için bir yöntem sunar: tf.feature_column.numeric_column().
Önceki adımda, modele dahil etmek istediğiniz özelliklerin bir listesini tanımladınız. Şimdi bu listeyi kullanarak bunları sayısal verilere dönüştürebilirsiniz. Modelinizden özellikleri hariç tutmak istiyorsanız, feature_cols'u oluşturmadan önce FEATURES listesinden bir veya daha fazla değişkeni çıkarabilirsiniz.
Şunu unutmayın ki, şunu kullanacaksınız: Python `FEATURES` listesiyle liste anlama ifadesi kullanarak `feature_cols` adında yeni bir liste oluşturun. Bu, `tf.feature_column.numeric_column()` ifadesini dokuz kez yazmaktan kaçınmanıza yardımcı olur. Liste anlama ifadesi, yeni listeler oluşturmanın daha hızlı ve daha temiz bir yoludur.
feature_cols = [tf.feature_column.numeric_column(k) for k in FEATURES]
) 3 Adım Tahminciyi tanımlayın
Bu adımda, tahminleyiciyi tanımlamanız gerekiyor. TensorFlow, sınıflandırma görevleri için üç ve TensorFlow regresyon görevleri için üç olmak üzere altı adet önceden oluşturulmuş hazır tahminleyici sunar:
- Regresör
- DNNRegresör
- DoğrusalRegresör
- DNNLinearCombinedRegressor
- sınıflandırmak
- DNN Sınıflandırıcısı
- Doğrusal Sınıflandırıcı
- DNNDoğrusalBirleşik Sınıflandırıcı
Bu derste Doğrusal Regresörü kullanacaksınız. Bu fonksiyona erişmek için tf.estimator'ı kullanmanız gerekir.
Fonksiyonun iki argümana ihtiyacı vardır:
- feature_columns: modele dahil edilecek değişkenleri içerir.
- model_dir: Grafın depolanacağı, model parametrelerinin kaydedileceği vb. yol.
TensorFlow, çalışma dizininizde otomatik olarak "train" adında bir klasör oluşturacaktır. Bu klasöre erişmek için bu yolu kullanmanız gerekmektedir. Tensör KartıAşağıda TensorFlow regresyon örneğinde gösterildiği gibi.
estimator = tf.estimator.LinearRegressor(
        feature_columns=feature_cols,
        model_dir="train")
Çıktı
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a215dc550>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
TensorFlow'un en zor kısmı, modele veri besleme yöntemidir. TensorFlow, paralel hesaplama ve çok büyük veri kümeleriyle çalışmak üzere tasarlanmıştır. Makine kaynaklarının sınırlı olması nedeniyle, modele tüm verileri aynı anda beslemek mümkün değildir. Bunun için, her seferinde bir veri grubu beslemeniz gerekir. Milyonlarca veya daha fazla kayıt içeren devasa veri kümelerinden bahsediyoruz. Eğer veri grubu eklemezseniz, bellek hatasıyla karşılaşacaksınız.
Örneğin, verileriniz 100 gözlem içeriyorsa ve toplu iş boyutunu 10 olarak tanımlarsanız bu, modelin her yinelemede 10 gözlem göreceği anlamına gelir (10*10).
Model tüm verileri gördükten sonra bir epoch'u tamamlar. Bir epoch, modelin verileri kaç kez görmesini istediğinizi tanımlar. Bu adımı "yok" olarak ayarlamak ve modelin belirli sayıda yineleme gerçekleştirmesine izin vermek daha iyidir.
Eklenmesi gereken ikinci bilgi ise, her yinelemeden önce verileri karıştırmak isteyip istemediğinizdir. Eğitim sırasında, modelin veri kümesinin belirli bir örüntüsünü öğrenmemesi için verilerin karıştırılması önemlidir. Model, verilerin altında yatan örüntünün ayrıntılarını öğrenirse, görülmemiş veriler için tahmini genelleştirmekte zorlanacaktır. Buna aşırı uyum (overfitting) denir. Model eğitim verilerinde iyi performans gösterir ancak görülmemiş veriler için doğru tahmin yapamaz.
TensorFlow bu iki adımı kolaylaştırır. Veriler işlem hattına girdiğinde, kaç gözleme (toplu işlem) ihtiyaç duyduğunu ve verileri karıştırması gerekip gerekmediğini bilir.
TensorFlow'a modeli nasıl besleyeceğini belirtmek için `pandas_input_fn` kullanabilirsiniz. Bu nesne beş parametre gerektirir:
- x: özellik verileri
- y: etiket verileri
- toplu iş_boyutu: toplu iş. Varsayılan olarak 128
- num_epoch: epoch sayısı, varsayılan değer 1
- Karıştır: Verileri karıştırıp karıştırmayacağınızı belirtir. Varsayılan olarak, Hiçbiri.
Modeli birçok kez beslemeniz gerekiyor, bu nedenle bu işlemi tekrarlayacak bir fonksiyon tanımlıyorsunuz. Bu fonksiyona get_input_fn adını verin.
def get_input_fn(data_set, num_epochs=None, n_batch = 128, shuffle=True):
         return tf.estimator.inputs.pandas_input_fn(
         x=pd.DataFrame({k: data_set[k].values for k in FEATURES}),
         y = pd.Series(data_set[LABEL].values),
         batch_size=n_batch,
         num_epochs=num_epochs,
         shuffle=shuffle)
Bir modelin performansını değerlendirmenin genel yöntemi şudur:
- Modeli eğitin
- Modeli farklı bir veri kümesi üzerinde değerlendirin.
- Bir tahminde bulunun
TensorFlow tahmincisi, bu üç adımı kolayca gerçekleştirmek için üç farklı fonksiyon sunar.
) 4 Adım Modeli eğitin
Modeli eğitmek için `train` tahmincisi yöntemini kullanabilirsiniz. `train` tahmincisi bir `input_fn` ve adım sayısına ihtiyaç duyar. Yukarıda oluşturduğunuz fonksiyonu modele besleyebilirsiniz. Ardından modele 1000 kez tekrarlama talimatı verin. Epoch sayısını belirtmediğinizi, modelin 1000 kez tekrarlamasına izin verdiğinizi unutmayın. Epoch sayısını 1 olarak ayarlarsanız, eğitim setinde 400 kayıt ve batch boyutu 128 olduğu için model dört kez tekrarlayacaktır.
- 128 satır
- 128 satır
- 128 satır
- 16 satır
Bu nedenle, aşağıda yer alan TensorFlow sınıflandırma örneğinde gösterildiği gibi, epoch sayısını "yok" olarak ayarlamak ve yineleme sayısını tanımlamak daha kolaydır.
estimator.train(input_fn=get_input_fn(training_set,
                                           num_epochs=None,
                                           n_batch = 128,
                                           shuffle=False),
                                           steps=1000)
Çıktı
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 238.616
INFO:tensorflow:loss = 13909.657, step = 101 (0.420 sec)
INFO:tensorflow:global_step/sec: 314.293
INFO:tensorflow:loss = 12881.449, step = 201 (0.320 sec)
INFO:tensorflow:global_step/sec: 303.863
INFO:tensorflow:loss = 12391.541, step = 301 (0.327 sec)
INFO:tensorflow:global_step/sec: 308.782
INFO:tensorflow:loss = 12050.5625, step = 401 (0.326 sec)
INFO:tensorflow:global_step/sec: 244.969
INFO:tensorflow:loss = 11766.134, step = 501 (0.407 sec)
INFO:tensorflow:global_step/sec: 155.966
INFO:tensorflow:loss = 11509.922, step = 601 (0.641 sec)
INFO:tensorflow:global_step/sec: 263.256
INFO:tensorflow:loss = 11272.889, step = 701 (0.379 sec)
INFO:tensorflow:global_step/sec: 254.112
INFO:tensorflow:loss = 11051.9795, step = 801 (0.396 sec)
INFO:tensorflow:global_step/sec: 292.405
INFO:tensorflow:loss = 10845.855, step = 901 (0.341 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
TensorBoard'u aşağıdaki komutla kontrol edebilirsiniz:
activate hello-tf
# For MacOS
tensorboard --logdir=./train
# For Windows
tensorboard --logdir=train
) 5 Adım Modelinizi değerlendirin
Aşağıdaki kod ile modelinizin test setine uyumunu değerlendirebilirsiniz:
ev = estimator.evaluate(
          input_fn=get_input_fn(test_set,
          num_epochs=1,
          n_batch = 128,
          shuffle=False))
Çıktı
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
Kaybı aşağıdaki kodla yazdırabilirsiniz:
loss_score = ev["loss"]
print("Loss: {0:f}".format(loss_score))
Çıktı
Loss: 3215.895996
Modelin kaybı 3215'tir. Hatanın ne kadar büyük olduğunu anlamak için özet istatistiklerine bakabilirsiniz.
training_set['medv'].describe()
Çıktı
count    400.000000
mean      22.625500
std        9.572593
min        5.000000
25%       16.600000
50%       21.400000
75%       25.025000
max       50.000000
Name: medv, dtype: float64
Yukarıdaki özet istatistiklerden, bir evin ortalama fiyatının 22 bin, minimum fiyatının 5 bin ve maksimum fiyatının 50 bin olduğunu biliyorsunuz. Bildirilen kayıp, ortalama karesel hata olduğundan, orijinal birimlerdeki tipik hata yaklaşık olarak 32.16'nın karekökü, yani yaklaşık 5.7 bin dolardır.
) 6 Adım Tahmini yap
Son olarak, TensorFlow'un predict yöntemini kullanarak Boston'daki altı evin değerini tahmin edebilirsiniz.
y = estimator.predict(
         input_fn=get_input_fn(prediction_set,
         num_epochs=1,
         n_batch = 128,
         shuffle=False))
Tahmini değerleri yazdırmak için şu kodu kullanabilirsiniz:
predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
Çıktı
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.96125], dtype=float32), array([27.270979], dtype=float32), array([29.299236], dtype=float32), array([16.436684], dtype=float32), array([21.460876], dtype=float32)]
Model aşağıdaki değerleri tahmin etmektedir:
| ev | Tahmin |
| 1 | 32.29 |
| 2 | 18.96 |
| 3 | 27.27 |
| 4 | 29.29 |
| 5 | 16.43 |
| 6 | 21.46 |
Unutmayın ki bu altı evin gerçek değerini bilmiyoruz. Derin öğrenme eğitiminde, doğrusal modeli alt etmeye çalışacaksınız.
NumPy Çözümü
Bu bölümde, verileri beslemek için bir NumPy tahmincisi kullanarak modeli nasıl eğiteceğiniz açıklanmaktadır. Yöntem aynıdır, ancak numpy_input_fn tahmincisini kullanacaksınız.
Aynı üç CSV dosyasını okuyun, ancak yalnızca .values parametresiyle ham NumPy dizilerini saklayın.
training_set_n = pd.read_csv("E:/boston_train.csv").values
test_set_n = pd.read_csv("E:/boston_test.csv").values
prediction_set_n = pd.read_csv("E:/boston_predict.csv").values
) 1 Adım Verileri içeri aktarın
Öncelikle, özellik değişkenlerini etiketlerden ayırmanız gerekiyor. Bunu hem eğitim verileri hem de değerlendirme verileri için yapmalısınız. Verileri bölmek için bir fonksiyon tanımlamak daha hızlı olacaktır.
def prepare_data(df):
        X_train = df[:, :-3]
        y_train = df[:,-3]
        return X_train, y_train
Bu fonksiyonu kullanarak eğitim ve değerlendirme veri kümelerindeki özelliklerden etiketleri ayırabilirsiniz.
X_train, y_train = prepare_data(training_set_n)
X_test, y_test = prepare_data(test_set_n)
Tahmin veri setinin son sütununu hariç tutmanız gerekiyor çünkü bu sütun yalnızca NaN değerleri içeriyor.
x_predict = prediction_set_n[:, :-2]
Dizinin şeklini doğrulayın. Etiketin ikinci bir boyuta sahip olmaması gerektiğini unutmayın, bu da (400,) anlamına gelir.
print(X_train.shape, y_train.shape, x_predict.shape)
Çıktı
(400, 9) (400,) (6, 9)
Özellik sütunlarını aşağıdaki gibi oluşturabilirsiniz:
feature_columns = [ tf.feature_column.numeric_column('x', shape=X_train.shape[1:])]
Tahminleyici daha önce olduğu gibi tanımlanır: özellik sütunlarını ve grafiğin kaydedileceği yeri belirtirsiniz.
estimator = tf.estimator.LinearRegressor(
         feature_columns=feature_columns,
         model_dir="train1")
Çıktı
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train1', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a218d8f28>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Verileri modele beslemek ve ardından modeli eğitmek için NumPy tahminleyicisini kullanabilirsiniz. Okunabilirliği kolaylaştırmak için input_fn fonksiyonunu önceden tanımladığımızı unutmayın.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
           x={"x": X_train},
           y=y_train,
           batch_size=128,
           shuffle=False,
           num_epochs=None)
estimator.train(input_fn = train_input,steps=5000)
Çıktı
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train1/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 490.057
INFO:tensorflow:loss = 13909.656, step = 101 (0.206 sec)
INFO:tensorflow:global_step/sec: 788.986
INFO:tensorflow:loss = 12881.45, step = 201 (0.126 sec)
INFO:tensorflow:global_step/sec: 736.339
INFO:tensorflow:loss = 12391.541, step = 301 (0.136 sec)
INFO:tensorflow:global_step/sec: 383.305
INFO:tensorflow:loss = 12050.561, step = 401 (0.260 sec)
INFO:tensorflow:global_step/sec: 859.832
INFO:tensorflow:loss = 11766.133, step = 501 (0.117 sec)
INFO:tensorflow:global_step/sec: 804.394
INFO:tensorflow:loss = 11509.918, step = 601 (0.125 sec)
INFO:tensorflow:global_step/sec: 753.059
INFO:tensorflow:loss = 11272.891, step = 701 (0.134 sec)
INFO:tensorflow:global_step/sec: 402.165
INFO:tensorflow:loss = 11051.979, step = 801 (0.248 sec)
INFO:tensorflow:global_step/sec: 344.022
INFO:tensorflow:loss = 10845.854, step = 901 (0.288 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train1/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.985.
Out[23]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x1a1b6ea860>
Modelinizi değerlendirmek için aynı adımı farklı bir giriş fonksiyonuyla tekrarlarsınız.
eval_input = tf.estimator.inputs.numpy_input_fn(
       x={"x": X_test},
       y=y_test,
       shuffle=False,
       batch_size=128,
       num_epochs=1)
   estimator.evaluate(eval_input,steps=None)
Çıktı
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.158947, global_step = 1000, loss = 3215.8945
Out[24]:
{'average_loss': 32.158947, 'global_step': 1000, 'loss': 3215.8945}
Son olarak, tahmini hesaplayabilirsiniz. Sonuç, Pandas sonucuna benzer olmalıdır.
test_input = tf.estimator.inputs.numpy_input_fn(
        x={"x": x_predict},
        batch_size=128,
        num_epochs=1,
        shuffle=False)
        y = estimator.predict(test_input)

predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
Çıktı
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.961248], dtype=float32), array([27.270979], dtype=float32), array([29.299242], dtype=float32), array([16.43668], dtype=float32), array([21.460878], dtype=float32)]
TensorFlow Çözümü
Son bölüm tamamen saf bir konuya ayrılmıştır. TensorFlow Çözüm. Bu yöntem diğer ikisine göre biraz daha karmaşık.
Şunu unutmayın ki, eğer bir Jupyter defterBu oturumu çalıştırmak için sistemi yeniden başlatmanız ve çekirdeği temizlemeniz gerekiyor.
TensorFlow, verileri işlem hattına aktarmak için harika bir araç geliştirdi. Bu bölümde, input_fn fonksiyonunu kendiniz oluşturacaksınız.
) 1 Adım Verinin yolunu ve biçimini tanımlayın
Öncelikle, CSV dosyalarının yolunu içeren iki değişken tanımlıyorsunuz. Eğitim seti ve test seti için iki dosyanız olduğunu unutmayın.
import tensorflow as tf
df_train = "E:/boston_train.csv"
df_eval = "E:/boston_test.csv"
Ardından CSV dosyasından kullanmak istediğiniz sütunları tanımlamanız gerekiyor. Hepsini kullanacağız. Bundan sonra, her değişkenin türünü belirtmeniz gerekiyor.
Kayan noktalı değişkenler [0.] ile tanımlanır.
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
                "dis", "tax", "ptratio", "medv"]
RECORDS_ALL = [[0.0], [0.0], [0.0], [0.0],[0.0],[0.0],[0.0],[0.0],[0.0],[0.0]]
) 2 Adım input_fn işlevini tanımlayın
Bu fonksiyon üç bölüme ayrılabilir:
- Verileri içeri aktarın
- Yineleyiciyi oluştur
- Verileri tüketin
Aşağıda fonksiyonu tanımlayan genel kod bulunmaktadır. Kodun açıklaması daha sonra verilecektir.
def input_fn(data_file, batch_size, num_epoch = None):
       # Step 1
          def parse_csv(value):
          columns = tf.decode_csv(value, record_defaults= RECORDS_ALL)
          features = dict(zip(COLUMNS, columns))
          #labels = features.pop('median_house_value')
          labels =  features.pop('medv')
          return features, labels

          # Extract lines from input files using the Dataset API.
          dataset = (tf.data.TextLineDataset(data_file) # Read text file
          .skip(1) # Skip header row
          .map(parse_csv))

          dataset = dataset.repeat(num_epoch)
          dataset = dataset.batch(batch_size)
          # Step 3
          iterator = dataset.make_one_shot_iterator()
          features, labels = iterator.get_next()
          return features, labels
Verileri içeri aktarın
CSV dosyaları için, `dataset` yöntemi her seferinde bir satır okur. Veri kümesini oluşturmak için, nesneyi kullanmanız gerekir. TextLineVeri kümesi. Veri kümenizin bir başlığı var, bu nedenle ilk satırı atlamak için skip(1) kullanmanız gerekiyor. Bu noktada, yalnızca verileri okuyorsunuz ve başlığı işlem hattından çıkarıyorsunuz. Modeli beslemek için, özellikleri etiketten ayırmanız gerekiyor. Verilere herhangi bir dönüşüm uygulamak için kullanılan yöntem map'tir.
Bu yöntem, verilerin nasıl dönüştürüleceğini belirtmek için oluşturacağınız bir fonksiyonu çağırır. Kısacası, verileri bu fonksiyona iletmeniz gerekiyor. TextLineVeri kümesi nesnesini alın, başlığı hariç tutun ve bir fonksiyon tarafından yönlendirilen bir dönüşümü uygulayın.
Code açıklama
- tf.data.TextLineVeri kümesi (veri_dosyası): bu satır CSV dosyasını okur.
- .skip(1): başlığı atlar
- .map(parse_csv)): kayıtları tensörlere ayrıştırır
Harita nesnesine talimat verecek bir fonksiyon tanımlamanız gerekiyor. Bu fonksiyona parse_csv adını verebilirsiniz.
Bu fonksiyon, `tf.decode_csv` metodu ile CSV dosyasını ayrıştırır ve özellikleri ve etiketi tanımlar. Özellikler sözlük veya demet olarak tanımlanabilir. Sözlük metodu daha kullanışlı olduğu için tercih edilmiştir.
Code açıklama
- tf.decode_csv(value, Record_defaults= RECORDS_ALL): decode_csv yöntemi, çıktıyı kullanır. TextLineCSV dosyasını okumak için veri seti. `record_defaults`, TensorFlow'a sütun türleri hakkında bilgi verir. TensorFlow 2.x'te bu sembol `tf.io.decode_csv` adresinde bulunur.
- dict(zip(COLUMNS, columns)): sözlüğü tüm sütunlarla doldurur.tracBu veri işleme sırasında ted
- features.pop('medv'): Hedef değişkeni özellik değişkenlerinden çıkarır ve bir etiket değişkeni oluşturur.
Veri kümesinin, tensörleri yinelemeli olarak beslemek için daha fazla öğeye ihtiyacı var. Aslında, veri kümesinin modele süresiz olarak veri beslemeye devam etmesini sağlamak için `repeat` yöntemini eklemeniz gerekiyor. Bu yöntemi eklemezseniz, model yalnızca bir kez yineleme yapacak ve daha fazla veri işleme hattına beslenmediği için bir hata verecektir.
Bundan sonra, batch yöntemiyle batch boyutunu kontrol edebilirsiniz. Bu, her yineleme için işlem hattına ne kadar veri geçirmek istediğinizi veri kümesine bildirmeniz anlamına gelir. Büyük bir batch boyutu ayarlarsanız, model yavaşlayacaktır.
) 3 Adım Yineleyiciyi oluştur
Artık ikinci adıma hazırsınız: veri kümesindeki öğeleri döndürecek bir yineleyici oluşturun.
Operatör oluşturmanın en basit yolu make_one_shot_iterator yöntemidir.
Bundan sonra yineleyiciden özellikleri ve etiketleri oluşturabilirsiniz.
) 4 Adım Verileri tüketin
input_fn fonksiyonuyla neler olduğunu kontrol edebilirsiniz. Verileri kullanmak için fonksiyonu bir oturumda çağırmanız gerekiyor. Toplu işlem boyutunu 1 olarak ayarlayarak deneyin.
Özellikleri bir sözlük, etiketi ise bir dizi olarak yazdırdığına dikkat edin.
Bu, CSV dosyasının ilk satırını gösterecektir. Bu kodu farklı toplu işlem boyutlarıyla birçok kez çalıştırmayı deneyebilirsiniz.
next_batch = input_fn(df_train, batch_size = 1, num_epoch = None)
with tf.Session() as sess:
     first_batch  = sess.run(next_batch)
     print(first_batch)
Çıktı
({'crim': array([2.3004], dtype=float32), 'zn': array([0.], dtype=float32), 'indus': array([19.58], dtype=float32), 'nox': array([0.605], dtype=float32), 'rm': array([6.319], dtype=float32), 'age': array([96.1], dtype=float32), 'dis': array([2.1], dtype=float32), 'tax': array([403.], dtype=float32), 'ptratio': array([14.7], dtype=float32)}, array([23.8], dtype=float32))
) 5 Adım Özellik sütununu tanımlayın
Sayısal sütunları aşağıdaki gibi tanımlamanız gerekiyor:
X1= tf.feature_column.numeric_column('crim')
X2= tf.feature_column.numeric_column('zn')
X3= tf.feature_column.numeric_column('indus')
X4= tf.feature_column.numeric_column('nox')
X5= tf.feature_column.numeric_column('rm')
X6= tf.feature_column.numeric_column('age')
X7= tf.feature_column.numeric_column('dis')
X8= tf.feature_column.numeric_column('tax')
X9= tf.feature_column.numeric_column('ptratio')
Tüm değişkenleri tek bir grupta birleştirmeniz gerektiğini unutmayın.
base_columns = [X1, X2, X3,X4, X5, X6,X7, X8, X9]
) 6 Adım Modeli oluşturun
Modeli LinearRegressor tahmincisi ile eğitebilirsiniz.
model = tf.estimator.LinearRegressor(feature_columns=base_columns, model_dir='train3')
Çıktı
INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_model_dir': 'train3', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1820a010f0>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
bir kullanmanız gerekir lambda işlevi Bu, input_fn fonksiyonuna argümanlar yazmanıza olanak tanır. Lambda fonksiyonu kullanmazsanız, modeli eğitemezsiniz.
# Train the estimator
model.train(steps =1000,
          input_fn= lambda : input_fn(df_train,batch_size=128, num_epoch = None))
Çıktı
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train3/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 72.5646
INFO:tensorflow:loss = 13909.657, step = 101 (1.380 sec)
INFO:tensorflow:global_step/sec: 101.355
INFO:tensorflow:loss = 12881.449, step = 201 (0.986 sec)
INFO:tensorflow:global_step/sec: 109.293
INFO:tensorflow:loss = 12391.541, step = 301 (0.915 sec)
INFO:tensorflow:global_step/sec: 102.235
INFO:tensorflow:loss = 12050.5625, step = 401 (0.978 sec)
INFO:tensorflow:global_step/sec: 104.656
INFO:tensorflow:loss = 11766.134, step = 501 (0.956 sec)
INFO:tensorflow:global_step/sec: 106.697
INFO:tensorflow:loss = 11509.922, step = 601 (0.938 sec)
INFO:tensorflow:global_step/sec: 118.454
INFO:tensorflow:loss = 11272.889, step = 701 (0.844 sec)
INFO:tensorflow:global_step/sec: 114.947
INFO:tensorflow:loss = 11051.9795, step = 801 (0.870 sec)
INFO:tensorflow:global_step/sec: 111.484
INFO:tensorflow:loss = 10845.855, step = 901 (0.897 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train3/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Out[8]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x18225eb8d0>
Aşağıdaki kod ile modelinizin test setine uyumunu değerlendirebilirsiniz:
results = model.evaluate(steps =None,input_fn=lambda: input_fn(df_eval, batch_size =128, num_epoch = 1))
for key in results:
print("   {}, was: {}".format(key, results[key]))
Çıktı
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
   average_loss, was: 32.158958435058594
   loss, was: 3215.89599609375
   global_step, was: 1000
Son adım, özellik matrisinin değerine dayanarak hedef değerini tahmin etmektir. Tahmin etmek istediğiniz değerleri içeren bir sözlük yazabilirsiniz. Modelinizin dokuz özelliği olduğundan, her biri için bir değer sağlamanız gerekir. Model, bunların her biri için bir tahmin sunacaktır.
Aşağıdaki kodda, df_predict CSV dosyasında bulunan her bir özelliğin değerlerini yazıyorsunuz.
Veri kümesinde etiket bulunmadığı için yeni bir input_fn fonksiyonu yazmanız gerekiyor. Bunun için Dataset nesnesinden from_tensors API'sini kullanabilirsiniz.
prediction_input = {
          'crim': [0.03359,5.09017,0.12650,0.05515,8.15174,0.24522],
          'zn': [75.0,0.0,25.0,33.0,0.0,0.0],
          'indus': [2.95,18.10,5.13,2.18,18.10,9.90],
          'nox': [0.428,0.713,0.453,0.472,0.700,0.544],
          'rm': [7.024,6.297,6.762,7.236,5.390,5.782],
          'age': [15.8,91.8,43.4,41.1,98.9,71.7],
          'dis': [5.4011,2.3682,7.9809,4.0220,1.7281,4.0317],
          'tax': [252,666,284,222,666,304],
          'ptratio': [18.3,20.2,19.7,18.4,20.2,18.4]
     }
     def test_input_fn():
     dataset = tf.data.Dataset.from_tensors(prediction_input)
     return dataset

     # Predict all our prediction_input
     pred_results = model.predict(input_fn=test_input_fn)
Son olarak, tahminleri yazdırıyorsunuz.
for pred in enumerate(pred_results):
print(pred)
Çıktı
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
(0, {'predictions': array([32.297546], dtype=float32)})
(1, {'predictions': array([18.96125], dtype=float32)})
(2, {'predictions': array([27.270979], dtype=float32)})
(3, {'predictions': array([29.299236], dtype=float32)})
(4, {'predictions': array([16.436684], dtype=float32)})
(5, {'predictions': array([21.460876], dtype=float32)})

INFO:tensorflow:Calling model_fn. INFO:tensorflow:Done calling model_fn. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from train3/model.ckpt-5000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. (0, {'predictions': array([35.60663], dtype=float32)}) (1, {'predictions': array([22.298521], dtype=float32)}) (2, {'predictions': array([25.74533], dtype=float32)}) (3, {'predictions': array([35.126694], dtype=float32)}) (4, {'predictions': array([17.94416], dtype=float32)}) (5, {'predictions': array([22.606628], dtype=float32)})
Her üç işlem hattı da aynı altı tahmini döndürüyor; bu da Pandas, NumPy ve yerel TensorFlow veri seti arasındaki seçimin doğruluktan ziyade kolaylık meselesi olduğunu doğruluyor.
