
TensorFlow ile Yapay Sinir Ağı (YSA) Eğitimi
 Editoryal Takım
⚡ Akıllı Özet
Yapay sinir ağları, girdiyi bağlantılı katmanlardan geçirerek, sonucu bir kayıp fonksiyonuyla puanlayarak ve ağırlıkları bir optimize ediciyle düzelterek öğrenir. Bu kılavuz, TensorFlow'da bir yapay sinir ağı oluşturmayı ve MNIST rakamlarını sınıflandırmayı göstermektedir.
Yapay Sinir Ağı Nedir?
An Yapay Sinir Ağı (YSA) Yapay sinir ağı, yapay nöron adı verilen bağlantılı birimlerin bir araya gelmesiyle yapay beyinler oluşturmak için biyolojik sinir ağlarından esinlenilmiş bir bilgisayar sistemidir. İnsanların yaptığı gibi bilgiyi analiz etmek ve işlemek üzere tasarlanmıştır. Yapay sinir ağı, daha fazla veri mevcut olduğunda daha iyi sonuçlar üretmek için kendi kendine öğrenme yeteneğine sahiptir.
Aşağıdaki diyagram tracBu, ham girdiden ağırlıkları düzelten optimize ediciye kadar, böyle bir ağdan geçen tam bir geçiş anlamına gelir.

Yapay Sinir Ağı (YSA) dört ana nesneden oluşur:
- Katmanlar: Öğrenmenin tamamı katmanlarda gerçekleşir. 3 katman vardır: 1) Giriş, 2) Gizli ve 3) Çıkış
- Özellik ve etiket: Ağa giren veriler (özellikler) ve ağdan çıkan veriler (etiketler)
- Kayıp fonksiyonu: Öğrenme aşamasının performansını tahmin etmek için kullanılan ölçüt.
- Optimize Edici: Ağdaki bilgileri güncelleyerek öğrenme sürecini iyileştirin.
Bir sinir ağı, girdi verilerini alır ve katmanlar topluluğuna iletir. Ardından ağ, performansını bir kayıp fonksiyonu ile değerlendirir. Kayıp fonksiyonu, ağın bilgiyi öğrenmeden önce izlemesi gereken yol hakkında bir fikir verir. Ağ, bir optimizasyon algoritması yardımıyla bu bilgiyi geliştirir.
Yukarıdaki şekle bakarsanız altta yatan mekanizmayı anlayacaksınız.
Program, bazı girdi değerlerini alır ve bunları iki tam bağlantılı katmana iletir. Bir matematik probleminiz olduğunu hayal edin. İlk yapacağınız şey, problemi çözmek için ilgili bölümü okumaktır. Ardından yeni bilginizi probleme uygularsınız. Çok iyi bir sonuç alma olasılığınız düşüktür. Ağ için de durum aynıdır: Veriyi ilk gördüğünde ve bir tahmin yaptığında, sonuç gerçek verilerle mükemmel bir şekilde eşleşmeyecektir.
Ağ, bilgisini geliştirmek için bir optimizasyon algoritması kullanır. Bu benzetmede, optimizasyon algoritması bir bölümü tekrar okumak olarak düşünülebilir. Tekrar okuyarak yeni bilgiler edinirsiniz. Benzer şekilde, ağ optimizasyon algoritmasını kullanır, bilgisini günceller ve ne kadar daha öğrenmesi gerektiğini kontrol etmek için bu yeni bilgiyi test eder. Program, mümkün olan en düşük hatayı verene kadar bu adımı tekrarlar.
Matematik problemi benzetmesinde, bu, ders içeriğini iyice anlayana kadar ders kitabındaki bölümü birçok kez okuduğunuz anlamına gelir. Birden fazla kez okuduktan sonra bile hata yapmaya devam ediyorsanız, bu, mevcut materyalin bilgi kapasitesine ulaştığınız anlamına gelir. Puanınızı iyileştirmek için farklı bir ders kitabı kullanmanız veya farklı bir yöntem denemeniz gerekir. Sinir ağları için de süreç aynıdır. Hata oranı düşmeyi bırakır ve kayıp eğrisi düzleşirse, mevcut mimari artık hiçbir şey öğrenemez. Bilgiyi geliştirmek için ağın daha iyi optimize edilmesi gerekir.
Bu dört nesne, bir ağ tasarlarken yapılandırdığınız bileşenlere doğrudan karşılık gelir.
Sinir ağı Archidoku
Yapay sinir ağı mimarisi aşağıdaki bileşenlerden oluşmaktadır:
- Katmanlar
- Etkinleştirme işlevi
- Kayıp fonksiyonu
- Doktoru
Katmanlar
Katman, tüm öğrenmenin gerçekleştiği yerdir. Bir katmanın içinde, her biri kendi ağırlığına sahip olan keyfi sayıda nöron bulunur. Tipik bir sinir ağı genellikle yoğun bağlantılı katmanlar (tam bağlantılı katmanlar olarak da adlandırılır) tarafından işlenir. Bu, tüm girdilerin çıktıya bağlı olduğu anlamına gelir.
Tipik bir sinir ağı, girdi olarak bir vektör ve etiketleri içeren bir skaler değer alır. En basit kurulum, yalnızca iki sınıfa sahip ikili bir sınıflandırmadır: 0 ve 1.
Ağ, bir girdi alır, bunu bağlı tüm düğümlere gönderir ve bir aktivasyon fonksiyonu ile sinyali hesaplar. Aşağıdaki numaralı diyagram, ağırlıklı toplamı ve aktivasyon adımını ayrı ayrı görebilmeniz için tek bir düğümü genişletmektedir.

Yukarıdaki şekil bu fikri göstermektedir. Birinci katman giriş değerlerini tutar. Gizli katman olarak adlandırılan ikinci katman, önceki katmandan gelen ağırlıklı girişi alır.
- İlk düğüm giriş değerleridir.
- Nöron, giriş kısmı ve aktivasyon fonksiyonu olmak üzere ikiye ayrılır. Sol kısım, önceki katmandan gelen tüm girdileri alır. Sağ kısım ise, aktivasyon fonksiyonuna aktarılan girdilerin toplamıdır.
- Gizli katmanlardan hesaplanan ve tahmin yapmak için kullanılan çıktı değeri. Sınıflandırma için, sınıf sayısına eşittir. Regresyon için ise yalnızca bir değer tahmin edilir.
Etkinleştirme işlevi
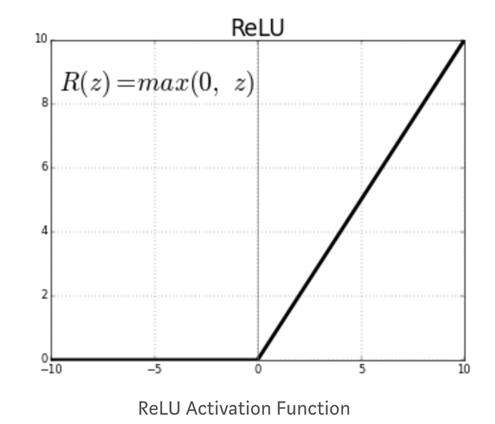
Bir düğümün aktivasyon fonksiyonu, belirli bir girdi kümesi verildiğinde çıktıyı tanımlar. Ağın doğrusal olmayan kalıpları öğrenmesini sağlamak için bir aktivasyon fonksiyonuna ihtiyacınız vardır. Yaygın bir aktivasyon fonksiyonu, Doğrulmuş Doğrusal Birim (ReLU)'dur. Bu fonksiyon, tüm negatif değerler için sıfır verir.
Diğer aktivasyon fonksiyonları şunlardır:
- Parçalı Doğrusal
- sigmoid
- Tan
- Sızdıran ReLU
Aşağıdaki grafik, ReLU'nun neden bu şekilde tanımlandığını gösteriyor: eğri, her negatif giriş için sıfırda düzleşiyor ve sonrasında doğrusal olarak yükseliyor.
Bir sinir ağı oluştururken verilmesi gereken kritik karar:
- Sinir ağında kaç katman var
- Her katman için kaç gizli birim
Çok sayıda katman ve gizli birime sahip sinir ağları, verilerin karmaşık bir temsilini öğrenebilir, ancak bu durum ağın hesaplama yükünü çok pahalı hale getirir.
Kayıp fonksiyonu
Gizli katmanları ve aktivasyon fonksiyonunu tanımladıktan sonra kayıp fonksiyonunu ve optimize ediciyi belirtmeniz gerekir.
İkili sınıflandırma için, ikili çapraz entropi kayıp fonksiyonu kullanmak yaygın bir uygulamadır. doğrusal regresyonBunun için ortalama kare hatasını kullanırsınız.
Kayıp fonksiyonu, optimize edicinin performansını tahmin etmek için önemli bir ölçümdür. Eğitim sırasında bu ölçüm en aza indirilecektir. Karşılaştığınız sorunun türüne bağlı olarak bu miktarı dikkatli bir şekilde seçmeniz gerekir.
Doktoru
Kayıp fonksiyonu, modelin performansının bir ölçüsüdür. Optimizasyon algoritması, kaybı azaltmak için ağın ağırlıklarını iyileştirmeye yardımcı olur. Farklı optimizasyon algoritmaları mevcuttur, ancak en yaygın olanı Stokastik Gradyan İniş'tir.
Geleneksel optimize ediciler şunlardır:
- Momentum optimizasyon
- Nesterov Hızlandırılmış Gradyan
- Ada Grad
- Adam optimizasyonu
ArchiYalnızca mimari özellikler, kullanılabilir bir modelin garantisini vermez.
Sinir Ağının Sınırlamaları
Aşağıda sinir ağlarının sınırlamaları yer almaktadır:
Aşırı uyum gösterme
Karmaşık sinir ağlarında sık karşılaşılan bir sorun, daha önce görülmemiş verilere genelleme yapmanın zorluğudur. Çok sayıda ağırlığa sahip bir sinir ağı, eğitim veri setindeki belirli ayrıntıları çok iyi tanımlayabilir, ancak bu genellikle aşırı uyumlanmaya yol açar. Veriler gruplar içinde dengesiz ise (yani, bazı gruplarda yeterli veri yoksa), ağ eğitim sırasında çok iyi öğrenir ancak bu tür kalıpları daha önce hiç görülmemiş verilere genelleme yeteneğine sahip olmaz.
Burada bir denge söz konusu. makine öğrenme optimizasyon ve genelleme arasında.
- Bir modeli optimize etmek, eğitim veri setindeki kayıpları en aza indiren en iyi parametreleri bulmayı gerektirir.
- Ancak genelleme, modelin görünmeyen veriler için nasıl davrandığını anlatır.
Modelin eğitim verilerindeki belirli ayrıntıları veya istenmeyen kalıpları yakalamasını önlemek için farklı teknikler kullanabilirsiniz. En iyi yöntem, yeterli miktarda veri içeren dengeli bir veri kümesine sahip olmaktır. Aşırı uyumun azaltılması sanatına düzenleme (regularization) denir. Aşağıdaki üç teknik, geleneksel başlangıç noktalarıdır.
| Teknik | Bu, neyi kısıtlıyor? | Bu eğitimdeki tipik ayarlar |
|---|---|---|
| Ağ boyutu | Katman sayısı ve gizli birim sayısı | İki gizli katman, 300 ve 100 birim |
| L1 / L2 ağırlık düzenlemesi | Ağırlık katsayılarının büyüklüğü | l1_regularization_strength ve l2_regularization_strength değerleri 0.01'dir. |
| Bırakmak | Eğitim aşaması başına kapatılan ünitelerin oranı | 0.3'lük bir düşüş |
Ağ boyutu
Çok fazla katman ve gizli birime sahip bir sinir ağının oldukça karmaşık olduğu bilinmektedir. Modelin karmaşıklığını azaltmanın basit bir yolu, boyutunu küçültmektir. Katman sayısını belirlemek için tek bir en iyi uygulama yoktur. Az sayıda katmanla başlamanız ve modelin aşırı uyum sağladığını görene kadar boyutu artırmanız gerekir.
Ağırlık Düzenlemesi
Aşırı uyumun önlenmesi için standart bir teknik, ağın ağırlıklarına kısıtlamalar eklemektir. Kısıtlama, ağın ağırlıklarının yalnızca küçük değerler almasını sağlar. Kısıtlama, hatanın kayıp fonksiyonuna eklenir. İki tür düzenleme vardır:
- L1 (Kement): Maliyet, ağırlık katsayılarının mutlak değerine orantılıdır.
- L2 (Sırt): Maliyet, ağırlık katsayılarının değerinin karesiyle orantılıdır.
Bırakmak
Dropout, garip ama kullanışlı bir tekniktir. Dropout'lu bir ağ, eğitim adımı sırasında bazı birimlerin rastgele kapatılacağı ve böylece çıkış sinyallerinin sıfır olacağı anlamına gelir. [0.1, 1.7, 0.7, -0.9] ağırlık dizisine sahip olduğunuzu düşünün. Sinir ağında dropout varsa, rastgele dağıtılmış 0'larla [0.1, 0, 0, -0.9] haline gelir. Dropout'u kontrol eden parametre, dropout oranıdır. Oran, kaç birimin kapatılacağını tanımlar. 0.2 ile 0.5 arasında bir orana sahip olmak yaygındır.
Küçük bir etkileşimli örnek, eğitim döngüsünü izlemeyi kolaylaştırıyor.
TensorFlow'daki Sinir Ağı Örneği
İşte yapay sinir ağının tipik bir sınıflandırma probleminde nasıl çalıştığını gösteren bir örnek. Her biri rastgele bir değere sahip iki girdi (x1 ve x2) vardır. Çıktı ikili bir sınıftır. Amaç, iki özelliğe dayanarak etiketi sınıflandırmaktır. Bu görevi gerçekleştirmek için sinir ağı mimarisi şu şekilde tanımlanır:
- İki gizli katman
- İlk katmanda dört adet tamamen bağlı nöron bulunur
- İkinci katmanda tamamen bağlı iki nöron bulunur
- Etkinleştirme fonksiyonu bir ReLU'dur.
- Öğrenme oranı 2 olan bir L0.003 Düzenlemesi ekleyin
Ağ, 10'luk bir batch boyutuyla 180 epoch boyunca ağırlıkları optimize edecektir. Aşağıdaki yapay sinir ağı örneği animasyonunda, ağırlıkların zaman içinde nasıl değiştiğini ve ağın sınıflandırma haritasını nasıl iyileştirdiğini görebilirsiniz.ping.

Öncelikle ağ tüm ağırlıklara rastgele değerler atar.
- Rastgele ağırlıklarla, yani optimizasyon yapılmadan, çıktı kaybı 0.453'tür. Aşağıdaki resim, ağı farklı renklerle göstermektedir.
- Genel olarak turuncu renk negatif değerleri, mavi renkler ise pozitif değerleri temsil eder.
- Veri noktaları aynı şekilde gösterilmiştir: mavi olanlar pozitif etiketleri, turuncu olanlar ise negatif etiketleri temsil eder.

İkinci gizli katmanın içinde, çizgiler ağırlıkların işaretine göre renklendirilmiştir. Turuncu çizgiler negatif ağırlıkları, mavi çizgiler ise pozitif ağırlıkları taşır.
Gördüğünüz gibi, çıktı haritasındapingAğ oldukça fazla hata yapıyor. Şimdi optimizasyondan sonra ağın nasıl davrandığına bakalım.
Aşağıdaki yapay sinir ağı örneği resmi, optimize edilmiş ağın sonuçlarını göstermektedir. Öncelikle, ağın veri noktalarını sınıflandırmayı başarıyla öğrendiğini fark edeceksiniz. Önceki resimle karşılaştırıldığında, başlangıçtaki ağırlık -0.43 iken optimizasyon sonrasında -0.95 olmuştur.

Bu fikir, daha fazla gizli katman ve nöron içeren ağlar için genelleştirilebilir. Ayarları kendiniz deneyebilirsiniz. TensorFlow Oyun Alanı.
Aşağıdaki örnekte, aynı fikir gerçek bir veri kümesi üzerinde kod olarak nasıl uygulanıyor gösterilmektedir.
TensorFlow ile Sinir Ağı Nasıl Eğitilir
İşte bir sinir ağını eğitmenin adım adım süreci. TensorFlow API'nin tahmin aracı DNNClassifier'ı kullanan yapay sinir ağı.
İlk sinir ağınızı eğitmek için MNIST veri kümesini kullanacağız. Bir sinir ağını eğitmek TensorFlow Çok karmaşık değil. Ön işleme adımı, önceki eğitimlerdekiyle tamamen aynı görünüyor. Şu şekilde ilerleyeceksiniz:
- Verileri içeri aktarın
- Verileri dönüştürün
- Tensörü oluşturun.
- Modeli oluşturun
- Modeli eğitin ve değerlendirin
- Modeli geliştirin
Sürüm notu: Bu kılavuzdaki kod, TensorFlow 1.x Estimator API'sini hedeflemektedir. tf-estimator paketinin son sürümü TensorFlow 2.15 ile birlikte yayınlanmıştır ve tf.estimator, TensorFlow 2.16'da kaldırılmıştır. Bu adımları güncel bir sürümde çalıştırmak için, ya TensorFlow 2.15'i sabitleyin ya da aynı iki katmanlı ağı tf.keras.layers.Dense ve model.fit() ile yeniden oluşturun.
Adım 1) Verileri içe aktarın
Öncelikle gerekli kütüphaneyi içe aktarmanız gerekiyor. MNIST veri setini şu şekilde içe aktarabilirsiniz: scikit-öğrenme Aşağıda TensorFlow Sinir Ağı örneğinde gösterildiği gibi.
MNIST veri seti, yeni teknikleri veya algoritmaları test etmek için en yaygın kullanılan veri setidir. Her biri 0'dan 9'a kadar el yazısıyla yazılmış bir rakamı gösteren 28×28 piksellik görüntülerden oluşan bir koleksiyondur. Elastik bozulmalarla eğitilmiş derin evrimsel ağlardan oluşan bir komite, test hatasını %0.27'ye kadar düşürdü.
import numpy as np
import tensorflow as tf
np.random.seed(1337)
Orijinal kılavuzda MNIST dosyaları elle indirilmiş ve fetch_mldata komutu bu klasöre yönlendirilmişti.
from sklearn.datasets import fetch_mldata
mnist = fetch_mldata(' /Users/Thomas/Dropbox/Learning/Upwork/tuto_TF/data/mldata/MNIST original')
print(mnist.data.shape)
print(mnist.target.shape)
API notu: mldata.org artık çevrimiçi değil ve fetch_mldata, scikit-learn 0.22 sürümünde kaldırıldı. Mevcut bir kurulumda, yukarıdaki çağrıyı fetch_openml('mnist_784', version=1) ile değiştirin; bu, aynı 70,000 rakamı indirir ve aynı verileri ve hedef özniteliklerini ortaya çıkarır.
Bundan sonra verileri bölüp her iki veri setinin şeklini elde edersiniz.
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(mnist.data, mnist.target, test_size=0.2, random_state=42)
y_train  = y_train.astype(int)
y_test  = y_test.astype(int)
batch_size =len(X_train)

print(X_train.shape, y_train.shape,y_test.shape )
Adım 2) Verileri dönüştürün
Önceki derste, aykırı değerlerin etkisini sınırlamak için verileri dönüştürmeniz gerektiğini öğrendiniz. Bu Sinir Ağları dersinde, min-max ölçekleyici kullanarak verileri dönüştüreceksiniz. Formül şu şekildedir:
(X-min_x)/(max_x - min_x)
scikit-learn'de bunun için zaten bir fonksiyon var: MinMaxScaler().
## resclae
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
# Train
X_train_scaled = scaler.fit_transform(X_train.astype(np.float64))
# test
X_test_scaled = scaler.fit_transform(X_test.astype(np.float64))
Adım 3) Tensörü oluşturun
Artık oluşturma yöntemine aşinasınız. tansörler TensorFlow'da eğitim veri setini sayısal bir sütuna dönüştürebilirsiniz.
feature_columns = [tf.feature_column.numeric_column('x', shape=X_train_scaled.shape[1:])]
Adım 4) Modeli oluşturun
Sinir ağının mimarisi, ilk katman için 300 birim ve ikinci katman için 100 birim olmak üzere 2 gizli katman içerir. Bu değerler bir formülden ziyade deneyime dayanmaktadır. Bunları ayarlayarak ağın doğruluğunu nasıl etkilediklerini görebilirsiniz.
Modeli oluşturmak için DNNClassifier tahminleyicisini kullanıyorsunuz. Eğitim setinde on sınıf olduğu için sınıf sayısını 10 olarak ayarlamanız gerekiyor. Tahminleyici nesnesinin sözdizimine zaten aşinasınız. feature_columns, n_classes ve model_dir argümanları önceki eğitimdekiyle tamamen aynı. hidden_units argümanı yeni: hem katman sayısını hem de her katmanın sinir ağına kaç düğüm bağladığını kontrol ediyor. Aşağıdaki kodda, ilki 300 düğümü, ikincisi 100 düğümü bağlayan iki gizli katman bulunmaktadır.
Tahmin ediciyi oluşturmak için tf.estimator.DNNClassifier'ı aşağıdaki parametrelerle kullanın:
- özellik_sütunları: Ağda kullanılacak sütunları tanımlayın.
- gizli_birimler: Gizli nöron sayısını tanımlayın.
- n_sınıflar: Tahmin edilecek sınıf sayısını tanımlayın.
- model_dir: Yolun tanımını yapın Tensör Kartı
estimator = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    n_classes=10,
    model_dir = '/train/DNN')
Adım 5) Modeli eğitin ve değerlendirin
NumPy giriş fonksiyonunu kullanarak modeli eğitebilir ve değerlendirebilirsiniz.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_train_scaled},
    y=y_train,
    batch_size=50,
    shuffle=False,
    num_epochs=None)
estimator.train(input_fn = train_input,steps=1000)
eval_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_test_scaled},
    y=y_test,
    shuffle=False,
    batch_size=X_test_scaled.shape[0],
    num_epochs=1)
estimator.evaluate(eval_input,steps=None)
Çıktı:
{'accuracy': 0.9637143,
 'average_loss': 0.12014342,
 'loss': 1682.0079,
 'global_step': 1000}
Mevcut mimari, değerlendirme veri setinde yaklaşık yüzde 96'lık bir doğruluk oranına yol açmaktadır.
Adım 6) Modeli geliştirin
Düzenlileştirme parametreleri ekleyerek modeli iyileştirmeyi deneyebilirsiniz.
Burada tahminleyici, %0.3'lük bir dropout oranı ve hem L1 hem de L2 katmanlarının güçlerinin %0.01 olarak ayarlandığı bir Proximal AdaGrad optimize edici kullanır. TensorFlow sinir ağında, optimize ediciye train nesnesi ve ardından optimize edicinin adı aracılığıyla ulaşırsınız. TensorFlow, Proximal AdaGrad optimize edici için yerleşik bir API sunar.
Derin sinir ağına düzenleme eklemek için, tf.train.ProximalAdagradOptimizer'ı aşağıdaki parametrelerle kullanabilirsiniz:
- Öğrenme oranı: öğrenme oranı
- L1 düzenlemesi: l1_düzenleme_gücü
- L2 düzenlemesi: l2_düzenleme_gücü
estimator_imp = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    dropout=0.3,
    n_classes = 10,
    optimizer=tf.train.ProximalAdagradOptimizer(
      learning_rate=0.01,
      l1_regularization_strength=0.01,
      l2_regularization_strength=0.01
    ),
    model_dir = '/train/DNN1')
estimator_imp.train(input_fn = train_input,steps=1000)
estimator_imp.evaluate(eval_input,steps=None)
Çıktı:
{'accuracy': 0.95057142,
 'average_loss': 0.17318928,
 'loss': 2424.6499,
 'global_step': 2000}
Aşırı uyumun azaltılması için seçilen değerler model doğruluğunu iyileştirmedi. İlk modelinizin doğruluğu %96 iken, L2 düzenleyiciye sahip modelin doğruluğu %95'tir. Farklı değerler deneyerek bunların doğruluğa nasıl etki ettiğini görebilirsiniz.
