
Tutorial do Scikit-Learn: como instalar e exemplos do Scikit-Learn
 Equipe editorial
⚡ Resumo Inteligente
Scikit-learn é de código aberto. Python Biblioteca que abrange pré-processamento, classificação, regressão, agrupamento e seleção de modelos por meio de uma única interface de estimador consistente, o que mantém um fluxo de trabalho completo de aprendizado de máquina curto, legível e reproduzível, desde os dados brutos até as previsões com pontuação.
O que é Scikit-learn?
Scikit-learn é um open-source Python biblioteca para aprendizado de máquinaEle suporta algoritmos consagrados como KNN, gradient boosting, random forest e SVM, e é construído sobre... NumPy e SciPy. O Scikit-learn é amplamente utilizado em competições do Kaggle, bem como em importantes empresas de tecnologia. Ele abrange pré-processamento, redução de dimensionalidade, classificação, regressão, agrupamento e seleção de modelos.
O Scikit-learn possui uma das melhores documentações entre as bibliotecas de código aberto. Ele oferece até mesmo um gráfico de estimativa interativo. Escolher o estimador certo, que te guia desde o tamanho do seu conjunto de dados até uma lista restrita de algoritmos que valem a pena experimentar.
A figura abaixo ilustra como o Scikit-learn funciona.
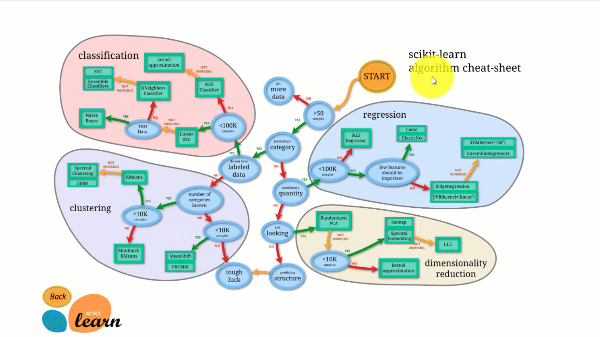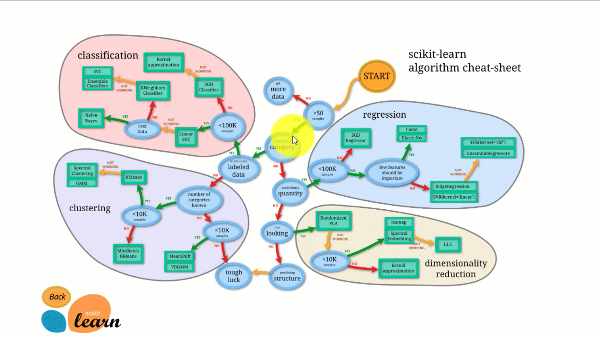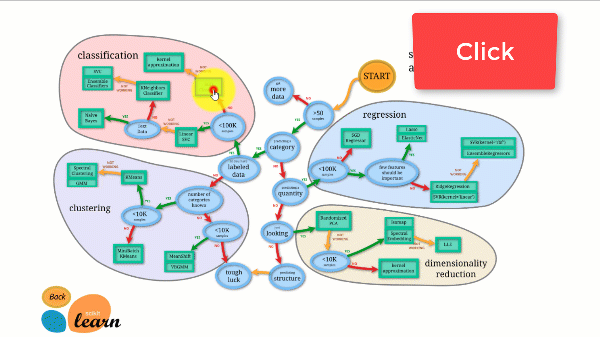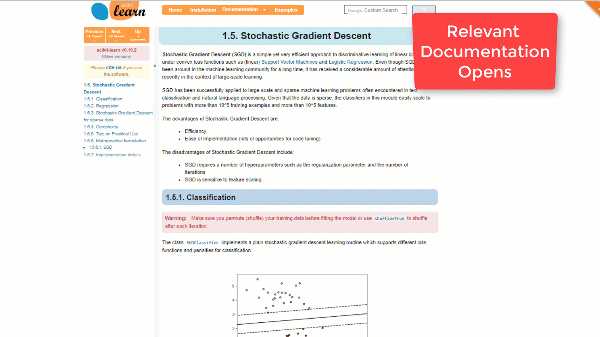
O Scikit-learn não é difícil de usar e oferece excelentes resultados. No entanto, ele treina na CPU: o trabalho é paralelizado entre os núcleos com o argumento `n_jobs`, em vez de na GPU. Executar um algoritmo de aprendizado profundo com ele é possível, mas raramente é a melhor opção, especialmente se você já sabe como usar outras ferramentas. TensorFlow.
Como baixar e instalar o Scikit-learn
Agora neste Python Neste tutorial sobre Scikit-learn, você aprenderá como baixar e instalar o Scikit-learn:
Opção 1: AWS
O Scikit-learn pode ser usado na AWS. Uma imagem Docker com o Scikit-learn pré-instalado elimina completamente o trabalho de configuração.
Para instalar a versão de desenvolvedor, execute o comando abaixo dentro de Jupyter:
import sys
!{sys.executable} -m pip install git+git://github.com/scikit-learn/scikit-learn.git
Opção 2: Mac ou Windows usando Anaconda
Para saber mais sobre a instalação do Anaconda, consulte Como baixar e instalar o TensorFlow.
Na época em que este guia foi escrito, os desenvolvedores do scikit-learn haviam lançado uma versão de desenvolvimento que corrigia problemas presentes na versão então vigente. Portanto, os passos a seguir utilizam essa versão de desenvolvimento. Em uma máquina nova, a versão estável atual já contém todos os transformadores usados aqui. pip install -U scikit-learn basta.
Como instalar o scikit-learn com ambiente Conda
Se você instalou o scikit-learn com o ambiente conda, siga os passos abaixo para atualizar para a versão 0.20.
Passo 1) Ative o ambiente TensorFlow.
source activate hello-tf
Passo 2) Remova o scikit-learn usando o comando conda
conda remove scikit-learn
Passo 3) Instale a versão de desenvolvedor
Instale a versão para desenvolvedores do scikit-learn juntamente com as bibliotecas necessárias.
conda install -c anaconda git
pip install Cython
pip install h5py
pip install git+git://github.com/scikit-learn/scikit-learn.git
OBSERVAÇÃO: Windows usuários precisam Microsoft visual C++ 14. Você pode conseguir. aqui..
Exemplo do Scikit-Learn com aprendizado de máquina
Este tutorial do Scikit está dividido em duas partes:
- Aprendizado de máquina com scikit-learn
- Como confiar em seu modelo com LIME
A primeira parte detalha como construir um pipeline, criar um modelo e ajustar os hiperparâmetros, enquanto a segunda parte aborda a interpretação do modelo.
Etapa 1) Importe os dados
Neste tutorial do Scikit-learn, você usará o conjunto de dados do censo de adultos.
O arquivo é lido diretamente do Repositório de Aprendizado de Máquina da UCI no código abaixo, portanto, nenhum download manual é necessário. Se você estiver interessado em estatísticas descritivas, vale a pena conferir as ferramentas Dive e Overview. Consulte Neste tutorial Para saber mais sobre Mergulho e Visão Geral.
Você importa o conjunto de dados com o pandas. Observe que é necessário converter as variáveis contínuas para o formato float.
Este conjunto de dados inclui oito variáveis categóricas, listadas em CATE_FEATURES:
- classe de trabalho
- educação
- marital
- ocupação
- relacionamento
- raça
- sexo
- país nativo
Inclui também seis variáveis contínuas, listadas em CONTI_FEATURES:
- idade
- fnlwgt
- número_educação
- Ganho de capital
- perda_capital
- horas_semana
As listas são preenchidas manualmente para que você tenha uma ideia mais clara de quais colunas estão em jogo. Uma maneira mais rápida de criar uma lista de colunas categóricas ou contínuas é:
## List Categorical
CATE_FEATURES = df_train.iloc[:,:-1].select_dtypes('object').columns
print(CATE_FEATURES)

## List continuous
CONTI_FEATURES =  df_train._get_numeric_data()
print(CONTI_FEATURES)
Aqui está o código para importar os dados:
# Import dataset
import pandas as pd

## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country', 'label']
### Define continuous list
CONTI_FEATURES  = ['age', 'fnlwgt','capital_gain', 'education_num', 'capital_loss', 'hours_week']
### Define categorical list
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']

## Prepare the data
features = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country']

PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"

df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_train[CONTI_FEATURES] =df_train[CONTI_FEATURES].astype('float64')
df_train.describe()
Chamar a função describe() no frame retorna as estatísticas resumidas para as seis colunas contínuas:
| idade | fnlwgt | número_educação | Ganho de capital | perda_capital | horas_semana | |
|---|---|---|---|---|---|---|
| contar | 32561.000000 | 3.256100e + 04 | 32561.000000 | 32561.000000 | 32561.000000 | 32561.000000 |
| significar | 38.581647 | 1.897784e + 05 | 10.080679 | 1077.648844 | 87.303830 | 40.437456 |
| std | 13.640433 | 1.055500e + 05 | 2.572720 | 7385.292085 | 402.960219 | 12.347429 |
| min | 17.000000 | 1.228500e + 04 | 1.000000 | 0.000000 | 0.000000 | 1.000000 |
| 25% | 28.000000 | 1.178270e + 05 | 9.000000 | 0.000000 | 0.000000 | 40.000000 |
| 50% | 37.000000 | 1.783560e + 05 | 10.000000 | 0.000000 | 0.000000 | 40.000000 |
| 75% | 48.000000 | 2.370510e + 05 | 12.000000 | 0.000000 | 0.000000 | 45.000000 |
| max | 90.000000 | 1.484705e + 06 | 16.000000 | 99999.000000 | 4356.000000 | 99.000000 |
Você pode verificar a quantidade de valores únicos da variável `native_country`. Apenas uma família é da Holanda (Países Baixos). Essa família não traz nenhuma informação e causará um erro durante o treinamento.
df_train.native_country.value_counts()
United-States                 29170
Mexico                          643
?                               583
Philippines                     198
Germany                         137
Canada                          121
Puerto-Rico                     114
El-Salvador                     106
India                           100
Cuba                             95
England                          90
Jamaica                          81
South                            80
China                            75
Italy                            73
Dominican-Republic               70
Vietnam                          67
Guatemala                        64
Japan                            62
Poland                           60
Columbia                         59
Taiwan                           51
Haiti                            44
Iran                             43
Portugal                         37
Nicaragua                        34
Peru                             31
France                           29
Greece                           29
Ecuador                          28
Ireland                          24
Hong                             20
Cambodia                         19
Trinadad&Tobago                  19
Thailand                         18
Laos                             18
Yugoslavia                       16
Outlying-US(Guam-USVI-etc)       14
Honduras                         13
Hungary                          13
Scotland                         12
Holand-Netherlands                1
Name: native_country, dtype: int64
Você pode excluir esta linha sem informações do conjunto de dados:
## Drop Netherland, because only one row
df_train = df_train[df_train.native_country != "Holand-Netherlands"]
A seguir, você armazena a posição dos recursos contínuos em uma lista. Você precisará dele na próxima etapa para construir o pipeline.
O código abaixo percorre todos os nomes de coluna em CONTI_FEATURES, lê cada localização (ou seja, seu número de coluna) e a adiciona a uma lista chamada conti_features.
## Get the column index of the categorical features
conti_features = []
for i in CONTI_FEATURES:
    position = df_train.columns.get_loc(i)
    conti_features.append(position)
print(conti_features)
[0, 2, 10, 4, 11, 12]
O bloco seguinte realiza a mesma função para as variáveis categóricas.
## Get the column index of the categorical features
categorical_features = []
for i in CATE_FEATURES:
    position = df_train.columns.get_loc(i)
    categorical_features.append(position)
print(categorical_features)
[1, 3, 5, 6, 7, 8, 9, 13]
Agora, observe o próprio conjunto de dados. Cada variável categórica é uma string, e um modelo não pode receber um valor de string, portanto, o conjunto de dados precisa ser transformado com variáveis dummy.
df_train.head(5)
Na verdade, você precisa de uma coluna para cada grupo em cada recurso. Primeiro, execute o código abaixo para calcular o número total de colunas necessárias.
print(df_train[CATE_FEATURES].nunique(),
      'There are',sum(df_train[CATE_FEATURES].nunique()), 'groups in the whole dataset')
workclass          9
education         16
marital            7
occupation        15
relationship       6
race               5
sex                2
native_country    41
dtype: int64 There are 101 groups in the whole dataset
O conjunto de dados completo contém 101 grupos, conforme mostrado acima. A variável `workclass` sozinha possui nove grupos. Você pode listar os nomes dos grupos com o código abaixo; `unique()` retorna os valores distintos de cada variável categórica.
for i in CATE_FEATURES:
    print(df_train[i].unique())
['State-gov' 'Self-emp-not-inc' 'Private' 'Federal-gov' 'Local-gov' '?'
 'Self-emp-inc' 'Without-pay' 'Never-worked']
['Bachelors' 'HS-grad' '11th' 'Masters' '9th' 'Some-college' 'Assoc-acdm'
 'Assoc-voc' '7th-8th' 'Doctorate' 'Prof-school' '5th-6th' '10th'
 '1st-4th' 'Preschool' '12th']
['Never-married' 'Married-civ-spouse' 'Divorced' 'Married-spouse-absent'
 'Separated' 'Married-AF-spouse' 'Widowed']
['Adm-clerical' 'Exec-managerial' 'Handlers-cleaners' 'Prof-specialty'
 'Other-service' 'Sales' 'Craft-repair' 'Transport-moving'
 'Farming-fishing' 'Machine-op-inspct' 'Tech-support' '?'
 'Protective-serv' 'Armed-Forces' 'Priv-house-serv']
['Not-in-family' 'Husband' 'Wife' 'Own-child' 'Unmarried' 'Other-relative']
['White' 'Black' 'Asian-Pac-Islander' 'Amer-Indian-Eskimo' 'Other']
['Male' 'Female']
['United-States' 'Cuba' 'Jamaica' 'India' '?' 'Mexico' 'South'
 'Puerto-Rico' 'Honduras' 'England' 'Canada' 'Germany' 'Iran'
 'Philippines' 'Italy' 'Poland' 'Columbia' 'Cambodia' 'Thailand' 'Ecuador'
 'Laos' 'Taiwan' 'Haiti' 'Portugal' 'Dominican-Republic' 'El-Salvador'
 'France' 'Guatemala' 'China' 'Japan' 'Yugoslavia' 'Peru'
 'Outlying-US(Guam-USVI-etc)' 'Scotland' 'Trinadad&Tobago' 'Greece'
 'Nicaragua' 'Vietnam' 'Hong' 'Ireland' 'Hungary']
O conjunto de dados de treinamento conterá, portanto, 101 + 6 colunas: os grupos one-hot mais as seis características contínuas.
O Scikit-learn pode cuidar da conversão em duas etapas:
- Converta a string em um ID. "State-gov" torna-se ID 1, "Self-emp-not-inc" torna-se ID 2 e assim por diante. O LabelEncoder faz isso para você.
- Transponha cada ID para uma nova coluna. O conjunto de dados possui 101 IDs de grupo, portanto haverá 101 colunas, uma para cada grupo de características categóricas. O Scikit-learn fornece o OneHotEncoder para essa operação.
Etapa 2) Crie o conjunto de treinamento/teste
Agora que o conjunto de dados está pronto, divida-o em 80/20: 80% para o conjunto de treinamento e 20% para o conjunto de teste.
Você pode usar a função `train_test_split`. O primeiro argumento é o dataframe de recursos e o segundo é o rótulo. Você define o tamanho do conjunto de teste com `test_size`.
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(df_train[features],
                                                    df_train.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train.head(5)
print(X_train.shape, X_test.shape)
(26048, 14) (6512, 14)
Etapa 3) Construir o pipeline
O pipeline facilita a alimentação do modelo com dados consistentes. A ideia é processar os dados brutos através de um objeto que executa todas as operações em sequência.
Com esse conjunto de dados, você precisa padronizar as variáveis contínuas e converter as categóricas. Qualquer operação pode ser realizada dentro de um pipeline: valores ausentes podem ser substituídos pela média ou mediana, e novas variáveis podem ser criadas.
Você tem uma escolha: codificar os dois processos diretamente no código ou criar um pipeline. A codificação direta pode vazar dados de teste para as estatísticas ajustadas e criar inconsistências ao longo do tempo, portanto, o pipeline é a melhor opção.
from sklearn.preprocessing import StandardScaler, OneHotEncoder, LabelEncoder
from sklearn.compose import ColumnTransformer, make_column_transformer
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LogisticRegression
O pipeline executa duas operações antes de alimentar o classificador logístico:
- Padronizar a variável: StandardScaler()
- Converta os recursos categóricos: OneHotEncoder(sparse=False)
Você executa ambas as etapas com `make_column_transformer`. Quando este guia foi escrito, a função não estava presente na versão lançada do scikit-learn (0.19), motivo pelo qual foi utilizada a versão de desenvolvimento; ela está incluída em todas as versões estáveis desde a 0.20.
A função `make_column_transformer` é simples: você declara quais colunas transformar e qual transformação aplicar. Para padronizar as feições contínuas, você passa:
- conti_features, StandardScaler() dentro de make_column_transformer
- conti_features: a lista de colunas contínuas
- StandardScaler: padroniza essas colunas
O objeto OneHotEncoder dentro de make_column_transformer codifica os rótulos automaticamente.
preprocess = make_column_transformer(
    (conti_features, StandardScaler()),
    ### Need to be numeric not string to specify columns name
    (categorical_features, OneHotEncoder(sparse=False))
)
Nota de versão: Dois argumentos no bloco acima foram movidos. As versões atuais esperam o transformador primeiro e as colunas em segundo lugar, e escasso foi renomeado saída esparsa presente no scikit-learn 1.2 e removido na versão 1.4, portanto o código mais recente lê OneHotEncoder(sparse_output=False).
Você pode testar se o pipeline funciona com fit_transform. A saída deve ter o formato 26048, 107.
preprocess.fit_transform(X_train).shape
(26048, 107)
O transformador de dados está pronto. Você cria o pipeline com make_pipeline e, uma vez que os dados estejam transformados, alimenta a regressão logística.
model = make_pipeline(
    preprocess,
    LogisticRegression())
Treinar um modelo com scikit-learn é trivial: basta chamar o método `fit` no pipeline. Você pode imprimir a acurácia com o método `score`.
model.fit(X_train, y_train)
print("logistic regression score: %f" % model.score(X_test, y_test))
logistic regression score: 0.850891
Por fim, você pode prever as classes com `predict_proba`, que retorna a probabilidade de cada classe. Observe que a soma das duas probabilidades é igual a um.
model.predict_proba(X_test)
array([[0.83576663, 0.16423337],
       [0.94582765, 0.05417235],
       [0.64760587, 0.35239413],
       ...,
       [0.99639252, 0.00360748],
       [0.02072181, 0.97927819],
       [0.56781353, 0.43218647]])
Etapa 4) Usando nosso pipeline em uma pesquisa em grade
Ajustar os hiperparâmetros, os valores que definem a estrutura do modelo, pode ser tedioso e exaustivo.
Uma forma de avaliar o modelo seria alterar o tamanho do conjunto de treinamento e medir o desempenho, repetindo o exercício dez vezes para observar a dispersão da pontuação. Isso requer muito trabalho manual.
Em vez disso, o scikit-learn fornece funções que realizam o ajuste de parâmetros e a validação cruzada para você.
Validação cruzada
A validação cruzada significa que, durante o treinamento, o conjunto de treinamento é dividido n vezes em partes (folds) e o modelo é avaliado n vezes. Se `cv` for definido como 10, o modelo será treinado e avaliado dez vezes. Em cada rodada, o classificador é treinado em nove partes escolhidas aleatoriamente e a décima parte é mantida para avaliação.
Pesquisa de grade
Todo classificador possui hiperparâmetros que podem ser ajustados. Você pode testar valores individualmente ou definir uma grade de parâmetros. A documentação do scikit-learn lista todos os parâmetros aceitos pelo classificador logístico. Para manter o treinamento rápido, este exemplo ajusta apenas o parâmetro C, que controla a regularização. Ele deve ser positivo, e um valor pequeno dá mais peso ao regularizador.
Você usa o objeto GridSearchCV, que recebe um dicionário com os hiperparâmetros a serem ajustados. Liste cada hiperparâmetro seguido pelos valores que deseja testar. Para ajustar C, você escreve:
- 'logisticregression__C': [0.001, 0.01, 0.1, 1.0] — o nome do parâmetro é precedido pelo nome do classificador em minúsculas e dois sublinhados.
O modelo testará quatro valores diferentes: 0.001, 0.01, 0.1 e 1. Ele é treinado com 10 folds, ou seja, cv=10.
from sklearn.model_selection import GridSearchCV
# Construct the parameter grid
param_grid = {
    'logisticregression__C': [0.001, 0.01,0.1, 1.0],
    }
Agora você pode treinar o modelo usando o GridSearchCV com os parâmetros grid e cv.
# Train the model
grid_clf = GridSearchCV(model,
                        param_grid,
                        cv=10,
                        iid=False)
grid_clf.fit(X_train, y_train)
Saída:
GridSearchCV(cv=10, error_score='raise-deprecating',
       estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...ty='l2', random_state=None, solver='liblinear', tol=0.0001,
          verbose=0, warm_start=False))]),
       fit_params=None, iid=False, n_jobs=1,
       param_grid={'logisticregression__C': [0.001, 0.01, 0.1, 1.0]},
       pre_dispatch='2*n_jobs', refit=True, return_train_score='warn',
       scoring=None, verbose=0)
Nota de versão: da Eu iria O argumento visível nesta saída foi descontinuado no scikit-learn 0.22 e removido na versão 0.24, portanto, deve ser simplesmente removido da chamada GridSearchCV nas versões atuais.
Para acessar os melhores parâmetros, você usa best_params_.
grid_clf.best_params_
Saída:
{'logisticregression__C': 1.0}
Após treinar o modelo com quatro valores de regularização diferentes, o parâmetro ideal é:
print("best logistic regression from grid search: %f" % grid_clf.best_estimator_.score(X_test, y_test))
melhor regressão logística da pesquisa em grade: 0.850891
Para acessar as probabilidades previstas:
grid_clf.best_estimator_.predict_proba(X_test)
array([[0.83576677, 0.16423323],
       [0.9458291 , 0.0541709 ],
       [0.64760416, 0.35239584],
       ...,
       [0.99639224, 0.00360776],
       [0.02072033, 0.97927967],
       [0.56782222, 0.43217778]])
Modelo XGBoost com scikit-learn
Agora, experimente um dos classificadores mais poderosos do mercado. O XGBoost é um aprimoramento do Random Forest baseado em gradient boosting. Seus fundamentos teóricos estão fora do escopo deste texto. Python Tutorial do Scikit-learn, mas lembre-se de que o XGBoost já ganhou diversas competições no Kaggle. Em um conjunto de dados de tamanho médio, ele pode ter um desempenho tão bom quanto, ou até melhor, do que um algoritmo de aprendizado profundo.
O classificador é difícil de treinar porque expõe um grande número de parâmetros. Você pode, é claro, usar o GridSearchCV para escolhê-los para você.
Uma opção melhor aqui é o RandomizedSearchCV. O GridSearchCV fica lento quando a grade é grande, porque o espaço de busca cresce a cada parâmetro adicionado. O RandomizedSearchCV, por sua vez, amostra os valores de cada hiperparâmetro aleatoriamente em cada iteração, de modo que 1,000 iterações avaliam 1,000 combinações. Fora isso, funciona de maneira muito semelhante ao GridSearchCV.
Você precisa importar o xgboost. Se a biblioteca não estiver instalada, execute `pip3 install xgboost` ou instale-a a partir de um arquivo de configuração. Jupyter caderno com:
use import sys
!{sys.executable} -m pip install xgboost
Em seguida, importe o classificador e os dois auxiliares de pesquisa:
import xgboost
from sklearn.model_selection import RandomizedSearchCV
from sklearn.model_selection import StratifiedKFold
A próxima etapa neste Scikit Python O objetivo deste tutorial é especificar os parâmetros a serem ajustados. A documentação oficial do XGBoost lista todos eles. Para os fins deste tutorial, vamos nos concentrar em... Python No tutorial do Sklearn, você escolhe apenas dois hiperparâmetros com dois valores cada, porque o XGBoost leva muito tempo para treinar e cada ponto extra na grade aumenta o tempo de espera.
params = {
        'xgbclassifier__gamma': [0.5, 1],
        'xgbclassifier__max_depth': [3, 4]
        }
Em seguida, você constrói um novo pipeline com o classificador XGBoost e 600 estimadores. O parâmetro `n_estimators` é ajustável e um valor alto pode levar a sobreajuste (overfitting). Você pode experimentar outros valores, mas esteja ciente de que isso pode levar horas. Todos os outros parâmetros mantêm seus valores padrão.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1)
)
Você pode aprimorar a validação cruzada com o validador cruzado Stratified K-Folds. Aqui, apenas três folds são usados para acelerar o cálculo, com alguma perda de qualidade; aumente esse número para 5 ou 10 em sua máquina para obter melhores resultados. O modelo é treinado em quatro iterações.
skf = StratifiedKFold(n_splits=3,
                      shuffle = True,
                      random_state = 1001)

random_search = RandomizedSearchCV(model_xgb,
                                   param_distributions=params,
                                   n_iter=4,
                                   scoring='accuracy',
                                   n_jobs=4,
                                   cv=skf.split(X_train, y_train),
                                   verbose=3,
                                   random_state=1001)
A busca aleatória está pronta, então você pode treinar o modelo.
#grid_xgb = GridSearchCV(model_xgb, params, cv=10, iid=False)
random_search.fit(X_train, y_train)
Fitting 3 folds for each of 4 candidates, totalling 12 fits
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8759645283888057, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8729701715996775, total= 1.0min
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8706519235199263, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8735460094437406, total= 1.3min
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8722791661868018, total=  57.7s
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8753886905447426, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8697304768486523, total= 1.3min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8740066797189912, total= 1.4min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8707671043538355, total= 1.0min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8729701715996775, total= 1.2min
[Parallel(n_jobs=4)]: Done  10 out of  12 | elapsed:  3.6min remaining:   43.5s
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8736611770125533, total= 1.2min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8692697535130154, total= 1.2min
[Parallel(n_jobs=4)]: Done  12 out of  12 | elapsed:  3.6min finished
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/model_selection/_search.py:737: DeprecationWarning: The default of the `iid` parameter will change from True to False in version 0.22 and will be removed in 0.24. This will change numeric results when test-set sizes are unequal. DeprecationWarning)
RandomizedSearchCV(cv=<generator object _BaseKFold.split at 0x1101eb830>,
          error_score='raise-deprecating',
          estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))]),
          fit_params=None, iid='warn', n_iter=4, n_jobs=4,
          param_distributions={'xgbclassifier__gamma': [0.5, 1], 'xgbclassifier__max_depth': [3, 4]},
          pre_dispatch='2*n_jobs', random_state=1001, refit=True,
          return_train_score='warn', scoring='accuracy', verbose=3)
Como você pode ver, o XGBoost obteve uma pontuação melhor do que a regressão logística anterior.
print("Melhor parameter", random_search.best_params_)
print("best logistic regression from grid search: %f" % random_search.best_estimator_.score(X_test, y_test))
Melhor parameter {'xgbclassifier__max_depth': 3, 'xgbclassifier__gamma': 0.5}
best logistic regression from grid search: 0.873157
random_search.best_estimator_.predict(X_test)
array(['<=50K', '<=50K', '<=50K', ..., '<=50K', '>50K', '<=50K'], dtype=object)
Crie DNN com MLPClassifier no scikit-learn
Por fim, você pode treinar uma rede neural com o próprio scikit-learn. O método é o mesmo que para qualquer outro classificador, e o estimador é o MLPClassifier.
from sklearn.neural_network import MLPClassifier
A rede abaixo é definida por:
- Solucionador de Adam
- função de ativação ReLU
- Alfa = 0.0001
- Tamanho do lote: 150
- Duas camadas ocultas com 200 e 100 neurônios respectivamente
model_dnn = make_pipeline(
    preprocess,
    MLPClassifier(solver='adam',
                  alpha=0.0001,
                  activation='relu',
                    batch_size=150,
                    hidden_layer_sizes=(200, 100),
                    random_state=1))
Você pode alterar o número de camadas para melhorar o modelo.
model_dnn.fit(X_train, y_train)
  print("DNN regression score: %f" % model_dnn.score(X_test, y_test))
Pontuação de regressão DNN: 0.821253
LIME: Confie no seu modelo
Agora que você tem um bom modelo, precisa de uma maneira de confiar nele. Os algoritmos de aprendizado de máquina, especialmente florestas aleatórias e redes neurais, são conhecidos como modelos de caixa preta: eles funcionam, mas ninguém consegue entender o porquê.
Três pesquisadores desenvolveram uma ferramenta que mostra como o computador chega a uma previsão. O artigo deles é “Por que eu deveria confiar em você?”E o algoritmo que eles publicaram se chama Local Interpretable Model-Agnostic Explanations (LIME).
Vejamos um exemplo. Às vezes, não sabemos se uma previsão de aprendizado de máquina é confiável. Um médico não pode aceitar um diagnóstico simplesmente porque foi produzido por um computador, e é preciso saber se um modelo é confiável antes de colocá-lo em produção.
Imagine poder ver por que qualquer classificador fez uma previsão, mesmo para modelos tão complexos quanto redes neurais, florestas aleatórias ou SVMs com um kernel arbitrário. Fica muito mais fácil confiar em uma previsão quando os motivos por trás dela são visíveis, e igualmente mais fácil decidir quando um modelo não é confiável. O LIME mostra quais recursos influenciaram a decisão do classificador.
Preparação de dados
Há algumas coisas que você precisa alterar para executar o LIME com PythonPrimeiro, instale o lime no terminal com o comando `pip install lime`.
O Lime utiliza um objeto LimeTabularExplainer para aproximar o modelo localmente. Este objeto requer:
- um conjunto de dados em NumPy formato
- O nome dos recursos: feature_names
- O nome das classes: class_names
- O índice da coluna dos recursos categóricos: categorical_features
- O nome do grupo para cada característica categórica: nomes_categoriais
Crie o conjunto de treinamento NumPy.
Você pode copiar e converter df_train do pandas para NumPy com muita facilidade.
df_train.head(5)
# Create numpy data
df_lime = df_train
df_lime.head(3)
Obtenha o nome da classe
O rótulo pode ser acessado através de unique(). Você deverá ver:
- '<= 50K'
- '> 50K'
# Get the class name
class_names = df_lime.label.unique()
class_names
array(['<=50K', '>50K'], dtype=object)
Indexe as colunas de características categóricas.
Utilize o método que você aprendeu anteriormente para obter o nome de cada grupo. Você codifica o rótulo com LabelEncoder e repete a operação em cada atributo categórico.
##
import sklearn.preprocessing as preprocessing
categorical_names = {}
for feature in CATE_FEATURES:
    le = preprocessing.LabelEncoder()
    le.fit(df_lime[feature])
    df_lime[feature] = le.transform(df_lime[feature])
    categorical_names[feature] = le.classes_
print(categorical_names)
{'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}

df_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
label              object
dtype: object
Agora que o conjunto de dados está pronto, você pode criar os diferentes conjuntos de dados mostrados nos exemplos do Scikit-learn abaixo. Os dados são transformados fora do pipeline para evitar erros com o LIME: o conjunto de treinamento passado para o LimeTabularExplainer deve ser um array NumPy sem strings, e o método acima já produziu um.
from sklearn.model_selection import train_test_split
X_train_lime, X_test_lime, y_train_lime, y_test_lime = train_test_split(df_lime[features],
                                                    df_lime.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train_lime.head(5)
Você pode criar o pipeline com os parâmetros ideais encontrados pelo XGBoost.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(max_depth = 3,
                          gamma = 0.5,
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1))

model_xgb.fit(X_train_lime, y_train_lime)
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/preprocessing/_encoders.py:351: FutureWarning: The handling of integer data will change in version 0.22. Currently, the categories are determined based on the range [0, max(values)], while in the future they will be determined based on the unique values.
If you want the future behavior and silence this warning, you can specify "categories='auto'."In case you used a LabelEncoder before this OneHotEncoder to convert the categories to integers, then you can now use the OneHotEncoder directly.
  warnings.warn(msg, FutureWarning)
Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))])
Você receberá um aviso. Ele explica que não é necessário criar um codificador de rótulos antes do pipeline. Se você não estiver usando o LIME, o método da primeira parte deste tutorial de Machine Learning com Scikit-learn funciona bem. Caso contrário, mantenha esta abordagem: primeiro crie um conjunto de dados codificado e, em seguida, aplique o codificador one-hot dentro do pipeline.
print("best logistic regression from grid search: %f" % model_xgb.score(X_test_lime, y_test_lime))
best logistic regression from grid search: 0.873157
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
Antes de usar o LIME, crie um array NumPy contendo as características das linhas classificadas incorretamente. Você poderá usar essa lista posteriormente para entender o que levou o classificador ao erro.
temp = pd.concat([X_test_lime, y_test_lime], axis= 1)
temp['predicted'] = model_xgb.predict(X_test_lime)
temp['wrong']=  temp['label'] != temp['predicted']
temp = temp.query('wrong==True').drop('wrong', axis=1)
temp= temp.sort_values(by=['label'])
temp.shape
(826, 16)
Em seguida, você cria uma função lambda que recupera a previsão do modelo para novos dados. Você precisará dela em breve.
predict_fn = lambda x: model_xgb.predict_proba(x).astype(float)
X_test_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
dtype: object
predict_fn(X_test_lime)
array([[7.96461046e-01, 2.03538969e-01],
       [9.51730132e-01, 4.82698716e-02],
       [7.93448269e-01, 2.06551731e-01],
       ...,
       [9.90314305e-01, 9.68566816e-03],
       [6.45816326e-04, 9.99354184e-01],
       [9.71042812e-01, 2.89571714e-02]])
Você converte o dataframe do pandas em um array NumPy.
X_train_lime = X_train_lime.values
X_test_lime = X_test_lime.values
X_test_lime
array([[4.00000e+01, 5.00000e+00, 1.93524e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.70000e+01, 4.00000e+00, 2.16481e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.50000e+01, 4.00000e+00, 2.56263e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       ...,
       [2.80000e+01, 6.00000e+00, 2.11032e+05, ..., 0.00000e+00,
        4.00000e+01, 2.50000e+01],
       [4.40000e+01, 4.00000e+00, 1.67005e+05, ..., 0.00000e+00,
        6.00000e+01, 3.80000e+01],
       [5.30000e+01, 4.00000e+00, 2.57940e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01]])
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
print(features,
      class_names,
      categorical_features,
      categorical_names)
['age', 'workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country'] ['<=50K' '>50K'] [1, 3, 5, 6, 7, 8, 9, 13] {'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}
import lime
import lime.lime_tabular
### Train should be label encoded not one hot encoded
explainer = lime.lime_tabular.LimeTabularExplainer(X_train_lime ,
                                                   feature_names = features,
                                                   class_names=class_names,
                                                   categorical_features=categorical_features,
                                                   categorical_names=categorical_names,
                                                   kernel_width=3)
Agora, escolha uma família aleatória do conjunto de teste e veja tanto a previsão quanto o processo pelo qual o computador chegou a ela.
import numpy as np
np.random.seed(1)
i = 100
print(y_test_lime.iloc[i])
>50K
X_test_lime[i]
array([4.20000e+01, 4.00000e+00, 1.76286e+05, 7.00000e+00, 1.20000e+01,
       2.00000e+00, 4.00000e+00, 0.00000e+00, 4.00000e+00, 1.00000e+00,
       0.00000e+00, 0.00000e+00, 4.00000e+01, 3.80000e+01])
Você pode usar o recurso de explicação com `explain_instance` para inspecionar o raciocínio por trás do modelo. O gráfico gerado é mostrado abaixo.
exp = explainer.explain_instance(X_test_lime[i], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

O classificador previu corretamente a situação desta família: a renda é de fato superior a 50 mil.
O primeiro ponto a observar é que o classificador não tem muita certeza de si mesmo. Ele prevê uma renda acima de 50 mil com 64% de probabilidade, e esses 64% são influenciados por ganhos de capital e estado civil. A cor azul contribui negativamente para a classe positiva e a linha laranja, positivamente.
O classificador está hesitante porque o ganho de capital dessa família é zero, enquanto o ganho de capital geralmente é um bom indicador de riqueza. A família também trabalha menos de 40 horas por semana. Idade, ocupação e sexo contribuem positivamente.
Se o estado civil fosse solteiro, o classificador teria previsto uma renda inferior a 50 mil (0.64 – 0.18 = 0.46).
Agora tente outra residência, uma que foi classificada incorretamente. A tabela explicativa correspondente segue o código.
temp.head(3)
temp.iloc[1,:-2]
age                  58
workclass             4
fnlwgt            68624
education            11
education_num         9
marital               2
occupation            4
relationship          0
race                  4
sex                   1
capital_gain          0
capital_loss          0
hours_week           45
native_country       38
Name: 20931, dtype: object
i = 1
print('This observation is', temp.iloc[i,-2:])
This observation is label        <=50K
predicted     >50K
Name: 20931, dtype: object
exp = explainer.explain_instance(temp.iloc[1,:-2], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

O classificador previu uma renda inferior a 50 mil, o que está errado. Essa família é atípica: não teve ganho nem perda de capital, a pessoa é divorciada, tem quase 60 anos e possui nível de escolaridade superior a 12. Seguindo o padrão geral, o classificador posicionou a renda familiar abaixo de 50 mil.
Experimente o LIME você mesmo e perceberá diversos erros grosseiros do classificador. O repositório GitHub do autor da biblioteca contém documentação adicional para classificação de imagens e textos.
Referência de comandos do Scikit-learn
A seguir, uma lista de comandos úteis que se aplicam ao scikit-learn versão 0.20 e posteriores.
| Tarefa | Função ou classe |
|---|---|
| Crie o conjunto de dados de treino/teste. | treinar_teste_split |
| Construir um pipeline | |
| Selecione as colunas e aplique a transformação. | make_column_transformer |
| Tipo de transformação | |
| Padronizar | StandardScaler |
| Escala mín-máx | MinMax Scaler |
| Normalizar | Normalizador |
| Imputar valores ausentes | SimplesImputador |
| Converter categórico | OneHotEncoder |
| Ajuste e transforme os dados | ajuste_transform |
| Faça o pipeline | make_pipeline |
| Modelo básico | |
| Regressão logística | LogísticaRegressão |
| XGBoostName | Classificador XGB |
| Rede neural | Classificador MLP |
| Pesquisa de grade | GradeSearchCV |
| Pesquisa aleatória | CV de pesquisa randomizado |
