
NoSQL 튜토리얼: NoSQL 데이터베이스 유형 및 예제
 편집 팀
⚡ 스마트 요약
NoSQL은 고정된 스키마가 필요 없고, 조인을 사용하지 않으며, 확장성이 뛰어난 비관계형 데이터베이스 관리 시스템입니다. 이 자료에서는 NoSQL이란 무엇인지, 왜 존재하는지, 역사, 특징, 네 가지 데이터베이스 유형, CAP 정리, 최종 일관성, 그리고 장단점에 대해 설명합니다.
NoSQL이란 무엇입니까?
NoSQL 데이터베이스 NoSQL은 고정된 스키마가 필요 없는 비관계형 데이터 관리 시스템입니다. 조인을 사용하지 않으며 확장성이 뛰어납니다. NoSQL 데이터베이스는 주로 방대한 데이터 저장 용량을 필요로 하는 분산 데이터 저장소에 사용됩니다. 빅데이터 및 실시간 웹 애플리케이션에 NoSQL이 활용되고 있습니다. 예를 들어 트위터, 페이스북 등의 기업들이 NoSQL을 사용하고 있습니다. Google 매일 수 테라바이트의 사용자 데이터를 수집합니다.
NoSQL 데이터베이스 NoSQL은 "Not Only SQL" 또는 "Not SQL"의 약자입니다. 더 적절한 용어는 "NoREL"이겠지만, NoSQL이라는 용어가 널리 사용되었습니다. 칼 스트로지는 1998년에 NoSQL 개념을 소개했습니다.
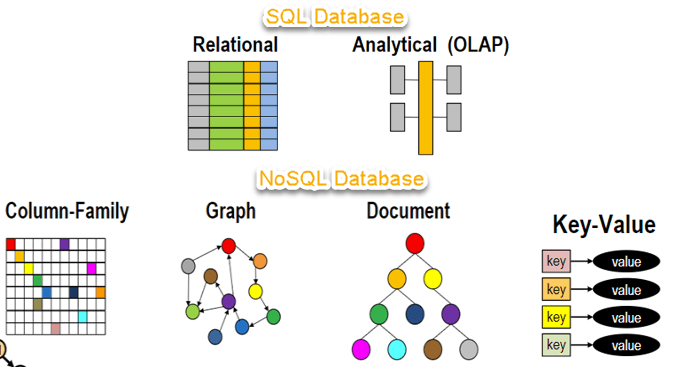
기존 관계형 데이터베이스 관리 시스템(RDBMS)은 SQL 구문을 사용하여 데이터를 저장하고 검색하여 분석합니다. 반면, NoSQL 데이터베이스 시스템은 정형, 반정형, 비정형 및 다형성 데이터를 저장할 수 있는 다양한 데이터베이스 기술을 포괄합니다. 이 NoSQL 데이터베이스 튜토리얼에서 다이어그램을 통해 NoSQL에 대해 자세히 알아보겠습니다.
왜 NoSQL인가?
NoSQL 데이터베이스 개념은 인터넷 거대 기업들 사이에서 인기를 얻게 되었습니다. Google, 페이스북, Amazon등 엄청난 양의 데이터를 다루는 사람입니다. 대용량 데이터에 RDBMS를 사용하면 시스템 응답 시간이 느려집니다.
이 문제를 해결하려면 기존 하드웨어를 업그레이드하여 시스템을 "확장"할 수 있습니다. 이 과정은 비용이 많이 듭니다.
이 문제에 대한 대안은 부하가 증가할 때마다 데이터베이스 부하를 여러 호스트에 분산하는 것입니다. 이 방법을 "스케일 아웃"이라고 합니다.

NoSQL 데이터베이스는 비관계형 데이터베이스이므로 관계형 데이터베이스보다 확장성이 뛰어납니다. 이는 웹 애플리케이션을 염두에 두고 설계되었기 때문입니다.

NoSQL 데이터베이스의 간략한 역사
- 1998년 – 카를로 스트로치는 자신이 개발한 경량 오픈소스 관계형 데이터베이스에 NoSQL이라는 용어를 사용했습니다.
- 2000년 – 그래프 데이터베이스 Neo4j가 출시되었습니다.
- 2004 - Google BigTable이 출시되었습니다.
- 2005 - CouchDB 시작됩니다.
- 2007년 – 다음 연구 논문 Amazon 다이나모가 출시되었습니다.
- 2008 – 페이스북 오픈소스 Cassandra 프로젝트.
- 2009년 – NoSQL이라는 용어가 다시 등장했다.
NoSQL의 특징
비 관계형
- NoSQL 데이터베이스는 절대 다음을 따르지 않습니다. 관계형 모델.
- 고정된 열 형식의 레코드가 포함된 테이블은 절대 제공하지 마십시오.
- 자체 포함 집합체 또는 BLOB을 사용하여 작업합니다.
- 객체 관계형 맵이 필요하지 않습니다.ping 그리고 데이터 정규화.
- 쿼리 언어, 쿼리 플래너, 참조 무결성 조인 또는 ACID와 같은 복잡한 기능은 없습니다.
스키마 프리
- NoSQL 데이터베이스는 스키마가 없거나 스키마가 완화되어 있습니다.
- 데이터 스키마에 대한 어떠한 정의도 필요하지 않습니다.
- 동일 도메인 내에서 이질적인 데이터 구조를 제공합니다.

간단한 API
- 데이터 저장 및 조회를 위한 사용하기 쉬운 인터페이스를 제공합니다.
- API는 하위 수준의 데이터 조작 및 선택 방법을 제공합니다.
- 텍스트 기반 프로토콜은 주로 HTTP REST와 JSON에서 사용됩니다.
- 주로 표준 기반이 아닌 NoSQL 쿼리 언어를 사용합니다.
- 웹 기반 데이터베이스는 인터넷을 통해 접속 가능한 서비스로 운영됩니다.
분산
- 여러 개의 NoSQL 데이터베이스를 분산 방식으로 실행할 수 있습니다.
- 자동 확장 및 장애 조치 기능을 제공합니다.
- 확장성과 처리량을 위해 ACID 개념을 희생하는 경우가 종종 있습니다.
- 분산 노드 간에는 동기식 복제가 거의 이루어지지 않으며, 비동기식 멀티마스터 복제, 피어투피어 복제, HDFS 복제가 사용됩니다.
- 궁극적인 일관성만을 제공할 뿐입니다.
- 공유 자원이 없는 아키텍처. 이를 통해 조정 부담을 줄이고 분산도를 높일 수 있습니다.

NoSQL 데이터베이스 유형
NoSQL 데이터베이스 데이터베이스는 크게 키-값 쌍, 컬럼형, 그래프형, 문서형의 네 가지 유형으로 분류됩니다. 각 유형은 고유한 특징과 한계를 가지고 있습니다. 위에 언급된 데이터베이스 중 어느 것도 모든 문제를 해결하는 데 더 나은 것은 아닙니다. 사용자는 제품의 요구 사항에 따라 적절한 데이터베이스를 선택해야 합니다.
NoSQL 데이터베이스 유형:
- 키-값 쌍 기반
- 열 중심 그래프
- 그래프 기반
- 문서 중심

키-값 쌍 기반
데이터는 키/값 쌍으로 저장됩니다. 이러한 방식은 대량의 데이터와 높은 부하를 처리하도록 설계되었습니다. 키-값 쌍 저장 데이터베이스는 각 키가 고유하고 값이 JSON, BLOB(대형 바이너리 객체), 문자열 등이 될 수 있는 해시 테이블 형태로 데이터를 저장합니다.
예를 들어, 키-값 쌍에는 "웹사이트"와 같은 키와 ""와 같은 값이 포함될 수 있습니다.Guru99. "

이는 가장 기본적인 NoSQL 데이터베이스 예시 중 하나입니다. 이러한 유형의 NoSQL 데이터베이스는 컬렉션, 딕셔너리, 연관 배열 등으로 사용됩니다. 키-값 저장소는 개발자가 스키마 없이 데이터를 저장할 수 있도록 도와줍니다. 이러한 저장소는 쇼핑몰에 가장 적합합니다.ping 장바구니 내용물.
Redis, Dynamo, Riak은 키-값 저장소 데이터베이스의 NoSQL 예시입니다. 이들은 모두 다음을 기반으로 합니다. Amazon의 Dynamo 종이입니다.
열 기반
컬럼 지향 데이터베이스는 컬럼을 기반으로 작동하며 BigTable 논문을 바탕으로 합니다. Google각 열은 개별적으로 처리됩니다. 단일 열 데이터베이스의 값은 연속적으로 저장됩니다.

이들은 SUM, COUNT와 같은 집계 쿼리에서 높은 성능을 제공합니다. AVGMIN 등과 같이 데이터가 컬럼에 바로 저장되어 있으므로 편리합니다. 컬럼 기반 NoSQL 데이터베이스는 데이터 웨어하우스를 관리하는 데 널리 사용됩니다. 비즈니스 인텔리전스CRM 및 도서관 카드 목록.
H베이스, CassandraHypertable과 같은 NoSQL 쿼리 예시는 컬럼 기반 데이터베이스를 사용합니다.
문서 지향
문서 지향형 NoSQL 데이터베이스는 데이터를 키-값 쌍으로 저장하고 검색하지만, 값 부분은 문서 형태로 저장됩니다. 이 문서는 JSON 또는 XML 형식으로 저장되며, 데이터베이스는 저장된 값을 이해하고 쿼리할 수 있습니다.

왼쪽 다이어그램에서 관계형 데이터베이스의 행과 열을 볼 수 있고, 오른쪽 다이어그램은 JSON과 유사한 구조를 가진 문서 데이터베이스를 보여줍니다. 관계형 데이터베이스에서는 어떤 열이 있는지 등을 미리 정의해야 하지만, 문서 데이터베이스는 JSON 객체와 같은 데이터 저장소를 사용합니다. 따라서 데이터 구조를 정의할 필요가 없어 유연성이 뛰어납니다.
이 문서 유형은 주로 CMS 시스템, 블로그 플랫폼, 실시간 분석 및 전자상거래 애플리케이션에 사용됩니다. 다양한 집계 구조에 대한 여러 작업이나 쿼리가 필요한 복잡한 트랜잭션에는 사용해서는 안 됩니다.
Amazon 단순DB, CouchDB, MongoDBRiak 및 Lotus Notes는 인기 있는 문서 중심 편집기입니다. DBMS 시스템.
그래프 기반
그래프형 데이터베이스는 엔티티와 엔티티 간의 관계를 저장합니다. 엔티티는 노드로, 관계는 엣지로 저장됩니다. 엣지는 노드 간의 관계를 나타냅니다. 모든 노드와 엣지는 고유한 식별자를 가지고 있습니다.

테이블 간 연결이 느슨한 관계형 데이터베이스와 달리, 그래프 데이터베이스는 본질적으로 다중 관계를 갖습니다. 관계가 데이터베이스에 이미 저장되어 있으므로 탐색 속도가 빠르며, 관계를 계산할 필요가 없습니다. 그래프 기반 데이터베이스는 주로 소셜 네트워크, 물류 및 공간 데이터에 사용됩니다.
Neo4J, 무한 그래프, OrientDB그리고 FlockDB는 인기 있는 그래프 기반 데이터베이스 중 일부입니다.
NoSQL용 쿼리 메커니즘 도구
가장 일반적인 데이터 검색 메커니즘은 GET 리소스를 사용하여 키/ID를 기반으로 값을 검색하는 REST 기반 방식입니다.
문서 저장소 데이터베이스는 키-값 쌍의 값을 이해하기 때문에 더 복잡한 쿼리를 처리할 수 있습니다. 예를 들어, CouchDB MapReduce를 사용하여 뷰를 정의할 수 있습니다.
CAP 정리란 무엇입니까?
CAP 정리(브루어 정리라고도 함)는 분산 데이터 저장소가 다음 세 가지 보장 중 두 가지 이상을 제공하는 것이 불가능하다는 것을 나타냅니다.
- 일관성
- 이용 가능 여부 (Availability)
- 파티션 공차
일관성 : 데이터는 작업 실행 후에도 일관성을 유지해야 합니다. 즉, 데이터가 기록되면 이후의 모든 읽기 요청에 해당 데이터가 포함되어야 합니다. 예를 들어, 주문 상태를 업데이트한 후에는 모든 클라이언트가 동일한 데이터를 볼 수 있어야 합니다.
운영시간: 데이터베이스는 항상 사용 가능하고 응답성이 있어야 합니다. 가동 중지 시간이 없어야 합니다.
파티션 허용오차: Partition Tolerance는 서버 간의 통신이 불안정하더라도 시스템이 계속 작동해야 함을 의미합니다. 예를 들어, 서버는 서로 통신할 수 없는 여러 그룹으로 분할될 수 있습니다. 여기서 데이터베이스의 일부를 사용할 수 없는 경우 다른 부분은 항상 영향을 받지 않습니다.
최종 일관성
"최종 일관성"이라는 용어는 고가용성과 확장성을 확보하기 위해 여러 머신에 데이터 복사본을 보유하는 것을 의미합니다. 따라서 한 머신에서 데이터 항목에 변경 사항이 발생하면 다른 복제본에도 해당 변경 사항이 반영되어야 합니다.
데이터 복제는 즉각적으로 이루어지지 않을 수 있습니다. 일부 복사본은 즉시 업데이트되는 반면, 다른 복사본은 시간이 지남에 따라 업데이트됩니다. 이러한 복사본들은 서로 일관성이 없을 수 있지만, 결국에는 일관성을 갖게 됩니다. 따라서 이를 최종 일관성(eventual consistency)이라고 합니다.
베이스: B비정상적으로 A유효한, S자주 상태, E의도적 일관성
- 기본적으로 '가용하다'는 것은 CAP 정리에 따라 데이터베이스가 항상 사용 가능하다는 것을 의미합니다.
- 소프트 상태란 입력이 없더라도 시스템 상태가 변경될 수 있음을 의미합니다.
- 최종적 일관성이란 시스템이 시간이 지남에 따라 일관성을 갖게 된다는 것을 의미합니다.

NoSQL의 장점
- 기본 데이터 소스 또는 분석 데이터 소스로 사용할 수 있습니다.
- 빅데이터 역량.
- 단일 실패 지점이 없습니다.
- 복제가 쉽습니다.
- 별도의 캐싱 계층이 필요하지 않습니다.
- 빠른 성능과 수평 확장성을 제공합니다.
- 정형 데이터, 반정형 데이터, 비정형 데이터를 모두 효과적으로 처리할 수 있습니다.
- 객체 지향 프로그래밍은 사용하기 쉽고 유연합니다.
- NoSQL 데이터베이스는 전용 고성능 서버가 필요하지 않습니다.
- 주요 개발 언어 및 플랫폼을 지원합니다.
- 관계형 데이터베이스 관리 시스템(RDBMS)을 사용하는 것보다 구현이 더 간단합니다.
- 이는 온라인 애플리케이션의 기본 데이터 소스 역할을 할 수 있습니다.
- 데이터의 속도, 다양성, 양, 복잡성을 관리하는 빅데이터를 처리합니다.
- 분산 데이터베이스 및 다중 데이터 센터 운영에 탁월합니다.
- 데이터를 저장하기 위한 별도의 캐싱 계층이 필요하지 않게 됩니다.
- 다운타임이나 서비스 중단 없이 쉽게 변경할 수 있는 유연한 스키마 설계를 제공합니다.
NoSQL의 단점
- 표준화 규칙이 없습니다.
- 제한된 조회 기능.
- RDBMS 데이터베이스와 도구는 비교적 성숙한 수준입니다.
- 여러 트랜잭션이 동시에 수행될 때 일관성을 유지하는 등 전통적인 데이터베이스 기능을 제공하지 않습니다.
- 데이터 양이 증가하면 키를 유지하기 어려워져 고유 값을 유지하기가 어려워집니다.
- 관계형 데이터에서는 제대로 작동하지 않습니다.
- 신규 개발자에게는 학습 곡선이 가파르다.
- 오픈소스 옵션은 기업들에게 그다지 인기가 없습니다.
