
MongoDB Espressioni regolari ($regex) con esempi
 Stefano Twain
⚡ Riepilogo intelligente
MongoDB Le espressioni regolari eseguono la corrispondenza di pattern per trovare stringhe all'interno dei documenti, utilizzando l'operatore $regex, il flag $options per l'insensibilità alle maiuscole/minuscole, gli ancoraggi per le corrispondenze esatte e i delimitatori slash quando il valore esatto del campo non è noto.
Le espressioni regolari vengono utilizzate per la corrispondenza di modelli, che consiste fondamentalmente nel trovare stringhe all'interno dei documenti.
A volte, quando si recuperano documenti in una raccolta, potresti non sapere esattamente quale sia l'esatto valore del campo da cercare. Pertanto, è possibile utilizzare le espressioni regolari per facilitare il recupero dei dati in base ai valori di ricerca corrispondenti ai modelli.
Utilizzo dell'operatore $regex per la corrispondenza dei modelli
L'operatore $regex in MongoDB viene utilizzato per cercare stringhe specifiche nella collezione. L'esempio seguente mostra come ciò può essere fatto.
Supponiamo di avere la stessa collezione di dipendenti con i campi denominati "Employeeid" e "EmployeeName". Supponiamo inoltre di avere i seguenti documenti nella nostra collezione.
| ID Dipendente | Nome dipendente |
|---|---|
| 22 | Nuovo Martin |
| 2 | Mohan |
| 3 | Joe |
| 4 | Mohan R |
| 100 | Guru99 |
| 6 | Gurang |
Nel codice seguente abbiamo utilizzato l'operatore $regex per specificare i criteri di ricerca.

db.Employee.find({EmployeeName : {$regex: "Gu" }}).forEach(printjson)
Code Spiegazione:
- Qui vogliamo trovare tutti i nomi dei dipendenti che contengono il carattere 'Gu'. Pertanto, specifichiamo l'operatore $regex per definire il criterio di ricerca 'Gu'.
- printjson viene utilizzato per stampare ogni documento restituito dalla query in un modo migliore.
Se il comando viene eseguito correttamente, verrà visualizzato il seguente output:
Produzione:

L'output mostra chiaramente che vengono restituiti i documenti in cui il nome del dipendente contiene i caratteri "Gu".
Supponiamo che la tua raccolta contenga i seguenti documenti con un documento aggiuntivo che contiene il nome del dipendente come "Guru999”. Se hai inserito i criteri di ricerca come “Guru99”, restituirebbe anche il documento che aveva “Guru999”. Ma supponiamo di non volerlo e di voler restituire solo il documento con “Guru99”. Quindi possiamo farlo con la corrispondenza esatta del modello. Per fare una corrispondenza esatta del modello, useremo i caratteri ^ e $. Aggiungeremo il carattere ^ all'inizio della stringa e $ alla fine della stringa.
| ID Dipendente | Nome dipendente |
|---|---|
| 22 | Nuovo Martin |
| 2 | Mohan |
| 3 | Joe |
| 4 | Mohan R |
| 100 | Guru99 |
| 6 | Gurang |
| 8 | Guru999 |
L'esempio seguente mostra come farlo.
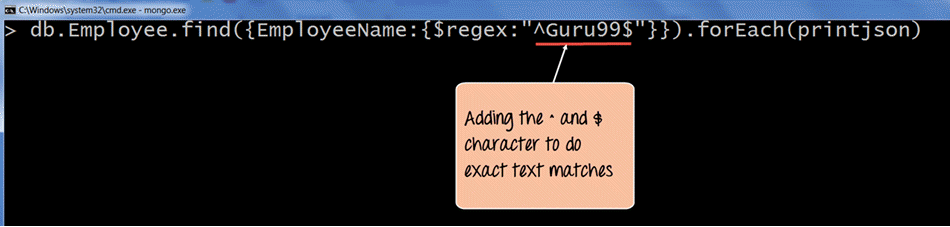
db.Employee.find({EmployeeName : {$regex: "^Guru99$"}}).forEach(printjson)
Code Spiegazione:
- Qui nei criteri di ricerca, stiamo usando i caratteri ^ e $. Il ^ viene utilizzato per assicurarsi che la stringa inizi con un determinato carattere e il $ viene utilizzato per assicurarsi che la stringa termini con un determinato carattere. Quindi quando il codice viene eseguito, estrarrà solo la stringa con il nome "Guru99 ".
- printjson viene utilizzato per stampare ogni documento restituito dalla query in un modo migliore.
Se il comando viene eseguito correttamente, verrà visualizzato il seguente output:
Produzione:
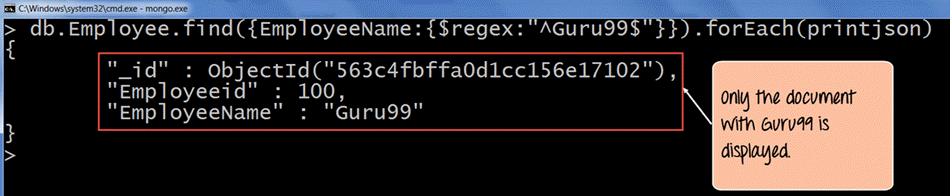
Nell'output è chiaramente visibile la stringa “Guru99” è stato recuperato.
Corrispondenza del modello con $ opzioni
Quando si utilizza l'operatore $regex è possibile fornire anche opzioni aggiuntive utilizzando $ options parola chiave. Ad esempio, supponiamo di voler trovare tutti i documenti che contengono "Gu" nel nome del dipendente, indipendentemente dal fatto che faccia distinzione tra maiuscole e minuscole o meno. Se si desidera un risultato del genere, è necessario utilizzare il file $ options con il parametro di insensibilità alle maiuscole/minuscole.
L'esempio seguente mostra come farlo.
Supponiamo di avere la stessa collezione di dipendenti con i campi denominati "Employeeid" e "EmployeeName".
Supponiamo inoltre di avere i seguenti documenti nella nostra collezione.
| ID Dipendente | Nome dipendente |
|---|---|
| 22 | Nuovo Martin |
| 2 | Mohan |
| 3 | Joe |
| 4 | Mohan R |
| 100 | Guru99 |
| 6 | Gurang |
| 7 | GURU99 |
Ora, se eseguiamo la stessa query dell'argomento precedente, non vedremo mai il documento con "GURU99" nel risultato. Per assicurarci che venga incluso nel set di risultati, dobbiamo aggiungere il parametro "i" alla variabile $options.
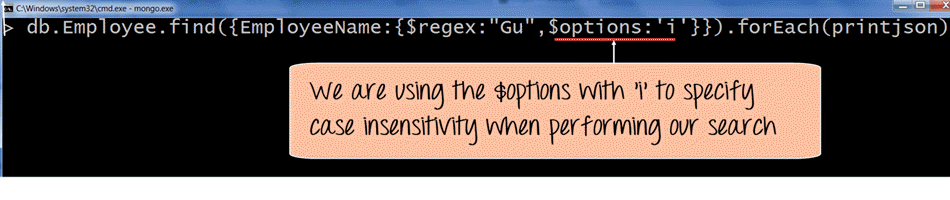
db.Employee.find({EmployeeName:{$regex: "Gu",$options:'i'}}).forEach(printjson)
Code Spiegazione:
- L'opzione $options con il parametro 'i' (che indica l'insensibilità alle maiuscole/minuscole) specifica che vogliamo eseguire la ricerca indipendentemente dal fatto che le lettere 'Gu' siano minuscole o maiuscole.
Se il comando viene eseguito correttamente, verrà visualizzato il seguente output:
Produzione:
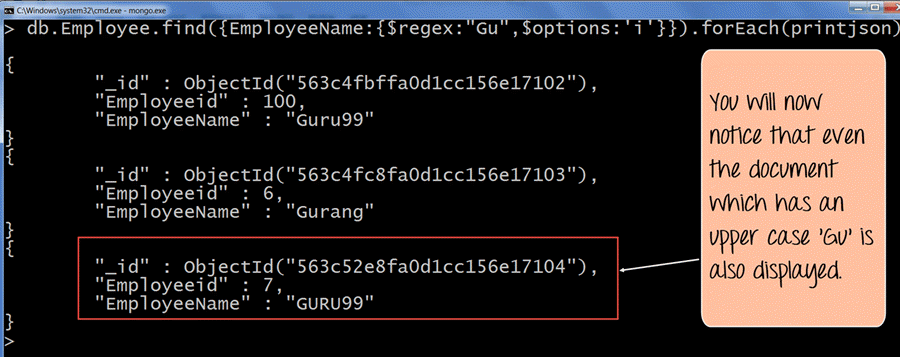
- L'output mostra chiaramente che, anche se un documento contiene la lettera maiuscola 'Gu', viene comunque visualizzato nel set di risultati.
Corrispondenza di modelli senza l'operatore regex
È possibile effettuare la corrispondenza di pattern anche senza l'operatore $regex. L'esempio seguente mostra come fare.
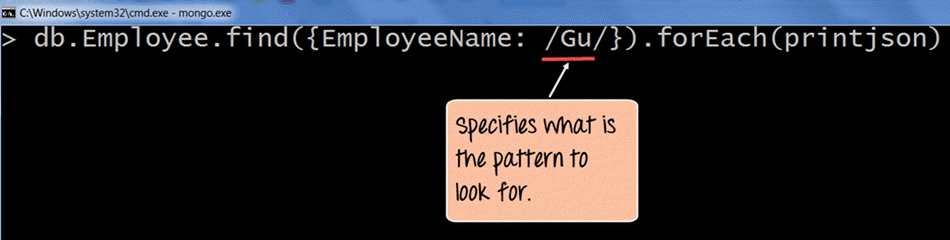
db.Employee.find({EmployeeName: /Gu/}).forEach(printjson)
Code Spiegazione:
- I delimitatori "//" servono fondamentalmente a specificare i criteri di ricerca all'interno di questi delimitatori. Pertanto, specifichiamo /Gu/ per trovare nuovamente i documenti che contengono "Gu" nel campo EmployeeName.
Se il comando viene eseguito correttamente, verrà visualizzato il seguente output:
Produzione:
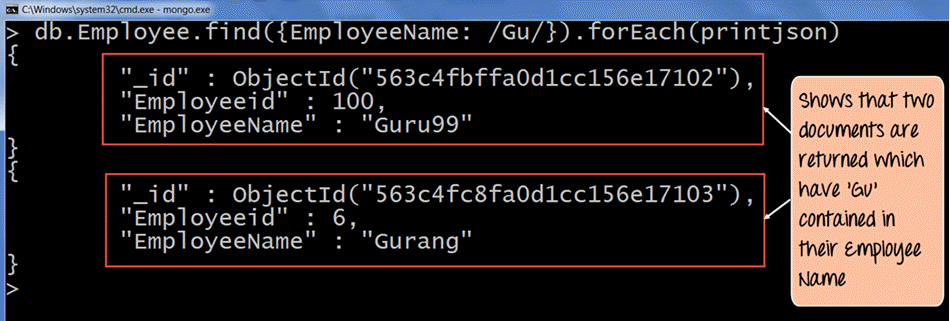
L'output mostra chiaramente che vengono restituiti i documenti in cui il nome del dipendente contiene i caratteri "Gu".
Recupero degli ultimi 'n' documenti da una raccolta
Esistono vari modi per ottenere gli ultimi n documenti in una raccolta.
Analizziamo uno dei metodi attraverso i seguenti passaggi.
L'esempio seguente mostra come farlo.
Supponiamo di avere la stessa collezione di dipendenti con i campi denominati "Employeeid" e "EmployeeName".
Supponiamo inoltre di avere nella nostra collezione i seguenti documenti:
| ID Dipendente | Nome dipendente |
|---|---|
| 22 | Nuovo Martin |
| 2 | Mohan |
| 3 | Joe |
| 4 | Mohan R |
| 100 | Guru99 |
| 6 | Gurang |
| 7 | GURU99 |
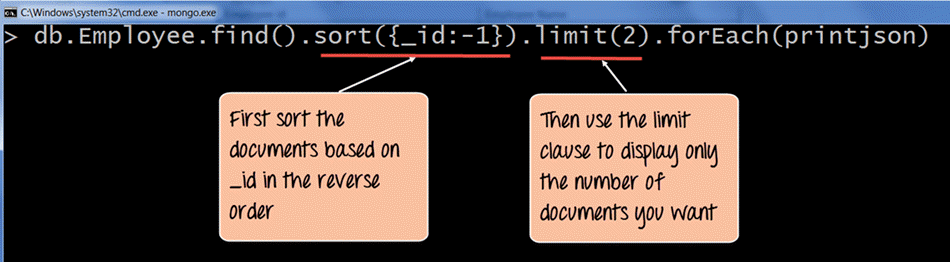
db.Employee.find().sort({_id:-1}).limit(2).forEach(printjson)
Code Spiegazione:
- Quando si interrogano i documenti, utilizzare la funzione sort per ordinare i record in ordine inverso in base al valore del campo _id nella collezione. Il valore -1 indica sostanzialmente di ordinare i documenti in ordine inverso o decrescente, in modo che l'ultimo documento diventi il primo a essere visualizzato.
- Quindi usa la clausola LIMIT per visualizzare solo il numero di record che desideri. Qui abbiamo impostato la clausola LIMIT (2), quindi verranno recuperati gli ultimi due documenti.
Se il comando viene eseguito correttamente, verrà visualizzato il seguente output:
Produzione:
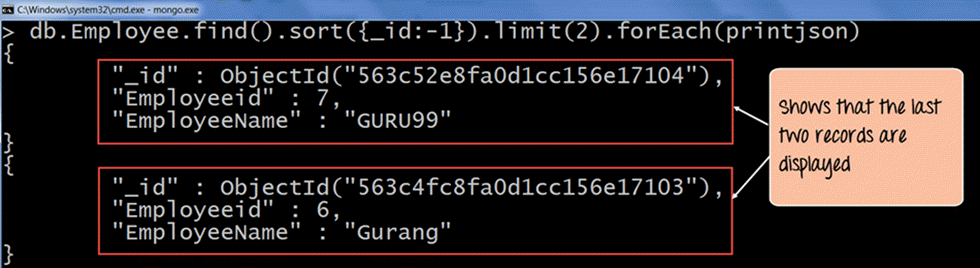
L'output mostra chiaramente che vengono visualizzati gli ultimi due documenti della raccolta. Quindi abbiamo chiaramente dimostrato che per recuperare gli ultimi "n" documenti nella raccolta, possiamo prima ordinare i documenti in ordine decrescente e quindi utilizzare la clausola limite per restituire il numero "n" di documenti richiesti.
Note:: Se la ricerca viene eseguita su una stringa che supera, diciamo, 38,000 caratteri, non verranno visualizzati i risultati corretti.
