
Tutorial su Apache Oozie: Diagramma di flusso, Scheduler
 Prafulla Ranadive
⚡ Riepilogo intelligente
Apache Oozie è lo scheduler di workflow per Hadoop che esegue job dipendenti come grafi aciclici diretti, combinando un motore di workflow per azioni MapReduce, Pig e Hive con un motore di coordinamento guidato dal tempo e dalla disponibilità dei dati.
Cos'è Apache Oozie?
Apache Oozie è uno scheduler di flussi di lavoro per HadoopSi tratta di un sistema che gestisce il flusso di lavoro di processi dipendenti. Qui, gli utenti possono creare grafi aciclici diretti di flussi di lavoro, che possono essere eseguiti in parallelo e in sequenza in Hadoop.
Si compone di due parti:
- Motore del flusso di lavoro: La responsabilità di un motore di workflow è quella di memorizzare ed eseguire workflow composti da job Hadoop, ad esempio, MapReduce, Maiale, Alveare.
- Motore di coordinamento: Esegue processi di flusso di lavoro in base a pianificazioni predefinite e alla disponibilità dei dati.
Oozie è scalabile e può gestire l'esecuzione puntuale di migliaia di flussi di lavoro (ciascuno composto da decine di job) in un cluster Hadoop. Il diagramma seguente mostra la posizione dello scheduler rispetto al cluster e ai job che gestisce.

Oozie è anche molto flessibile. È possibile avviare, arrestare, sospendere e riavviare i processi con facilità. Oozie semplifica notevolmente la riesecuzione dei flussi di lavoro non riusciti. È facile capire quanto possa essere difficile recuperare i processi persi o non riusciti a causa di tempi di inattività o guasti. È persino possibile saltare un nodo specifico che ha generato un errore.
Stato del progetto: Apache Oozie è stato ritirato da Apache Software Foundation nel febbraio 2025 e il trasferimento al Soffitta Apache Completato nell'aprile 2025. La versione finale rimane la 5.2.1 di febbraio 2021 e il repository del codice sorgente è ora di sola lettura. I cluster esistenti lo utilizzano ancora, motivo per cui è utile conoscere i meccanismi descritti di seguito, ma le nuove pipeline vengono normalmente create su Apache Airflow.
Come funziona Oozie?
Oozie viene eseguito come servizio nel cluster e i client inviano le definizioni dei flussi di lavoro per l'elaborazione immediata o successiva.
Un flusso di lavoro Oozie è costituito da nodi di azione e nodi di controllo del flusso.
Un nodo azione rappresenta un'attività del flusso di lavoro, ad esempio lo spostamento dei file in HDFS, eseguendo un job MapReduce, Pig o Hive, importando dati utilizzando Sqop, oppure eseguendo uno script di shell o un programma scritto in Java.
Un nodo di controllo del flusso gestisce l'esecuzione del flusso di lavoro tra le azioni, consentendo l'utilizzo di costrutti come la logica condizionale, in cui è possibile seguire diversi rami a seconda del risultato di un nodo di azione precedente.
In questa categoria di nodi rientrano il nodo iniziale, il nodo finale e il nodo di errore.
- Avvia nodo designa l'inizio del lavoro del flusso di lavoro.
- Fine nodo segnala la fine del lavoro.
- Nodo di errore Indica il verificarsi di un errore e il relativo messaggio di errore da stampare.
Al termine dell'esecuzione di un flusso di lavoro, Oozie utilizza una callback HTTP per aggiornare il client sullo stato del flusso di lavoro. Anche l'ingresso o l'uscita da un nodo di azione possono attivare la callback.
Nodi di controllo e tipi di azione di Oozie
Oltre a inizio, fine ed errore, il flusso di lavoro XML supporta un piccolo vocabolario di nodi di controllo che definiscono la struttura del grafico.
- decisione: Valuta un'espressione e indirizza il flusso di lavoro verso uno dei diversi rami possibili, l'equivalente di un'istruzione switch.
- forchetta: Suddivide il percorso in modo che due o più azioni vengano eseguite in parallelo.
- aderire: Attende che ogni ramo di una forchetta corrispondente sia terminato prima di proseguire.
- uccidere: Interrompe immediatamente il flusso di lavoro e registra il messaggio di errore.
I nodi di azione riguardano il lavoro vero e proprio e ognuno ha il proprio elemento XML:
- map-reduce, pig, hive e sqoop Le azioni avviano il corrispondente job Hadoop.
- Giava esegue una classe principale sul cluster; conchiglia and SSH eseguire gli script.
- fs esegue le operazioni di pulizia di HDFSping come sposta, elimina, crea directory e cambia permessi.
- email notifica ai destinatari e sottoflusso di lavoro chiama un'altra applicazione di flusso di lavoro.
Esempio di diagramma del flusso di lavoro
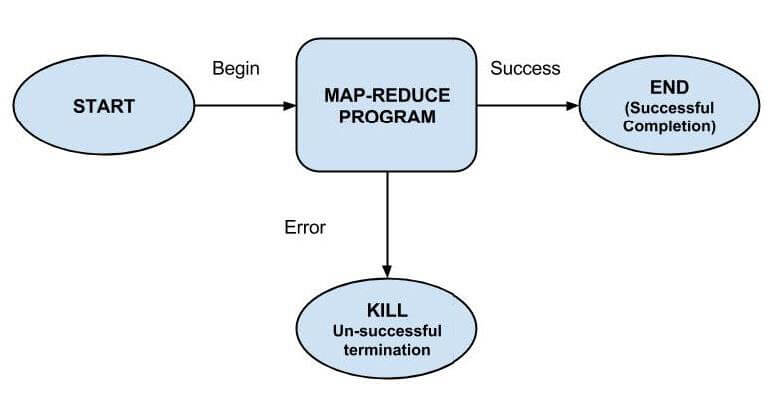
Il diagramma sottostante tracSi tratta di un piccolo flusso di lavoro che parte dal suo nodo iniziale, passa attraverso un'azione MapReduce e arriva al nodo finale oppure al percorso di errore quando l'azione fallisce.
Tipi di lavori Oozie
Oozie descrive il lavoro su tre livelli. Ogni livello racchiude quello sottostante, quindi un pacchetto controlla in definitiva molti flussi di lavoro individuali.
| Tipo di lavoro | Cosa definisce | Innescato da |
|---|---|---|
| Workflow | Un grafo aciclico diretto di nodi di azione e controllo, scritto in workflow.xml | Invio manuale o tramite un coordinatore |
| Coordinatore | Una pianificazione ricorrente per un flusso di lavoro, con un orario di inizio, un orario di fine e una frequenza. | Orario e disponibilità dei dati di input |
| Bundle | Una raccolta di applicazioni di coordinamento gestite insieme come un'unica pipeline di dati. | Un orario di inizio applicato a tutti i suoi coordinatori |
In pratica, questa distinzione è importante: un flusso di lavoro risponde alla domanda "cosa viene eseguito", un coordinatore risponde alla domanda "quando viene eseguito" e un pacchetto risponde alla domanda "cosa inizia e finisce insieme".
Creazione e distribuzione di un'applicazione Oozie per la gestione dei flussi di lavoro.
Un'applicazione workflow è composta dalla definizione del workflow e da tutte le risorse associate, come file JAR di MapReduce, script Pig, ecc. Le applicazioni devono seguire una semplice struttura di directory e vengono distribuite su HDFS in modo che Oozie possa accedervi.
Di seguito è riportato un esempio di struttura di directory:
<name of workflow>/
├── lib/
│   └── hadoop-examples.jar
└── workflow.xml
È necessario che il file workflow.xml (un file di definizione del flusso di lavoro) si trovi nella directory principale (la directory padre che contiene il nome del flusso di lavoro). La directory lib contiene i file JAR con le classi MapReduce. Un'applicazione workflow conforme a questa struttura può essere compilata con qualsiasi strumento di build, ad esempio Ant o Maven.
Una tale build deve essere copiata in HDFS utilizzando un comando, ad esempio:
% hadoop fs -put hadoop-examples/target/<name of workflow dir> name of workflow
Procedura per l'esecuzione di un processo di flusso di lavoro Oozie
In questa sezione vedremo come eseguire un lavoro del flusso di lavoro. Per eseguirlo, utilizzeremo lo strumento da riga di comando Oozie (un programma client che comunica con il server Oozie).
1. Esporta l'OOZIE_URL variabile d'ambiente che indica al comando oozie quale server Oozie utilizzare (in questo caso ne stiamo usando uno in esecuzione localmente):
% export OOZIE_URL="http://localhost:11000/oozie"
2. Eseguire il processo del flusso di lavoro utilizzando:
% oozie job -config ch05/src/main/resources/max-temp-workflow.properties -run
L'opzione -config si riferisce a un file locale Java delle proprietà contenente le definizioni per i parametri nel file XML del flusso di lavoro, nonché oozie.wf.application.path, che indica a Oozie la posizione dell'applicazione del flusso di lavoro in HDFS.
Contenuto di esempio del file delle proprietà:
nameNode=hdfs://localhost:8020
jobTracker=localhost:8021
oozie.wf.application.path=${nameNode}/user/${user.name}/<name of workflow>
3. Ottieni lo stato del processo del flusso di lavoro.
Lo stato di un job del flusso di lavoro può essere visualizzato utilizzando il sottocomando 'job' con l'opzione '-info', specificando l'ID del job dopo '-info'.
e.g., % oozie job -info <job id>
L'output mostra uno stato che può essere RUNNING, KILLED o SUCCEEDED.
4. I risultati dell'esecuzione corretta del flusso di lavoro possono essere visualizzati utilizzando un comando Hadoop come:
% hadoop fs -cat <location of result>
Perché usare Oozie?
Lo scopo principale dell'utilizzo di Oozie è quello di gestire i diversi tipi di processi elaborati in un sistema Hadoop.
Le dipendenze tra i job vengono specificate dall'utente sotto forma di grafi aciclici diretti. Oozie elabora queste informazioni e si occupa della loro esecuzione nell'ordine corretto, come specificato nel workflow. In questo modo, l'utente risparmia tempo nella gestione di un workflow completo. Inoltre, Oozie offre la possibilità di specificare la frequenza di esecuzione di un determinato job.
Caratteristiche di Oozie
- Oozie ha un'API client e un'interfaccia a riga di comando che può essere utilizzata per avviare, controllare e monitorare i lavori da un Java applicazione.
- Grazie alle sue API di servizi web, è possibile controllare i processi da qualsiasi luogo.
- Oozie prevede la possibilità di eseguire processi programmati a intervalli regolari.
- Oozie offre la possibilità di inviare notifiche via email al completamento delle attività.
Oozie contro Apache Airflow
Poiché Oozie non è più supportato, la maggior parte dei team che oggi valutano uno scheduler confrontano le soluzioni che già utilizzano con Apache Airflow. I due strumenti risolvono lo stesso problema da prospettive opposte.
| Aspetto | Apache Oozie | Flusso d'aria Apache |
|---|---|---|
| Linguaggio di definizione | Flussi di lavoro scritti in formato XML | I DAG sono scritti come Python codice |
| Obbiettivo | Costruito attorno ad azioni Hadoop come MapReduce, Pig, Hive e Sqoop | Uso generale, con operatori per servizi cloud, database e container. |
| Programmazione | Posizioni di coordinamento vincolate a tempi e disponibilità dei dati | Programmazione degli intervalli più sensori che si attivano in base alle condizioni esterne. |
| Stato del progetto | Ritirato nella soffitta degli Apache nel 2025; versione finale 5.2.1 | Progetto Apache di livello superiore in fase di sviluppo attivo |
Oozie rimane l'opzione più semplice su un cluster che già lo esegue, poiché le azioni corrispondono uno a uno ai componenti di Hadoop. Airflow è la scelta più pratica per qualsiasi nuova implementazione, in particolare quando una pipeline si estende oltre Hadoop.
