
Tutorial su Hadoop Pig: cos'è Apache Pig? Architecnica, esempio
 Prafulla Ranadive
⚡ Riepilogo intelligente
Apache Pig è una piattaforma di alto livello per l'analisi di grandi set di dati su Hadoop, che combina il linguaggio di flusso di dati Pig Latin con un runtime che compila ogni script in MapReduce, Tez o Spark lavori automaticamente.
Questo tutorial inizia con l'idea alla base di Apache Pig, per poi illustrare l'installazione e l'esecuzione completa di uno script Pig Latin.
Cos'è Apache Pig?
Il maiale è un animale di alto livello linguaggio di programmazione Utile per analizzare grandi insiemi di dati. Pig è nato da un progetto di sviluppo di Yahoo!
In un framework MapReduce, i programmi devono essere tradotti in una serie di fasi Map e Reduce. Tuttavia, questo non è un modello di programmazione con cui gli analisti di dati hanno familiarità. Quindi, per colmare questa lacuna, un assolutotraczione chiamata Pig è stata costruita sopra Hadoop.
Apache Pig permette di concentrarsi maggiormente sull'analisi di grandi quantità di dati e di dedicare meno tempo alla scrittura di programmi MapReduce. Proprio come i maiali, che mangiano di tutto, il linguaggio di programmazione Apache Pig è progettato per funzionare con qualsiasi tipo di dato. Ecco perché il nome, Pig! La mascotte del progetto qui sotto illustra perfettamente il concetto.

Il progetto è ancora attivo. Apache Pig 0.18.0 è stato rilasciato il 15 settembre 2025 e aggiunge il supporto per Hadoop 3, Tez 0.10, Hive 3, Spark 3, HBase 2 e Python 3, secondo il Pagina delle release di Apache PigLa procedura descritta di seguito è stata originariamente scritta per la versione 0.12.1, molto più vecchia, quindi alcuni passaggi includono una nota in cui si afferma che la versione attuale si comporta in modo diverso.
Maiale Architectura
L'architettura di Pig è composta da due componenti:
- Maiale latino, che è una lingua
- Un ambiente di esecuzione, per l'esecuzione di programmi in Pig Latin.
Un programma Pig Latin è costituito da una serie di operazioni o trasformazioni che vengono applicate ai dati di input per produrre output. Queste operazioni descrivono un flusso di dati che viene tradotto in una rappresentazione eseguibile dall'ambiente di esecuzione Hadoop Pig. In sostanza, i risultati di queste trasformazioni sono una serie di MapReduce processi di cui un programmatore non è a conoscenza. Quindi, in un certo senso, Pig in Hadoop permette al programmatore di concentrarsi sui dati piuttosto che sulla natura dell'esecuzione.
Il Pig Latin è un linguaggio relativamente rigido che utilizza parole chiave familiari dell'elaborazione dati, ad esempio Join, Group e Filter. Il diagramma seguente tracSi tratta di uno script proveniente dalla shell di Grunt che, attraverso il parser, l'ottimizzatore e il compilatore, viene elaborato prima di raggiungere il motore di esecuzione.

Modalità di esecuzione
Pig in Hadoop ha due modalità di esecuzione e la procedura di installazione descritta più avanti le utilizza entrambe:
- Modalità locale: In questa modalità, il linguaggio Hadoop Pig viene eseguito in un singolo JVM e utilizza il file system locale. Questa modalità è adatta solo per l'analisi di piccoli set di dati utilizzando Pig in Hadoop.
- Modalità MapReduce: In questa modalità, le query scritte in Pig Latin vengono tradotte in job MapReduce ed eseguite su un cluster Hadoop (il cluster può essere pseudo-distribuito o completamente distribuito). La modalità MapReduce con un cluster completamente distribuito è utile per eseguire Pig su grandi insiemi di dati.
Quei due sono la coppia classica. Le versioni attuali espongono effettivamente sei tipi di esecuzione, o exectype, ciascuno selezionato con lo stesso -x bandiera, come documentato nel Guida introduttiva a Pig 0.18.0.
| Esettico | Comando | Dove il lavoro va |
|---|---|---|
| Local | maiale -x locale | Una singola JVM rispetto al file system locale |
| Tez locale | maiale -x tez_local | Una singola JVM che utilizza il runtime Tez (sperimentale) |
| Spark locale | maiale -x spark_local | Una singola JVM che utilizza la Spark tempo di esecuzione (sperimentale) |
| MapReduce | pig o pig -x mapreduce | Un cluster Hadoop con HDFS; questa è l'impostazione predefinita |
| Tez | maiale -x tez | Un cluster Hadoop che esegue il motore Tez |
| Spark | maiale -x scintilla | A SparkCluster YARN o Mesos con HDFS |
Tipi di dati Pig Latin e OperaTors
Prima di scrivere uno script, è utile sapere cosa Pig può contenere e cosa può fargli. Il modello dati è completamente annidato, il che permette a Pig di leggere file di log e altri input con struttura debole che una tabella relazionale rifiuterebbe.
Il Pig Latin offre due famiglie di tipi:
- Tipi scalari:
int,long,float,double,chararray,bytearray,boolean,datetime,bigintegerandbigdecimal. Lo script di esempio in seguito dichiara ogni colonna comechararray. - Tipi complessi: a tupla è un insieme ordinato di campi e si comporta come una riga; Bags è una collezione non ordinata di tuple e si comporta come una tabella; carta geografica è un insieme di coppie chiave-valore la cui chiave deve essere una
chararray.
Gli operatori rientrano in un numero ristretto di settori, e una manciata di loro gestisce quasi tutte le condutture:
| Operator | Ciò che fa |
|---|---|
| CARICA / MEMORIZZA | Leggere una relazione dal file system e riscrivere il risultato |
| FILTRO | Mantieni solo le tuple che corrispondono a una condizione |
| PER OGNI … GENERARE | Procedi colonna per colonna, creando nuovi campi |
| GRUPPO / COGRUPPO | Raggruppa una relazione, o due o più relazioni, tramite una chiave |
| ISCRIVITI | Unire le relazioni con un join interno o esterno |
| UNIONE / DIVISIONE | Unire le relazioni o dividerne una in diverse |
| ORDINA PER / DISTINTO / LIMITA | Ordina, elimina i duplicati e limita il numero di tuple |
| SCARICA / DESCRIVI / SPIEGA / ILLUSTRA | Esaminare i risultati, gli schemi, i piani di esecuzione e le esecuzioni di esempio. |
Anche i quattro operatori di ispezione hanno scorciatoie Grunt, che consentono di risparmiare tempo.ping durante il debug: \d per DUMP, \de per DESCRIVERE, \e per SPIEGARE e \i per ILLUSTRARE.
Prerequisiti
Pig è uno strumento lato client. Analizza uno script, pianifica il lavoro e invia i job, ma non fornisce spazio di archiviazione o un cluster proprio, quindi è necessario disporre prima di un'installazione Hadoop funzionante. L'elenco dei requisiti di Apache è breve.
| Componente | Requisito | Perché è necessario |
|---|---|---|
| Hadoop | Hadoop 2.x o 3.x, con HADOOP_HOME esportato | Fornisce HDFS e il motore di esecuzione. Senza HADOOP_HOME, Pig 0.18.0 utilizza Hadoop 2.7.3 integrato. |
| Java | Java 1.7 o versioni successive, con JAVA_HOME impostato sulla directory di installazione | Pig e i daemon Hadoop sono Java programmi |
| Python (facoltativo) | Python 2.7 | Necessario solo per lo streaming Python funzioni definite dall'utente |
| Formica (facoltativa) | Formica 1.8 | Necessario solo durante la compilazione o la ricompilazione di Pig dai sorgenti. |
Due punti pratici accompagnano quell'elenco. In primo luogo, esegui tutto come un utente Linux che ha già una directory home in HDFS e il permesso di scriverci; questo tutorial utilizza hduser, l'account creato durante la configurazione di Hadoop. In secondo luogo, avviare il cluster prima di avviare Pig in modalità MapReduce, perché Pig fallisce immediatamente se NameNode e ResourceManager sono inattivi. Se Hadoop non è ancora installato, procedere tramite come installare Hadoop prima.
Come scaricare e installare Pig
Ora in questo tutorial di Apache Pig impareremo come scaricare e installare Pig:
Prima di iniziare con la procedura vera e propria, assicurati di aver installato Hadoop. Cambia utente in 'hduser' (l'ID utilizzato durante la configurazione di Hadoop; puoi passare all'ID utente che usi per la tua configurazione di Hadoop).

Passo 1) Scarica l'ultima versione stabile di Pig Hadoop da uno qualsiasi dei siti mirror disponibili all'indirizzo
https://pig.apache.org/releases.html
Seleziona il file tar.gz (e non src.tar.gz) da scaricare, come mostrato di seguito.

Passo 2) Una volta completato il download, accedi alla directory contenente il file tar scaricato e sposta il file tar nella posizione in cui desideri installare Pig Hadoop. In questo caso, lo sposteremo in /usr/local.

Spostati nella directory che conterrà i file di Pig Hadoop.
cd /usr/local
Extracil contenuto del file tar come di seguito.
sudo tar -xvf pig-0.12.1.tar.gz

Passo 3) Modifica il file ~/.bashrc per aggiungere le variabili d'ambiente relative a Pig.
Apri il file ~/.bashrc con un qualsiasi editor di testo a tua scelta e apporta le modifiche indicate di seguito.
export PIG_HOME=<Installation directory of Pig>
export PATH=$PIG_HOME/bin:$HADOOP_HOME/bin:$PATH

Passo 4) Ora, esegui il caricamento di questa configurazione d'ambiente utilizzando il comando seguente.
. ~/.bashrc

Passo 5) Dobbiamo ricompilare Pig per supportare Hadoop 2.2.0.
Ecco i passaggi da seguire.
Vai alla directory principale di Pig.
cd $PIG_HOME
Installa Ant.
sudo apt-get install ant

Nota: il download si avvierà e richiederà tempo in base alla velocità della tua connessione internet.
Ricompila Pig.
sudo ant clean jar-all -Dhadoopversion=23

Si prega di notare che durante questo processo di ricompilazione vengono scaricati diversi componenti, pertanto il sistema deve essere connesso a Internet.
Inoltre, se questo processo si blocca e non vedi alcun movimento nel prompt dei comandi per più di 20 minuti, premi Ctrl + c ed esegui nuovamente lo stesso comando.
Nel nostro caso, ci vogliono 20 minuti.

Questo passaggio di ricompilazione appartiene all'era 0.12.1, quando i jar spediti venivano creati contro Hadoop 1 e il -Dhadoopversion=23 Il flag ha cambiato la build Ant per la linea Hadoop 0.23 e 2.x. Apache Pig 0.18.0 include binari che funzionano già su Hadoop 2.7 e versioni successive, nonché su Hadoop 3, quindi in una versione corrente è normalmente possibile estrarre il file tarball e passare direttamente al test seguente.
Passo 6) Verifica l'installazione di Pig utilizzando il comando
pig -help

Esempio di sceneggiatura di maiale
Una volta installato Pig, il resto di questo tutorial su Apache Pig esegue uno script completo. Useremo Pig Scripts per trovare il numero di prodotti venduti in ciascun paese.
Input: Il nostro set di dati di input è un file CSV, VenditeJan2009.csv.
Passo 1) Avvia Hadoop.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Passo 2) Pig in Big Data preleva un file da HDFS in modalità MapReduce e memorizza i risultati nuovamente in HDFS.
Copia il file SalesJan2009.csv (memorizzato sul file system locale in ~/input/SalesJan2009.csv) nella directory home di HDFS (Hadoop Distributed File System).
In questo esempio di Apache Pig, il file si trova nella cartella `input`. Se il file è memorizzato in un'altra posizione, specifica quel nome.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/input/SalesJan2009.csv /

Verifica se il file è stato effettivamente copiato.
$HADOOP_HOME/bin/hdfs dfs -ls /

Passo 3) Configurazione Pig.
Innanzitutto, accedi alla directory $PIG_HOME/conf e conserva una copia del file di proprietà originale.
cd $PIG_HOME/conf
sudo cp pig.properties pig.properties.original

Apri il file pig.properties con un editor di testo a tua scelta e specifica il percorso del file di log utilizzando pig.logfile.
sudo gedit pig.properties

Il sistema di registrazione utilizzerà questo file per registrare gli errori.
Passo 4) Esegui il comando 'pig', che avvierà il prompt dei comandi di Pig, una shell interattiva per le query Pig.
pig

Passo 5) Nel prompt dei comandi di Grunt per Pig, eseguire i seguenti comandi Pig in ordine.
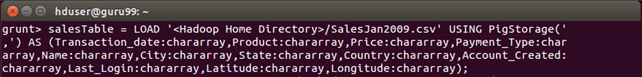
— A. Caricare il file contenente i dati.
salesTable = LOAD '/SalesJan2009.csv' USING PigStorage(',') AS (Transaction_date:chararray,Product:chararray,Price:chararray,Payment_Type:chararray,Name:chararray,City:chararray,State:chararray,Country:chararray,Account_Created:chararray,Last_Login:chararray,Latitude:chararray,Longitude:chararray);
Premi Invio dopo questo comando.
— B. Raggruppa i dati in base al campo Paese.
GroupByCountry = GROUP salesTable BY Country;

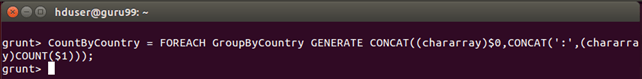
— C. Per ogni tupla in 'GroupByCountry', genera la stringa risultante del tipo Nome del Paese: Numero di prodotti venduti.
CountByCountry = FOREACH GroupByCountry GENERATE CONCAT((chararray)$0,CONCAT(':',(chararray)COUNT($1)));
Premi Invio dopo questo comando.
— D. Memorizza i risultati del flusso di dati nella directory 'pig_output_sales' su HDFS.
STORE CountByCountry INTO 'pig_output_sales' USING PigStorage('\t');

L'esecuzione di questo comando richiederà del tempo. Una volta completata, dovresti visualizzare la seguente schermata.

Passo 6) Il risultato può essere visualizzato tramite l'interfaccia di comando come
$HADOOP_HOME/bin/hdfs dfs -cat pig_output_sales/part-r-00000

I risultati possono essere visualizzati anche tramite un'interfaccia web.
Apri http://localhost:50070/ in un browser web.
La porta 50070 è l'interfaccia web del NameNode su Hadoop 2. Hadoop 3 ha spostato la stessa pagina sulla porta 9870, quindi usa quest'ultimo indirizzo se il tuo cluster utilizza Hadoop 3.

Ora seleziona "Esplora il filesystem" e naviga fino a /user/hduser/pig_output_sales.

Apri la parte r-00000 per leggere le coppie paese e quantità di prodotto generate dallo script.

Apache Pig vs Hive vs MapReduce
Pig viene raramente valutato da solo. La domanda usuale è se un lavoro appartiene a Pig, in Alveare oppure in un programma MapReduce scritto manualmente, dato che tutti e tre finiscono per essere eseguiti come job sullo stesso cluster.
| Aspetto | MapReduce (Java) | Maiale Apache | Alveare di Apache |
|---|---|---|---|
| Interfaccia | Java API | Pig Latin, un linguaggio di scripting per il flusso di dati | HiveQL, un dialetto SQL |
| Livello di addominalitracproduzione | Basso | Medio | Alto |
| Utente tipico | Java sviluppatore | Ingegnere o ricercatore dei dati | Analista con dimestichezza con SQL |
| Dati adatti | Qualsiasi cosa, gestita manualmente | Strutturato e semi-strutturato; lo schema è opzionale al momento del caricamento. | Tabelle strutturate registrate in un metastore |
| Code volume | La maggior parte delle linee | Meno linee | Il minor numero di righe per una query |
| Esegue come | Un job MapReduce | Compila in MapReduce, Tez o Spark posti di lavoro | Compila in MapReduce, Tez o Spark posti di lavoro |
| benvenuti alle | Controllo completo e logica personalizzata | Pipeline ETL a più fasi | Interrogazioni e reportistica ad hoc |
In pratica la distinzione è semplice. Scegli Hive quando i dati hanno già la forma di una tabella e la domanda è formulata come SQL. Scegli Pig quando l'input è disordinato, quando la pipeline è una catena di trasformazioni piuttosto che una singola query, o quando lo stesso script deve diramarsi e ricongiungersi. Scegli MapReduce solo quando nessuno dei due approcci è adatto.tracLa funzione può esprimere la logica, perché il numero di righe cresce rapidamente.
Il maiale si integra perfettamente nell'ecosistema. Sqoop e Flume atterra i dati grezzi, Pig o Hive li modellano e uno scheduler come Apache Oozie incatena i passaggi in una pipeline ripetibile. Per un quadro più ampio di dove si inseriscono questi strumenti, consultare la guida a Big Data e la raccolta di strumenti per big data; per un'alternativa commerciale ETL agli script scritti a mano, vedere Talend.
