
Come impostare Cassandra Cluster su più nodi
 Team editoriale
⚡ Riepilogo intelligente
Cassandra Cluster Raggruppa più nodi in modo che i dati siano distribuiti e nessuna singola macchina contenga tutto. Questa pagina spiega i componenti del cluster, il partizionatore e il token ring, i prerequisiti, le impostazioni di configurazione che uniscono i nodi e come verificarne il risultato.
Cosa è Cassandra Cluster?
A Cassandra il cluster è una delle conchiglie nel loro insieme Cassandra Banca dati. Il Cassandra Il cluster contiene numerosi livelli diversi di unità di archiviazione, e ogni livello contiene gli altri.
Grande organizzazione come AmazonFacebook, ecc. hanno enormi quantità di dati da gestire. Quindi queste organizzazioni non possono archiviare questa enorme quantità di dati su una singola macchina. È qui che entrano in gioco i database come Cassandra con architettura distribuita.
Queste organizzazioni memorizzano questa enorme quantità di dati su più nodi. Questi nodi comunicano tra loro. A questo scopo, Cassandra viene istituito il cluster.
- Cluster Si tratta fondamentalmente di un gruppo di nodi, in modo che i nodi possano comunicare facilmente tra loro.
- Il nodo coordinatore è il nodo che riceve una richiesta da un client e comunica con le repliche per conto di tale client. Qualsiasi nodo può fungere da coordinatore per qualsiasi richiesta.
Partizionatore
Un partizionatore determina come distribuire i dati nel cluster. Il partizionatore utilizza una funzione hash per distribuire i dati nel cluster. È necessaria la chiave di partizione per calcolare l'hash. Questo hash si chiama token. I dati vengono distribuiti sulla base di questo token.
Il partizionatore predefinito è Murmur3Partitioner, che produce token distribuiti uniformemente su un intervallo fisso. Ogni nodo possiede uno o più intervalli di quell'intervallo e la raccolta di intervalli forma il token ringPoiché l'assegnazione avviene tramite hash anziché tramite valore, l'aggiunta di un nodo sposta solo gli intervalli che occupa, anziché rimescolare l'intero set di dati.
Prerequisiti per Cassandra Cluster
Per la configurazione del cluster sono previsti i seguenti requisiti.
- È necessario disporre di più macchine, fisiche o virtuali, che fungano da nodi.
- I nodi devono essere in grado di raggiungersi reciprocamente sulla rete. Le porte 7000 per il traffico tra nodi, 7001 se TLS è abilitato e 9042 per le connessioni client devono essere aperte tra di essi.
- Linux dovrebbe essere installato su ogni nodo. È la piattaforma Cassandra è testato e supportato su.
- Apache Cassandra Deve essere installato su ogni nodo, nella stessa versione. Versioni diverse non consentono di completare un accordo di schema.
- Un supportato JDK deve essere installato su ogni macchina, con JAVA_HOME impostato.
- Gli orologi devono essere sincronizzati con NTP. Cassandra risolve le scritture in conflitto tramite timestamp, quindi la deriva dell'orologio produce silenziosamente risultati errati.
L'ultimo requisito è quello che più spesso viene trascurato e causa problemi ai dati anziché errori all'avvio.
.
Come installare Cassandra Cluster su Linux
Cassandra Deve essere installato su ogni macchina prima che una qualsiasi di esse possa unirsi a un cluster. Gli screenshot seguenti provengono dal programma di installazione grafico di DataStax Enterprise, che era il metodo più comune quando questa guida è stata scritta. Tale programma di installazione non è più distribuito per l'uso da parte della community, quindi viene prima illustrato il metodo attuale e la procedura guidata segue a titolo di riferimento.
Metodo attuale: installare Apache Cassandra Installa il pacchetto o il file tarball binario su ogni nodo in modo identico, quindi verifica che ognuno si avvii autonomamente prima di tentare di unirli.
tar -xzf apache-cassandra-x.y.z-bin.tar.gz -C /opt/
export CASSANDRA_HOME=/opt/apache-cassandra-x.y.z
$CASSANDRA_HOME/bin/cassandra -f
Una volta che un singolo nodo si è avviato correttamente, arrestarlo, svuotare la sua directory dati e passare alla sezione di configurazione del cluster riportata di seguito.
Passo 1) Corri il Cassandra Installazione dell'edizione enterprise. Su Linux Nel terminale, esegui il programma di installazione. Verrà visualizzata la pagina seguente.

Questa pagina non fornisce alcuna informazione necessaria. Fornisce solo informazioni su Cassandra versione. Quindi passa questa pagina e premi il pulsante successivo.
Passo 2) Accetta il contratto di licenza. Dopo aver premuto il pulsante Avanti, verrà visualizzata la pagina successiva.

Questa pagina fornisce informazioni sui pacchetti e sui sottopacchetti nel file Cassandra che verrà installato. Di seguito verrà chiesto di accettare la licenza. Seleziona la casella "Accetto il contratto" e premi il pulsante Avanti.
Passo 3) Installa Builder e fai clic su Avanti. Dopo aver premuto il pulsante Avanti, visualizzerai la pagina seguente.

Questa pagina ti chiede informazioni sulle opzioni di installazione.
- Prima di tutto, ti verrà richiesta la directory di installazione. Per impostazione predefinita, è installato nella directory home.
- Successivamente, viene chiesto il tipo di installazione, selezionare Installazione semplice.
- Successivamente, viene chiesto informazioni sul sistema di aggiornamento, seleziona "no".
- Successivamente, viene richiesto di specificare l'interfaccia predefinita. Sono disponibili due opzioni: installare il programma in locale (localhost) oppure selezionare un indirizzo IP. Selezionare l'indirizzo IP per l'installazione.
- Premi il pulsante successivo.
Passo 4) Configura il nodo e fai clic su Avanti. Dopo aver premuto il pulsante Avanti, verrà visualizzata la pagina seguente.

Questa pagina chiede informazioni sulla configurazione del nodo.
- Innanzitutto, seleziona il tipo di nodo 'Cassandra Nodo'.
- Successivamente, in Nome anello, inserisci il nome del tuo cluster. Cluster il nome dovrebbe essere lo stesso per tutti i nodi nello stesso cluster.
- Successivamente, seleziona il seed. Il seed è il nodo con cui gli altri nodi non seed si connettono all'avvio.
- Dopo aver fornito queste informazioni, premere il pulsante successivo.
Passo 5) Installa l'agente di monitoraggio. Dopo aver premuto il pulsante Avanti, verrà visualizzata la pagina seguente. In questa pagina viene richiesto l'indirizzo IP su cui installare l'agente.
- L'agente è necessario per la console di monitoraggio, dove tutti i nodi possono essere osservati in un unico luogo.
- Dopo aver fornito queste informazioni, premere il pulsante successivo.

Passo 6) Premere Avanti per l'installazione. Dopo aver premuto il pulsante Avanti, verrà visualizzata la pagina seguente.

Ora il setup è pronto per l'installazione. Premere il pulsante successivo.
Passo 7) Attendi il completamento del processo di installazione. Dopo aver premuto il pulsante Avanti, verrà visualizzata la pagina seguente.
L'installazione del programma avrà inizio.
Passo 8) Fai clic sul pulsante Fine. Dopo l'installazione, verrà visualizzata la pagina seguente. Nella stessa pagina, vedrai il segno di spunta per l'opzione che appare per impostazione predefinita.

Configurazione di cassandra.yaml per l'unione dei nodi
La sola installazione non crea un cluster. I nodi si trovano a vicenda solo quando quattro impostazioni nel file cassandra.yaml coincidono, ed è proprio in questo file che si verificano la maggior parte degli errori durante la configurazione di un cluster.
cluster_name: 'Guru99 Cluster'
seed_provider:
  - class_name: org.apache.cassandra.locator.SimpleSeedProvider
    parameters:
      - seeds: "192.168.1.10,192.168.1.11"
listen_address: 192.168.1.10
rpc_address: 0.0.0.0
broadcast_rpc_address: 192.168.1.10
endpoint_snitch: GossipingPropertyFileSnitch
- nome_cluster I dati devono corrispondere su ogni nodo. Una mancata corrispondenza è la causa più comune del rifiuto di un nodo di aderire.
- semi elenca i punti di contatto con cui un nodo iniziale comunica. Due o tre seed per data center sono sufficienti; rendere ogni nodo un seed impedisce l'avvio automaticoping.
- indirizzo_di_ascolto è l'indirizzo che gli altri nodi utilizzano per raggiungere questo nodo. Deve essere un indirizzo instradabile valido, mai localhost.
- endpoint_snitch dice Cassandra la disposizione dei rack e del data center. GossipingPropertyFileSnitch è la scelta più comune, con i valori impostati nel file cassandra-rackdc.properties.
Modificare il nome del dispositivo di segnalazione o del cluster dopo che i dati sono già stati raccolti richiede passaggi aggiuntivi, quindi entrambe le decisioni devono essere prese prima dell'avvio del primo nodo.
Partenza Cassandra Nodo
Dopo l'installazione Cassandra Su ciascun nodo, avviare i server e seguire i passaggi seguenti. L'ordine è importante: avviare prima i nodi seed, uno alla volta, attendendo che ciascuno segnali di essere attivo prima di avviare il successivo. L'avvio simultaneo di più nodi può generare conflitti di intervallo dei token.
Passo 1) Vai Cassandra directory di installazione e avviare il server.
bin/cassandra -f

Eseguendo questo comando, il Cassandra Il server verrà avviato. Ecco lo screenshot in cui Cassandra Il server si sta avviando.
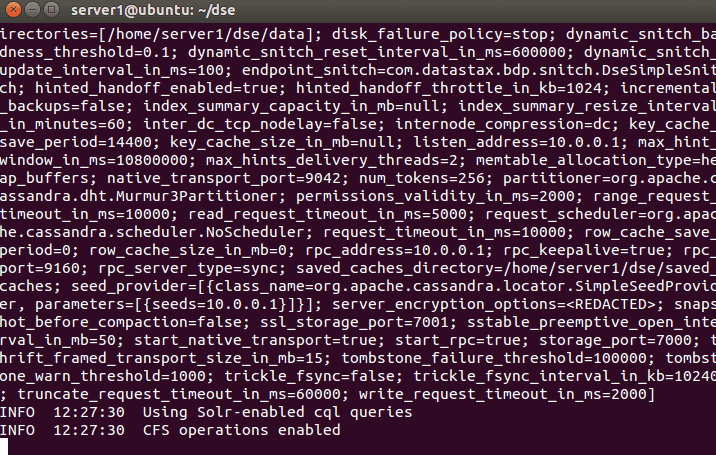
Dopo circa un minuto il server sarà attivo. Avvia ciascun server nodo uno alla volta. Dopo aver avviato tutti i server nodo, il tuo Cassandra il cluster è pronto per l'uso.
Passo 2) Verifica che ogni nodo si sia unito controllando l'anello da uno qualsiasi di essi.
nodetool status
nodetool describecluster
Ogni nodo dovrebbe apparire con lo stato UN, ovvero Up e Normal, e la colonna Owns dovrebbe mostrare percentuali approssimativamente uguali. Una singola versione dello schema nell'output di describecluster conferma che tutti i nodi concordano sullo schema.
Tre sintomi coprono la maggior parte dei guasti. Un nodo che non appare mai di solito ha un cluster_name non corrispondente o una porta 7000 bloccata. Un nodo bloccato a UJ, l'adesione, sta ancora trasmettendo dati e ha semplicemente bisogno di tempo su un cluster di grandi dimensioni. La proprietà estremamente disomogenea indica un errore di configurazione di Snitch, dove i nodi sono stati posizionati nel rack o nel data center sbagliato.
Con l'anello integro, le impostazioni di replica per ogni keyspace decidono come i dati si diffondono al suo interno, come descritto nel Cassandra spazio chiave tutorial e il Cassandra architettura abbattersi.
