
उदाहरण के साथ इन्फॉर्मेटिका में नॉर्मलाइज़र रूपांतरण
 डेविड कार्टर
⚡ स्मार्ट सारांश
इनफॉर्मेटिका में नॉर्मलाइज़र ट्रांसफॉर्मेशन एक सक्रिय ट्रांसफॉर्मेशन है जो दोहराए जाने वाले कॉलम वाली एक पंक्ति को कई पंक्तियों में परिवर्तित करता है, और यह उन कुंजी कॉलम को भी उत्पन्न करता है जो इसके द्वारा उत्पन्न प्रत्येक घटना की पहचान करते हैं।
नॉर्मलाइज़र ट्रांसफ़ॉर्मेशन क्या है?
नॉर्मलाइज़र एक सक्रिय रूपांतरण है, जिसका उपयोग एक पंक्ति को कई पंक्तियों में और इसके विपरीत परिवर्तित करने के लिए किया जाता है। यह आपके डेटा को अधिक व्यवस्थित तरीके से प्रस्तुत करने का एक स्मार्ट तरीका है।
यदि किसी एक पंक्ति में कई स्तंभों में दोहराया गया डेटा हो, तो उसे कई पंक्तियों में विभाजित किया जा सकता है। कभी-कभी हमारे पास कई स्तंभों में दोहराया गया डेटा होता है। उदाहरण के लिए:
| छात्र का नाम | कक्षा 9 का स्कोर | कक्षा 10 का स्कोर | कक्षा 11 का स्कोर | कक्षा 12 का स्कोर |
| छात्र 1 | 50 | 60 | 65 | 80 |
| छात्र 2 | 70 | 64 | 83 | 77 |
इस मामले में, कक्षा स्कोर कॉलम चार कॉलम में दोहराया गया है। नॉर्मलाइज़र का उपयोग करके, हम इन्हें निम्नलिखित डेटा सेट में विभाजित कर सकते हैं।
| छात्र का नाम | वर्ग | स्कोर |
| छात्र 1 | 9 | 50 |
| छात्र 1 | 10 | 60 |
| छात्र 1 | 11 | 65 |
| छात्र 1 | 12 | 80 |
| छात्र 2 | 9 | 70 |
| छात्र 2 | 10 | 64 |
| छात्र 2 | 11 | 83 |
| छात्र 2 | 12 | 77 |
पांच स्तंभों की दो पंक्तियाँ तीन स्तंभों की आठ पंक्तियों में बदल गई हैं। चूंकि रूपांतरण से बाहर निकलने वाली पंक्तियों की संख्या, इसमें प्रवेश करने वाली पंक्तियों की संख्या से भिन्न है, इसलिए नॉर्मलाइज़र एक सक्रिय रूपांतरण है, और यही नियम अगले भाग में निर्मित बिक्री उदाहरण पर भी लागू होता है।
इनफॉर्मेटिका में नॉर्मलाइज़र ट्रांसफॉर्मेशन का उपयोग कैसे करें
मानचित्र बनाने के लिए निम्नलिखित छह चरण आवश्यक हैं।ping जो तिमाही स्टोर बिक्री की एक फ्लैट फाइल को पढ़ता है और प्रति तिमाही एक लक्ष्य पंक्ति लिखता है।
चरण 1) स्क्रिप्ट का उपयोग करके स्रोत तालिका “sales_source” और लक्ष्य तालिका “sales_target” बनाएं और उन्हें आयात करें सूचना विज्ञान.
उपरोक्त Sales_Source.txt फ़ाइल डाउनलोड करें
चरण 2) मानचित्र बनाएँping स्रोत तालिका “sales_source” और लक्ष्य तालिका “sales_target” है। मैपping डिजाइनर कैनवास में स्रोत परिभाषा होती है, और उसके स्रोत क्वालीफायर और लक्ष्य की परिभाषा।

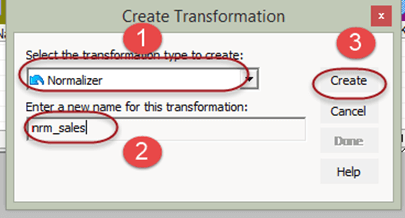
चरण 3) ट्रांसफॉर्मेशन मेनू से एक नया ट्रांसफॉर्मेशन बनाएं। क्रिएट ट्रांसफॉर्मेशन विंडो में:
- ट्रांसफॉर्मेशन के रूप में नॉर्मलाइज़र का चयन करें
- नाम दर्ज करें, “nrm_sales”
- बनाएँ विकल्प चुनें
विंडो नीचे दिए गए स्क्रीनशॉट की तरह दिखती है, जिसमें बाईं ओर रूपांतरण प्रकारों की सूची और उसके नीचे नाम बॉक्स होता है।
चरण 4) ट्रांसफॉर्मेशन बन जाएगा, 'हो गया' विकल्प चुनें। खाली nrm_sales ट्रांसफॉर्मेशन अब कैनवास पर सोर्स क्वालिफायर और टारगेट के बीच मौजूद है।

चरण 5) Double नॉर्मलाइज़र ट्रांसफ़ॉर्मेशन पर क्लिक करें, फिर:
- नॉर्मलाइज़र टैब चुनें
- दो कॉलम बनाने के लिए आइकन पर क्लिक करें
- स्तंभ नाम दर्ज करें
- बिक्री के लिए घटना की संख्या 4 और स्टोर नाम के लिए 0 पर सेट करें
- ओके बटन चुनें
इस टैब में सबसे महत्वपूर्ण प्रविष्टि 'Occurs' मान है: यह डिज़ाइनर को बताता है कि एक स्रोत पंक्ति में कॉलम कितनी बार दोहराया जाता है। स्टोर का नाम प्रति पंक्ति एक बार आता है, इसलिए इसका 'Occurs' मान 0 रहता है।

रूपांतरण में कॉलम उत्पन्न होंगे। आपको बिक्री कॉलम की संख्या 4 दिखाई देगी क्योंकि हमने घटनाओं की संख्या 4 निर्धारित की है। इनके साथ ही डिज़ाइनर जनरेटेड कुंजी और जनरेटेड कॉलम आईडी पोर्ट जोड़ता है, जिनका वर्णन अगले अनुभाग में किया गया है।

चरण 6) तब में नक्शाping:
- चार तिमाही के स्रोत क्वालीफायर के चार कॉलम को क्रमशः नॉर्मलाइज़र कॉलम से लिंक करें।
- स्टोर नाम कॉलम को नॉर्मलाइज़र कॉलम से लिंक करें
- स्टोर_नाम और बिक्री कॉलम को नॉर्मलाइज़र से लक्ष्य तालिका से लिंक करें
- GK_sales कॉलम को नॉर्मलाइज़र से लक्ष्य तालिका से लिंक करें
सभी लिंक बन जाने के बाद, पूरा नक्शा तैयार हो जाएगा।ping ऐसा दिखता है.

मानचित्र सहेजेंping और इसे बनाने के बाद निष्पादित करें सत्र और वर्कफ़्लोकिसी स्टोर की प्रत्येक तिमाही की बिक्री के लिए, नॉर्मलाइज़र परिवर्तन द्वारा एक अलग पंक्ति बनाई जाएगी।
हमारे मानचित्र का आउटपुटping ऐसा होगा –
| स्टोर नाम | तिमाही | बिक्री |
| दिल्ली | 1 | 150 |
| दिल्ली | 2 | 240 |
| दिल्ली | 3 | 455 |
| दिल्ली | 4 | 100 |
| मुंबई | 1 | 100 |
| मुंबई | 2 | 500 |
| मुंबई | 3 | 350 |
| मुंबई | 4 | 340 |
मूल डेटा में QUARTER1, QUARTER2, QUARTER3 और QUARTER4 नाम के कॉलम बार-बार आ रहे थे। नॉर्मलाइज़र की मदद से हमने डेटा को QUARTER नाम के एक ही कॉलम में व्यवस्थित कर दिया है, जिससे मूल डेटा के एक रिकॉर्ड के लिए लक्ष्य डेटा में चार रिकॉर्ड बन गए हैं।
इस तरह, आप डेटा को सामान्यीकृत कर सकते हैं और डेटा के एकल स्रोत के लिए एकाधिक रिकॉर्ड बना सकते हैं।
नॉर्मलाइज़र ट्रांसफॉर्मेशन पोर्ट्स और प्रॉपर्टीज़
पोर्ट्स टैब पर कॉलम कभी टाइप नहीं किए जाते। इन्हें नॉर्मलाइज़र टैब पर परिभाषित किया जाता है, और फिर डिज़ाइनर स्वचालित रूप से मिलान करने वाले पोर्ट बनाता है। नीचे दी गई तालिका बताती है कि प्रत्येक प्रविष्टि और प्रत्येक जनरेट किया गया पोर्ट क्या कार्य करता है।
| पोर्ट या विशेषता | यह क्या करता है |
| तब होता है | एक स्रोत पंक्ति में कॉलम की उपस्थिति की संख्या। 0 का मान एक बार आने वाले कॉलम को दर्शाता है, जैसे कि स्टोर का नाम। |
| स्तर | यह कॉलमों को रिकॉर्ड पदानुक्रम में समूहित करता है। इसका उपयोग COBOL सोर्स कोड के लिए किया जाता है और एक सपाट संरचना के लिए इसका मान 0 रहता है। |
| इनपुट पोर्ट | एक पाइपलाइन नॉर्मलाइज़र प्रत्येक घटना के लिए एक इनपुट पोर्ट बनाता है, इसलिए 4 का ऑकर्स मान चार इनपुट पोर्ट उत्पन्न करता है। |
| आउटपुट बंदरगाह | एक से अधिक बार आने वाले कॉलम में एक ही आउटपुट पोर्ट होता है जो प्रत्येक बार आने पर एक पंक्ति लौटाता है। |
| जीके_ | जनरेट की गई कुंजी। इंटीग्रेशन सर्विस हर बार सोर्स रो को प्रोसेस करते समय इस अनुक्रम संख्या को बढ़ाती है। |
| जीसीआईडी_ | जनरेट किया गया कॉलम आईडी। यह उस कॉलम के आने का इंडेक्स है, इसलिए जो कॉलम चार बार आता है, वह 1, 2, 3 या 4 लौटाता है। |
दोनों जनरेट किए गए पोर्ट्स के बीच का अंतर याद रखने योग्य है, क्योंकि दोनों काउंटर की तरह दिखते हैं। GCID प्रत्येक स्रोत पंक्ति के लिए 1 से पुनः आरंभ होता है, जबकि GK पूरे सत्र में बढ़ता रहता है। बिक्री मानचित्र मेंpingGK_sales लक्ष्य से जुड़ा पोर्ट है, इसलिए आउटपुट की प्रत्येक आठ पंक्तियों में एक अलग कुंजी होती है।
प्रॉपर्टीज़ टैब पर मौजूद दो सेटिंग्स यह नियंत्रित करती हैं कि रन के बीच वह कुंजी कैसे व्यवहार करती है। रीसेट यह सत्र के अंत में उत्पन्न कुंजी मान को सत्र शुरू होने से पहले के मान पर वापस लौटा देता है। पुनः प्रारंभ सेशन चलने पर जनरेट की गई कुंजी अनुक्रम प्रत्येक बार 1 से शुरू होता है, जिससे पोर्ट्स टैब पर प्रदर्शित अनुक्रम मान ओवरराइड हो जाता है। पूर्ण विशेषता परिभाषाएँ प्रकाशित की जाती हैं। पॉवरसेंटर ट्रांसफॉर्मेशन गाइड.
VSAM नॉर्मलाइज़र बनाम पाइपलाइन नॉर्मलाइज़र
PowerCenter एक ही ट्रांसफॉर्मेशन के दो संस्करण प्रदान करता है, और ऊपर दिए गए उदाहरण में दूसरे संस्करण का उपयोग किया गया है। इन दोनों में से किसी एक को चुनना पूरी तरह से स्रोत पर निर्भर करता है।
| पहलू | वीएसएएम नॉर्मलाइज़र | पाइपलाइन नॉर्मलाइज़र |
| मानचित्र में भूमिकाping | COBOL स्रोत परिभाषा के लिए स्रोत क्वालिफायर के रूप में कार्य करता है | यह पाइपलाइन में कहीं भी, सामान्य स्रोत योग्यताकर्ता के बाद स्थित हो सकता है। |
| यह कैसे बनता है | COBOL स्रोत को मानचित्र में खींचने पर यह स्वचालित रूप से बन जाता है।ping | इसे ट्रांसफॉर्मेशन मेनू से बनाया गया है, जैसा कि ऊपर चरण 3 में बताया गया है। |
| एक दोहराव वाले कॉलम के लिए इनपुट पोर्ट | एक से अधिक बार आने वाले पूरे कॉलम के लिए एक ही इनपुट पोर्ट। | कॉलम के प्रत्येक स्थान के लिए एक इनपुट पोर्ट |
| कॉलमों का संपादन | COBOL स्रोत कोड बदलें और रूपांतरण को पुनः बनाएं। | नॉर्मलाइज़र टैब पर कॉलम को कभी भी संपादित करें |
| विशिष्ट डेटा | OCCURS और REDEFINES क्लॉज़ का उपयोग करके मेनफ्रेम फ़ाइलें | रिलेशनल टेबल और फ्लैट फाइलों में कॉलम दोहराए जाते हैं |
एक COBOL फ़ाइल में एक ही भौतिक फ़ाइल में कई रिकॉर्ड प्रकार भी हो सकते हैं, यही कारण है कि VSAM संस्करण कॉलम सूची के बजाय कॉपीबुक पढ़ता है। ईटीएल डेटाबेस और सीमांकित फ़ाइलों के साथ काम करने के लिए, पाइपलाइन नॉर्मलाइज़र सबसे उपयुक्त टूल है।
नॉर्मलाइज़र ट्रांसफॉर्मेशन में होने वाली सामान्य त्रुटियाँ और उन्हें ठीक करने के तरीके
अधिकांश नॉर्मलाइज़र समस्याएं tracदो या तीन सेटिंग्स पर वापस आ जाएं। नीचे दी गई सूची में वे सेटिंग्स शामिल हैं जो विकास के दौरान सबसे अधिक बार सामने आती हैं।
- पोर्ट सूची स्रोत से मेल नहीं खाती। इनपुट पोर्ट की संख्या बहुत कम या बहुत अधिक होने का मतलब लगभग हमेशा यह होता है कि 'Occurs' का मान गलत है। नॉर्मलाइज़र टैब को दोबारा खोलें और 'Occurs' को दोहराए जाने वाले कॉलम की सटीक संख्या पर सेट करें, फिर मैप को दोबारा लिंक करें।pingक्योंकि परिवर्तन होने पर पोर्ट्स का पुनर्निर्माण होता है।
- यह एक बार आने वाले कॉलम पर सेट होता है। स्टोर के नाम को 0 से अधिक 'Occurs' मान देने पर वे पंक्तियाँ भी कई बार दोहराई जाती हैं जिन्हें दोहराया नहीं जाना चाहिए था। केवल एक बार आने वाले कॉलम का मान 0 ही रहता है।
- दिनांक कॉलम परिभाषित नहीं किए जा सकते। नॉर्मलाइज़र टैब केवल स्ट्रिंग, एनस्ट्रिंग और नंबर कॉलम स्वीकार करता है, इसलिए किसी तिथि को स्ट्रिंग के रूप में ले जाना होगा और लक्ष्य तक पहुंचने से पहले उसे एक एक्सप्रेशन ट्रांसफॉर्मेशन में परिवर्तित करना होगा।
- सेशन लॉग में पंक्तियों की संख्या गलत दिख रही है। दो स्रोत पंक्तियों को पढ़ना और आठ लक्ष्य पंक्तियों को लिखना, 4 के 'घटना मान' के लिए सही व्यवहार है, कोई दोष नहीं। नॉर्मलाइज़र सक्रिय है क्योंकि ये संख्याएँ भिन्न हैं।
- उत्पन्न की गई कुंजियाँ रन के बीच दोहराई जाती हैं या जंप करती हैं। यह प्रॉपर्टीज़ टैब पर रीसेट और रीस्टार्ट का जोड़ा है। रीस्टार्ट हर सेशन के लिए क्रम को वापस 1 पर सेट कर देता है, जिसकी ज़रूरत तब कम ही पड़ती है जब कुंजी किसी वेयरहाउस टेबल में पहुँच जाती है।
- पोर्ट्स टैब पर किए गए बदलाव स्थायी नहीं होंगे। पोर्ट जनरेट किए जाते हैं, बनाए नहीं जाते। हर कॉलम में बदलाव नॉर्मलाइज़र टैब पर होना चाहिए, और VSAM नॉर्मलाइज़र के लिए बदलाव COBOL सोर्स में ही होना चाहिए।
जब कई दोहराए जाने वाले समूहों को एक साथ विभाजित करना होता है, तो आमतौर पर प्रत्येक समूह के लिए एक नॉर्मलाइज़र का उपयोग करना और परिणामों को बाद में संयोजित करना एक ही रूपांतरण को ओवरलोड करने की तुलना में अधिक स्वच्छ होता है। जहाँ आवश्यकता इसके विपरीत होती है, यानी कई पंक्तियों को एक में संयोजित करना, वहाँ एक एग्रीगेटर रूपांतरण इसके बजाय सही उपकरण है।
