
Hadoop MapReduce -esimerkki: Ensimmäinen Java Ohjelma kanssa Code
 Prafulla Ranadive
⚡ Älykäs yhteenveto
Hadoop MapReduce -ohjelmat kirjoitetaan kolmena Java luokat, mapper, reduktori ja driver, jotka käännetään, pakataan purkkiin ja lähetetään klusterille myynnin laskemiseksi maittain.
Tässä opetusohjelmassa opit käyttämään Hadoopia MapReduce-esimerkkien kanssa. Käytetty syöttötieto on MyyntiJan2009.csvSe sisältää myyntiin liittyviä tietoja, kuten tuotteen nimen, hinnan, maksutavan, asiakkaan kaupungin ja maan. Tavoitteena on selvittää kussakin maassa myytyjen tuotteiden määrä.
Ensimmäinen Hadoop MapReduce -ohjelma
Nyt tässä MapReduce opetusohjelma, luomme ensimmäisen Java MapReduce-ohjelma:
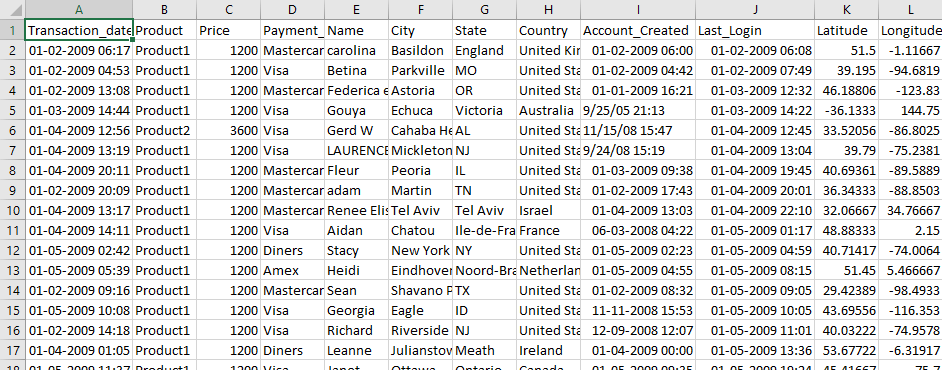
Alla olevassa kuvakaappauksessa näkyvät raakat SalesJan2009-tiedot, joissa jokainen rivi on yksi tapahtuma ja maa sijaitsee kahdeksannessa pilkulla erotetussa sarakkeessa.
Varmista, että sinulla on Hadoop asennettuna. Ennen kuin aloitat varsinaisen prosessin, vaihda käyttäjätunnukseksi 'hduser' (tunnus, jota käytettiin Hadoopin määrittämisessä – voit vaihtaa käyttäjätunnukseen, jota käytettiin omassa Hadoop-määrityksessäsi).
su - hduser_
Kehotteessa näkyy hduser-tili, kuten alla on esitetty.

Vaihe 1) Luo projektihakemisto ja lähdekooditiedostot
Luo uusi hakemisto nimeltä MapReduceTutorial, kuten alla olevassa MapReduce-esimerkissä on esitetty.
sudo mkdir MapReduceTutorial

Anna käyttöoikeudet
sudo chmod -R 777 MapReduceTutorial

Luo kolme Java lähdekooditiedostot alla MapReduceTutorialin sisällä. Huomaa, että kaikki kolme käyttävät vanhempaa versiota. org.apache.hadoop.mapred API, joka toimitetaan edelleen Hadoop 3.x:n mukana.
SalesMapper.java
package SalesCountry;

import java.io.IOException;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesMapper extends MapReduceBase implements Mapper <LongWritable, Text, Text, IntWritable> {
	private final static IntWritable one = new IntWritable(1);

	public void map(LongWritable key, Text value, OutputCollector <Text, IntWritable> output, Reporter reporter) throws IOException {

		String valueString = value.toString();
		String[] SingleCountryData = valueString.split(",");
		output.collect(new Text(SingleCountryData[7]), one);
	}
}
SalesCountryReducer.java
package SalesCountry;

import java.io.IOException;
import java.util.*;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {

	public void reduce(Text t_key, Iterator<IntWritable> values, OutputCollector<Text,IntWritable> output, Reporter reporter) throws IOException {
		Text key = t_key;
		int frequencyForCountry = 0;
		while (values.hasNext()) {
			// replace type of value with the actual type of our value
			IntWritable value = (IntWritable) values.next();
			frequencyForCountry += value.get();

		}
		output.collect(key, new IntWritable(frequencyForCountry));
	}
}
SalesCountryDriver.java
package SalesCountry;

import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.*;
import org.apache.hadoop.mapred.*;

public class SalesCountryDriver {
    public static void main(String[] args) {
        JobClient my_client = new JobClient();
        // Create a configuration object for the job
        JobConf job_conf = new JobConf(SalesCountryDriver.class);

        // Set a name of the Job
        job_conf.setJobName("SalePerCountry");

        // Specify data type of output key and value
        job_conf.setOutputKeyClass(Text.class);
        job_conf.setOutputValueClass(IntWritable.class);

        // Specify names of Mapper and Reducer Class
        job_conf.setMapperClass(SalesCountry.SalesMapper.class);
        job_conf.setReducerClass(SalesCountry.SalesCountryReducer.class);

        // Specify formats of the data type of Input and output
        job_conf.setInputFormat(TextInputFormat.class);
        job_conf.setOutputFormat(TextOutputFormat.class);

        // Set input and output directories using command line arguments,
        //arg[0] = name of input directory on HDFS, and arg[1] =  name of output directory to be created to store the output file.

        FileInputFormat.setInputPaths(job_conf, new Path(args[0]));
        FileOutputFormat.setOutputPath(job_conf, new Path(args[1]));

        my_client.setConf(job_conf);
        try {
            // Run the job
            JobClient.runJob(job_conf);
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
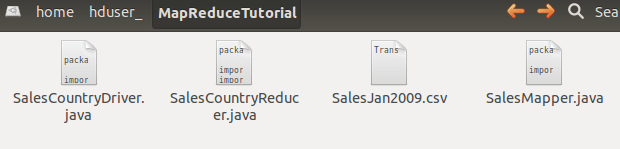
Arkisto laajenee samoihin kolmeen lähdetiedostoon, kuten tässä näkyy.
Tarkista kaikkien näiden tiedostojen tiedostooikeudet

Jos lukuoikeudet puuttuvat, myönnä ne:

Vaihe 2) Vie Hadoop-luokkapolku
Vie luokkapolku alla olevan Hadoop-esimerkin mukaisesti.
export CLASSPATH="$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-core-2.2.0.jar:$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-common-2.2.0.jar:$HADOOP_HOME/share/hadoop/common/hadoop-common-2.2.0.jar:~/MapReduceTutorial/SalesCountry/*:$HADOOP_HOME/lib/*"
Viety luokkapolku toistetaan takaisin kehotteessa.

Vaihe 3) Käännä Java Tiedostojen
Käännä Java tiedostot (nämä tiedostot sijaitsevat hakemistossa Final-MapReduceHandsOn). Niiden luokkatiedostot sijoitetaan pakettihakemistoon.
javac -d . SalesMapper.java SalesCountryReducer.java SalesCountryDriver.java
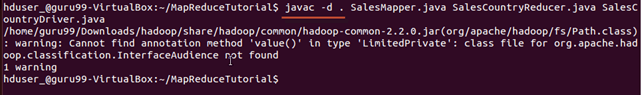
Tämä varoitus voidaan turvallisesti jättää huomiotta — se vain ilmoittaa, että mapped API on vanhentunut.
Tämä käännös luo nykyiseen hakemistoon hakemiston, jonka nimi on määritetty kohdassa Java lähdetiedosto (eli meidän tapauksessamme SalesCountry) ja laita kaikki käännetyt luokkatiedostot siihen.

Vaihe 4) Luo manifestitiedosto
Luo uusi Manifest.txt-tiedosto
sudo gedit Manifest.txt
Lisää siihen seuraava rivi:
Main-Class: SalesCountry.SalesCountryDriver

SalesCountry.SalesCountryDriver on pääluokan nimi. Huomaa, että sinun on painettava Enter-näppäintä tämän rivin lopussa.
Vaihe 5) Pakkaa luokat purkkiin
Luo Jar-tiedosto
jar cfm ProductSalePerCountry.jar Manifest.txt SalesCountry/*.class

Tarkista, että jar-tiedosto on luotu

Vaihe 6) Käynnistä Hadoop
Käynnistä Hadoop
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Vaihe 7) Kopioi syötetiedosto HDFS:ään
Kopioi tiedosto SalesJan2009.csv kansioon ~/inputMapReduce
Kopioi nyt ~/inputMapReduce HDFS:ään alla olevalla komennolla.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/inputMapReduce /
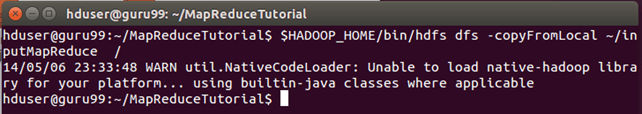
Voimme jättää tämän varoituksen huomiotta.
Tarkista, onko tiedosto todella kopioitu vai ei.
$HADOOP_HOME/bin/hdfs dfs -ls /inputMapReduce

Vaihe 8) Suorita MapReduce-työ
Suorita MapReduce-työ
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales

Tämä luo tuloshakemiston nimeltä mapreduce_output_sales on HDFS. Tämän hakemiston sisältö on tiedosto, joka sisältää tuotteiden myynnin maittain.
Vaihe 9) Lue tulokset
Tulos näkyy komentoliittymän kautta seuraavasti:
$HADOOP_HOME/bin/hdfs dfs -cat /mapreduce_output_sales/part-00000
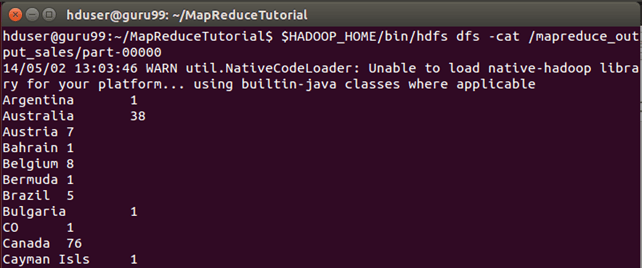
Tulokset ovat nähtävissä myös verkkokäyttöliittymän kautta mm.
avoin http://localhost:50070/ verkkoselaimessa. Hadoop 3.x:ssä NameNode-verkkokäyttöliittymä siirrettiin porttiin 9870, joten käytä http://localhost:9870/ sen sijaan.

Valitse nyt 'Selaa tiedostojärjestelmää' ja siirry kansioon /mapreduce_output_sales

Avaa osa-r-00000

SalesMapper-luokan selitys
Työn edetessä alusta loppuun seuraavissa kolmessa osiossa käydään läpi, mitä kukin luokka todellisuudessa tekee.
Tässä osiossa ymmärrämme SalesMapper-luokan toteutuksen.
1. Aloitamme määrittämällä luokallemme paketin nimen. SalesCountry on pakettimme nimi. Huomaa, että käännöksen tuloste, SalesMapper.class, menee hakemistoon, jonka nimi on tämä paketin nimi: SalesCountry.
Tämän jälkeen tuomme kirjastopaketteja.
Alla oleva tilannekuva näyttää SalesMapper-luokan toteutuksen -

Näyte Code Selitys:
1. SalesMapper-luokan määritelmä-
public class SalesMapper extends MapReduceBase implements Mapper<LongWritable, Text, Text, IntWritable> {
Jokainen mapper-luokka on laajennettava MapReduceBase-luokasta ja sen on toteutettava Mapper-rajapinta.
2. Karttafunktion määrittäminen-
public void map(LongWritable key,
         Text value,
OutputCollector<Text, IntWritable> output,
Reporter reporter) throws IOException
Mapper-luokan pääosa on 'map()'-metodi, joka hyväksyy neljä argumenttia.
Jokaisella 'map()'-metodin kutsukerralla välitetään avain-arvo-pari (tässä koodissa 'key' ja 'value').
'map()'-metodi aloittaa jakamalla argumenttina vastaanotetun syötetekstin osiin. Se jakaa jokaisen rivin kenttiin.
String valueString = value.toString();
String[] SingleCountryData = valueString.split(",");
Tässä erottimena käytetään pilkkua ','.
Tämän jälkeen muodostetaan pari käyttämällä 'SingleCountryData'-taulukon seitsemännellä indeksillä olevaa tietuetta ja arvoa '1'.
output.collect(new Text(SingleCountryData[7]), one);
Valitsemme tietueen 7. indeksistä, koska tarvitsemme maatietoja ja ne sijaitsevat 7. indeksissä taulukossa 'SingleCountryData'.
Huomaa, että syöttötietomme ovat alla olevassa muodossa (jossa maa on seitsemännellä indeksillä ja 0 on lähtöindeksi):
Transaction_date,Product,Price,Payment_Type,Name,City,State,Country,Account_Created,Last_Login,Latitude,Longitude
Mapper-funktion tuloste on jälleen avain-arvo-pari, joka lähetetään 'OutputCollector'-funktion 'collect()'-metodilla.
SalesCountryReducer-luokan selitys
Tässä osiossa ymmärrämme SalesCountryReducer-luokan toteutuksen.
1. Aloitamme määrittämällä luokallemme paketin nimen. SalesCountry on pakettimme nimi. Huomaa, että käännöksen tuloste, SalesCountryReducer.class, menee hakemistoon, jonka nimi on tämä paketin nimi: SalesCountry.
Tämän jälkeen tuomme kirjastopaketteja.
Alla oleva tilannekuva näyttää SalesCountryReducer-luokan toteutuksen
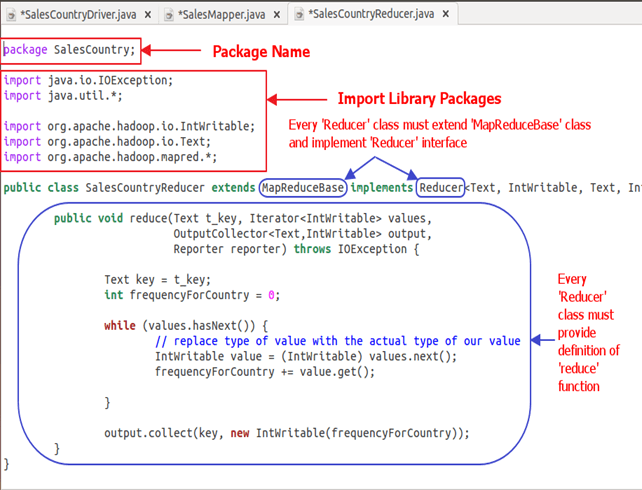
Code Selitys:
1. SalesCountryReducer-luokan määritelmä-
public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {
Tässä kaksi ensimmäistä tietotyyppiä, 'Text' ja 'IntWritable', ovat reduktorin syöteavaimen arvon tietotyypit.
Mapperin tuloste on muodossa , Tämä mapperin tuloste muuttuu reduktorin syötteeksi. Joten sen tietotyypin mukaiseksi käytetään tässä Text- ja IntWritable-tietotyyppejä.
Kaksi viimeistä tietotyyppiä, 'Text' ja 'IntWritable', ovat reduktorin luoman tulosteen tietotyypit avain-arvo-parin muodossa.
Jokainen reducer-luokka on laajennettava MapReduceBase-luokasta ja sen on toteutettava Reducer-rajapinta.
2. Vähennä-funktion määrittäminen
public void reduce( Text t_key,
             Iterator<IntWritable> values,
             OutputCollector<Text,IntWritable> output,
             Reporter reporter) throws IOException {
reduce()-metodin syöte on avain, jossa on useita arvoja sisältävä lista.
Esimerkiksi meidän tapauksessamme se on
, , , , , .
Tämä annetaan reduktorille muodossa
Joten tämän muodon argumenttien hyväksymiseksi käytetään kahta ensimmäistä tietotyyppiä, nimittäin Teksti ja Iteraattori Teksti on avaimen ja iteraattorin tietotyyppi. on tietotyyppi kyseisen avaimen arvojen listalle.
Seuraava argumentti on tyyppiä OutputCollector joka kerää pelkistysvaiheen tuotoksen.
reduce()-metodi aloittaa kopioimalla avaimen arvon ja alustamalla frekvenssimäärän arvoksi 0.
Text key = t_key;int frequencyForCountry = 0;
Sitten käymme while-silmukan avulla läpi avaimeen liittyvien arvojen listan ja laskemme lopullisen taajuuden summaamalla kaikki arvot.
 while (values.hasNext()) {
            // replace type of value with the actual type of our value
            IntWritable value = (IntWritable) values.next();
            frequencyForCountry += value.get();

        }
Nyt työnnämme tuloksen lähtökeräimelle avaimen ja saadun taajuuslaskennan muodossa.
Alla oleva koodi tekee tämän -
output.collect(key, new IntWritable(frequencyForCountry));
SalesCountryDriver-luokan selitys
Tässä osiossa ymmärrämme SalesCountryDriver-luokan toteutuksen.
1. Aloitamme määrittämällä luokallemme paketin nimen. SalesCountry on pakettimme nimi. Huomaa, että käännöksen tuloste, SalesCountryDriver.class, menee hakemistoon, joka on nimetty tämän paketin nimellä: SalesCountry.
Tässä on rivi, joka määrittää paketin nimen ja sen jälkeen koodin kirjastopakettien tuontia varten.

2. Määritä ajuriluokka, joka luo uuden asiakastyön, konfigurointiobjektin ja mainostaa Mapper- ja Reducer-luokkia.
Kuljettajaluokka on vastuussa MapReduce-työmme asettamisesta käynnistymään HadoopTässä luokassa määritetään työn nimi, syötteen/tulosteen tietotyyppi sekä mapper- ja reduktoriluokkien nimet.

3. Alla olevassa koodinpätkässä asetamme syöttö- ja lähtöhakemistot, joita käytetään syötetietojoukon kuluttamiseen ja tulosteen tuottamiseen, vastaavasti.
arg[0] ja arg[1] ovat komentoriviargumentteja, jotka annetaan MapReducen käytännön harjoituksissa annetun komennon yhteydessä, eli
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales
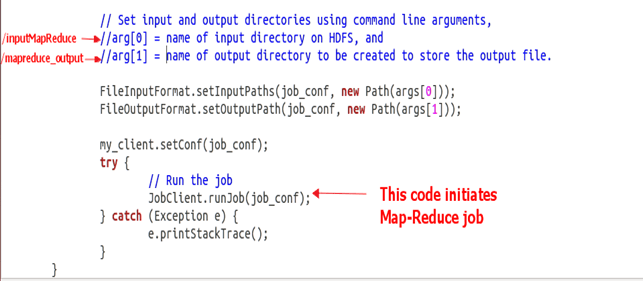
4. Käynnistä työmme
Alla oleva koodi aloittaa MapReduce-työn suorittamisen:
try {
    // Run the job
    JobClient.runJob(job_conf);
} catch (Exception e) {
    e.printStackTrace();
}
