
Приклад Hadoop MapReduce: Перший Java Програма с Code
 Прафулла Ранадіве
⚡ Розумний підсумок
Програми Hadoop MapReduce пишуться як три Java класи, маппер, редуктор та драйвер, які компілюються, упаковуються в JAR-файл та надсилаються до кластера для підрахунку продажів у кожній країні.
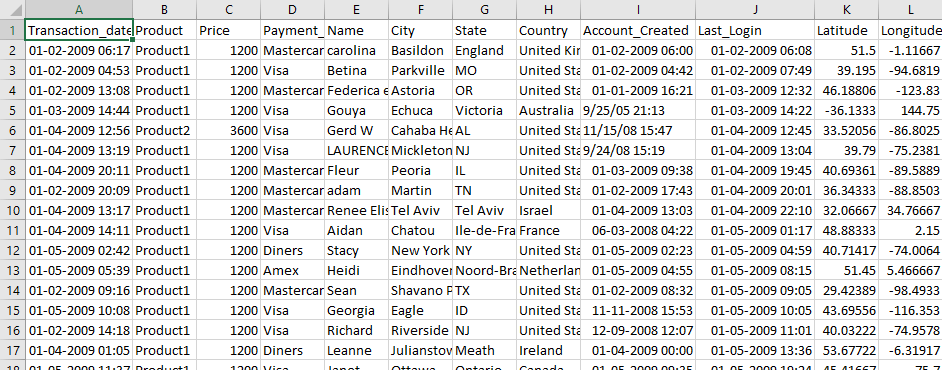
У цьому посібнику ви навчитеся використовувати Hadoop із прикладами MapReduce. Використані вхідні дані SalesJan2009.csvВін містить інформацію, пов’язану з продажами, таку як назва товару, ціна, спосіб оплати, місто та країна клієнта. Мета полягає в тому, щоб з’ясувати кількість товарів, проданих у кожній країні.
Перша програма Hadoop MapReduce
Тепер у цьому Підручник MapReduce, ми створимо свій перший Java Програма MapReduce:
На знімку екрана нижче показано необроблені дані SalesJan2009, де кожен рядок відповідає одній транзакції, а країна знаходиться у восьмому стовпці, розділеному комами.
Переконайтеся, що у вас встановлено Hadoop. Перш ніж розпочати сам процес, змініть ім'я користувача на «hduser» (ідентифікатор, який використовувався під час налаштування Hadoop — ви можете переключитися на ідентифікатор користувача, який використовувався під час власного налаштування Hadoop).
su - hduser_
Запит змінюється на обліковий запис hduser, як показано нижче.

Крок 1) Створення каталогу проекту та вихідних файлів
Створіть новий каталог з назвою MapReduceTutorial, як показано в наведеному нижче прикладі MapReduce.
sudo mkdir MapReduceTutorial

Дайте дозволи
sudo chmod -R 777 MapReduceTutorial

Створіть три Java вихідні файли нижче в MapReduceTutorial. Зверніть увагу, що всі три використовують старішу версію org.apache.hadoop.mapred API, який досі постачається з Hadoop 3.x.
SalesMapper.java
package SalesCountry;

import java.io.IOException;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesMapper extends MapReduceBase implements Mapper <LongWritable, Text, Text, IntWritable> {
	private final static IntWritable one = new IntWritable(1);

	public void map(LongWritable key, Text value, OutputCollector <Text, IntWritable> output, Reporter reporter) throws IOException {

		String valueString = value.toString();
		String[] SingleCountryData = valueString.split(",");
		output.collect(new Text(SingleCountryData[7]), one);
	}
}
SalesCountryReducer.java
package SalesCountry;

import java.io.IOException;
import java.util.*;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {

	public void reduce(Text t_key, Iterator<IntWritable> values, OutputCollector<Text,IntWritable> output, Reporter reporter) throws IOException {
		Text key = t_key;
		int frequencyForCountry = 0;
		while (values.hasNext()) {
			// replace type of value with the actual type of our value
			IntWritable value = (IntWritable) values.next();
			frequencyForCountry += value.get();

		}
		output.collect(key, new IntWritable(frequencyForCountry));
	}
}
SalesCountryDriver.java
package SalesCountry;

import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.*;
import org.apache.hadoop.mapred.*;

public class SalesCountryDriver {
    public static void main(String[] args) {
        JobClient my_client = new JobClient();
        // Create a configuration object for the job
        JobConf job_conf = new JobConf(SalesCountryDriver.class);

        // Set a name of the Job
        job_conf.setJobName("SalePerCountry");

        // Specify data type of output key and value
        job_conf.setOutputKeyClass(Text.class);
        job_conf.setOutputValueClass(IntWritable.class);

        // Specify names of Mapper and Reducer Class
        job_conf.setMapperClass(SalesCountry.SalesMapper.class);
        job_conf.setReducerClass(SalesCountry.SalesCountryReducer.class);

        // Specify formats of the data type of Input and output
        job_conf.setInputFormat(TextInputFormat.class);
        job_conf.setOutputFormat(TextOutputFormat.class);

        // Set input and output directories using command line arguments,
        //arg[0] = name of input directory on HDFS, and arg[1] =  name of output directory to be created to store the output file.

        FileInputFormat.setInputPaths(job_conf, new Path(args[0]));
        FileOutputFormat.setOutputPath(job_conf, new Path(args[1]));

        my_client.setConf(job_conf);
        try {
            // Run the job
            JobClient.runJob(job_conf);
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
Архів розгортається до тих самих трьох вихідних файлів, як показано тут.
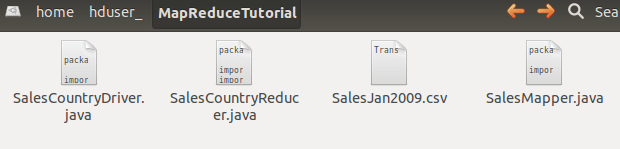
Перевірте права доступу для всіх цих файлів

Якщо дозволи на «читання» відсутні, надайте їх:

Крок 2) Експортуйте шлях до класів Hadoop
Експортуйте шлях до класів, як показано в прикладі Hadoop нижче.
export CLASSPATH="$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-core-2.2.0.jar:$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-common-2.2.0.jar:$HADOOP_HOME/share/hadoop/common/hadoop-common-2.2.0.jar:~/MapReduceTutorial/SalesCountry/*:$HADOOP_HOME/lib/*"
Експортований шлях до класів відображається назад у командному рядку.

Крок 3) Скомпілюйте Java файли
Складіть Java файли (ці файли знаходяться в каталозі Final-MapReduceHandsOn). Їхні файли класів будуть поміщені в каталог пакета.
javac -d . SalesMapper.java SalesCountryReducer.java SalesCountryDriver.java
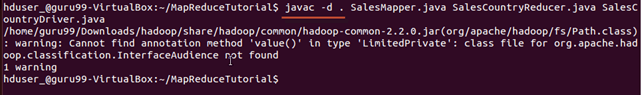
Це попередження можна безпечно ігнорувати — воно лише повідомляє про те, що API mapred застарів.
Ця компіляція створить каталог у поточному каталозі з назвою пакета, вказаною в Java вихідний файл (тобто SalesCountry у нашому випадку) та помістити туди всі скомпільовані файли класів.

Крок 4) Створення файлу маніфесту
Створіть новий файл Manifest.txt
sudo gedit Manifest.txt
Додайте до нього наступний рядок:
Main-Class: SalesCountry.SalesCountryDriver

SalesCountry.SalesCountryDriver – це назва основного класу. Зверніть увагу, що в кінці цього рядка потрібно натиснути клавішу Enter.
Крок 5) Упакуйте класи в банку
Створіть файл Jar
jar cfm ProductSalePerCountry.jar Manifest.txt SalesCountry/*.class

Перевірте, чи створено файл jar

Крок 6) Запустіть Hadoop
Запустіть Hadoop
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Крок 7) Скопіюйте вхідний файл у HDFS
Скопіюйте файл SalesJan2009.csv у ~/inputMapReduce
Тепер скористайтеся командою нижче, щоб скопіювати ~/inputMapReduce до HDFS.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/inputMapReduce /
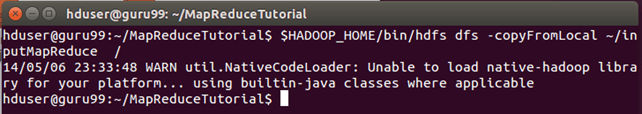
Ми можемо сміливо ігнорувати це попередження.
Перевірте, чи дійсно файл скопійовано чи ні.
$HADOOP_HOME/bin/hdfs dfs -ls /inputMapReduce

Крок 8) Запустіть завдання MapReduce
Запустіть завдання MapReduce
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales

Це створить вихідний каталог під назвою mapreduce_output_sales on HDFS. Вміст цього каталогу буде файлом, що містить дані про продажі продукції по країнах.
Крок 9) Ознайомтеся з результатами
Результат можна побачити через інтерфейс команди так:
$HADOOP_HOME/bin/hdfs dfs -cat /mapreduce_output_sales/part-00000
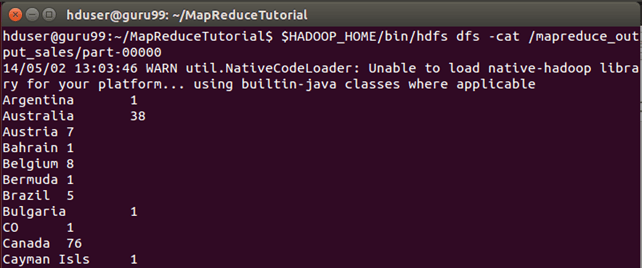
Результати також можна побачити через веб-інтерфейс як-
відкритий http://localhost:50070/ у веббраузері. У Hadoop 3.x веб-інтерфейс NameNode перемістився в порт 9870, тому використовуйте http://localhost:9870/ там натомість.

Тепер виберіть «Переглянути файлову систему» та перейдіть до /mapreduce_output_sales

Відкрита частина-r-00000

Пояснення класу SalesMapper
Оскільки завдання виконується від початку до кінця, у наступних трьох розділах розглядається, що насправді робить кожен клас.
У цьому розділі ми розглянемо реалізацію класу SalesMapper.
1. Почнемо з визначення назви пакета для нашого класу. SalesCountry – це назва нашого пакета. Зверніть увагу, що результат компіляції, SalesMapper.class, буде поміщений у каталог з назвою цього пакета: SalesCountry.
Після цього ми імпортуємо бібліотечні пакети.
На знімку нижче показано реалізацію класу SalesMapper.

Зразок Code Пояснення:
1. Визначення класу SalesMapper-
public class SalesMapper extends MapReduceBase implements Mapper<LongWritable, Text, Text, IntWritable> {
Кожен клас маппера має бути розширеним з класу MapReduceBase та має реалізовувати інтерфейс Mapper.
2. Визначення функції 'map'-
public void map(LongWritable key,
         Text value,
OutputCollector<Text, IntWritable> output,
Reporter reporter) throws IOException
Основною частиною класу Mapper є метод 'map()', який приймає чотири аргументи.
Під час кожного виклику методу 'map()' передається пара ключ-значення ('key' та 'value' у цьому коді).
Метод 'map()' починає з розділення вхідного тексту, отриманого як аргумент. Він розбиває кожен рядок на поля.
String valueString = value.toString();
String[] SingleCountryData = valueString.split(",");
Тут як роздільник використовується ','.
Після цього пара формується з використанням запису на 7-му індексі масиву 'SingleCountryData' та значення '1'.
output.collect(new Text(SingleCountryData[7]), one);
Ми вибираємо запис за 7-м індексом, оскільки нам потрібні дані про країну, і він розташований за 7-м індексом у масиві 'SingleCountryData'.
Зверніть увагу, що наші вхідні дані мають формат, наведений нижче (де країна знаходиться на 7-му місці в індексі, а 0 – як початковий індекс):
Transaction_date,Product,Price,Payment_Type,Name,City,State,Country,Account_Created,Last_Login,Latitude,Longitude
Вихідним результатом mapper знову є пара ключ-значення, яка видається за допомогою методу 'collect()' класу 'OutputCollector'.
Пояснення класу SalesCountryReducer
У цьому розділі ми розглянемо реалізацію класу SalesCountryReducer.
1. Почнемо з визначення назви пакета для нашого класу. SalesCountry – це назва нашого пакета. Зверніть увагу, що результат компіляції, SalesCountryReducer.class, буде поміщений у каталог з назвою цього пакета: SalesCountry.
Після цього ми імпортуємо бібліотечні пакети.
На знімку нижче показано реалізацію класу SalesCountryReducer.
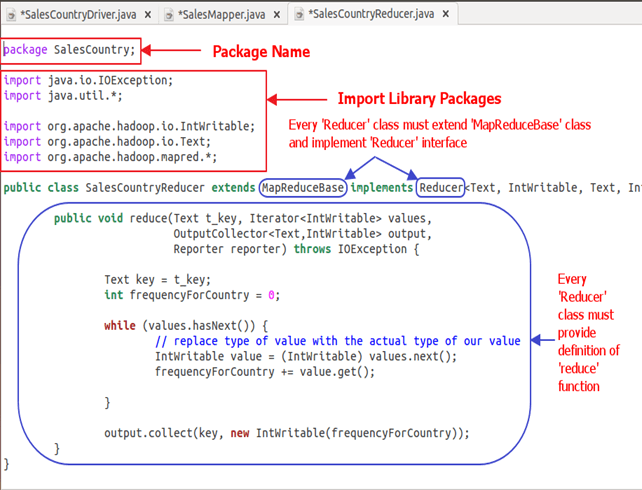
Code Пояснення:
1. Визначення класу SalesCountryReducer-
public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {
Тут перші два типи даних, «Text» та «IntWritable», є типом даних вхідного ключ-значення для редуктора.
Вихідні дані мапера мають вигляд , Цей вивід маппера стає вхідним для редуктора. Отже, для узгодження з його типом даних тут використовуються типи даних Text та IntWritable.
Останні два типи даних, «Text» та «IntWritable», – це типи даних, що генеруються редуктором у вигляді пари ключ-значення.
Кожен клас редуктора має бути розширеним з класу MapReduceBase та має реалізовувати інтерфейс Reducer.
2. Визначення функції «зменшення» -
public void reduce( Text t_key,
             Iterator<IntWritable> values,
             OutputCollector<Text,IntWritable> output,
             Reporter reporter) throws IOException {
Вхідними даними для методу reduce() є ключ зі списком кількох значень.
Наприклад, у нашому випадку це буде-
, , , , , .
Це надається редуктору як
Отже, для прийняття аргументів такої форми використовуються перші два типи даних, а саме: текст та ітератор. Текст – це тип даних ключа та ітератора. – це тип даних для списку значень для цього ключа.
Наступний аргумент має тип OutputCollector який збирає вихідний сигнал фази редуктора.
Метод reduce() починається з копіювання значення ключа та ініціалізації frequency count рівним 0.
Text key = t_key;int frequencyForCountry = 0;
Потім, використовуючи цикл 'while', ми перебираємо список значень, пов'язаних з ключем, і обчислюємо кінцеву частоту шляхом підсумовування всіх значень.
 while (values.hasNext()) {
            // replace type of value with the actual type of our value
            IntWritable value = (IntWritable) values.next();
            frequencyForCountry += value.get();

        }
Тепер ми передаємо результат на вихідний колектор у вигляді ключа та отриманого підрахунку частот.
Код нижче робить це -
output.collect(key, new IntWritable(frequencyForCountry));
Пояснення класу SalesCountryDriver
У цьому розділі ми розглянемо реалізацію класу SalesCountryDriver.
1. Почнемо з визначення назви пакета для нашого класу. SalesCountry – це назва нашого пакета. Зверніть увагу, що результат компіляції, SalesCountryDriver.class, буде поміщений у каталог з назвою цього пакета: SalesCountry.
Ось рядок із назвою пакета, а потім кодом для імпорту пакетів бібліотеки.

2. Визначте клас драйвера, який створить нове завдання клієнта, об’єкт конфігурації та оголосить класи Mapper і Reducer.
Клас драйвера відповідає за налаштування нашого завдання MapReduce для запуску HadoopУ цьому класі ми вказуємо назву завдання, тип даних вводу/виводу та назви класів маппера та редуктора.

3. У наведеному нижче фрагменті коду ми встановлюємо вхідні та вихідні каталоги, які використовуються для використання вхідного набору даних і створення вихідних даних відповідно.
arg[0] та arg[1] – це аргументи командного рядка, що передаються з командою, заданою в практичному вивченні MapReduce, тобто,
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales
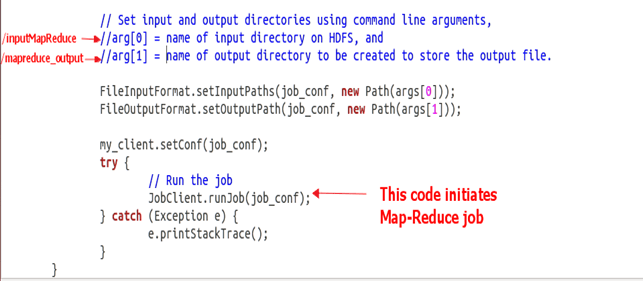
4. Запустіть нашу роботу
Наведений нижче код запускає виконання завдання MapReduce:
try {
    // Run the job
    JobClient.runJob(job_conf);
} catch (Exception e) {
    e.printStackTrace();
}
