
Gaussisk kärna i maskininlärning: Python Kärnmetoder
 Evelyn Clarke
⚡ Smart sammanfattning
Gaussiska kärnmetoder gör icke-separerbara data linjärt separerbara utan att någonsin bygga den högdimensionella objektkartan. Denna genomgång visar polynomkartanping för hand, tränar sedan en slumpmässig Fourierkärnklassificerare i TensorFlow.
Syftet med denna handledning är att göra en datauppsättning linjärt separerbar. Handledningen är uppdelad i två delar:
- Funktionsförvandling
- Träna en kärnklassificerare med TensorFlow
I den första delen kommer du att förstå idén bakom en kärnmetod inom maskininlärning, medan du i den andra delen kommer att se hur man tränar en kärnklassificerare med TensorFlowDu kommer att använda datamängden för vuxna. Syftet med denna datamängd är att klassificera inkomsterna under och över 50 000, med kännedom om varje hushålls beteende.
Varför behöver du Kernel Methods?
Målet med varje klassificerare är att korrekt förutsäga klasserna. För det bör datamängden vara separerbar. Titta på diagrammet nedan; det är ganska enkelt att se att alla punkter ovanför den svarta linjen tillhör den första klassen och de andra punkterna den andra klassen. Det är dock extremt sällsynt att ha en så enkel datamängd. I de flesta fall är data inte separerbara, och data som inte är separerbara ger naiva klassificerare som logistisk regression det svårt.
import numpy as np
  import matplotlib.pyplot as plt
  from mpl_toolkits.mplot3d import Axes3D
  x_lin = np.array([1,2,3,4,5,6,7,8,9,10])
  y_lin = np.array([2,2,3,2,2,9,6,8,8,9])
  label_lin = np.array([0,0,0,0,0,1,1,1,1,1])

  fig = plt.figure()
  ax=fig.add_subplot(111)
  plt.scatter(x_lin, y_lin, c=label_lin, s=60)
  plt.plot([-2.5, 10], [12.5, -2.5], 'k-', lw=2)
  ax.set_xlim([-5,15])
  ax.set_ylim([-5,15])plt.show()

I figuren nedan plottar vi en datamängd som inte är linjärt separerbar. Om vi ritar en rak linje kommer de flesta punkterna inte att klassificeras i rätt klass.
Ett sätt att hantera detta problem är att ta datamängden och omvandla den till en annan objektkarta. Det innebär att du använder en funktion för att flytta data till ett annat plan, ett som ska vara linjärt separerbart.
x = np.array([1,1,2,3,3,6,6,6,9,9,10,11,12,13,16,18])
y = np.array([18,13,9,6,15,11,6,3,5,2,10,5,6,1,3,1])
label = np.array([1,1,1,1,0,0,0,1,0,1,0,0,0,1,0,1])
fig = plt.figure()
plt.scatter(x, y, c=label, s=60)
plt.show()
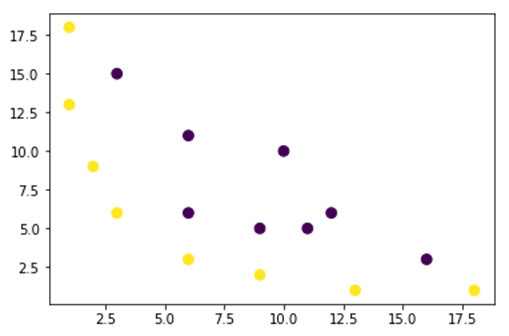
Data från figuren ovan ligger i ett 2D-plan och är inte separerbara. Du kan försöka omvandla dessa data till tre dimensioner, vilket innebär att du skapar en figur med 3 axlar.
I vårt exempel med Gaussisk kärna kommer vi att tillämpa en polynomavbildningping för att få våra data till en tredje dimension. Formeln för att transformera datan är följande.

Du definierar en funktion i Gaussian Kernel Python för att skapa de nya objektkartorna.
Du kan använda numpy för att koda formeln ovan. Varje rad nedan parar ihop en term i avbildningenping med arrayuttrycket som producerar det, och den lilla bilden markerar kvadratroten ur två faktorer.
| Formel | Motsvarande NumPy-kod |
|---|---|
| x | x[:,0] |
| y | x[:,1] |
| x² | x[:,0]**2 |
 |
np.sqrt(2)* |
| xy | x[:,0]*x[:,1] |
| y² | x[:,1]**2 |
### illustration purpose
def mapping(x, y):
	x = np.c_[(x, y)]
    if len(x) >	2:
    	x_1 = x[:,0]**2
        x_2 = np.sqrt(2)*x[:,0]*x[:,1]
        x_3 = x[:,1]**2
    else:
    	x_1 = x[0]**2
        x_2 = np.sqrt(2)*x[0]*x[1]
        x_3 = x[1]**2
   trans_x = np.array([x_1, x_2, x_3])
   return trans_x
Den nya kartanping har 3 dimensioner och 16 punkter.
x_1  = mapping(x, y)
x_1.shape
(3, 16)
Rita nu ett nytt diagram med 3 axlar, x, y respektive z.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[2], c=label, s=60)
ax.view_init(30, 185)ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')
plt.show()

Vi ser en förbättring, men om vi ändrar diagrammets orientering blir det tydligt att datamängden nu är separerbar.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[1], c=label, s=60)
ax.view_init(0, -180)ax.set_ylim([150,-50])
ax.set_zlim([-10000,10000])
ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')plt.show()

Om du måste manipulera en stor datamängd och skapa mer än två dimensioner kommer du att stöta på ett stort problem med metoden ovan. Faktum är att du måste transformera alla datapunkter, vilket uppenbarligen inte är hållbart. Det kommer att ta en evighet, och din dator kan få slut på minne.
Det vanligaste sättet att lösa detta problem är att använda en kärna.
Vad är en kärna i maskininlärning?
Tanken är att använda ett funktionsutrymme med högre dimension för att göra data nästan linjärt separerbara, som visas i figuren ovan.
Det finns gott om högre dimensionella rum som gör datapunkterna separerbara. Till exempel har vi visat att polynomavbildningenping är en bra början.
Vi har också visat att dessa transformationer inte är effektiva med mycket data. Istället kan man använda en kärnfunktion i maskininlärning för att modifiera data utan att flytta till ett nytt funktionsplan.
Kärnans magi är att hitta en funktion som undviker alla problem som högdimensionell beräkning medför. Resultatet av en kärna är en skalär funktion, eller med andra ord, vi är tillbaka i det endimensionella rummet.
När du har hittat den här funktionen kan du koppla in den i den vanliga linjära klassificeraren.
Här är ett exempel som konkretiserar konceptet med kärnmaskininlärning. Du har två vektorer, x1 och x2. Målet är att skapa en högre dimension genom att använda en polynomavbildning.pingUtdata är lika med punktprodukten av den nya objektkartan. Från metoden ovan behöver du:
- Förvandla x1 och x2 till en ny dimension
- Beräkna punktprodukten: gemensam för alla kärnor
Förvandla x1 och x2 till en ny dimension
Du kan använda funktionen som skapats ovan för att beräkna den högre dimensionen.
## Kernel
x1 = np.array([3,6])
x2 = np.array([10,10])

x_1 = mapping(x1, x2)
print(x_1)
Produktion
[[  9.         100.        ]
      [ 25.45584412 141.42135624]
      [ 36.         100.        ]]
Beräkna punktprodukten
Du kan använda objektpunkten från numpy för att beräkna punktprodukten mellan den första och andra vektorn som lagras i x_1.
print(np.dot(x_1[:,0], x_1[:,1]))
8100.0
Utdata är 8100. Du ser problemet: du behöver lagra en ny objektkarta i minnet för att beräkna punktprodukten. Om du har en datamängd med miljontals poster är den beräkningsmässigt ineffektiv.
Istället kan du använda polynomkärnan för att beräkna punktprodukten utan att transformera vektorn. Denna funktion beräknar punktprodukten av x1 och x2 som om dessa två vektorer hade transformerats till den högre dimensionen. Med andra ord beräknar en kärnfunktion resultatet av punktprodukten från ett annat funktionsrum.
Du kan skriva polynomets kärnfunktion i Python som följer.
def polynomial_kernel(x, y, p=2):
	return (np.dot(x, y)) ** p
Det är kraften hos punktprodukten av två vektorer. Nedan returnerar du den andra graden av polynomkärnan. Utgången är lika med den andra metoden. Detta är kärnans magi.
polynomial_kernel(x1, x2, p=2)
8100
Typer av kärnmetoder
Det finns många olika kärntekniker tillgängliga. Den enklaste är den linjära kärnan. Den här funktionen fungerar ganska bra för textklassificering. De andra kärnorna är:
- Polynomkärna
- Gaussisk kärna
Tabellen nedan sammanfattar vad var och en gör och när utövare använder den.
| Kärna | Vad den beräknar | Typisk användning |
|---|---|---|
| Linjär | Den vanliga punktprodukten i det ursprungliga funktionsutrymmet | Redan separerbara data och högdimensionella textfunktioner |
| Polynom | Punktprodukten upphöjd till graden p, som fångar funktionsinteraktioner | Böjda gränser när interaktionerna är kända för att spela roll |
| Gaussisk (RBF) | En avståndsbaserad likhet som faller mot noll när punkter rör sig isär | Det vanliga första valet när gränsformen är okänd |
I exemplet med TensorFlow använder vi slumpmässiga Fourier-funktioner. TensorFlow har en inbyggd estimator för att beräkna det nya funktionsutrymmet. Funktionsmapparen för slumpmässiga Fourier-funktioner är en approximation av den gaussiska kärnfunktionen som visas nedan.

Den Gaussiska filtreringsfunktionen beräknar likheten mellan datapunkterna i ett mycket högre dimensionellt utrymme.
När teorin är avklarad sätter resten av den här genomgången en gaussisk kärna i arbete på en verklig datamängd.
Träna Gaussian Kernel-klassificerare med TensorFlow
Målet med algoritmen är att klassificera hushållet som tjänar mer eller mindre än 50k.
Du kommer först att utvärdera en logistisk regression för att få en riktmärkesmodell. Därefter kommer du att träna en kärnklassificerare för att se om du kan få bättre resultat.
Du använder följande variabler från datauppsättningen för vuxna:
- ålder
- arbetsklass
- fnlwgt
- utbildning
- utbildningsnummer
- äktenskaplig
- ockupation
- relation
- lopp
- kön
- kapitalvinsten
- kapitalförlust
- timmar_vecka
- hemland
- etikett
Du kommer att göra följande innan du tränar och utvärderar modellen:
- Importera biblioteken
- Importera data
- Förbered data
- Konstruera den logistiska modellen: baslinjemodell
- Utvärdera modellen
- Konstruera och utvärdera kärnklassificeraren
Versionsnotering: Varje kodavsnitt nedan riktar sig mot TensorFlow 1.x. Namnrymden tf.contrib, som tillhandahåller real_valued_column, RandomFourierFeatureMapper och KernelLinearClassifier, togs bort i TensorFlow 2.0, och själva tf.estimator togs bort i TensorFlow 2.16. I en aktuell version, bygg samma pipeline med lagret tf.keras.layers.experimental.RandomFourierFeatures följt av ett Dense-utdatalager, eller med paret RBFSampler och SGDClassifier från scikit-learn.
Steg 1) Importera biblioteken
För att importera och träna Kernel-modeller i Artificiell intelligens, du behöver importera TensorFlow, pandor och NumPy.
#import numpy as np
from sklearn.model_selection
import train_test_split
import tensorflow as tf
import pandas as pd
import numpy as np
Steg 2) Importera data
Du laddar ner data från UCI-sida för vuxendata och importera den som en pandas DataFrame.
## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country', 'label']
PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"
PATH_test ="https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.test
"## Import
df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_test = pd.read_csv(PATH_test,skiprows = 1, skipinitialspace=True, names = COLUMNS, index_col=False)
Nu när tåget och testuppsättningen är definierade kan du ändra kolumnetiketten från sträng till heltal. TensorFlow accepterar inte strängvärden för etiketten.
label = {'<=50K': 0,'>50K': 1}
df_train.label = [label[item] for item in df_train.label]
label_t = {'<=50K.': 0,'>50K.': 1}
df_test.label = [label_t[item] for item in df_test.label]
df_train.shape
(32561, 15)
Steg 3) Förbered data
Datasetet innehåller både kontinuerliga och kategoriska funktioner. En bra metod är att standardisera värdena för de kontinuerliga variablerna. Du kan använda funktionen StandardScaler från scikit läraDu skapar även en användardefinierad funktion för att göra det enklare att konvertera tåg- och testmängden. Observera att du sammanfogar de kontinuerliga och kategoriska variablerna till en gemensam datamängd, och arrayen ska vara av typen float32.
COLUMNS_INT = ['age','fnlwgt','education_num','capital_gain', 'capital_loss', 'hours_week']
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']
from sklearn.preprocessing import StandardScaler
from sklearn import preprocessing

def prep_data_str(df):
	scaler = StandardScaler()
    le = preprocessing.LabelEncoder()
    df_toscale = df[COLUMNS_INT]
    df_scaled = scaler.fit_transform(df_toscale.astype(np.float64))
    X_1 = df[CATE_FEATURES].apply(le.fit_transform)
    y = df['label'].astype(np.int32)
    X_conc = np.c_[df_scaled, X_1].astype(np.float32)
    return X_conc, y
Transformer-funktionen är klar, så du kan konvertera datamängden och skapa funktionen input_fn.
X_train, y_train = prep_data_str(df_train)
X_test, y_test = prep_data_str(df_test)
print(X_train.shape)
(32561, 14)
I nästa steg tränar du en logistisk regression. Det kommer att ge dig en baslinjenoggrannhet. Målet är att slå baslinjen med en annan algoritm, nämligen en Kernel-klassificerare.
Steg 4) Konstruera logistikmodellen: Baslinjemodell
Du konstruerar funktionskolumnen med objektet real_valued_column. Det kommer att se till att alla variabler är täta numeriska data.
feat_column = tf.contrib.layers.real_valued_column('features', dimension=14)
Estimatorn definieras med TensorFlow Estimator API; du anger funktionskolumnerna och var grafen ska sparas.
estimator = tf.estimator.LinearClassifier(feature_columns=[feat_column],
                                          n_classes=2,
                                          model_dir = "kernel_log"
                                         )
INFO:tensorflow:Using default config.INFO:tensorflow:Using config: {'_model_dir': 'kernel_log', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a2003f780>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Du kommer att träna den logistiska regressionen med hjälp av mini-batchar av storlek 200.
# Train the model
train_input_fn = tf.estimator.inputs.numpy_input_fn(
	x={"features": X_train},
    y=y_train,
    batch_size=200,
    num_epochs=None,
    shuffle=True)
Du kan träna modellen med 1 000 iterationer.
estimator.train(input_fn=train_input_fn, steps=1000)
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into kernel_log/model.ckpt.
INFO:tensorflow:loss = 138.62949, step = 1
INFO:tensorflow:global_step/sec: 324.16
INFO:tensorflow:loss = 87.16762, step = 101 (0.310 sec)
INFO:tensorflow:global_step/sec: 267.092
INFO:tensorflow:loss = 71.53657, step = 201 (0.376 sec)
INFO:tensorflow:global_step/sec: 292.679
INFO:tensorflow:loss = 69.56703, step = 301 (0.340 sec)
INFO:tensorflow:global_step/sec: 225.582
INFO:tensorflow:loss = 74.615875, step = 401 (0.445 sec)
INFO:tensorflow:global_step/sec: 209.975
INFO:tensorflow:loss = 76.49044, step = 501 (0.475 sec)
INFO:tensorflow:global_step/sec: 241.648
INFO:tensorflow:loss = 66.38373, step = 601 (0.419 sec)
INFO:tensorflow:global_step/sec: 305.193
INFO:tensorflow:loss = 87.93341, step = 701 (0.327 sec)
INFO:tensorflow:global_step/sec: 396.295
INFO:tensorflow:loss = 76.61518, step = 801 (0.249 sec)
INFO:tensorflow:global_step/sec: 359.857
INFO:tensorflow:loss = 78.54885, step = 901 (0.277 sec)
INFO:tensorflow:Saving checkpoints for 1000 into kernel_log/model.ckpt.
INFO:tensorflow:Loss for final step: 67.79706.


<tensorflow.python.estimator.canned.linear.LinearClassifier at 0x1a1fa3cbe0>
Steg 5) Utvärdera modellen
Du definierar indatafunktionen NumPy för att utvärdera modellen. Du använder hela testuppsättningen för utvärderingen.
# Evaluation
test_input_fn = tf.estimator.inputs.numpy_input_fn(
    x={"features": X_test},
    y=y_test,
    batch_size=16281,
    num_epochs=1,
    shuffle=False)
estimator.evaluate(input_fn=test_input_fn, steps=1)
INFO:tensorflow:Calling model_fn.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:22
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from kernel_log/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Evaluation [1/1]
INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:23
INFO:tensorflow:Saving dict for global step 1000: accuracy = 0.82353663, accuracy_baseline = 0.76377374, auc = 0.84898686, auc_precision_recall = 0.67214864, average_loss = 0.3877216, global_step = 1000, label/mean = 0.23622628, loss = 6312.495, precision = 0.7362797, prediction/mean = 0.21208474, recall = 0.39417577
{'accuracy': 0.82353663,
 'accuracy_baseline': 0.76377374,
 'auc': 0.84898686,
 'auc_precision_recall': 0.67214864,
 'average_loss': 0.3877216,
 'global_step': 1000,
 'label/mean': 0.23622628,
 'loss': 6312.495,
 'precision': 0.7362797,
 'prediction/mean': 0.21208474,
 'recall': 0.39417577}
Du har en noggrannhet på 82 procent. I nästa avsnitt ska du försöka slå den logistiska klassificeraren med en kärnklassificerare.
Steg 6) Konstruera Kernel-klassificeraren
Kärnestimatorn skiljer sig inte så mycket från den traditionella linjära klassificeraren, åtminstone inte vad gäller konstruktionen. Tanken bakom den är att kombinera kraften hos en explicit kärnkarta.ping med den linjära klassificeraren.
Du behöver två fördefinierade estimatorer tillgängliga i TensorFlow för att träna Kernel Classifier:
- RandomFourierFeatureMapper
- KernelLinearClassifier
Du lärde dig i det första avsnittet att du behöver omvandla den låga dimensionen till en hög dimension med hjälp av en kärnfunktion. Mer exakt kommer du att använda slumpmässiga Fourierfunktioner, som approximerar den gaussiska funktionen. TensorFlow 1.x tillhandahåller den avbildningenping som RandomFourierFeatureMapper, och modellen kan tränas med hjälp av estimatorn KernelLinearClassifier.
För att bygga modellen följer du dessa steg:
- Ställ in den höga kärnfunktionen
- Ställ in hyperparametern L2
- Bygg modellen
- Träna modellen
- Utvärdera modellen
Steg A) Ställ in den högdimensionella kärnfunktionen
Den aktuella datamängden innehåller 14 funktioner som du kommer att transformera till en ny 5 000-dimensionell vektor. Du använder de slumpmässiga Fourierfunktionerna för att uppnå transformationen. Om du minns den gaussiska kärnformeln noterar du att det finns en standardavvikelsesparameter att definiera. Denna parameter styr likhetsmåttet som används under klassificeringen: en liten stddev gör att kärnan endast behandlar mycket nära punkter som lika, medan en stor jämnar ut beslutsgränsen.
Du kan ställa in alla parametrar i RandomFourierFeatureMapper med:
- input_dim = 14
- utgångsdim = 5000
- stddev = 4
### Prep Kernel
kernel_mapper = tf.contrib.kernel_methods.RandomFourierFeatureMapper(input_dim=14, output_dim=5000, stddev=4, name='rffm')
Du måste konstruera kärnmapparen genom att använda funktionskolumnerna som skapats innan: feat_column
### Map Kernel
kernel_mappers = {feat_column: [kernel_mapper]}
Steg B) Ställ in L2-hyperparametern
För att förhindra överanpassning bestraffar du förlustfunktionen med L2-regulariseraren. Du ställer in L2-hyperparametern till 0.1 och inlärningshastigheten till 5.
optimizer = tf.train.FtrlOptimizer(learning_rate=5, l2_regularization_strength=0.1)
Steg C) Bygg modellen
Nästa steg liknar den linjära klassificeringen. Du använder den inbyggda estimatorn KernelLinearClassifier. Observera att du lägger till kärnmapparen som definierats tidigare och ändrar modellkatalogen.
### Prep estimator
estimator_kernel = tf.contrib.kernel_methods.KernelLinearClassifier(
    n_classes=2,
    optimizer=optimizer,
    kernel_mappers=kernel_mappers,
    model_dir="kernel_train")
Utfasningsvarningarna nedan förväntas på TensorFlow 1.x, eftersom kernel_methods-modulen är byggd på de äldre tf.contrib.learn-uppskattarna.
WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/kernel_methods/python/kernel_estimators.py:305: multi_class_head (from tensorflow.contrib.learn.python.learn.estimators.head) is deprecated and will be removed in a future version. Instructions for updating: Please switch to tf.contrib.estimator.*_head. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:1179: BaseEstimator.__init__ (from tensorflow.contrib.learn.python.learn.estimators.estimator) is deprecated and will be removed in a future version. Instructions for updating: Please replace uses of any Estimator from tf.contrib.learn with an Estimator from tf.estimator.* WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:427: RunConfig.__init__ (from tensorflow.contrib.learn.python.learn.estimators.run_config) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.RunConfig instead. INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_task_type': None, '_task_id': 0, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a200ae550>, '_master': '', '_num_ps_replicas': 0, '_num_worker_replicas': 0, '_environment': 'local', '_is_chief': True, '_evaluation_master': '', '_train_distribute': None, '_tf_config': gpu_options { per_process_gpu_memory_fraction: 1.0 } , '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_secs': 600, '_log_step_count_steps': 100, '_session_config': None, '_save_checkpoints_steps': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_model_dir': 'kernel_train'}
Steg D) Träna modellen
Nu när kärnklassificeraren är byggd är du redo att träna den. Du väljer att iterera modellen 2 000 gånger.
### estimate
estimator_kernel.fit(input_fn=train_input_fn, steps=2000)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/head.py:678: ModelFnOps.__new__ (from tensorflow.contrib.learn.python.learn.estimators.model_fn) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.EstimatorSpec. You can use the `estimator_spec` method to create an equivalent one. INFO:tensorflow:Create CheckpointSaverHook. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Saving checkpoints for 1 into kernel_train/model.ckpt. INFO:tensorflow:loss = 0.6931474, step = 1 INFO:tensorflow:global_step/sec: 86.6365 INFO:tensorflow:loss = 0.39374447, step = 101 (1.155 sec) INFO:tensorflow:global_step/sec: 80.1986 INFO:tensorflow:loss = 0.3797774, step = 201 (1.247 sec) INFO:tensorflow:global_step/sec: 79.6376 INFO:tensorflow:loss = 0.3908726, step = 301 (1.256 sec) INFO:tensorflow:global_step/sec: 95.8442 INFO:tensorflow:loss = 0.41890752, step = 401 (1.043 sec) INFO:tensorflow:global_step/sec: 93.7799 INFO:tensorflow:loss = 0.35700393, step = 501 (1.066 sec) INFO:tensorflow:global_step/sec: 94.7071 INFO:tensorflow:loss = 0.35535482, step = 601 (1.056 sec) INFO:tensorflow:global_step/sec: 90.7402 INFO:tensorflow:loss = 0.3692882, step = 701 (1.102 sec) INFO:tensorflow:global_step/sec: 94.4924 INFO:tensorflow:loss = 0.34746957, step = 801 (1.058 sec) INFO:tensorflow:global_step/sec: 95.3472 INFO:tensorflow:loss = 0.33655524, step = 901 (1.049 sec) INFO:tensorflow:global_step/sec: 97.2928 INFO:tensorflow:loss = 0.35966292, step = 1001 (1.028 sec) INFO:tensorflow:global_step/sec: 85.6761 INFO:tensorflow:loss = 0.31254214, step = 1101 (1.167 sec) INFO:tensorflow:global_step/sec: 91.4194 INFO:tensorflow:loss = 0.33247527, step = 1201 (1.094 sec) INFO:tensorflow:global_step/sec: 82.5954 INFO:tensorflow:loss = 0.29305756, step = 1301 (1.211 sec) INFO:tensorflow:global_step/sec: 89.8748 INFO:tensorflow:loss = 0.37943482, step = 1401 (1.113 sec) INFO:tensorflow:global_step/sec: 76.9761 INFO:tensorflow:loss = 0.34204718, step = 1501 (1.300 sec) INFO:tensorflow:global_step/sec: 73.7192 INFO:tensorflow:loss = 0.34614792, step = 1601 (1.356 sec) INFO:tensorflow:global_step/sec: 83.0573 INFO:tensorflow:loss = 0.38911164, step = 1701 (1.204 sec) INFO:tensorflow:global_step/sec: 71.7029 INFO:tensorflow:loss = 0.35255936, step = 1801 (1.394 sec) INFO:tensorflow:global_step/sec: 73.2663 INFO:tensorflow:loss = 0.31130585, step = 1901 (1.365 sec) INFO:tensorflow:Saving checkpoints for 2000 into kernel_train/model.ckpt. INFO:tensorflow:Loss for final step: 0.37795097. KernelLinearClassifier(params={'head': <tensorflow.contrib.learn.python.learn.estimators.head._BinaryLogisticHead object at 0x1a2054cd30>, 'feature_columns': {_RealValuedColumn(column_name='features_MAPPED', dimension=5000, default_value=None, dtype=tf.float32, normalizer=None)}, 'optimizer': <tensorflow.python.training.ftrl.FtrlOptimizer object at 0x1a200aec18>, 'kernel_mappers': {_RealValuedColumn(column_name='features', dimension=14, default_value=None, dtype=tf.float32, normalizer=None): [<tensorflow.contrib.kernel_methods.python.mappers.random_fourier_features.RandomFourierFeatureMapper object at 0x1a200ae400>]}})
Steg E) Utvärdera modellen
Sist men inte minst utvärderar du prestandan hos din modell. Du bör kunna slå den logistiska regressionen.
# Evaluate and report metrics.
eval_metrics = estimator_kernel.evaluate(input_fn=test_input_fn, steps=1)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:50 INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from kernel_train/model.ckpt-2000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Evaluation [1/1] INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:51 INFO:tensorflow:Saving dict for global step 2000: accuracy = 0.83975184, accuracy/baseline_label_mean = 0.23622628, accuracy/threshold_0.500000_mean = 0.83975184, auc = 0.8904007, auc_precision_recall = 0.72722375, global_step = 2000, labels/actual_label_mean = 0.23622628, labels/prediction_mean = 0.23786618, loss = 0.34277728, precision/positive_threshold_0.500000_mean = 0.73001117, recall/positive_threshold_0.500000_mean = 0.5104004
Den slutliga noggrannheten är 84 %, cirka 1.6 procentenheter över baslinjen för logistisk regression (0.83975184 mot 0.82353663). Det finns en avvägning mellan förbättring av noggrannheten och beräkningskostnaden. Du måste fundera över om den förbättringen är värd den tid som den tyngre klassificeraren tar och om den har en övertygande inverkan på din verksamhet.
