
PyTorch Transfer Learning Handledning med exempel
 Evelyn Clarke
⚡ Smart sammanfattning
Transfer Learning återanvänder ett nätverk som redan är tränat på en stor datamängd så att en ny, relaterad uppgift kan lösas med betydligt färre märkta bilder och en bråkdel av den ursprungliga träningstiden.
Vad är Transfer Learning?
Överför lärande är en teknik för att använda en tränad modell för att lösa en annan relaterad uppgift. Det är en Maskininlärning en forskningsmetod som lagrar den kunskap som erhållits vid lösning av ett visst problem och använder samma kunskap för att lösa ett annat, men relaterat problem. Detta förbättrar effektiviteten genom att återanvända informationen som samlats in från den tidigare inlärda uppgiften.
Det är populärt att återanvända vikterna från en annan nätverksmodell eftersom det krävs en mycket stor mängd data för att träna ett nätverk från grunden. För att minska träningstiden tar man ett befintligt nätverk och dess vikter och modifierar det sista lagret för att lösa sitt eget problem. Fördelen är att detta sista lager kan tränas med en liten datamängd.
Innan du skriver någon PyTorch-kod, är det bra att veta vilken familj av Transfer Learning ditt problem tillhör, eftersom det avgör hur mycket märkt data du behöver.
Typer av överföringslärande
Forskningslitteraturen delar upp tekniken i tre familjer. Vilken som gäller för dig beror på vilken sida av problemet som bär etiketter, inte på vilket ramverk du använder.
| Typ | Källdomän | Target domän | Typisk användning |
|---|---|---|---|
| Induktiv | Märkt | Märkt, men en annan uppgift | Att omdirigera en ImageNet-ryggrad mot ett tvåklassigt Alien vs. Predator-problem |
| Transduktiv | Märkt | Omärkt, samma uppgift, annan datadistribution | Domänanpassning, som att flytta en modell från studiofotografier till telefonfotografier |
| Oövervakad | Omärkt | Omärkt | Clusterning eller dimensionsreduktion där det är opraktiskt att märka varje post |
Exemplet som byggs i den här handledningen är induktiv överföringsinlärning. VGG19 anländer med märkt ImageNet-kunskap, och den riktar sig sedan mot ett märkt tvåklassproblem som den aldrig sett förut.
Funktion Extraction kontra finjustering
Efter att ett förtränat nätverk har valts finns det två sätt att anpassa det. Skillnaden är helt enkelt hur många lager du tillåter att fortsätta lära sig.
| Aspect | Funktion extraction | Finjustering |
|---|---|---|
| Lager som tränar | Endast den ersatta klassificeraren | Klassificeraren plus några eller alla faltningsblock |
| requires_grad på ryggraden | Falsk | Sant för blocken som uppdateras |
| Behövliga uppgifter | Små, ofta några hundra bilder per klass | Större, vanligtvis tusentals |
| Utbildningskostnad | Lägst, körs på en CPU | Ju högre, desto mer värt blir det att ha en GPU |
| Typisk noggrannhet | Bra när käll- och målbilder ser likadana ut | Vanligtvis bättre när de två domänerna skiljer sig åt |
Stegen nedan använder funktionen extraction: varje VGG19-parameter fryses och endast det nya slutliga linjära lagret lär sig. Att byta till finjustering är en liten förändring, nämligen att lämna requires_grad satt till True på de block du vill uppdatera och sänka inlärningshastigheten så att de lånade vikterna inte förstörs.
Laddar datauppsättning
Innan du börjar använda Transfer Learning med PyTorch, du behöver förstå den datauppsättning du ska använda. I denna Transfer Learning PyTorTill exempel kommer du att klassificera en utomjording och ett rovdjur från nästan 700 bilder. För den här tekniken behöver du egentligen inte en stor mängd data för att träna. Du kan ladda ner datasetet från Kaggle: Alien vs. Predator.
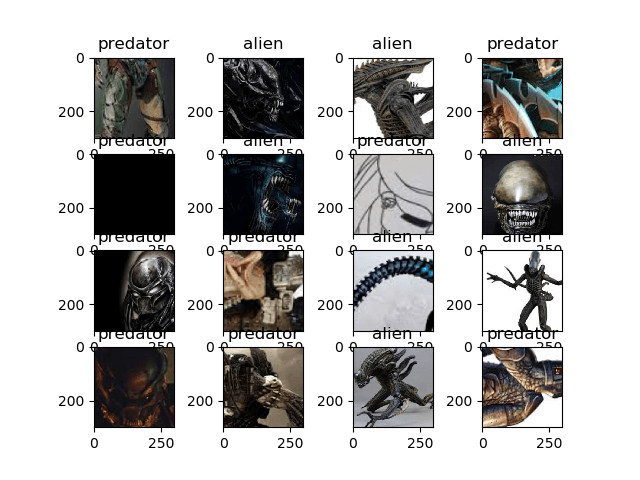
Samlingen är avsiktligt liten, och ett urval av bilderna den innehåller visas nedan.

Källa: Främmande vs. Predator Kaggle
Nästa i denna PyTorch Transfer Learning-handledningen, lär du dig hur du tillämpar Transfer Learning med PyTorch steg för steg.
Hur använder man Transfer Learning?
Här är en steg-för-steg-process för hur man använder Transfer Learning för djupinlärning med PyTorch:
Steg 1) Ladda data
Det första steget är att ladda data och tillämpa några transformationer på bilderna så att de matchar nätverkets krav.
Du kommer att ladda data från en mapp med torchvision.datasets. Modulen itererar över mappen för att dela upp data i tåg- och valideringsuppsättningar. Transformationspipelinen som används här beskär bilderna från mitten, konverterar dem till en tensor och normaliserar dem för Deep Learning.
from __future__ import print_function, division
import os
import time
import torch
import torchvision
from torchvision import datasets, models, transforms
import torch.optim as optim
import numpy as np
import matplotlib.pyplot as plt

data_dir = "alien_pred"
input_shape = 224
mean = [0.5, 0.5, 0.5]
std = [0.5, 0.5, 0.5]

#data transformation
data_transforms = {
   'train': transforms.Compose([
       transforms.CenterCrop(input_shape),
       transforms.ToTensor(),
       transforms.Normalize(mean, std)
   ]),
   'validation': transforms.Compose([
       transforms.CenterCrop(input_shape),
       transforms.ToTensor(),
       transforms.Normalize(mean, std)
   ]),
}

image_datasets = {
   x: datasets.ImageFolder(
       os.path.join(data_dir, x),
       transform=data_transforms[x]
   )
   for x in ['train', 'validation']
}

dataloaders = {
   x: torch.utils.data.DataLoader(
       image_datasets[x], batch_size=32,
       shuffle=True, num_workers=4
   )
   for x in ['train', 'validation']
}

dataset_sizes = {x: len(image_datasets[x]) for x in ['train', 'validation']}

print(dataset_sizes)
class_names = image_datasets['train'].classes

device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
Visualisera nu datamängden. Visualiseringssteget tar nästa omgång bilder och etiketter från träningsdataladdaren och visar dem med Matplotlib.
images, labels = next(iter(dataloaders['train']))

rows = 4
columns = 4
fig=plt.figure()
for i in range(16):
   fig.add_subplot(rows, columns, i+1)
   plt.title(class_names[labels[i]])
   img = images[i].numpy().transpose((1, 2, 0))
   img = std * img + mean
   plt.imshow(img)
plt.show()
Genom att köra det där snippet ritar man ett fyra gånger fyra rutnät med träningsbilder, där var och en har det klassnamn som laddaren returnerade.
Steg 2) Definiera modell
I den här djupinlärningsprocessen kommer du att använda VGG19 från torchvision-modulen.
Du kommer att använda torchvision.models för att ladda vgg19 med de förtränade vikterna aktiverade. Därefter fryser du lagren så att de inte är träningsbara. Du modifierar sedan det sista lagret med ett linjärt lager som passar problemet, vilket här betyder 2 klasser. CrossEntropyLoss används som förlustfunktion, och optimeraren är SGD med en inlärningshastighet på 0.001 och ett momentum på 0.9, som visas i Py nedan.Torch Exempel på överföring av lärande.
## Load the model based on VGG19
vgg_based = torchvision.models.vgg19(pretrained=True)

## freeze the layers
for param in vgg_based.parameters():
   param.requires_grad = False

# Modify the last layer
number_features = vgg_based.classifier[6].in_features
features = list(vgg_based.classifier.children())[:-1] # Remove last layer
features.extend([torch.nn.Linear(number_features, len(class_names))])
vgg_based.classifier = torch.nn.Sequential(*features)

vgg_based = vgg_based.to(device)

print(vgg_based)

criterion = torch.nn.CrossEntropyLoss()
optimizer_ft = optim.SGD(vgg_based.parameters(), lr=0.001, momentum=0.9)
Versionsnotering: d förtränad=Sant argumentet fungerar fortfarande men har ersatts sedan torchvision 0.13 av vikter argument, så nyare installationer förväntar sig torchvision.models.vgg19(vikter=VGG19_Vikter.STANDARD) och skriv ut en varning om utfasning annars. Båda formulären laddar samma ImageNet-vikter.
Utgångsmodellens struktur
Att skriva ut modellen returnerar hela VGG19-grafen. Läs den sista raden i klassificeringsblocket för att bekräfta att växlingen fungerade: den producerar nu 2 utdata istället för de 1 000 ImageNet-klasserna.
VGG(
  (features): Sequential(
	(0): Conv2d(3, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(1): ReLU(inplace)
	(2): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(3): ReLU(inplace)
	(4): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(5): Conv2d(64, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(6): ReLU(inplace)
	(7): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(8): ReLU(inplace)
	(9): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(10): Conv2d(128, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(11): ReLU(inplace)
	(12): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(13): ReLU(inplace)
	(14): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(15): ReLU(inplace)
	(16): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(17): ReLU(inplace)
	(18): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(19): Conv2d(256, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(20): ReLU(inplace)
	(21): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(22): ReLU(inplace)
	(23): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(24): ReLU(inplace)
	(25): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(26): ReLU(inplace)
	(27): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(28): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(29): ReLU(inplace)
	(30): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(31): ReLU(inplace)
	(32): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(33): ReLU(inplace)
	(34): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(35): ReLU(inplace)
	(36): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  )
  (classifier): Sequential(
	(0): Linear(in_features=25088, out_features=4096, bias=True)
	(1): ReLU(inplace)
	(2): Dropout(p=0.5)
	(3): Linear(in_features=4096, out_features=4096, bias=True)
	(4): ReLU(inplace)
	(5): Dropout(p=0.5)
	(6): Linear(in_features=4096, out_features=2, bias=True)
  )
)
Steg 3) Träna och testa modell
Vi kommer att använda några av funktionerna från detta PyTorch-handledning för att hjälpa oss att träna och utvärdera vår modell.
def train_model(model, criterion, optimizer, num_epochs=25):
   since = time.time()

   for epoch in range(num_epochs):
       print('Epoch {}/{}'.format(epoch, num_epochs - 1))
       print('-' * 10)

       #set model to trainable
       # model.train()

       train_loss = 0

       # Iterate over data.
       for i, data in enumerate(dataloaders['train']):
           inputs , labels = data
           inputs = inputs.to(device)
           labels = labels.to(device)

           optimizer.zero_grad()

           with torch.set_grad_enabled(True):
               outputs  = model(inputs)
               loss = criterion(outputs, labels)

           loss.backward()
           optimizer.step()

           train_loss += loss.item() * inputs.size(0)

           print('{} Loss: {:.4f}'.format(
               'train', train_loss / dataset_sizes['train']))

   time_elapsed = time.time() - since
   print('Training complete in {:.0f}m {:.0f}s'.format(
       time_elapsed // 60, time_elapsed % 60))

   return model

def visualize_model(model, num_images=6):
   was_training = model.training
   model.eval()
   images_so_far = 0
   fig = plt.figure()

   with torch.no_grad():
       for i, (inputs, labels) in enumerate(dataloaders['validation']):
           inputs = inputs.to(device)
           labels = labels.to(device)

           outputs = model(inputs)
           _, preds = torch.max(outputs, 1)

           for j in range(inputs.size()[0]):
               images_so_far += 1
               ax = plt.subplot(num_images//2, 2, images_so_far)
               ax.axis('off')
               ax.set_title('predicted: {} truth: {}'.format(class_names[preds[j]], class_names[labels[j]]))
               img = inputs.cpu().data[j].numpy().transpose((1, 2, 0))
               img = std * img + mean
               ax.imshow(img)

               if images_so_far == num_images:
                   model.train(mode=was_training)
                   return
       model.train(mode=was_training)
Slutligen i denna överföringslärande i PyTorTill exempel, starta träningsprocessen med antalet epoker satt till 25 och utvärdera nätverket efteråt. Vid varje träningssteg tar modellen indata och förutspår utdata. Förutsägelsen skickas till kriteriet för att beräkna förlusten, backpropagation beräknar gradienterna och optimeraren uppdaterar vikterna med autograd.
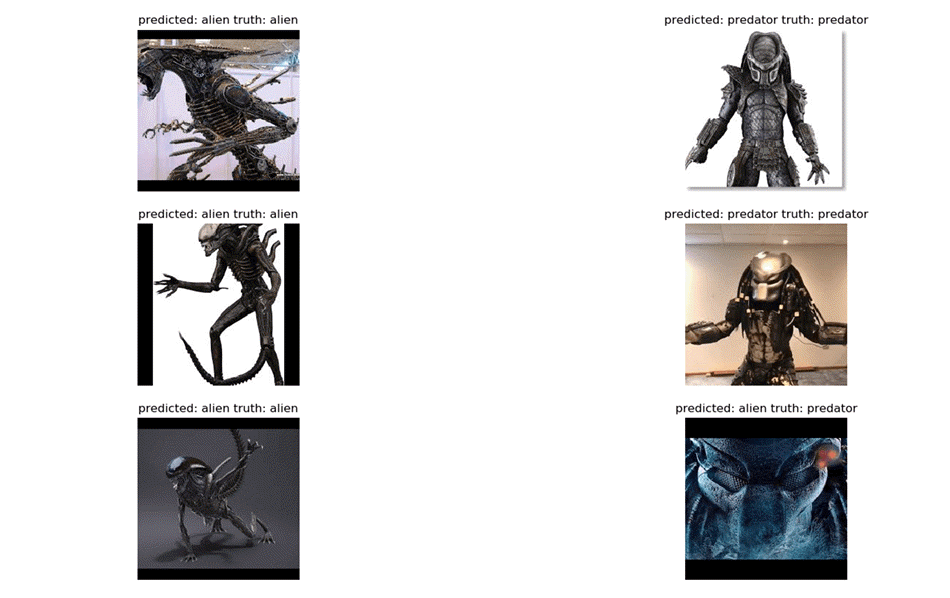
I visualiseringsfunktionen testas det tränade nätverket med en sats bilder för att förutsäga etiketterna, och resultatet ritas med Matplotlib.
vgg_based = train_model(vgg_based, criterion, optimizer_ft, num_epochs=25)

visualize_model(vgg_based)

plt.show()
Steg 4) Resultat
Noggrannheten som rapporterats för denna körning är 92 %. Loggen som skrivs ut i slutet av träningen visar löpförlusten för de två senaste epokerna tillsammans med den totala träningstiden.
Epoch 23/24
----------
train Loss: 0.0044
train Loss: 0.0078
train Loss: 0.0141
train Loss: 0.0221
train Loss: 0.0306
train Loss: 0.0336
train Loss: 0.0442
train Loss: 0.0482
train Loss: 0.0557
train Loss: 0.0643
train Loss: 0.0763
train Loss: 0.0779
train Loss: 0.0843
train Loss: 0.0910
train Loss: 0.0990
train Loss: 0.1063
train Loss: 0.1133
train Loss: 0.1220
train Loss: 0.1344
train Loss: 0.1382
train Loss: 0.1429
train Loss: 0.1500
Epoch 24/24
----------
train Loss: 0.0076
train Loss: 0.0115
train Loss: 0.0185
train Loss: 0.0277
train Loss: 0.0345
train Loss: 0.0420
train Loss: 0.0450
train Loss: 0.0490
train Loss: 0.0644
train Loss: 0.0755
train Loss: 0.0813
train Loss: 0.0868
train Loss: 0.0916
train Loss: 0.0980
train Loss: 0.1008
train Loss: 0.1101
train Loss: 0.1176
train Loss: 0.1282
train Loss: 0.1323
train Loss: 0.1397
train Loss: 0.1436
train Loss: 0.1467
Training complete in 2m 47s
Modellens förutsägelser visualiseras sedan med Matplotlib, som visas nedan.
Vanliga fel vid överföringsinlärning och hur man åtgärdar dem
De flesta fel i ett överföringsinlärningsskript är mekaniska snarare än matematiska. Det är dessa som hindrar koden ovan från att köras, och vad var och en betyder.
- Storleksavvikelse i det sista lagret: Det ersatta linjära lagret måste acceptera de in_features som rapporteras av den ursprungliga klassificeraren och ge exakta len(class_names)-utdata. Att skriva ut modellen, som i steg 2, är det snabbaste sättet att bekräfta båda siffrorna.
- Ryggraden har aldrig varit frusen: Om requires_grad lämnas på True uppdateras varje VGG19-parameter och körningen saktar ner till en krypning på en CPU. Sätt den på False innan klassificeraren ersätts.
- Normaliseringsfel: Medelvärdet och standardavvikelsen som används i transformationerna. Normalisering måste vara samma värden vid tränings- och inferenstid, annars avviker förutsägelserna utan någon synlig anledning.
- Föråldrat viktningsargument: På torchvision 0.13 och senare genererar pretrained=True en varning om utfasning och weights enum är att föredra.
- antal_arbetare på Windows och anteckningsböcker: En DataLoader med num_workers=4 behöver att startpunkten skyddas, så sätt num_workers=0 om Python genererar ett spawn- eller pickling-fel.
- Utvärdering i träningsläge: anropa model.eval() innan poängsättning så att Dropout och BatchNorm beter sig deterministiskt, och växla tillbaka med model.train() efteråt.
