
Ce este testarea de recuperare? cu Exemplu
 Echipa editorială
⚡ Rezumat inteligent
Testarea de recuperare verifică dacă software-ul își poate relua funcționarea normală după o eroare, o cădere de rețea sau o defecțiune hardware, prin restaurarea sistemului la un punct cunoscut ca fiind funcțional și reprocesarea tranzacțiilor până la producerea defecțiunii.
Ce este testarea de recuperare?
Testare de recuperare este o tehnică de testare a software-ului care verifică capacitatea software-ului de a se recupera după erori precum blocări de software sau hardware și erori de rețea. Scopul testării de recuperare este de a determina dacă operațiunile software pot fi continuate după un dezastru sau o pierdere a integrității. Testarea de recuperare implică revenirea software-ului la punctul în care integritatea era cunoscută și reprocesarea tranzacțiilor până la punctul de eroare.
În ingineria software, testarea recuperabilității este un tip de testarea nefuncțională — acoperă aspecte care nu sunt legate de o funcție sau o acțiune specifică a utilizatorului, cum ar fi scalabilitatea sau securitatea. Este realizată de testeri profesioniști, iar datele de rezervă adecvate sunt păstrate în prealabil în locații sigure.
Exemplu de testare de recuperare
Două scenarii prezintă tehnica la cel mai simplu nivel. În fiecare dintre ele, o eroare este forțată în mod deliberat, apoi aplicația este urmărită în timp ce își reia activitatea.
- Întrerupere a rețelei: În timp ce o aplicație primește date de la rețea, deconectați cablul de conectare. După un timp, reconectați-l și analizați capacitatea aplicației de a continua să primească date din punctul în care conexiunea a fost întreruptă.
- Restaurarea sesiunii: Reporniți sistemul în timp ce un browser are un număr definit de sesiuni deschise și verificați dacă browserul le recuperează pe toate.
Ilustrația de mai jos prezintă aceeași idee într-o formă vizuală.
Timpul necesar pentru recuperare depinde de:
- Numărul de puncte de repornire
- Volumul de date deținut de aplicație
- Instruirea și competențele persoanelor care desfășoară activități de recuperare și instrumentele disponibile pentru recuperare
Când există mai multe defecțiuni, testarea de recuperare ar trebui efectuată într-un mod structurat, mai degrabă decât toate odată - efectuată pentru un segment și apoi pentru altul.
Ciclul de viață al procesului de recuperare
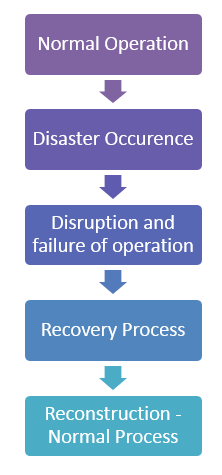
Înainte de a proiecta cazuri de testare, este util să vedem unde intervine un test de recuperare. Ciclul de viață al procesului de recuperare are cinci etape:
- Operatie normala
- Apariția dezastrului
- Întreruperea și eșecul operațiunii
- Eliminarea dezastrelor prin procesul de recuperare
- Reconstrucția tuturor proceselor și informațiilor, readucând întregul sistem la funcționarea normală
Diagrama de flux de mai jos prezintă aceste cinci etape în secvență.
Să discutăm în detaliu acești cinci pași:
- Operatie normala. Un sistem de hardware, software și firmware, integrat pentru a atinge un obiectiv comun, își îndeplinește sarcina proiectată fără întreruperi, într-o perioadă de timp stipulată.
- Apariția unui dezastru. O întrerupere poate apărea din cauza funcționării defectuoase a software-ului, din cauze precum o defecțiune inițiată de intrare, o eroare cauzată de o defecțiune hardware sau daune provocate de incendiu, furt sau grevă.
- Perturbare și eșec. Aceasta este cea mai dureroasă fază, ducând la pierderi de afaceri, relații rupte, oportunități pierdute, ore de muncă pierdute și, invariabil, pierderi financiare și de reputație. Un plan de recuperare în caz de dezastru menține această fază la minimum.
- Eliminarea dezastrelor. Dacă există deja un plan de rezervă și procese de atenuare a riscurilor, recuperarea costă mult mai puțin timp și efort. O echipă desemnată, cu rolul fiecărei persoane definit în prealabil, stabilește responsabilitățile și previne o perioadă lungă de întrerupere a activității.
- Reconstrucţie. Aceasta poate implica mai multe sesiuni de operare pentru a reconstrui toate folderele împreună cu fișierele de configurare. Pentru o recuperare corectă sunt necesare o documentație adecvată și un proces de reconstrucție definit.
Strategia de restaurare
Echipa de recuperare ar trebui să aibă propria strategie pentru recuperarea codului și a datelor importante pentru a readuce operațiunile la normal. Această strategie este unică pentru fiecare organizație, bazată pe importanța sistemelor pe care le gestionează, iar pentru sistemele critice se reduce la un set de opțiuni:
- O singură copie de rezervă sau mai multe
- Mai multe copii de rezervă într-un singur loc sau în locuri diferite
- Copiere de rezervă online sau copie de rezervă offline
- Copiile de rezervă se execută automat în baza unei politici sau sunt declanșate manual
- O echipă independentă de restaurare sau echipa de dezvoltare care efectuează lucrările
Fiecare opțiune are un factor de cost, iar backup-urile multiple pot consuma mai multe resurse fizice sau pot necesita o echipă independentă. Dependența contează și ea: companiile sunt expuse prin codul și datele pe care le păstrează la un singur furnizor și la o scară largă. AWS O pană de curent a scos din funcțiune în mod repetat, în același timp, servicii pentru consumatori bine-cunoscute. Capacitatea de restaurare independentă este crucială în astfel de cazuri.
Cum se face testarea de recuperare
Odată stabilită strategia, următoarea întrebare este cum este configurat testul în sine. Următoarele aspecte ar trebui luate în considerare la efectuarea testelor de recuperare.
- Creați un platformă de testare cât mai apropiată de condițiile reale de implementare: interfața, protocolul, firmware-ul, hardware-ul și software-ul ar trebui să corespundă cu producția.
- Deși testarea exhaustivă poate consuma mult timp și este costisitoare, ar trebui efectuată totuși o configurație identică și o verificare completă.
- Dacă este posibil, testați hardware-ul pe care se va face restaurarea în final — mai ales când restaurați pe o altă mașină decât cea pe care a fost creată copia de rezervă.
- Unele sisteme de backup se așteaptă ca hard disk-ul să aibă exact aceeași dimensiune cu cea de pe care a fost luată backupul.
- Gestionarea învechirii: tehnologia unităților avansează rapid, iar o unitate veche poate să nu fie compatibilă cu una nouă. Restaurarea la o mașină virtuală ajută, deoarece software-ul de virtualizare poate imita hardware-ul existent, inclusiv dimensiunile discurilor.
- Sistemele de backup online nu fac excepție de la testare. Majoritatea furnizorilor protejează utilizatorii de problemele legate de suporturile media prin stocare tolerantă la erori, astfel încât defecțiunile apar târziu.
- Chiar dacă sistemele de backup online sunt extrem de fiabile, partea de restaurare trebuie testată pentru a confirma că nu există probleme cu recuperarea, securitatea sau criptarea.
Deoarece recuperarea se face de la un capăt la altul, aceste exerciții sunt de obicei programate odată cu testarea sistemului mai degrabă decât la nivel de unitate.
Procedura de testare după restaurare
Restaurarea datelor este doar jumătate din exercițiu; copia restaurată trebuie să fie încă dovedită ca fiind utilizabilă. Majoritatea corporațiilor mari au auditori independenți care efectuează periodic exerciții de recuperare. Un plan cuprinzător de recuperare în caz de dezastru este costisitor de întreținut și testat, așa că organizațiile mai mici se bazează adesea pe copii de rezervă și stocare în afara sediului.
După restaurarea folderelor și fișierelor, următoarele verificări confirmă că acestea au fost recuperate corect:
- Redenumiți folderul cu documente corupte, astfel încât copia restaurată să nu poată fi confundată cu acesta.
- Numără fișierele din folderele restaurate și compară numărul respectiv cu folderul original.
- Deschideți câteva fișiere cu aplicația care le folosește în mod normal și confirmați că datele pot fi răsfoite și actualizate ca de obicei.
- Deschideți mai multe fișiere de diferite tipuri — imagini, MP3și documente, unele mari și altele mici.
- Folosește utilitarele de comparare a fișierelor și directoarelor pe care le folosesc majoritatea sisteme de operare oferă.
