
Tutorial su dplyr in R: Unire e combinare dati con esempi
 Evelyn Clarke
⚡ Riepilogo intelligente
dplyr unisce e combina i data frame in R con quattro funzioni: left_join(), right_join(), inner_join() e full_join(). Il pacchetto complementare tidyr rimodella poi il risultato dell'unione utilizzando gather(), spread(), separate() e unite().
Introduzione all'analisi dei dati
Prima di qualsiasi unione o rishaping Il verbo ha senso, aiuta a capire dove si inserisce la manipolazione dei dati. L'analisi dei dati può essere suddiviso in tre parti:
- Extracproduzione: Innanzitutto, dobbiamo raccogliere i dati da molte fonti e combinarli.
- Trasformare: Questo passaggio prevede la manipolazione dei dati. Una volta consolidate tutte le fonti di dati, possiamo iniziare a pulire i dati.
- Visualizzare: L'ultima mossa è visualizzare i nostri dati per verificare l'irregolarità.
Il diagramma sottostante mostra come si collegano le tre fasi.
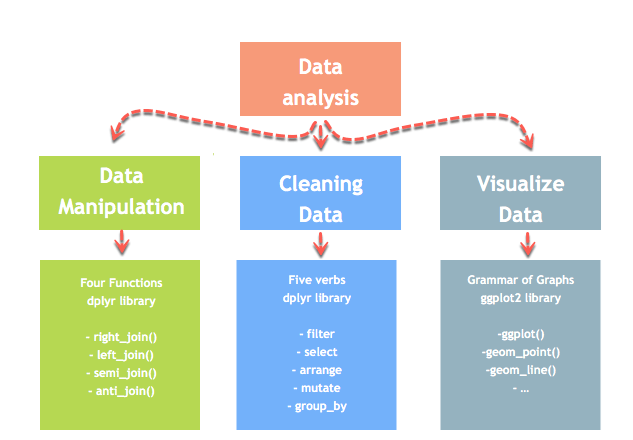
Una delle sfide più significative per gli scienziati dei dati è la manipolazione dei dati. I dati non sono mai disponibili nel formato desiderato. Gli scienziati dei dati devono dedicare almeno metà del loro tempo alla pulizia e alla manipolazione dei dati. Questo è uno dei compiti più critici del lavoro. Se il processo di manipolazione dei dati non è completo, preciso e rigoroso, il modello non funzionerà correttamente.
R dplyr
R dispone di un pacchetto chiamato dplyr che gestisce la trasformazione dei dati. È costruito attorno a un piccolo insieme di verbi principali — filter(), select(), arrange(), mutate() e summarise() — oltre a una famiglia di funzioni di join. Una volta che i dati sono stati elaborati, ggplot2 può visualizzarli.
Impareremo come utilizzare il pacchetto dplyr per manipolare un Cornice dati. Se R non è ancora installato, seguire le istruzioni Passaggi di configurazione di R e RStudio, quindi esegui install.packages(“dplyr”).
Unire i dati con dplyr
dplyr fornisce un modo piacevole e conveniente per combinare i set di dati. Potremmo avere molte fonti di dati di input e, a un certo punto, dobbiamo combinarle. Un join con dplyr aggiunge variabili a destra del set di dati originale.
dplyr si unisce
Di seguito sono riportati quattro importanti tipi di join utilizzati in dplyr per unire due dataset. Tutti e quattro accettano gli stessi argomenti — le due tabelle e la chiave — e differiscono solo per quali righe non corrispondenti vengono mantenute:
| Funzione | Obiettivo | argomenti | Chiavi multiple |
|---|---|---|---|
| left_join() | Unisci due set di dati. Conserva tutte le osservazioni dalla tabella di origine | x, y, by = “ID” | x, y, by = c(“ID”, “ID2”) |
| right_join() | Unisci due set di dati. Conserva tutte le osservazioni dalla tabella di destinazione | x, y, by = “ID” | x, y, by = c(“ID”, “ID2”) |
| inner_join() | Unisci due set di dati. Escludi tutte le righe non corrispondenti. | x, y, by = “ID” | x, y, by = c(“ID”, “ID2”) |
| full_join() | Unisci due set di dati. Mantieni tutte le osservazioni. | x, y, by = “ID” | x, y, by = c(“ID”, “ID2”) |
Questi quattro verbi corrispondono alle unioni SINISTRA, DESTRA, INTERNA e COMPLETA ESTERNA di SQL. R base raggiunge gli stessi risultati attraverso gli argomenti all, all.x e all.y di unire().
Esamineremo tutti i tipi di join attraverso un semplice esempio.
Innanzitutto, creiamo due dataset. La Tabella 1 contiene due variabili, ID e y, mentre la Tabella 2 raccoglie ID e z. In ogni situazione, dobbiamo avere un coppia di chiavi variabile. Nel nostro caso, l'ID è our chiave variabile. La funzione cercherà valori identici in entrambe le tabelle e assocerà i valori restituiti a destra della tabella 1. La figura seguente mostra le due tabelle affiancate.

library(dplyr)
df_primary <- tribble(
  ~ID, ~y,
   "A", 5,
   "B", 5,
   "C", 8,
   "D", 0,
  "F", 9)
df_secondary <- tribble(
  ~ID, ~z,
   "A", 30,
   "B", 21,
   "C", 22,
   "D", 25,
   "E", 29)
dplyr left_join()
Il metodo più comune per unire due dataset è utilizzare la funzione left_join(). L'immagine seguente mostra che la coppia chiave-valore corrisponde alle righe A, B, C e D, mentre E e F vengono escluse. Con left_join(), manteniamo tutte le righe della tabella originale e ignoriamo quelle che non hanno una coppia chiave-valore nella tabella di destinazione. Nel nostro esempio, il valore E non esiste nella tabella 1, quindi quella riga viene eliminata. Il valore F proviene dalla tabella di origine, quindi viene mantenuto dopo left_join() e restituisce NA nella colonna z.
Esempio di dplyr left_join()
Il diagramma seguente riproduce ciò che accade durante un left_join().

left_join(df_primary, df_secondary, by ='ID')
Produzione:
##
# A tibble: 5 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
## 5     F     9    NA
Si noti che quando entrambe le tabelle contengono una colonna con lo stesso nome, dplyr le disambigua utilizzando i suffissi .x e .y indicati sopra.
dplyr right_join()
La funzione right_join() funziona esattamente come left_join(). L'unica differenza è la riga eliminata. Il valore E, disponibile nel data frame di destinazione, esiste nella nuova tabella e assume il valore NA per la colonna y.
Esempio di dplyr right_join()
Il diagramma sottostante mostra l'immagine speculare.

right_join(df_primary, df_secondary, by = 'ID')
Produzione:
##
# A tibble: 5 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
## 5     E    NA    29
dplyr inner_join()
Quando le osservazioni non corrispondenti non sono affatto utili, possiamo restituire esclusivamente le righe che esistono in entrambi set di dati. Questa è la scelta giusta quando abbiamo bisogno di un set di dati completo e non vogliamo imputare i valori mancanti con la media o la mediana.
La funzione inner_join() viene in aiuto in questo caso. Essa esclude le righe non corrispondenti su entrambi i lati.
Esempio di dplyr inner_join()
Il diagramma seguente evidenzia i quattro ID che sopravvivono all'unione.

inner_join(df_primary, df_secondary, by ='ID')
Produzione:
##
# A tibble: 4 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
dplyr full_join()
Infine, la funzione full_join() conserva tutte le osservazioni e sostituisce i valori mancanti con NA.
Esempio di dplyr full_join()
Il diagramma seguente mostra tutti gli ID di entrambe le tabelle che sono rimasti invariati dopo l'unione.

full_join(df_primary, df_secondary, by = 'ID')
Produzione:
## # A tibble: 6 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
## 5     F     9    NA
## 6     E    NA    29
Coppie di chiavi multiple
Infine, ma non meno importante, possiamo avere più chiavi nel nostro dataset. Consideriamo il seguente dataset in cui abbiamo gli anni e un elenco di prodotti acquistati dal cliente. Lo screenshot qui sotto mostra le due tabelle e le colonne ID e anno che insieme identificano una riga.
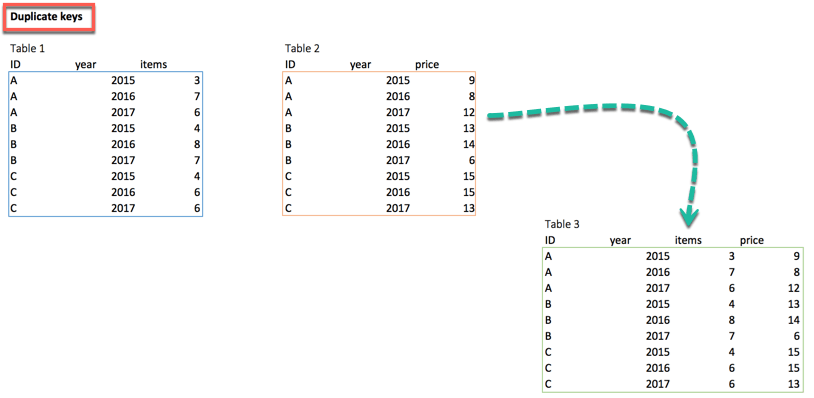
Se uniamo le due tabelle utilizzando solo l'ID, ogni anno viene abbinato a ogni altro anno e il numero di righe aumenta esponenzialmente. Per ovviare a questo problema, possiamo passare due variabili chiave-valore: ID e anno, presenti in entrambi i dataset. Possiamo utilizzare il seguente codice per unire la tabella 1 e la tabella 2:
df_primary <- tribble(
  ~ID, ~year, ~items,
  "A", 2015,3,
  "A", 2016,7,
  "A", 2017,6,
  "B", 2015,4,
  "B", 2016,8,
  "B", 2017,7,
  "C", 2015,4,
  "C", 2016,6,
  "C", 2017,6)
df_secondary <- tribble(
  ~ID, ~year, ~prices,
  "A", 2015,9,
  "A", 2016,8,
  "A", 2017,12,
  "B", 2015,13,
  "B", 2016,14,
  "B", 2017,6,
  "C", 2015,15,
  "C", 2016,15,
  "C", 2017,13)
left_join(df_primary, df_secondary, by = c('ID', 'year'))
Produzione:
## # A tibble: 9 x 4
##      ID  year items prices
##   <chr> <dbl> <dbl>  <dbl>
## 1     A  2015     3      9
## 2     A  2016     7      8
## 3     A  2017     6     12
## 4     B  2015     4     13
## 5     B  2016     8     14
## 6     B  2017     7      6
## 7     C  2015     4     15
## 8     C  2016     6     15
## 9     C  2017     6     13
Da dplyr 1.1.0 (gennaio 2023) la stessa chiave può essere scritta come join_by(ID, anno) e dplyr ora avverte di corrispondenze molti-a-molti inaspettate, come dplyr 1.1.0 si unisce all'annuncio spiega.
Funzioni di pulizia dei dati in R
L'unione risolve solo metà del problema, perché la tabella combinata deve comunque essere rimodellata. Di seguito sono riportate le quattro funzioni principali per riordinare (pulire) i dati:
| Funzione | Obiettivo | argomenti |
|---|---|---|
| raccogliere() | Trasforma i dati da larghi a lunghi | (dati, chiave, valore, na.rm = FALSE) |
| diffusione() | Trasforma i dati da lunghi a larghi | (dati, chiave, valore) |
| separato() | Dividi una variabile in due | (dati, col, in, sep = “”, rimuovi = VERO) |
| unire() | Unire due variabili in una sola | (dati, col, conc, sep = “”, rimuovi = VERO) |
Nota sulla versione: gather() e spread() sono stati sostituiti da pivot_longer() e pivot_wider() in tidyr 1.0.0, e separate() dalla famiglia separate_wider_delim() in tidyr 1.3.0. Le funzioni sostituite sono ancora in esecuzione, quindi ogni esempio seguente funziona, ma il nuovo codice dovrebbe preferire le famiglie più recenti mostrate in vignetta girevole di Tidyr. unite() rimane corrente.
Utilizziamo il pacchetto tidyr, parte della collezione tidyverse, per manipolare, pulire e visualizzare i dati. Se R è stato installato con Anaconda, il pacchetto è già disponibile da https://anaconda.org/r/r-tidyr.
Se non è già installato, immettere il seguente comando per installare tidyr:
install.packages("tidyr")
raccogliere()
L'obiettivo della funzione gather() è trasformare i dati dal formato wide al formato long.
Sintassi
gather(data, key, value, na.rm = FALSE)
Arguments:
-data: The data frame used to reshape the dataset
-key: Name of the new column created
-value: Select the columns used to fill the key column
-na.rm: Remove missing values. FALSE by default
Esempio
Di seguito, possiamo visualizzare il concetto di reshaping Da larga a lunga. Vogliamo creare una singola colonna denominata "crescita", riempita con le righe delle variabili trimestrali. La figura seguente mostra la tabella larga a sinistra e la tabella lunga rimodellata a destra.

library(tidyr)
# Create a messy dataset
messy <- data.frame(
  country = c("A", "B", "C"),
  q1_2017 = c(0.03, 0.05, 0.01),
  q2_2017 = c(0.05, 0.07, 0.02),
  q3_2017 = c(0.04, 0.05, 0.01),
  q4_2017 = c(0.03, 0.02, 0.04))
messy
Produzione:
##   country q1_2017 q2_2017 q3_2017 q4_2017
## 1       A    0.03    0.05    0.04    0.03
## 2       B    0.05    0.07    0.05    0.02
## 3       C    0.01    0.02    0.01    0.04
# Reshape the data
tidier <-messy %>%
gather(quarter, growth, q1_2017:q4_2017)
tidier
Produzione:
##    country quarter growth
## 1        A q1_2017   0.03
## 2        B q1_2017   0.05
## 3        C q1_2017   0.01
## 4        A q2_2017   0.05
## 5        B q2_2017   0.07
## 6        C q2_2017   0.02
## 7        A q3_2017   0.04
## 8        B q3_2017   0.05
## 9        C q3_2017   0.01
## 10       A q4_2017   0.03
## 11       B q4_2017   0.02
## 12       C q4_2017   0.04
Nella funzione gather(), creiamo due nuove variabili, quarter e growth, perché il nostro dataset originale ha una variabile di gruppo, country, e le coppie chiave-valore. In tidyr 1.0.0 e versioni successive, la stessa operazione di rimodellamento è scritta come pivot_longer(messy, cols = q1_2017:q4_2017, names_to = “quarter”, values_to = “growth”).
diffusione()
La funzione spread() fa l'opposto di gather().
Sintassi
spread(data, key, value)
arguments:
data: The data frame used to reshape the dataset
key: Column to reshape long to wide
value: Rows used to fill the new column
Esempio
Possiamo riportare il dataset più ordinato alla sua forma disordinata utilizzando la funzione spread().
# Reshape the data
messy_1 <- tidier %>%
  spread(quarter, growth)
messy_1
Produzione:
##   country q1_2017 q2_2017 q3_2017 q4_2017
## 1       A    0.03    0.05    0.04    0.03
## 2       B    0.05    0.07    0.05    0.02
## 3       C    0.01    0.02    0.01    0.04
L'equivalente moderno è pivot_wider(tidier, names_from = quarter, values_from = growth).
separato()
La funzione `separate()` divide una colonna in due in base a un separatore. Questa funzione è utile quando la variabile è una data. La nostra analisi potrebbe richiedere di concentrarsi su mese e anno, e in tal caso vogliamo separare la colonna in due nuove variabili.
Sintassi
separate(data, col, into, sep= "", remove = TRUE)
arguments:
-data: The data frame used to reshape the dataset
-col: The column to split
-into: The name of the new variables
-sep: Indicates the symbol used that separates the variable, i.e.:  "-", "_", "&"
-remove: Remove the old column. By default sets to TRUE.
Esempio
Possiamo dividere il trimestre dall'anno nel set di dati più ordinato applicando la funzione separate().
separate_tidier <-tidier %>%
separate(quarter, c("Qrt", "year"), sep ="_")
head(separate_tidier)
Produzione:
##   country Qrt year growth
## 1       A  q1 2017   0.03
## 2       B  q1 2017   0.05
## 3       C  q1 2017   0.01
## 4       A  q2 2017   0.05
## 5       B  q2 2017   0.07
## 6       C  q2 2017   0.02
unire()
La funzione unite() concatena due colonne in una sola.
Sintassi
unite(data, col, conc ,sep= "", remove = TRUE)
arguments:
-data: The data frame used to reshape the dataset
-col: Name of the new column
-conc: Name of the columns to concatenate
-sep: Indicates the symbol used that unites the variable, i.e:  "-", "_", "&"
-remove: Remove the old columns. By default, sets to TRUE
Esempio
Nell'esempio precedente, abbiamo separato il trimestre dall'anno. Cosa succede se vogliamo unirli? Utilizziamo il seguente codice:
unit_tidier <- separate_tidier %>%
  unite(Quarter, Qrt, year, sep ="_")
head(unit_tidier)
Produzione:
##   country Quarter growth
## 1       A q1_2017   0.03
## 2       B q1_2017   0.05
## 3       C q1_2017   0.01
## 4       A q2_2017   0.05
## 5       B q2_2017   0.07
## 6       C q2_2017   0.02
Il data frame rimodellato è ora pronto per le fasi di modellazione trattate nel resto del documento. Serie di tutorial su R.
