
Trasformazione del normalizzatore in Informatica con ESEMPIO
 David Carter
⚡ Riepilogo intelligente
La trasformazione Normalizer in Informatica è una trasformazione attiva che converte una singola riga contenente colonne ripetute in più righe, generando al contempo le colonne chiave che identificano ogni occorrenza prodotta.
Cos'è la trasformazione del normalizzatore?
Normalizer è una trasformazione attiva, utilizzata per convertire una singola riga in più righe e viceversa. È un modo intelligente per rappresentare i dati in maniera più organizzata.
Se in una singola riga sono presenti dati ripetuti in più colonne, è possibile suddividerla in più righe. A volte, infatti, i dati si ripetono in più colonne. Ad esempio:
| Nome dello studente | Punteggio della classe 9 | Punteggio della classe 10 | Punteggio della classe 11 | Punteggio della classe 12 |
| Studente 1 | 50 | 60 | 65 | 80 |
| Studente 2 | 70 | 64 | 83 | 77 |
In questo caso, la colonna del punteggio di classe si ripete in quattro colonne. Utilizzando il Normalizzatore, possiamo suddividerle nel seguente set di dati.
| Nome dello studente | Classe | Punti |
| Studente 1 | 9 | 50 |
| Studente 1 | 10 | 60 |
| Studente 1 | 11 | 65 |
| Studente 1 | 12 | 80 |
| Studente 2 | 9 | 70 |
| Studente 2 | 10 | 64 |
| Studente 2 | 11 | 83 |
| Studente 2 | 12 | 77 |
Due righe di cinque colonne sono diventate otto righe di tre colonne. Poiché il numero di righe in uscita dalla trasformazione è diverso dal numero di righe in entrata, il Normalizzatore è una trasformazione attiva e la stessa regola si applica all'esempio di vendite presentato nella sezione successiva.
Come utilizzare la trasformazione Normalizer in Informatica
I seguenti sei passaggi creano una mappaping che legge un file di testo contenente i dati trimestrali di vendita del negozio e scrive una riga con il valore obiettivo per ogni trimestre.
Passo 1) Crea la tabella di origine "sales_source" e la tabella di destinazione "sales_target" utilizzando lo script e importale Informatica.
Scarica il file Sales_Source.txt sopra
Passo 2) Crea una mappaping con origine “sales_source” e tabella di destinazione “sales_target”. La mappaping La tela del progettista contiene quindi la definizione della sorgente, la sua Qualificatore della fonte e la definizione dell'obiettivo.

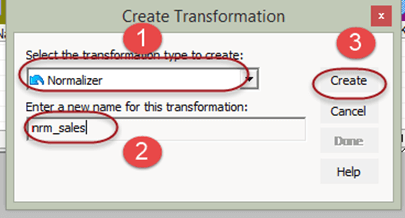
Passo 3) Dal menu Trasformazione, crea una nuova trasformazione. Nella finestra Crea trasformazione:
- Seleziona Normalizzatore come trasformazione
- Inserisci il nome, "nrm_sales"
- Seleziona l'opzione di creazione
La finestra si presenta come nello screenshot qui sotto, con l'elenco dei tipi di trasformazione a sinistra e la casella del nome in basso.
Passo 4) La trasformazione verrà creata, seleziona l'opzione "Fatto". La trasformazione nrm_sales vuota ora si trova nell'area di lavoro tra il Source Qualifier e il target.

Passo 5) Double fai clic sulla trasformazione Normalizzatore, quindi:
- Seleziona la scheda Normalizzatore
- Fai clic sull'icona per creare due colonne
- Inserisci i nomi delle colonne
- Imposta il numero di occorrenze su 4 per le vendite e 0 per il nome del negozio
- Selezionare il pulsante OK
Il valore "Occurs" è l'elemento più importante di questa scheda: indica al progettista quante volte la colonna si ripete in una riga di origine. Il nome del negozio compare una sola volta per riga, quindi il suo valore "Occurs" rimane a 0.

Durante la trasformazione verranno generate delle colonne. Vedrai 4 colonne relative alle vendite, poiché abbiamo impostato il numero di occorrenze a 4. Accanto a queste, il Designer aggiunge le porte chiave e ID colonna generate, come descritto nella sezione successiva.

Passo 6) Quindi nel carta geograficaping:
- Collega le quattro colonne del qualificatore di origine dei quattro quarti rispettivamente alle colonne del normalizzatore.
- Collega la colonna del nome del negozio alla colonna del normalizzatore
- Collega le colonne store_name e sales dal normalizzatore alla tabella di destinazione
- Collega la colonna GK_sales dal normalizzatore alla tabella di destinazione
Una volta tracciato ogni collegamento, la mappa completataping Somiglia a questo.

Salva la mappaping e eseguirlo dopo averlo creato Sessione and flusso di lavoro. Per ogni trimestre delle vendite di un negozio, verrà creata una riga separata dalla trasformazione del normalizzatore.
L'output della nostra mappaping sarà come –
| Nome del negozio | Trimestre | Sales |
| DELHI | 1 | 150 |
| DELHI | 2 | 240 |
| DELHI | 3 | 455 |
| DELHI | 4 | 100 |
| MUMBAI | 1 | 100 |
| MUMBAI | 2 | 500 |
| MUMBAI | 3 | 350 |
| MUMBAI | 4 | 340 |
I dati di origine presentavano colonne ripetute, ovvero QUARTER1, QUARTER2, QUARTER3 e QUARTER4. Con l'aiuto del Normalizzatore, abbiamo riorganizzato i dati in modo che si adattassero a un'unica colonna denominata QUARTER e, per ogni record di origine, sono stati creati quattro record nella destinazione.
In questo modo è possibile normalizzare i dati e creare più record per un'unica origine dati.
Porte e proprietà della trasformazione del normalizzatore
Le colonne non vengono mai inserite manualmente nella scheda Porte. Vengono definite nella scheda Normalizzatore e Designer crea automaticamente le porte corrispondenti. La tabella seguente spiega la funzione di ciascuna voce e di ciascuna porta generata.
| Porta o attributo | Ciò che fa |
| Si verifica | Numero di occorrenze della colonna in una riga di origine. Un valore pari a 0 indica una colonna che compare una sola volta, come ad esempio il nome del negozio. |
| Livella | Raggruppa le colonne in una gerarchia di record. Viene utilizzato per i sorgenti COBOL e rimane a 0 per una struttura piatta. |
| Porte di input | Un normalizzatore di pipeline crea una porta di input per ogni occorrenza, quindi un valore di Occurs pari a 4 produce quattro porte di input. |
| Porta di uscita | Una colonna con occorrenze multiple ha una singola porta di output che restituisce una riga per ogni occorrenza. |
| GK_ | Chiave generata. Il servizio di integrazione incrementa questo numero di sequenza ogni volta che elabora una riga di origine. |
| GCID_ | ID della colonna generato. Rappresenta l'indice dell'occorrenza, quindi una colonna che si verifica quattro volte restituisce 1, 2, 3 o 4. |
Vale la pena ricordare la differenza tra le due porte generate, perché entrambe sembrano dei contatori. GCID si riavvia da 1 per ogni riga sorgente, mentre GK continua a crescere per tutta la sessione. Nella mappa delle venditeping, GK_sales è la porta collegata al target, quindi ciascuna delle otto righe di output contiene una chiave distinta.
Nella scheda Proprietà sono presenti due impostazioni che controllano il comportamento di quel tasto tra un'esecuzione e l'altra. Rimuovi Restituisce al valore della chiave generata al termine della sessione il valore che aveva prima dell'inizio della sessione. Restart avvia la sequenza di chiavi generata da 1 ogni volta che viene eseguita la sessione, sovrascrivendo il valore della sequenza mostrato nella scheda Porte. Le definizioni complete degli attributi sono pubblicate nel Guida alla trasformazione di PowerCenter.
Normalizzatore VSAM vs Normalizzatore Pipeline
PowerCenter fornisce due versioni della stessa trasformazione e l'esempio precedente utilizza la seconda. La scelta tra le due dipende interamente dalla sorgente.
| Aspetto | Normalizzatore VSAM | Normalizzatore di pipeline |
| Ruolo nella mappaping | Funge da qualificatore di origine per una definizione di origine COBOL | Si trova in qualsiasi punto della pipeline, a valle di un normale Source Qualifier. |
| Come viene creato | Creato automaticamente quando il codice sorgente COBOL viene trascinato nella mappaping | Creato dal menu Trasformazione, come nel passaggio 3 sopra. |
| Porte di ingresso per una colonna ripetuta | Un'unica porta di ingresso per l'intera colonna con occorrenze multiple | Una porta di ingresso per ogni occorrenza della colonna |
| Modifica delle colonne | Modifica il codice sorgente COBOL e ricrea la trasformazione | È possibile modificare le colonne nella scheda Normalizzatore in qualsiasi momento. |
| Dati tipici | File mainframe che utilizzano le clausole OCCURS e REDEFINES | Ripetizione delle colonne nelle tabelle relazionali e nei file flat |
Un file COBOL può contenere anche diversi tipi di record nello stesso file fisico, motivo per cui la versione VSAM legge un copybook anziché un elenco di colonne. Per tutti i giorni ETL Per lavorare con database e file delimitati, il Normalizzatore pipeline è lo strumento ideale.
Errori comuni nella trasformazione del normalizzatore e come risolverli
La maggior parte dei problemi del normalizzatore tracTorniamo a due o tre impostazioni. L'elenco seguente comprende quelle che emergono più spesso durante lo sviluppo.
- L'elenco delle porte non corrisponde a quello di origine. Un numero di porte di input troppo basso o troppo alto indica quasi sempre che il valore di Occurs è errato. Riapri la scheda Normalizzatore e imposta Occurs sul numero esatto di colonne ripetute, quindi ricollega la mappa.ping, perché la modifica di Occurs ricostruisce le porte.
- Si verifica in un insieme di colonne che si verificano una sola volta. Assegnando al nome del negozio un valore "Occurs" maggiore di 0, si moltiplicano le righe che non dovevano ripetersi. Le colonne che si verificano una sola volta rimangono a 0.
- Non è possibile definire colonne di tipo data. La scheda Normalizzatore accetta solo colonne di tipo Stringa, Nstringa e Numero, quindi una data deve essere elaborata come stringa e convertita tramite una trasformazione Espressione prima di raggiungere la destinazione.
- Il conteggio delle righe nel registro di sessione sembra errato. La lettura di due righe di origine e la scrittura di otto righe di destinazione è un comportamento corretto per un valore di Occurs pari a 4, non un difetto. Il Normalizzatore è attivo proprio perché questi conteggi sono diversi.
- Le chiavi generate si ripetono o saltano tra un'esecuzione e l'altra. Questa è la coppia di pulsanti "Ripristina" e "Riavvia" nella scheda Proprietà. "Riavvia" riporta la sequenza a 1 per ogni sessione, cosa raramente desiderata quando la chiave si trova in una tabella di data warehouse.
- Le modifiche apportate nella scheda Porte non verranno salvate. Le porte vengono generate, non create. Ogni modifica alle colonne va inserita nella scheda Normalizzatore e, nel caso di un Normalizzatore VSAM, la modifica va inserita direttamente nel codice sorgente COBOL.
Quando diversi gruppi ripetuti devono essere divisi contemporaneamente, di solito è più pulito utilizzare un Normalizzatore per gruppo e combinare i risultati a valle piuttosto che sovraccaricare una singola trasformazione. Laddove il requisito funziona nella direzione opposta, ovvero comprimendo molte righe in una sola, Trasformazione dell'aggregatore è invece lo strumento giusto.
