
Mesterséges neurális hálózat (ANN) bemutató a TensorFlow-val
 Szerkesztőség
⚡ Okos összefoglaló
A mesterséges neurális hálózatok úgy tanulnak, hogy bemeneti adatokat küldenek át a csatlakoztatott rétegeken, az eredményt veszteségfüggvénnyel pontozzák, és a súlyokat optimalizálóval korrigálják. Ez a bemutató egyet épít TensorFlow-ban, és osztályozza a MNIST számjegyeket.
Mi az a mesterséges neurális hálózat?
An Mesterséges neurális hálózat (ANN) egy biológiai neurális hálózatok ihlette számítógépes rendszer, amely mesterséges agyakat hoz létre összekapcsolt egységek, úgynevezett mesterséges neuronok gyűjteménye alapján. Úgy tervezték, hogy az emberekhez hasonlóan elemezze és feldolgozza az információkat. A mesterséges neurális hálózat öntanuló képességekkel rendelkezik, így jobb eredményeket produkál, ahogy több adat áll rendelkezésre.
Az alábbi ábra tracegyetlen teljes áthaladást jelent egy ilyen hálózaton, a nyers bemenettől az optimalizálóig, amely korrigálja a súlyokat.

A mesterséges neurális hálózat (ANN) négy fő objektumból áll:
- Rétegek: minden tanulás a rétegekben történik. 3 réteg van: 1) Bemenet, 2) Rejtett és 3) Kimenet.
- Jellemző és címke: Bemeneti adatok a hálózatba (jellemzők) és kimenet a hálózatból (címkék)
- Veszteségfüggvény: A tanulási fázis teljesítményének becslésére használt metrika
- Optimalizáló: Javítsa a tanulást a hálózatban lévő ismeretek frissítésével
Egy neurális hálózat a bemeneti adatokat egy rétegek együttesébe helyezi. A hálózat ezután egy veszteségfüggvénnyel értékeli a teljesítményét. A veszteségfüggvény képet ad a hálózatnak arról az útról, amelyet meg kell tennie, mielőtt elsajátítja a tudást. A hálózat egy optimalizáló segítségével fejleszti ezt a tudást.
Ha megnézi a fenti ábrát, megérti a mögöttes mechanizmust.
A program bemeneti értékeket vesz, és két teljesen összekapcsolt rétegbe helyezi azokat. Képzelj el egy matematikai feladatot. Az első dolog, amit teszel, hogy elolvasod a megfelelő fejezetet a megoldásához. Ezután alkalmazod az új ismereteidet a problémára. Nagy az esélye, hogy nem fogsz túl jól teljesíteni. Ugyanez a helyzet egy hálózattal is: amikor először látja az adatokat és előrejelzést tesz, az eredmény nem fog tökéletesen megegyezni a tényleges adatokkal.
Tudásának bővítése érdekében a hálózat optimalizálót használ. Ebben a hasonlatban az optimalizáló úgy tekinthető, mint aki újraolvassa a fejezetet. Az újbóli olvasás révén új ismeretekre teszünk szert. Hasonlóképpen, a hálózat az optimalizálót használja, frissíti tudását, és teszteli az új ismereteket, hogy ellenőrizze, mennyit kell még megtanulnia. A program addig ismétli ezt a lépést, amíg a lehető legkisebb hibát nem éri el.
A matematikai feladatok analógiájában ez azt jelenti, hogy sokszor elolvasod a tankönyvi fejezetet, amíg teljesen meg nem érted a tananyagot. Még többszöri olvasás után is, ha folyamatosan hibázol, az azt jelenti, hogy elérted az aktuális anyag tudáskapacitását. Másik tankönyvet kell használnod, vagy más módszert kell kipróbálnod az eredmény javítása érdekében. Egy neurális hálózat esetében ugyanez a folyamat zajlik. Ha a hiba csökkenésének megszűnése és a veszteséggörbe ellaposodik, a jelenlegi architektúra nem tud semmi mást tanulni. A hálózatot jobban kell optimalizálni a tudás javítása érdekében.
Ez a négy objektum közvetlenül a hálózat tervezésekor konfigurált komponensekhez kapcsolódik.
Ideghálózat Architectúra
A mesterséges neurális hálózat architektúrája a következő komponensekből áll:
- Rétegek
- Aktiválási funkció
- Veszteség funkció
- Optimizer
Rétegek
Egy rétegben zajlik az összes tanulás. Egy rétegen belül tetszőleges számú neuron található, amelyek mindegyike saját súlyokkal rendelkezik. Egy tipikus neurális hálózatot gyakran sűrűn összekapcsolt rétegek (más néven teljesen összekapcsolt rétegek) dolgoznak fel. Ez azt jelenti, hogy minden bemenet a kimenethez van csatlakoztatva.
Egy tipikus neurális hálózat egy bemeneti vektort és egy skalárt vesz fel, amely a címkéket tartalmazza. A legegyszerűbb felépítés egy bináris osztályozás, amely csak két osztállyal rendelkezik: 0 és 1.
A hálózat fogad egy bemenetet, elküldi azt az összes csatlakoztatott csomópontnak, és egy aktivációs függvénnyel kiszámítja a jelet. Az alábbi számozott ábra egyetlen csomópontot bontat ki, így külön látható a súlyozott összeg és az aktiválási lépés.

A fenti ábra ezt az elképzelést ábrázolja. Az első réteg a bemeneti értékeket tartalmazza. A második réteg, az úgynevezett rejtett réteg, az előző réteg súlyozott bemenetét kapja.
- Az első csomópont a bemeneti értékek.
- A neuron bemeneti részre és aktivációs függvényre bontható. A bal rész az előző réteg összes bemenetét kapja. A jobb rész az aktivációs függvénynek átadott bemenetek összege.
- A rejtett rétegekből kiszámított kimeneti érték, amelyet predikcióhoz használnak. Osztályozás esetén ez megegyezik az osztályok számával. Regresszió esetén csak egy értéket jósolnak meg.
Aktiválási funkció
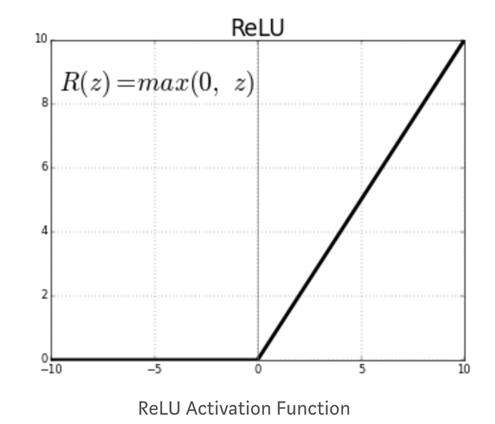
Egy csomópont aktivációs függvénye meghatározza a kimenetet egy bemeneti halmaz alapján. Egy aktivációs függvényre van szükség ahhoz, hogy a hálózat nemlineáris mintákat tanulhasson. Egy gyakori aktivációs függvény a ReLU, az egyenirányított lineáris egység. A függvény minden negatív értékre nullát ad.
A többi aktiválási funkció:
- Darabosan Lineáris
- szigmabél
- Tanh
- Szivárgó ReLU
Az alábbi ábra azt mutatja, hogy miért írható le így a ReLU: a görbe minden negatív bemenet esetén nullánál lapos, majd utána lineárisan emelkedik.
A neurális hálózat felépítése során meghozandó kritikus döntés:
- Hány réteg van a neurális hálózatban
- Hány rejtett egység minden réteghez
A sok réteggel és rejtett egységgel rendelkező neurális hálózatok képesek megtanulni az adatok összetett reprezentációját, de nagyon megdrágítják a hálózat számítását.
Veszteség funkció
Miután meghatározta a rejtett rétegeket és az aktiválási függvényt, meg kell adnia a veszteségfüggvényt és az optimalizálót.
Bináris osztályozáshoz bevett gyakorlat a bináris kereszt-entrópia veszteségfüggvény használata. lineáris regresszió, az átlagos négyzetes hibát használod.
A veszteségfüggvény fontos mérőszám az optimalizáló teljesítményének becsléséhez. A képzés során ez a mutató minimálisra csökken. Gondosan kell kiválasztania ezt a mennyiséget a probléma típusától függően.
Optimizer
A veszteségfüggvény a modell teljesítményének mértéke. Az optimalizáló segít javítani a hálózat súlyozását a veszteség csökkentése érdekében. Különböző optimalizálók állnak rendelkezésre, de a leggyakoribb a sztochasztikus gradiens csökkenés.
A hagyományos optimalizálók a következők:
- Momentum optimalizálás
- Nesterov gyorsított gradiens
- AdaGrad
- Ádám optimalizálás
ArchiA struktúra önmagában nem garantálja a használható modellt.
A neurális hálózat korlátai
A neurális hálózat korlátai a következők:
Túlfeszítés
A komplex neurális hálózatok gyakori problémája a láthatatlan adatokra való általánosítás nehézsége. Egy sok súllyal rendelkező neurális hálózat nagyon jól képes azonosítani a vonatkészlet specifikus részleteit, de ez gyakran túlillesztéshez vezet. Ha az adatok kiegyensúlyozatlanok a csoportokon belül (azaz nem áll rendelkezésre elegendő adat egyes csoportokban), a hálózat nagyon jól fog tanulni a betanítás során, de nem lesz képes az ilyen mintákat korábban soha nem látott adatokra általánosítani.
Van egy kompromisszum a gépi tanulás optimalizálás és általánosítás között.
- Egy modell optimalizálásához meg kell találni a legjobb paramétereket, amelyek minimalizálják a tanulóhalmaz veszteségét.
- Az általánosítás azonban megmondja, hogyan viselkedik a modell nem látott adatok esetén.
Annak megakadályozására, hogy a modell rögzítse a betanítási adatok specifikus részleteit vagy nem kívánt mintázatait, különböző technikákat alkalmazhat. A legjobb módszer egy kiegyensúlyozott adathalmaz elegendő mennyiségű adattal. A túlillesztésének csökkentésének művészetét regularizációnak nevezik. Az alábbi három technika a hagyományos kiindulópontok.
| Technika | Amit korlátoz | Tipikus beállítás ebben az oktatóanyagban |
|---|---|---|
| Hálózat mérete | A rétegek és a rejtett egységek száma | Két rejtett réteg, 300 és 100 egység |
| L1 / L2 súlyszabályozás | A súlyegyütthatók nagysága | l1_regularization_strength és l2_regularization_strength 0.01 |
| Kidobni | A kikapcsolt egységek aránya betanítási lépésenként | 0.3-as kiesés |
Hálózat mérete
A túl sok réteggel és rejtett egységgel rendelkező neurális hálózatokról köztudott, hogy rendkívül kifinomult. A modell bonyolultságának csökkentésének egyik egyszerű módja a méretének csökkentése. Nincs egyetlen bevált gyakorlat a rétegek számának meghatározására. Kis számú réteggel kell kezdeni, és növelni a méretet, amíg a modell túlillesztettnek nem bizonyul.
Súlyszabályozás
A túlillesztődés elkerülésének egy standard technikája a hálózat súlyaira vonatkozó korlátozások bevezetése. A korlátozás arra kényszeríti a hálózat súlyait, hogy csak kis értékeket vegyenek fel. A korlátozást a hiba veszteségfüggvényéhez adják hozzá. Kétféle regularizáció létezik:
- L1 (Lasszó): A költség arányos a súlyozási együtthatók abszolút értékével.
- L2 (gerinc): A költség arányos a súlyozási együtthatók értékének négyzetével.
Kidobni
A kiesés egy furcsa, de hasznos technika. Egy kieső hálózat azt jelenti, hogy néhány egység véletlenszerűen kikapcsol egy betanítási lépés során, így a kimenő jelük nulla lesz. Képzeljünk el egy súlyokból álló tömböt [0.1, 1.7, 0.7, -0.9]. Ha a neurális hálózatban kieső jel van, akkor az [0.1, 0, 0, -0.9] lesz, véletlenszerűen elosztott 0 értékkel. A kiesést szabályozó paraméter a kiesési arány. A ráta határozza meg, hogy hány egység kapcsoljon ki. Gyakori, hogy a ráta 0.2 és 0.5 között van.
Egy kis interaktív példa megkönnyíti a képzési ciklus megtekintését.
Példa a neurális hálózatra a TensorFlow-ban
Íme egy mesterséges neurális hálózat példája működés közben, amely bemutatja, hogyan működik egy neurális hálózat egy tipikus osztályozási problémán. Két bemenet van, x1 és x2, mindegyik véletlenszerű értékkel. A kimenet egy bináris osztály. A cél a címke osztályozása a két jellemző alapján. A feladat végrehajtásához a neurális hálózat architektúráját a következőképpen definiáljuk:
- Két rejtett réteg
- Az első réteg négy teljesen összekapcsolt neuronból áll
- A második rétegben két teljesen összekapcsolt neuron található
- Az aktiválási függvény egy ReLU.
- Adjon hozzá egy L2-szabályozást 0.003 tanulási aránnyal
A hálózat 180 epoch alatt optimalizálja a súlyokat 10-es kötegmérettel. Az alábbi ANN példaanimációban látható, hogyan változnak a súlyok az idő múlásával, és hogyan javítja a hálózat az osztályozási térképet.ping.

Először is, a hálózat véletlenszerű értékeket rendel az összes súlyhoz.
- A véletlenszerű súlyokkal, azaz optimalizálás nélkül, a kimeneti veszteség 0.453. Az alábbi kép különböző színekkel ábrázolja a hálózatot.
- Általában a narancssárga szín negatív értékeket jelöl, míg a kék színek a pozitív értékeket.
- Az adatpontok azonos ábrázolásúak: a kékek a pozitív, a narancssárga pedig a negatív címkéket jelölik.

A második rejtett rétegen belül a vonalak a súlyok előjelét követve színeződnek. A narancssárga vonalak negatív, a kékek pedig pozitív súlyokat hordoznak.
Amint látható, a kimeneti térképenping, a hálózat elég sok hibát vét. Most nézzük meg, hogyan viselkedik a hálózat optimalizálás után.
Az alábbi mesterséges neurális hálózat példájának képe az optimalizált hálózat eredményeit mutatja. Először is, észrevehetjük, hogy a hálózat sikeresen megtanulta az adatpontok osztályozását. Az előző képpel összehasonlítva a kezdeti súly -0.43 volt, míg az optimalizálás után -0.95 súlyt kapunk.

Az ötlet általánosítható több rejtett réteggel és neuronnal rendelkező hálózatokra. A beállításokkal saját maga is kísérletezhet a TensorFlow játszótér.
Az alábbi útmutató ugyanazt az ötletet építi fel kódban egy valós adathalmazon.
Neurális hálózat betanítása a TensorFlow segítségével
Íme egy lépésről lépésre bemutatott folyamat, hogyan taníthatsz be egy neurális hálózatot TensorFlow ANN az API DNNClassifier becslőjét használja.
Az MNIST adatkészletet fogjuk használni az első neurális hálózat betanításához. Neurális hálózat betanítása TensorFlow nem túl bonyolult. Az előfeldolgozási lépés pontosan ugyanúgy néz ki, mint az előző oktatóanyagokban. A következőképpen fogsz eljárni:
- Importálja az adatokat
- Alakítsa át az adatokat
- A tenzor megalkotása
- Építsd meg a modellt
- A modell képzése és értékelése
- Javítsa a modellt
Verzió megjegyzés: Az ebben a bemutatóban található kód a TensorFlow 1.x Estimator API-t célozza meg. A tf-estimator csomag végleges kiadása a TensorFlow 2.15-ös verziójával érkezett, a tf.estimator csomagot pedig eltávolították a TensorFlow 2.16-os verziójából. Ezen lépések aktuális kiadáson történő futtatásához vagy rögzítse a TensorFlow 2.15-öt, vagy építse újra ugyanazt a kétrétegű hálózatot a tf.keras.layers.Dense és a model.fit() függvénnyel.
1. lépés) Importálja az adatokat
Először is importálnia kell a szükséges könyvtárat. Az MNIST adathalmazt a következővel importálhatja: scikit elsajátítható ahogy az alábbi TensorFlow neurális hálózati példában látható.
Az MNIST adathalmaz az új technikák vagy algoritmusok tesztelésére leggyakrabban használt adathalmaz. 28×28 pixeles képek gyűjteménye, amelyek mindegyike egy 0 és 9 közötti kézzel írott számjegyet mutat. Egy rugalmas torzításokkal betanított mély konvolúciós hálózatokból álló bizottság 0.27 százalékra csökkentette a teszthibát.
import numpy as np
import tensorflow as tf
np.random.seed(1337)
Az eredeti útmutató manuálisan töltötte le az MNIST fájlokat, és a fetch_mldata erre a mappára mutatott.
from sklearn.datasets import fetch_mldata
mnist = fetch_mldata(' /Users/Thomas/Dropbox/Learning/Upwork/tuto_TF/data/mldata/MNIST original')
print(mnist.data.shape)
print(mnist.target.shape)
API-megjegyzés: Az mldata.org már nem elérhető, és a fetch_mldata függvényt eltávolították a scikit-learn 0.22-es verziójából. Jelenlegi telepítés esetén cserélje le a fenti hívást a fetch_openml('mnist_784', version=1) hívásra, amely letölti ugyanazt a 70 000 számjegyet, és elérhetővé teszi az azonos adat- és célattribútumokat.
Ezután szétválasztod az adatokat, és megkapod mindkét adathalmaz alakját.
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(mnist.data, mnist.target, test_size=0.2, random_state=42)
y_train  = y_train.astype(int)
y_test  = y_test.astype(int)
batch_size =len(X_train)

print(X_train.shape, y_train.shape,y_test.shape )
2. lépés) Alakítsa át az adatokat
Az előző oktatóanyagban megtanultad, hogy az adatokat transzformálni kell a kiugró értékek hatásának korlátozása érdekében. Ebben a Neurális Hálózatok oktatóanyagban a min-max skálázóval fogod transzformálni az adatokat. A képlet a következő:
(X-min_x)/(max_x - min_x)
A scikit-learn-nek már van egy függvénye erre: MinMaxScaler()
## resclae
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
# Train
X_train_scaled = scaler.fit_transform(X_train.astype(np.float64))
# test
X_test_scaled = scaler.fit_transform(X_test.astype(np.float64))
3. lépés) Szerkessze meg a tenzort
Most már ismered az alkotás módját tenzorok a TensorFlow-ban. A vonatkészletet numerikus oszloppá alakíthatja.
feature_columns = [tf.feature_column.numeric_column('x', shape=X_train_scaled.shape[1:])]
4. lépés) Építse meg a modellt
A neurális hálózat architektúrája két rejtett réteget tartalmaz, az első réteg 300, a második pedig 100 egységgel. Ezek az értékek inkább tapasztalatból, mint képletből származnak. Finomíthatod őket, és megfigyelheted, hogyan befolyásolják a hálózat pontosságát.
A modell felépítéséhez a DNNClassifier becslőt kell használnod. Az osztályok számát 10-re kell állítanod, mivel tíz osztály van a tanulóhalmazban. A becslő objektum szintaxisával már ismered. A feature_columns, n_classes és model_dir argumentumok pontosan megegyeznek az előző oktatóanyagban szereplőkkel. A hidden_units argumentum az új: ez szabályozza mind a rétegek számát, mind azt, hogy az egyes rétegek hány csomóponthoz csatlakoznak a neurális hálózathoz. Az alábbi kódban két rejtett réteg található, az első 300 csomópontot, a második pedig 100 csomópontot köt össze.
A becslő összeállításához használja a tf.estimator.DNNClassifier fájlt a következő paraméterekkel:
- jellemző_oszlopok: A hálózatban használandó oszlopok meghatározása
- rejtett_egységek: Határozza meg a rejtett neuronok számát
- n_osztályok: Határozza meg a jósolandó osztályok számát
- modell_könyvtár: Határozza meg az útvonalat TensorBoard
estimator = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    n_classes=10,
    model_dir = '/train/DNN')
5. lépés) Tanítsa meg és értékelje a modellt
A NumPy input függvénnyel betaníthatod és kiértékelheted a modellt.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_train_scaled},
    y=y_train,
    batch_size=50,
    shuffle=False,
    num_epochs=None)
estimator.train(input_fn = train_input,steps=1000)
eval_input = tf.estimator.inputs.numpy_input_fn(
    x={"x": X_test_scaled},
    y=y_test,
    shuffle=False,
    batch_size=X_test_scaled.shape[0],
    num_epochs=1)
estimator.evaluate(eval_input,steps=None)
output:
{'accuracy': 0.9637143,
 'average_loss': 0.12014342,
 'loss': 1682.0079,
 'global_step': 1000}
A jelenlegi architektúra nagyjából 96 százalékos pontosságot eredményez az értékelési halmazon.
6. lépés) Javítsa a modellt
Megpróbálhatja javítani a modellt regularizációs paraméterek hozzáadásával.
Itt a becslő egy Proximal AdaGrad optimalizálót használ, amelynek kiesési aránya 0.3, és mind az L1, mind az L2 erősség 0.01-re van állítva. Egy TensorFlow neurális hálózatban az optimalizálót a vonatobjektumon keresztül érjük el, amelyet az optimalizáló neve követ. A TensorFlow beépített API-t szállít a Proximal AdaGrad optimalizálóhoz.
A mély neurális hálózat regularizációjának hozzáadásához a tf.train.ProximalAdagradOptimizer függvényt használhatja a következő paraméterekkel:
- Tanulási sebesség: tanulási_ráta
- L1 regularizáció: l1_regularizációs_erősség
- L2 regularizáció: l2_regularizációs_erősség
estimator_imp = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[300, 100],
    dropout=0.3,
    n_classes = 10,
    optimizer=tf.train.ProximalAdagradOptimizer(
      learning_rate=0.01,
      l1_regularization_strength=0.01,
      l2_regularization_strength=0.01
    ),
    model_dir = '/train/DNN1')
estimator_imp.train(input_fn = train_input,steps=1000)
estimator_imp.evaluate(eval_input,steps=None)
output:
{'accuracy': 0.95057142,
 'average_loss': 0.17318928,
 'loss': 2424.6499,
 'global_step': 2000}
A túlillesztettség csökkentésére kiválasztott értékek nem javították a modell pontosságát. Az első modell pontossága 96% volt, míg az L2 regularizátorral rendelkező modellé 95%. Kipróbálhatsz különböző értékeket, és megnézheted, hogyan befolyásolják a pontosságot.
