
Gauss-kernel a gépi tanulásban: Python Kernel Methods
 Evelyn Clarke
⚡ Okos összefoglaló
A Gauss-kernel módszerek lineárisan szétválaszthatóvá teszik a nem szétválasztható adatokat anélkül, hogy valaha is fel kellene építeni a nagydimenziós jellemzőtérképet. Ez az útmutató a polinomtérképet mutatja be.ping kézzel, majd egy véletlenszerű Fourier kernel osztályozót képez ki a TensorFlow-ban.
Ennek az oktatóanyagnak az a célja, hogy egy adatkészletet lineárisan elválaszthatóvá tegyen. Az oktatóanyag két részre oszlik:
- Funkció átalakítás
- Kernel osztályozó betanítása TensorFlow-val
Az első részben megérted a gépi tanulásban használt kernel metódusok mögött rejlő ötletet, míg a második részben azt láthatod, hogyan taníthatsz be egy kernel osztályozót a következővel: TensorFlowA felnőtt adathalmazt fogod használni. Ennek az adathalmaznak a célja az 50 ezer alatti és feletti bevételek osztályozása, ismerve az egyes háztartások viselkedését.
Miért van szükség Kernel Methodsokra?
Minden osztályozó célja az osztályok helyes előrejelzése. Ehhez az adathalmaznak elválaszthatónak kell lennie. Nézzük meg az alábbi ábrát; meglehetősen egyszerűen látható, hogy a fekete vonal feletti összes pont az első osztályhoz tartozik, a többi pont pedig a második osztályhoz. Azonban rendkívül ritka, hogy egy adathalmaz ilyen egyszerű legyen. A legtöbb esetben az adatok nem elválaszthatók, és az elválasztható adatok nehézséget okoznak a naiv osztályozóknak, mint például a logisztikus regresszió.
import numpy as np
  import matplotlib.pyplot as plt
  from mpl_toolkits.mplot3d import Axes3D
  x_lin = np.array([1,2,3,4,5,6,7,8,9,10])
  y_lin = np.array([2,2,3,2,2,9,6,8,8,9])
  label_lin = np.array([0,0,0,0,0,1,1,1,1,1])

  fig = plt.figure()
  ax=fig.add_subplot(111)
  plt.scatter(x_lin, y_lin, c=label_lin, s=60)
  plt.plot([-2.5, 10], [12.5, -2.5], 'k-', lw=2)
  ax.set_xlim([-5,15])
  ax.set_ylim([-5,15])plt.show()

Az alábbi ábrán egy olyan adathalmazt ábrázolunk, amely nem lineárisan elválasztható. Ha egyenes vonalat húzunk, a pontok többsége nem a megfelelő osztályba kerül.
A probléma egyik megoldási módja az, hogy az adathalmazt egy másik jellemzőtérképre alakítjuk át. Ez azt jelenti, hogy egy függvény segítségével az adatokat egy másik síkra kell mozgatni, amely lineárisan elválasztható.
x = np.array([1,1,2,3,3,6,6,6,9,9,10,11,12,13,16,18])
y = np.array([18,13,9,6,15,11,6,3,5,2,10,5,6,1,3,1])
label = np.array([1,1,1,1,0,0,0,1,0,1,0,0,0,1,0,1])
fig = plt.figure()
plt.scatter(x, y, c=label, s=60)
plt.show()
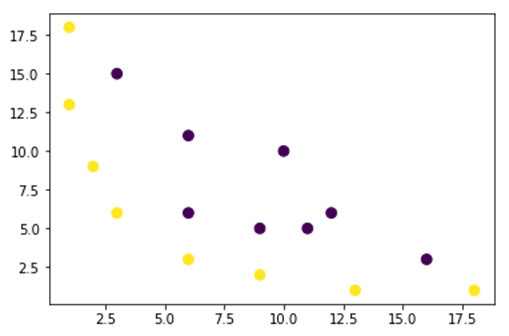
A fenti ábra adatai egy 2D-s síkban helyezkednek el, és nem választhatók szét. Megpróbálhatod ezeket az adatokat három dimenzióba transzformálni, ami azt jelenti, hogy egy 3 tengelyes ábrát hozol létre.
Gauss-kernel példánkban egy polinomleképezést fogunk alkalmazniping hogy adatainkat egy harmadik dimenzióba hozzuk. Az adatok átalakításának képlete a következő.

Függvényt a Gauss-kernelben definiál Python az új jellemzőtérképek létrehozásához.
Használhatja numpy a fenti képlet kódolásához. Az alábbi sorok mindegyike a térkép egy tagját párosítjaping a tömbkifejezéssel, amely előállítja, és a kis kép a két tényező négyzetgyökét jelöli.
| Képlet | Ekvivalens NumPy kód |
|---|---|
| x | x[:,0] |
| y | x[:,1] |
| x² | x[:,0]**2 |
 |
np.sqrt(2)* |
| xy | x[:,0]*x[:,1] |
| y² | x[:,1]**2 |
### illustration purpose
def mapping(x, y):
	x = np.c_[(x, y)]
    if len(x) >	2:
    	x_1 = x[:,0]**2
        x_2 = np.sqrt(2)*x[:,0]*x[:,1]
        x_3 = x[:,1]**2
    else:
    	x_1 = x[0]**2
        x_2 = np.sqrt(2)*x[0]*x[1]
        x_3 = x[1]**2
   trans_x = np.array([x_1, x_2, x_3])
   return trans_x
Az új térképping 3 dimenzióval és 16 ponttal rendelkezik.
x_1  = mapping(x, y)
x_1.shape
(3, 16)
Most készíts egy új diagramot 3 tengellyel, rendre x, y és z tengelyekkel.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[2], c=label, s=60)
ax.view_init(30, 185)ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')
plt.show()

Látunk egy javulást, de ha megváltoztatjuk a diagram tájolását, egyértelművé válik, hogy az adathalmaz most már elkülöníthető.
# plot
fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
ax.scatter(x_1[0], x_1[1], x_1[1], c=label, s=60)
ax.view_init(0, -180)ax.set_ylim([150,-50])
ax.set_zlim([-10000,10000])
ax.set_xlabel('X Label')
ax.set_ylabel('Y Label')
ax.set_zlabel('Z Label')plt.show()

Ha egy nagy adathalmazt kell manipulálnod és kettőnél több dimenziót kell létrehoznod, akkor a fenti módszerrel egy nagy problémába ütközöl. Valójában az összes adatpontot transzformálni kell, ami nyilvánvalóan nem fenntartható. Ez egy örökkévalóságig fog tartani, és a számítógépednek elfogyhat a memóriája.
A probléma megoldásának leggyakoribb módja a kernel használata.
Mi az a kernel a gépi tanulásban?
Az ötlet az, hogy egy magasabb dimenziós jellemzőteret használjunk, hogy az adatok szinte lineárisan elválaszthatóak legyenek, ahogy a fenti ábra is mutatja.
Számos magasabb dimenziós tér létezik, amelyek lehetővé teszik az adatpontok szétválaszthatóságát. Például megmutattuk, hogy a polinomleképezésping nagyszerű kezdés.
Azt is bemutattuk, hogy sok adat esetén ezek az átalakítások nem hatékonyak. Ehelyett a gépi tanulásban egy kernelfüggvényt használhatunk az adatok módosítására anélkül, hogy új jellemzősíkra kellene váltanunk.
A kernel varázslata abban rejlik, hogy találjon egy olyan függvényt, amely elkerüli a sokdimenziós számítással járó összes problémát. A kernel eredménye egy skalár, vagy másképp fogalmazva, visszatérünk az egydimenziós térbe.
Miután megtalálta ezt a függvényt, beillesztheti a standard lineáris osztályozóba.
Íme egy példa, amely kézzelfoghatóvá teszi a kernel gépi tanulás koncepcióját. Két vektorunk van, x1 és x2. A cél egy magasabb dimenzió létrehozása egy polinomtérkép használatával.pingA kimenet egyenlő az új jellemzőtérkép skaláris szorzatával. A fenti módszerből a következőket kell tennie:
- Alakítsa át x1-et és x2-t új dimenzióvá
- Számítsa ki a pontszorzatot: közös minden kernelre
Alakítsa át x1-et és x2-t új dimenzióvá
A magasabb dimenzió kiszámításához használhatja a fent létrehozott függvényt.
## Kernel
x1 = np.array([3,6])
x2 = np.array([10,10])

x_1 = mapping(x1, x2)
print(x_1)
teljesítmény
[[  9.         100.        ]
      [ 25.45584412 141.42135624]
      [ 36.         100.        ]]
Számítsa ki a pontszorzatot!
Használhatod az objektumpontot innen: numpy az x_1-ben tárolt első és második vektor skaláris szorzatának kiszámításához.
print(np.dot(x_1[:,0], x_1[:,1]))
8100.0
A kimenet 8100. Látod a problémát: egy új jellemzőtérképet kell tárolnod a memóriában a skaláris szorzat kiszámításához. Ha van egy több millió rekordot tartalmazó adathalmazod, akkor ez számítási szempontból hatástalan.
Ehelyett a polinom kernelt használhatjuk a skaláris szorzat kiszámításához a vektor transzformálása nélkül. Ez a függvény az x1 és x2 skaláris szorzatát számítja ki, mintha ezt a két vektort magasabb dimenzióba transzformáltuk volna. Másképp fogalmazva, egy kernelfüggvény egy másik jellemzőtérből számítja ki a skaláris szorzat eredményét.
Beírhatod a polinomiális kernelfüggvényt Python alábbiak szerint.
def polynomial_kernel(x, y, p=2):
	return (np.dot(x, y)) ** p
Ez két vektor pontszorzatának hatványa. Az alábbiakban visszaadja a polinom kernel második fokát. A kimenet megegyezik a másik módszerrel. Ez a kernel varázsa.
polynomial_kernel(x1, x2, p=2)
8100
Kernel-módszerek típusai
Sokféle kernel technika létezik. A legegyszerűbb a lineáris kernel. Ez a függvény elég jól működik szövegosztályozásra. A többi kernel a következő:
- Polinom kernel
- Gauss kernel
Az alábbi táblázat összefoglalja, hogy mit csinálnak ezek, és mikor nyúlnak hozzájuk a szakemberek.
| mag | Mit számít ki | Tipikus felhasználás |
|---|---|---|
| Lineáris | Az eredeti jellemzőtérben lévő sima skaláris szorzat | Már elkülöníthető adatok és nagy dimenziójú szöveges jellemzők |
| Polinom | A skaláris szorzat p fokra emelve, amely a jellemzők kölcsönhatásait rögzíti | Ívelt határok, amikor ismert, hogy a kölcsönhatások számítanak |
| Gauss-eloszlású (RBF) | Távolságon alapuló hasonlóság, amely nullához közelít, ahogy a pontok távolodnak egymástól. | A szokásos első választás, ha a határ alakja ismeretlen |
A TensorFlow-val végzett példában véletlenszerű Fourier-jellemzőket fogunk használni. A TensorFlow beépített becslővel rendelkezik az új jellemzőtér kiszámításához. A véletlenszerű Fourier-jellemzőleképező az alább látható Gauss-kernelfüggvény közelítése.

A Gauss-szűrő függvény kiszámítja a hasonlóságot az adatpontok között egy sokkal magasabb dimenziós térben.
Miután az elmélet tisztázódott, a bemutató további részében egy Gauss-kernelt valós adathalmazon fogunk használni.
A Gauss-kernel osztályozó képzése a TensorFlow segítségével
Az algoritmus célja az 50 ezernél többet vagy kevesebbet kereső háztartás osztályozása.
Először egy logisztikus regressziót fogsz kiértékelni egy benchmark modell létrehozásához. Ezután betanítasz egy kernel osztályozót, hogy lásd, tudsz-e jobb eredményeket elérni.
A következő változókat használja a felnőtt adatkészletből:
- kor
- munkaosztály
- fnlwgt
- szabott oktatás
- oktatási_szám
- házastársi
- foglalkozás
- kapcsolat
- verseny
- szex
- tőkenyereség
- tőke_veszteség
- óra_hét
- Szülőföld
- címke
A modell betanítása és kiértékelése előtt a következőképpen kell eljárnia:
- Importálja a könyvtárakat
- Importálja az adatokat
- Készítse elő az adatokat
- Logisztikai modell felépítése: alapmodell
- Értékelje a modellt
- A kernel osztályozó létrehozása és kiértékelése
Verzió megjegyzés: Az alábbi kódrészletek mindegyike a TensorFlow 1.x-et célozza meg. A tf.contrib névtér, amely a real_valued_column, a RandomFourierFeatureMapper és a KernelLinearClassifier értékeket biztosítja, el lett távolítva a TensorFlow 2.0-ban, magát a tf.estimator-t pedig a TensorFlow 2.16-ban. Egy jelenlegi kiadásban ugyanezt a folyamatot a tf.keras.layers.experimental.RandomFourierFeatures réteggel, majd egy Dense kimeneti réteggel, vagy a scikit-learn RBFSampler és SGDClassifier párosával kell felépíteni.
1. lépés) Importálja a könyvtárakat
Kernel modellek importálásához és betanításához Mesterséges intelligencia , importálnia kell a TensorFlow-t, pandák és NumPy.
#import numpy as np
from sklearn.model_selection
import train_test_split
import tensorflow as tf
import pandas as pd
import numpy as np
2. lépés) Importálja az adatokat
Letöltöd az adatokat a UCI felnőtt adatkészlet oldal és importálja pandas DataFrame-ként.
## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country', 'label']
PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"
PATH_test ="https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.test
"## Import
df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_test = pd.read_csv(PATH_test,skiprows = 1, skipinitialspace=True, names = COLUMNS, index_col=False)
Most, hogy a vonat és a teszthalmaz definiálva van, az oszlopcímkét karakterláncról egész számra módosíthatja. A TensorFlow nem fogad el karakterlánc értékeket címkéként.
label = {'<=50K': 0,'>50K': 1}
df_train.label = [label[item] for item in df_train.label]
label_t = {'<=50K.': 0,'>50K.': 1}
df_test.label = [label_t[item] for item in df_test.label]
df_train.shape
(32561, 15)
3. lépés) Készítse elő az adatokat
Az adathalmaz folytonos és kategorikus jellemzőket is tartalmaz. Jó gyakorlat a folytonos változók értékeinek szabványosítása. Használhatod a StandardScaler függvényt a következőből: scikit elsajátíthatóLétrehozol egy felhasználó által definiált függvényt is, hogy megkönnyítsd a vonat és a teszthalmaz konvertálását. Figyelj arra, hogy a folytonos és a kategorikus változókat egy közös adathalmazba fűzöd össze, és a tömbnek float32 típusúnak kell lennie.
COLUMNS_INT = ['age','fnlwgt','education_num','capital_gain', 'capital_loss', 'hours_week']
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']
from sklearn.preprocessing import StandardScaler
from sklearn import preprocessing

def prep_data_str(df):
	scaler = StandardScaler()
    le = preprocessing.LabelEncoder()
    df_toscale = df[COLUMNS_INT]
    df_scaled = scaler.fit_transform(df_toscale.astype(np.float64))
    X_1 = df[CATE_FEATURES].apply(le.fit_transform)
    y = df['label'].astype(np.int32)
    X_conc = np.c_[df_scaled, X_1].astype(np.float32)
    return X_conc, y
A transzformátor függvény elkészült, így konvertálhatod az adathalmazt és létrehozhatod az input_fn függvényt.
X_train, y_train = prep_data_str(df_train)
X_test, y_test = prep_data_str(df_test)
print(X_train.shape)
(32561, 14)
A következő lépésben logisztikus regressziót fog gyakorolni. Ez megadja az alapvonal pontosságát. A cél az alapvonal legyőzése egy másik algoritmussal, nevezetesen egy kernel osztályozóval.
4. lépés) Építse meg a logisztikai modellt: Alapmodell
A jellemzőoszlopot a valós_értékű_oszlop objektummal kell létrehozni. Biztosítani fogja, hogy minden változó sűrű numerikus adat legyen.
feat_column = tf.contrib.layers.real_valued_column('features', dimension=14)
A becslőt a TensorFlow Estimator API segítségével definiáljuk; megadjuk a jellemzőoszlopokat és a grafikon mentési helyét.
estimator = tf.estimator.LinearClassifier(feature_columns=[feat_column],
                                          n_classes=2,
                                          model_dir = "kernel_log"
                                         )
INFO:tensorflow:Using default config.INFO:tensorflow:Using config: {'_model_dir': 'kernel_log', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a2003f780>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
A logisztikus regressziót 200 elemből álló mini-kötegekkel fogod betanítani.
# Train the model
train_input_fn = tf.estimator.inputs.numpy_input_fn(
	x={"features": X_train},
    y=y_train,
    batch_size=200,
    num_epochs=None,
    shuffle=True)
A modellt 1,000 iterációval betaníthatod.
estimator.train(input_fn=train_input_fn, steps=1000)
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into kernel_log/model.ckpt.
INFO:tensorflow:loss = 138.62949, step = 1
INFO:tensorflow:global_step/sec: 324.16
INFO:tensorflow:loss = 87.16762, step = 101 (0.310 sec)
INFO:tensorflow:global_step/sec: 267.092
INFO:tensorflow:loss = 71.53657, step = 201 (0.376 sec)
INFO:tensorflow:global_step/sec: 292.679
INFO:tensorflow:loss = 69.56703, step = 301 (0.340 sec)
INFO:tensorflow:global_step/sec: 225.582
INFO:tensorflow:loss = 74.615875, step = 401 (0.445 sec)
INFO:tensorflow:global_step/sec: 209.975
INFO:tensorflow:loss = 76.49044, step = 501 (0.475 sec)
INFO:tensorflow:global_step/sec: 241.648
INFO:tensorflow:loss = 66.38373, step = 601 (0.419 sec)
INFO:tensorflow:global_step/sec: 305.193
INFO:tensorflow:loss = 87.93341, step = 701 (0.327 sec)
INFO:tensorflow:global_step/sec: 396.295
INFO:tensorflow:loss = 76.61518, step = 801 (0.249 sec)
INFO:tensorflow:global_step/sec: 359.857
INFO:tensorflow:loss = 78.54885, step = 901 (0.277 sec)
INFO:tensorflow:Saving checkpoints for 1000 into kernel_log/model.ckpt.
INFO:tensorflow:Loss for final step: 67.79706.


<tensorflow.python.estimator.canned.linear.LinearClassifier at 0x1a1fa3cbe0>
5. lépés) Értékelje a modellt
Definiálod a NumPy bemeneti függvényt a modell kiértékeléséhez. A teljes teszthalmazt felhasználod a kiértékeléshez.
# Evaluation
test_input_fn = tf.estimator.inputs.numpy_input_fn(
    x={"features": X_test},
    y=y_test,
    batch_size=16281,
    num_epochs=1,
    shuffle=False)
estimator.evaluate(input_fn=test_input_fn, steps=1)
INFO:tensorflow:Calling model_fn.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:22
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from kernel_log/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Evaluation [1/1]
INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:23
INFO:tensorflow:Saving dict for global step 1000: accuracy = 0.82353663, accuracy_baseline = 0.76377374, auc = 0.84898686, auc_precision_recall = 0.67214864, average_loss = 0.3877216, global_step = 1000, label/mean = 0.23622628, loss = 6312.495, precision = 0.7362797, prediction/mean = 0.21208474, recall = 0.39417577
{'accuracy': 0.82353663,
 'accuracy_baseline': 0.76377374,
 'auc': 0.84898686,
 'auc_precision_recall': 0.67214864,
 'average_loss': 0.3877216,
 'global_step': 1000,
 'label/mean': 0.23622628,
 'loss': 6312.495,
 'precision': 0.7362797,
 'prediction/mean': 0.21208474,
 'recall': 0.39417577}
82 százalékos pontossággal dolgozol. A következő részben megpróbálod felülmúlni a logisztikus osztályozót egy kernel osztályozóval.
6. lépés) Készítse el a Kernel osztályozót
A kernel becslő nem sokban különbözik a hagyományos lineáris osztályozótól, legalábbis felépítését tekintve. A mögötte álló ötlet az, hogy egy explicit kernel leképezés erejét ötvözze.ping a lineáris osztályozóval.
A Kernel osztályozó betanításához két előre meghatározott becslőre van szüksége a TensorFlow-ban:
- RandomFourierFeatureMapper
- KernelLinearClassifier
Az első részben megtanultad, hogy egy kernelfüggvény segítségével az alacsony dimenziót magas dimenzióvá kell alakítanod. Pontosabban, véletlenszerű Fourier-jellemzőket fogsz használni, amelyek közelítik a Gauss-függvényt. A TensorFlow 1.x biztosítja ezt a leképezést.ping például RandomFourierFeatureMapper, és a modell a KernelLinearClassifier becslő használatával tanítható.
A modell elkészítéséhez kövesse az alábbi lépéseket:
- Állítsa be a nagy dimenziójú Kernel funkciót
- Állítsa be az L2 hiperparamétert
- Építsd meg a modellt
- Tanítsd meg a modellt
- Értékelje a modellt
A) lépés) Nagy dimenziójú kernelfüggvény beállítása
Az aktuális adathalmaz 14 jellemzőt tartalmaz, amelyeket egy új, 5,000 dimenziós vektorrá fogsz transzformálni. A transzformációhoz véletlenszerű Fourier-jellemzőket használsz. Ha felidézed a Gauss-kernelképletet, észreveszed, hogy van egy szórásparaméter, amelyet meg kell határozni. Ez a paraméter szabályozza az osztályozás során használt hasonlósági mértéket: egy kis szórás azt eredményezi, hogy a kernel csak a nagyon közeli pontokat tekinti hasonlónak, míg egy nagy érték kisimítja a döntési határt.
A RandomFourierFeatureMapper összes paraméterét a következőkkel hangolhatja:
- input_dim = 14
- kimeneti_dim = 5000
- szórás = 4
### Prep Kernel
kernel_mapper = tf.contrib.kernel_methods.RandomFourierFeatureMapper(input_dim=14, output_dim=5000, stddev=4, name='rffm')
A kernelleképezőt a feat_column előtt létrehozott jellemzőoszlopok felhasználásával kell létrehoznia
### Map Kernel
kernel_mappers = {feat_column: [kernel_mapper]}
B. lépés) Az L2 hiperparaméter beállítása
A túlillesztés elkerülése érdekében az L2 regularizátorral bünteted a veszteségfüggvényt. Az L2 hiperparamétert 0.1-re, a tanulási rátát pedig 5-re állítod.
optimizer = tf.train.FtrlOptimizer(learning_rate=5, l2_regularization_strength=0.1)
C) lépés) A modell megépítése
A következő lépés hasonló a lineáris osztályozáshoz. A beépített KernelLinearClassifier becslőt használjuk. Fontos megjegyezni, hogy hozzá kell adni a korábban definiált kernel mappert, és módosítani kell a modell könyvtárát.
### Prep estimator
estimator_kernel = tf.contrib.kernel_methods.KernelLinearClassifier(
    n_classes=2,
    optimizer=optimizer,
    kernel_mappers=kernel_mappers,
    model_dir="kernel_train")
Az alábbi elavulási figyelmeztetések várhatóak a TensorFlow 1.x verzióján, mivel a kernel_methods modul a régebbi tf.contrib.learn becslőkre épül.
WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/kernel_methods/python/kernel_estimators.py:305: multi_class_head (from tensorflow.contrib.learn.python.learn.estimators.head) is deprecated and will be removed in a future version. Instructions for updating: Please switch to tf.contrib.estimator.*_head. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:1179: BaseEstimator.__init__ (from tensorflow.contrib.learn.python.learn.estimators.estimator) is deprecated and will be removed in a future version. Instructions for updating: Please replace uses of any Estimator from tf.contrib.learn with an Estimator from tf.estimator.* WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/estimator.py:427: RunConfig.__init__ (from tensorflow.contrib.learn.python.learn.estimators.run_config) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.RunConfig instead. INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_task_type': None, '_task_id': 0, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a200ae550>, '_master': '', '_num_ps_replicas': 0, '_num_worker_replicas': 0, '_environment': 'local', '_is_chief': True, '_evaluation_master': '', '_train_distribute': None, '_tf_config': gpu_options { per_process_gpu_memory_fraction: 1.0 } , '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_secs': 600, '_log_step_count_steps': 100, '_session_config': None, '_save_checkpoints_steps': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_model_dir': 'kernel_train'}
D. lépés) A modell betanítása
Most, hogy a kernel osztályozó felépített, készen állsz a betanítására. Úgy döntesz, hogy 2,000-szer iterálod a modellt.
### estimate
estimator_kernel.fit(input_fn=train_input_fn, steps=2000)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:From /Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/tensorflow/contrib/learn/python/learn/estimators/head.py:678: ModelFnOps.__new__ (from tensorflow.contrib.learn.python.learn.estimators.model_fn) is deprecated and will be removed in a future version. Instructions for updating: When switching to tf.estimator.Estimator, use tf.estimator.EstimatorSpec. You can use the `estimator_spec` method to create an equivalent one. INFO:tensorflow:Create CheckpointSaverHook. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Saving checkpoints for 1 into kernel_train/model.ckpt. INFO:tensorflow:loss = 0.6931474, step = 1 INFO:tensorflow:global_step/sec: 86.6365 INFO:tensorflow:loss = 0.39374447, step = 101 (1.155 sec) INFO:tensorflow:global_step/sec: 80.1986 INFO:tensorflow:loss = 0.3797774, step = 201 (1.247 sec) INFO:tensorflow:global_step/sec: 79.6376 INFO:tensorflow:loss = 0.3908726, step = 301 (1.256 sec) INFO:tensorflow:global_step/sec: 95.8442 INFO:tensorflow:loss = 0.41890752, step = 401 (1.043 sec) INFO:tensorflow:global_step/sec: 93.7799 INFO:tensorflow:loss = 0.35700393, step = 501 (1.066 sec) INFO:tensorflow:global_step/sec: 94.7071 INFO:tensorflow:loss = 0.35535482, step = 601 (1.056 sec) INFO:tensorflow:global_step/sec: 90.7402 INFO:tensorflow:loss = 0.3692882, step = 701 (1.102 sec) INFO:tensorflow:global_step/sec: 94.4924 INFO:tensorflow:loss = 0.34746957, step = 801 (1.058 sec) INFO:tensorflow:global_step/sec: 95.3472 INFO:tensorflow:loss = 0.33655524, step = 901 (1.049 sec) INFO:tensorflow:global_step/sec: 97.2928 INFO:tensorflow:loss = 0.35966292, step = 1001 (1.028 sec) INFO:tensorflow:global_step/sec: 85.6761 INFO:tensorflow:loss = 0.31254214, step = 1101 (1.167 sec) INFO:tensorflow:global_step/sec: 91.4194 INFO:tensorflow:loss = 0.33247527, step = 1201 (1.094 sec) INFO:tensorflow:global_step/sec: 82.5954 INFO:tensorflow:loss = 0.29305756, step = 1301 (1.211 sec) INFO:tensorflow:global_step/sec: 89.8748 INFO:tensorflow:loss = 0.37943482, step = 1401 (1.113 sec) INFO:tensorflow:global_step/sec: 76.9761 INFO:tensorflow:loss = 0.34204718, step = 1501 (1.300 sec) INFO:tensorflow:global_step/sec: 73.7192 INFO:tensorflow:loss = 0.34614792, step = 1601 (1.356 sec) INFO:tensorflow:global_step/sec: 83.0573 INFO:tensorflow:loss = 0.38911164, step = 1701 (1.204 sec) INFO:tensorflow:global_step/sec: 71.7029 INFO:tensorflow:loss = 0.35255936, step = 1801 (1.394 sec) INFO:tensorflow:global_step/sec: 73.2663 INFO:tensorflow:loss = 0.31130585, step = 1901 (1.365 sec) INFO:tensorflow:Saving checkpoints for 2000 into kernel_train/model.ckpt. INFO:tensorflow:Loss for final step: 0.37795097. KernelLinearClassifier(params={'head': <tensorflow.contrib.learn.python.learn.estimators.head._BinaryLogisticHead object at 0x1a2054cd30>, 'feature_columns': {_RealValuedColumn(column_name='features_MAPPED', dimension=5000, default_value=None, dtype=tf.float32, normalizer=None)}, 'optimizer': <tensorflow.python.training.ftrl.FtrlOptimizer object at 0x1a200aec18>, 'kernel_mappers': {_RealValuedColumn(column_name='features', dimension=14, default_value=None, dtype=tf.float32, normalizer=None): [<tensorflow.contrib.kernel_methods.python.mappers.random_fourier_features.RandomFourierFeatureMapper object at 0x1a200ae400>]}})
E. lépés) A modell értékelése
Végül, de nem utolsósorban értékeli modellje teljesítményét. Le kell tudnia győzni a logisztikai regressziót.
# Evaluate and report metrics.
eval_metrics = estimator_kernel.evaluate(input_fn=test_input_fn, steps=1)
WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Casting <dtype: 'int32'> labels to bool. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. WARNING:tensorflow:Trapezoidal rule is known to produce incorrect PR-AUCs; please switch to "careful_interpolation" instead. INFO:tensorflow:Starting evaluation at 2018-07-12-15:58:50 INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from kernel_train/model.ckpt-2000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. INFO:tensorflow:Evaluation [1/1] INFO:tensorflow:Finished evaluation at 2018-07-12-15:58:51 INFO:tensorflow:Saving dict for global step 2000: accuracy = 0.83975184, accuracy/baseline_label_mean = 0.23622628, accuracy/threshold_0.500000_mean = 0.83975184, auc = 0.8904007, auc_precision_recall = 0.72722375, global_step = 2000, labels/actual_label_mean = 0.23622628, labels/prediction_mean = 0.23786618, loss = 0.34277728, precision/positive_threshold_0.500000_mean = 0.73001117, recall/positive_threshold_0.500000_mean = 0.5104004
A végső pontosság 84%, ami körülbelül 1.6 százalékponttal magasabb a logisztikus regresszió alapértékénél (0.83975184 a 0.82353663-mal szemben). Kompromisszum van a pontosság javulása és a számítási költség között. Át kell gondolni, hogy ez a javulás megéri-e a nehezebb osztályozó által felhasznált időt, és hogy van-e meggyőző hatása az üzleti tevékenységére.
