
Scikit-Learn Tutorial: Hogyan telepítsünk és Scikit-Learn példák
 Evelyn Clarke
⚡ Okos összefoglaló
A Scikit-learn nyílt forráskódú Python Egy olyan könyvtár, amely egyetlen konzisztens becslőfelület mögött lefedi az előfeldolgozást, az osztályozást, a regressziót, a klaszterezést és a modellkiválasztást, így a teljes gépi tanulási munkafolyamat rövid, olvasható és reprodukálható a nyers adatoktól a pontozott predikciókig.
Mi az a Scikit-learn?
Scikit elsajátítható egy nyílt forrású Python könyvtár számára gépi tanulásTámogatja a jól bevált algoritmusokat, mint például a KNN, a gradiens boosting, a random forest és az SVM, és a következőkre épül: numpy és a SciPy. A Scikit-learn-t széles körben használják Kaggle versenyeken, valamint neves tech vállalatoknál. Lefedi az előfeldolgozást, a dimenziócsökkentést, az osztályozást, a regressziót, a klaszterezést és a modellkiválasztást.
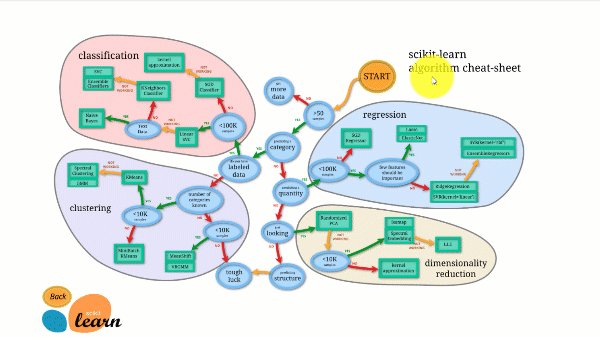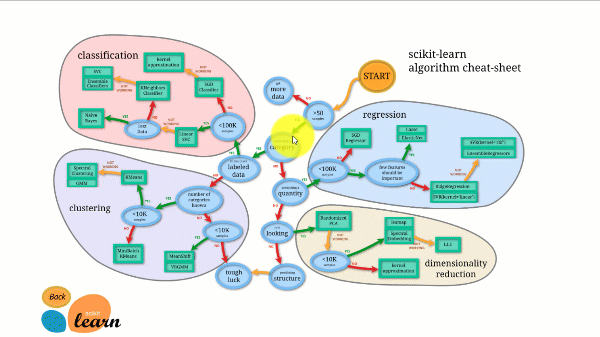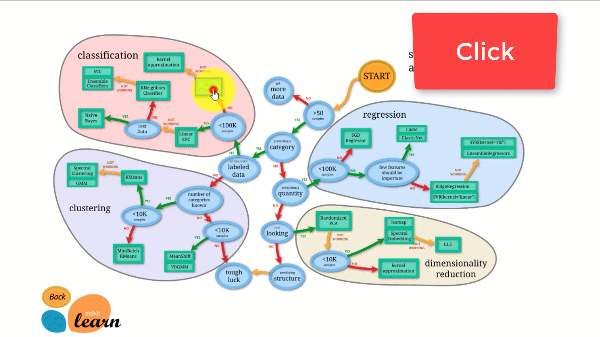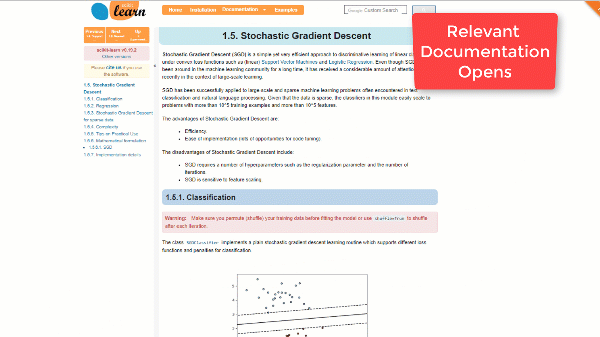
A Scikit-learn rendelkezik az egyik legjobb dokumentációval az összes nyílt forráskódú könyvtár közül. Még egy interaktív becslőtáblát is biztosít, A megfelelő becslő kiválasztása, amely végigvezet az adathalmaz méretétől a kipróbálásra érdemes algoritmusok rövid listájáig.
Az alábbi ábra a Scikit-learn működését szemlélteti.
A Scikit-learn használata nem nehézkes, és kiváló eredményeket ad. Azonban a CPU-n tanít: a munka párhuzamosan fut a magok között az n_jobs argumentummal, nem pedig GPU-n. Egy mélytanuló algoritmus futtatása lehetséges vele, de ritkán optimális, különösen akkor, ha már tudod, hogyan kell használni. TensorFlow.
A Scikit-learn letöltése és telepítése
Most ebben Python A Scikit-learn oktatóanyagban megtanulhatod, hogyan töltsd le és telepítsd a Scikit-learn-t:
1. lehetőség: AWS
A Scikit-learn használható AWS-en keresztül. Egy előre telepített scikit-learn-nel rendelkező Docker-rendszerkép teljesen megspórolja a beállítási munkát.
A fejlesztői verzió telepítéséhez futtassa az alábbi parancsot a Jupyter:
import sys
!{sys.executable} -m pip install git+git://github.com/scikit-learn/scikit-learn.git
2. lehetőség: Mac vagy Windows Anaconda segítségével
Az Anaconda telepítésével kapcsolatos további információkért lásd: Hogyan töltsd le és telepítsd a TensorFlow-t?.
Mire ez az útmutató íródott, a scikit fejlesztői kiadtak egy fejlesztői verziót, amely kijavította az akkori aktuális kiadásban található problémákat, így az alábbi lépések ezt a fejlesztői verziót használják. Egy mai friss gépen a jelenlegi stabil kiadás már tartalmazza az itt használt összes transzformátort, és pip install -U scikit-learn elég.
A scikit-learn telepítése a Conda Environment segítségével
Ha a scikit-learn csomagot a Conda környezettel telepítette, kövesse az alábbi lépéseket a 0.20-as verzióra való frissítéshez.
1. lépés) Aktiválja a tensorflow környezetet
source activate hello-tf
2. lépés) Távolítsa el a scikit-learn parancsot a conda paranccsal
conda remove scikit-learn
3. lépés) Telepítse a fejlesztői verziót
Telepítse a scikit-learn fejlesztői verzióját a szükséges kódtárakkal együtt.
conda install -c anaconda git
pip install Cython
pip install h5py
pip install git+git://github.com/scikit-learn/scikit-learn.git
JEGYZET: Windows a felhasználóknak szükségük van Microsoft Vizuális C++ 14. Megkaphatod itt .
Scikit-Learn példa gépi tanulással
Ez a Scikit oktatóanyag két részre oszlik:
- Gépi tanulás a scikit-learn segítségével
- Hogyan bízza meg modelljét a LIME-ban
Az első rész részletezi, hogyan kell felépíteni egy folyamatot, létrehozni egy modellt és hangolni a hiperparamétereket, míg a második rész a modell értelmezését tárgyalja.
1. lépés) Importálja az adatokat
Ebben a Scikit learn oktatóanyagban a felnőtt népszámlálási adatkészletet fogod használni.
A fájl közvetlenül az UCI Machine Learning Repository-ból olvasható be az alábbi kódban, így nincs szükség manuális letöltésre. Ha érdekelnek a leíró statisztikák, érdemes megnézni a Dive és az Overview eszközöket. Lásd: ez a bemutató ha többet szeretne megtudni a Merülésről és az Áttekintésről.
A pandas segítségével importálod az adathalmazt. Fontos megjegyezni, hogy a folytonos változókat lebegőpontos formátumba kell konvertálnod.
Ez az adathalmaz nyolc kategorikus változót tartalmaz, amelyek a CATE_FEATURES részben vannak felsorolva:
- munkaosztály
- szabott oktatás
- házastársi
- foglalkozás
- kapcsolat
- verseny
- szex
- Szülőföld
Ezenkívül hat folytonos változót is tartalmaz, amelyek a CONTI_FEATURES részben vannak felsorolva:
- kor
- fnlwgt
- oktatási_szám
- tőkenyereség
- tőke_veszteség
- óra_hét
A listákat itt kézzel töltjük ki, hogy világosabb képet kapj arról, mely oszlopok vannak érvényben. A kategorikus vagy folyamatos oszlopok listájának gyorsabb felépítése a következő:
## List Categorical
CATE_FEATURES = df_train.iloc[:,:-1].select_dtypes('object').columns
print(CATE_FEATURES)

## List continuous
CONTI_FEATURES =  df_train._get_numeric_data()
print(CONTI_FEATURES)
Íme az adatok importálásához szükséges kód:
# Import dataset
import pandas as pd

## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country', 'label']
### Define continuous list
CONTI_FEATURES  = ['age', 'fnlwgt','capital_gain', 'education_num', 'capital_loss', 'hours_week']
### Define categorical list
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']

## Prepare the data
features = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country']

PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"

df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_train[CONTI_FEATURES] =df_train[CONTI_FEATURES].astype('float64')
df_train.describe()
A describe() függvény meghívása a kereten visszaadja a hat folytonos oszlop összesített statisztikáját:
| kor | fnlwgt | oktatási_szám | tőkenyereség | tőke_veszteség | óra_hét | |
|---|---|---|---|---|---|---|
| számít | 32561.000000 | 3.256100e + 04 | 32561.000000 | 32561.000000 | 32561.000000 | 32561.000000 |
| jelent | 38.581647 | 1.897784e + 05 | 10.080679 | 1077.648844 | 87.303830 | 40.437456 |
| std | 13.640433 | 1.055500e + 05 | 2.572720 | 7385.292085 | 402.960219 | 12.347429 |
| perc | 17.000000 | 1.228500e + 04 | 1.000000 | 0.000000 | 0.000000 | 1.000000 |
| 25% | 28.000000 | 1.178270e + 05 | 9.000000 | 0.000000 | 0.000000 | 40.000000 |
| 50% | 37.000000 | 1.783560e + 05 | 10.000000 | 0.000000 | 0.000000 | 40.000000 |
| 75% | 48.000000 | 2.370510e + 05 | 12.000000 | 0.000000 | 0.000000 | 45.000000 |
| max | 90.000000 | 1.484705e + 06 | 16.000000 | 99999.000000 | 4356.000000 | 99.000000 |
Ellenőrizheted a native_country jellemző egyedi értékeinek számát. Csak egy háztartás származik Hollandiából. Ez a háztartás nem hoz információt, és hibát fog dobni a betanítás során.
df_train.native_country.value_counts()
United-States                 29170
Mexico                          643
?                               583
Philippines                     198
Germany                         137
Canada                          121
Puerto-Rico                     114
El-Salvador                     106
India                           100
Cuba                             95
England                          90
Jamaica                          81
South                            80
China                            75
Italy                            73
Dominican-Republic               70
Vietnam                          67
Guatemala                        64
Japan                            62
Poland                           60
Columbia                         59
Taiwan                           51
Haiti                            44
Iran                             43
Portugal                         37
Nicaragua                        34
Peru                             31
France                           29
Greece                           29
Ecuador                          28
Ireland                          24
Hong                             20
Cambodia                         19
Trinadad&Tobago                  19
Thailand                         18
Laos                             18
Yugoslavia                       16
Outlying-US(Guam-USVI-etc)       14
Honduras                         13
Hungary                          13
Scotland                         12
Holand-Netherlands                1
Name: native_country, dtype: int64
Ezt a nem informatív sort kizárhatja az adathalmazból:
## Drop Netherland, because only one row
df_train = df_train[df_train.native_country != "Holand-Netherlands"]
Ezután egy listában tárolja a folyamatos jellemzők pozícióját. Szüksége lesz rá a következő lépésben a csővezeték megépítéséhez.
Az alábbi kód végigmegy a CONTI_FEATURES összes oszlopnevén, beolvassa az egyes helyeket (azaz az oszlopszámukat), és hozzáfűzi azokat egy conti_features nevű listához.
## Get the column index of the categorical features
conti_features = []
for i in CONTI_FEATURES:
    position = df_train.columns.get_loc(i)
    conti_features.append(position)
print(conti_features)
[0, 2, 10, 4, 11, 12]
A következő blokk ugyanezt a feladatot látja el a kategorikus változókkal.
## Get the column index of the categorical features
categorical_features = []
for i in CATE_FEATURES:
    position = df_train.columns.get_loc(i)
    categorical_features.append(position)
print(categorical_features)
[1, 3, 5, 6, 7, 8, 9, 13]
Most nézzük meg magát az adathalmazt. Minden kategorikus jellemző egy karakterlánc, és egy modell nem kaphat karakterlánc értéket, ezért az adathalmazt dummy változókkal kell transzformálni.
df_train.head(5)
Valójában minden egyes funkció minden csoportjához egy oszlopra van szükséged. Először futtasd az alábbi kódot a szükséges oszlopok teljes számának kiszámításához.
print(df_train[CATE_FEATURES].nunique(),
      'There are',sum(df_train[CATE_FEATURES].nunique()), 'groups in the whole dataset')
workclass          9
education         16
marital            7
occupation        15
relationship       6
race               5
sex                2
native_country    41
dtype: int64 There are 101 groups in the whole dataset
A teljes adathalmaz 101 csoportot tartalmaz, ahogy fentebb látható. Csak a workclass jellemzőnek kilenc csoportja van. A csoportok nevét az alábbi kóddal listázhatod; a unique() függvény visszaadja az egyes kategorikus jellemzők egyedi értékeit.
for i in CATE_FEATURES:
    print(df_train[i].unique())
['State-gov' 'Self-emp-not-inc' 'Private' 'Federal-gov' 'Local-gov' '?'
 'Self-emp-inc' 'Without-pay' 'Never-worked']
['Bachelors' 'HS-grad' '11th' 'Masters' '9th' 'Some-college' 'Assoc-acdm'
 'Assoc-voc' '7th-8th' 'Doctorate' 'Prof-school' '5th-6th' '10th'
 '1st-4th' 'Preschool' '12th']
['Never-married' 'Married-civ-spouse' 'Divorced' 'Married-spouse-absent'
 'Separated' 'Married-AF-spouse' 'Widowed']
['Adm-clerical' 'Exec-managerial' 'Handlers-cleaners' 'Prof-specialty'
 'Other-service' 'Sales' 'Craft-repair' 'Transport-moving'
 'Farming-fishing' 'Machine-op-inspct' 'Tech-support' '?'
 'Protective-serv' 'Armed-Forces' 'Priv-house-serv']
['Not-in-family' 'Husband' 'Wife' 'Own-child' 'Unmarried' 'Other-relative']
['White' 'Black' 'Asian-Pac-Islander' 'Amer-Indian-Eskimo' 'Other']
['Male' 'Female']
['United-States' 'Cuba' 'Jamaica' 'India' '?' 'Mexico' 'South'
 'Puerto-Rico' 'Honduras' 'England' 'Canada' 'Germany' 'Iran'
 'Philippines' 'Italy' 'Poland' 'Columbia' 'Cambodia' 'Thailand' 'Ecuador'
 'Laos' 'Taiwan' 'Haiti' 'Portugal' 'Dominican-Republic' 'El-Salvador'
 'France' 'Guatemala' 'China' 'Japan' 'Yugoslavia' 'Peru'
 'Outlying-US(Guam-USVI-etc)' 'Scotland' 'Trinadad&Tobago' 'Greece'
 'Nicaragua' 'Vietnam' 'Hong' 'Ireland' 'Hungary']
A betanítási adatkészlet tehát 101 + 6 oszlopot fog tartalmazni: az egy-egy fontos csoportot, plusz a hat folytonos jellemzőt.
A Scikit-learn két lépésben tudja elvégezni az átalakítást:
- Alakítsa át a karakterláncot azonosítóvá. A State-gov azonosítóból 1 lesz, a Self-emp-not-inc azonosítóból 2, és így tovább. A LabelEncoder elvégzi ezt helyetted.
- Transzponálja az egyes azonosítókat egy új oszlopba. Az adathalmaz 101 csoportazonosítóval rendelkezik, így 101 oszlop rögzíti majd az összes kategorikus jellemzőcsoportot. A Scikit-learn a OneHotEncodert biztosítja ehhez a művelethez.
2. lépés) Hozza létre a vonat/tesztkészletet
Most, hogy az adathalmaz elkészült, oszd fel 80/20 arányban: 80 százalék a betanítóhalmazhoz és 20 százalék a teszthalmazhoz.
Használhatod a train_test_split függvényt. Az első argumentum a funkciók adatkerete, a második pedig a címke. A tesztkészlet méretét a test_size paraméterrel állíthatod be.
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(df_train[features],
                                                    df_train.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train.head(5)
print(X_train.shape, X_test.shape)
(26048, 14) (6512, 14)
3. lépés) Építse meg a csővezetéket
A folyamat megkönnyíti a modell konzisztens adatokkal való ellátását. Az ötlet az, hogy a nyers adatokat egyetlen objektumon keresztül juttassák el, amely minden műveletet sorban végrehajt.
Ezzel az adathalmazzal szabványosítani kell a folytonos változókat, és konvertálni a kategorikus változókat. Bármely művelet elvégezhető egy folyamatban: a hiányzó értékek helyettesíthetők az átlaggal vagy a mediánnal, és új változók hozhatók létre.
Választhatsz: fixen kódolod a két folyamatot, vagy egy pipeline-t építesz. A fix kódolás szivárogtathatja a tesztadatokat az illesztett statisztikákba, és idővel inkonzisztenciákat okozhat, ezért a pipeline a jobb megoldás.
from sklearn.preprocessing import StandardScaler, OneHotEncoder, LabelEncoder
from sklearn.compose import ColumnTransformer, make_column_transformer
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LogisticRegression
A folyamat két műveletet hajt végre a logisztikai osztályozó feltöltése előtt:
- Standardizálja a változót: StandardScaler()
- Konvertálja a kategorikus jellemzőket: OneHotEncoder(sparse=False)
Mindkét lépést a make_column_transformer függvénnyel kell végrehajtani. Amikor ezt a bemutatót írták, a függvény még nem volt benne a scikit-learn kiadott verziójában (0.19), ezért a fejlesztői buildet használták; ez minden stabil kiadásban megtalálható a 0.20 óta.
A make_column_transformer függvény használata egyszerű: deklarálod, hogy mely oszlopokat kell átalakítani, és melyik transzformációt kell alkalmazni. A folytonos jellemzők átadásához szabványosítanod kell:
- conti_features, StandardScaler() a make_column_transformer belsejében
- conti_features: a folyamatos oszlopok listája
- StandardScaler: szabványosítja ezeket az oszlopokat
A make_column_transformer függvényen belüli OneHotEncoder objektum automatikusan kódolja a címkéket.
preprocess = make_column_transformer(
    (conti_features, StandardScaler()),
    ### Need to be numeric not string to specify columns name
    (categorical_features, OneHotEncoder(sparse=False))
)
Verzió megjegyzés: A fenti blokkban két argumentum továbblépett. A jelenlegi kiadások először a transzformátort, majd csak másodszor az oszlopokat várják, és ritka átnevezték ritka_kimenet a scikit-learn 1.2-ben és eltávolítva az 1.4-ben, így az újabb kód így szól OneHotEncoder(sparse_output=False).
A pipeline működését a fit_transform függvénnyel tesztelheted. A kimenetnek 26048, 107 alakúnak kell lennie.
preprocess.fit_transform(X_train).shape
(26048, 107)
Az adattranszformátor készen áll. A pipeline-t a make_pipeline paranccsal hozod létre, és miután az adatok transzformálódtak, betáplálod a logisztikus regressziót.
model = make_pipeline(
    preprocess,
    LogisticRegression())
Egy modell betanítása a scikit-learn segítségével ezután triviális: hívjuk meg az fit metódust a folyamaton. A pontosságot a score metódussal nyomtathatjuk ki.
model.fit(X_train, y_train)
print("logistic regression score: %f" % model.score(X_test, y_test))
logistic regression score: 0.850891
Végül a predict_proba függvénnyel megjósolhatod az osztályokat, amely visszaadja az egyes osztályok valószínűségét. Figyeld meg, hogy a két valószínűség összege eggyel egyenlő.
model.predict_proba(X_test)
array([[0.83576663, 0.16423337],
       [0.94582765, 0.05417235],
       [0.64760587, 0.35239413],
       ...,
       [0.99639252, 0.00360748],
       [0.02072181, 0.97927819],
       [0.56781353, 0.43218647]])
4. lépés) Csővezetékünk használata rácskeresésben
A hiperparaméterek, a modell szerkezetét rögzítő értékek finomhangolása unalmas és kimerítő lehet.
A modell értékelésének egyik módja az lenne, hogy megváltoztatjuk a tanulóhalmaz méretét és mérjük a teljesítményt, a gyakorlatot tízszer megismételve, hogy lássuk az eredmény eloszlását. Ez sok manuális munkát igényel.
Ehelyett a scikit-learn olyan függvényeket biztosít, amelyek elvégzik a paraméterek finomhangolását és a keresztellenőrzést.
Keresztellenőrzés
A keresztvalidáció azt jelenti, hogy a betanítás során a tanulóhalmazt n-szer osztják fel hajtogatási csoportra, és a modellt n-szer kiértékelik. Ha a cv értéke 10, akkor a modellt tízszer tanítják és értékelik ki. Minden körben az osztályozó kilenc véletlenszerűen kiválasztott hajtogatási csoporton tanul, és a tizedik hajtogatást tartják meg kiértékelésre.
Rács keresés
Minden osztályozóhoz tartoznak a hangolandó hiperparaméterek. Kipróbálhatja az értékeket egyenként, vagy beállíthat egy paraméterrácsot. A scikit-learn dokumentációja felsorolja az összes paramétert, amelyet a logisztikai osztályozó elfogad. A gyors betanítás érdekében ez a példa csak a C paramétert hangolja, amely a regularizálást vezérli. Ennek pozitívnak kell lennie, és egy kis érték nagyobb súlyt ad a regularizátornak.
A GridSearchCV objektumot használod, amely a hangolandó hiperparaméterek szótárát veszi igénybe. Sorold fel az egyes hiperparamétereket, majd a kipróbálni kívánt értékeket. A C hangolásához a következőt írod:
- 'logisticregression__C': [0.001, 0.01, 0.1, 1.0] — a paraméter neve előtt az osztályozó neve kisbetűvel, majd két aláhúzásjel szerepel.
A modell négy különböző értéket fog kipróbálni: 0.001, 0.01, 0.1 és 1. 10 hajtogatással van betanítva, azaz cv=10.
from sklearn.model_selection import GridSearchCV
# Construct the parameter grid
param_grid = {
    'logisticregression__C': [0.001, 0.01,0.1, 1.0],
    }
Most már a GridSearchCV használatával betaníthatja a modellt a grid és a cv paraméterekkel.
# Train the model
grid_clf = GridSearchCV(model,
                        param_grid,
                        cv=10,
                        iid=False)
grid_clf.fit(X_train, y_train)
output:
GridSearchCV(cv=10, error_score='raise-deprecating',
       estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...ty='l2', random_state=None, solver='liblinear', tol=0.0001,
          verbose=0, warm_start=False))]),
       fit_params=None, iid=False, n_jobs=1,
       param_grid={'logisticregression__C': [0.001, 0.01, 0.1, 1.0]},
       pre_dispatch='2*n_jobs', refit=True, return_train_score='warn',
       scoring=None, verbose=0)
Verzió megjegyzés: a iid Az ebben a kimenetben látható argumentum elavult a scikit-learn 0.22-es verziójában, és eltávolításra került a 0.24-es verzióban, így egyszerűen el kell hagyni a GridSearchCV hívásból a jelenlegi kiadásokban.
A legjobb paraméterek eléréséhez a best_params_ paramétert kell használni.
grid_clf.best_params_
output:
{'logisticregression__C': 1.0}
Miután a modellt négy különböző regularizációs értékkel betanítottuk, az optimális paraméter a következőt adja:
print("best logistic regression from grid search: %f" % grid_clf.best_estimator_.score(X_test, y_test))
legjobb logisztikai regresszió a rácskeresésből: 0.850891
Az előrejelzett valószínűségek eléréséhez:
grid_clf.best_estimator_.predict_proba(X_test)
array([[0.83576677, 0.16423323],
       [0.9458291 , 0.0541709 ],
       [0.64760416, 0.35239584],
       ...,
       [0.99639224, 0.00360776],
       [0.02072033, 0.97927967],
       [0.56782222, 0.43217778]])
XGBoost modell scikit-learn funkcióval
Most próbáld ki a piacon kapható egyik legerősebb osztályozót. Az XGBoost egy színátmenet-növelő továbbfejlesztés a véletlenszerű erdőn. Elméleti háttere kívül esik ezen a tanulmányon. Python Scikit oktatóanyag, de ne feledd, hogy az XGBoost számos Kaggle versenyt megnyert. Egy átlagos méretű adathalmazon olyan jól, vagy jobban is teljesíthet, mint egy mélytanuló algoritmus.
Az osztályozó betanítása nehézkes, mivel nagyszámú paramétert tesz elérhetővé. Természetesen a GridSearchCV segítségével kiválaszthatod őket helyetted.
Jobb megoldás itt a RandomizedSearchCV. A GridSearchCV lelassul, ha a rács nagy, mivel a keresési tér minden hozzáadott paraméterrel növekszik. A RandomizedSearchCV ehelyett minden iterációban véletlenszerűen mintát vesz az egyes hiperparaméterek értékeiből, így 1,000 iteráció 1,000 kombinációt értékel ki. Egyébként nagyon hasonlóan működik, mint a GridSearchCV.
Importálnod kell az xgboost könyvtárat. Ha a könyvtár nincs telepítve, futtasd a pip3 install xgboost parancsot, vagy telepítsd egy könyvtárból. Jupyter jegyzetfüzet a következőkkel:
use import sys
!{sys.executable} -m pip install xgboost
Ezután importáljuk az osztályozót és a két keresési segédletet:
import xgboost
from sklearn.model_selection import RandomizedSearchCV
from sklearn.model_selection import StratifiedKFold
A következő lépés ebben a Scikitben Python az oktatóanyag célja a hangolandó paraméterek megadása. A hivatalos XGBoost dokumentáció mindet felsorolja. Ennek érdekében Python Az Sklearn oktatóanyagban csak két hiperparamétert választasz, mindegyikhez két értékkel, mert az XGBoost betanítása sokáig tart, és minden extra rácspont növeli a várakozási időt.
params = {
        'xgbclassifier__gamma': [0.5, 1],
        'xgbclassifier__max_depth': [3, 4]
        }
Ezután egy új folyamatot építesz az XGBoost osztályozóval és 600 becslővel. Az n_estimators önmagában is hangolható, és a magas érték túlillesztéshez vezethet. Kipróbálhatsz más értékeket is, de vedd figyelembe, hogy ez órákig is eltarthat. Minden más paraméter megtartja az alapértelmezett értéket.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1)
)
A keresztvalidációt a Stratified K-Folds keresztvalidátorral javíthatod. Itt csak három hajtogatást használunk a számítás felgyorsítása érdekében, némi minőségi veszteséggel; a jobb eredmények érdekében növeld ezt 5-re vagy 10-re a saját gépeden. A modell négy iteráción keresztül van betanítva.
skf = StratifiedKFold(n_splits=3,
                      shuffle = True,
                      random_state = 1001)

random_search = RandomizedSearchCV(model_xgb,
                                   param_distributions=params,
                                   n_iter=4,
                                   scoring='accuracy',
                                   n_jobs=4,
                                   cv=skf.split(X_train, y_train),
                                   verbose=3,
                                   random_state=1001)
A véletlenszerű keresés készen áll, így betaníthatja a modellt.
#grid_xgb = GridSearchCV(model_xgb, params, cv=10, iid=False)
random_search.fit(X_train, y_train)
Fitting 3 folds for each of 4 candidates, totalling 12 fits
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8759645283888057, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8729701715996775, total= 1.0min
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8706519235199263, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8735460094437406, total= 1.3min
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8722791661868018, total=  57.7s
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8753886905447426, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8697304768486523, total= 1.3min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8740066797189912, total= 1.4min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8707671043538355, total= 1.0min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8729701715996775, total= 1.2min
[Parallel(n_jobs=4)]: Done  10 out of  12 | elapsed:  3.6min remaining:   43.5s
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8736611770125533, total= 1.2min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8692697535130154, total= 1.2min
[Parallel(n_jobs=4)]: Done  12 out of  12 | elapsed:  3.6min finished
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/model_selection/_search.py:737: DeprecationWarning: The default of the `iid` parameter will change from True to False in version 0.22 and will be removed in 0.24. This will change numeric results when test-set sizes are unequal. DeprecationWarning)
RandomizedSearchCV(cv=<generator object _BaseKFold.split at 0x1101eb830>,
          error_score='raise-deprecating',
          estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))]),
          fit_params=None, iid='warn', n_iter=4, n_jobs=4,
          param_distributions={'xgbclassifier__gamma': [0.5, 1], 'xgbclassifier__max_depth': [3, 4]},
          pre_dispatch='2*n_jobs', random_state=1001, refit=True,
          return_train_score='warn', scoring='accuracy', verbose=3)
Amint látható, az XGBoost jobban teljesít, mint a korábbi logisztikus regresszió.
print("Best parameter", random_search.best_params_)
print("best logistic regression from grid search: %f" % random_search.best_estimator_.score(X_test, y_test))
Best parameter {'xgbclassifier__max_depth': 3, 'xgbclassifier__gamma': 0.5}
best logistic regression from grid search: 0.873157
random_search.best_estimator_.predict(X_test)
array(['<=50K', '<=50K', '<=50K', ..., '<=50K', '>50K', '<=50K'], dtype=object)
Hozzon létre DNN-t az MLPClassifier segítségével a scikit-learnben
Végül, magával a scikit-learn metódussal is betaníthatsz egy neurális hálózatot. A metódus ugyanaz, mint bármely más osztályozó esetében, a becslő pedig az MLPClassifier.
from sklearn.neural_network import MLPClassifier
Az alábbi hálózatot a következőképpen definiáljuk:
- Ádám megoldó
- ReLU aktiválási funkció
- Alfa = 0.0001
- 150 darabos tételméret
- Két rejtett réteg 200, illetve 100 neuronnal
model_dnn = make_pipeline(
    preprocess,
    MLPClassifier(solver='adam',
                  alpha=0.0001,
                  activation='relu',
                    batch_size=150,
                    hidden_layer_sizes=(200, 100),
                    random_state=1))
A rétegek számának módosításával javíthatja a modell minőségét.
model_dnn.fit(X_train, y_train)
  print("DNN regression score: %f" % model_dnn.score(X_test, y_test))
DNN regressziós pontszám: 0.821253
LIME: Bízzon modelljében
Most, hogy van egy jó modelled, szükséged van egy módszerre, amellyel megbízhatsz benne. A gépi tanulási algoritmusokat, különösen a véletlenszerű erdőket és a neurális hálózatokat, fekete doboz modelleknek nevezik: működnek, de senki sem látja, miért.
Három kutató épített egy eszközt, amely megmutatja, hogyan jut el a számítógép egy predikcióhoz. A tanulmányuk a következő: „Miért bízzak benned?”, és az általuk közzétett algoritmust Lokálisan Értelmezhető Modell-Agnosztikus Magyarázatoknak (LIME) nevezik.
Vegyünk egy példát. Néha nem tudjuk biztosan, hogy egy gépi tanuláson alapuló jóslat megbízható-e. Egy orvos nem fogadhat el egy diagnózist pusztán azért, mert egy számítógép állította elő, és tudnunk kell, hogy egy modell megbízható-e, mielőtt bevezetnénk a gyártásba.
Képzeljük el, hogy láthatjuk, miért adott egy osztályozó egy predikciót, még olyan bonyolult modellek esetén is, mint a neurális hálózatok, a véletlenszerű erdők vagy a tetszőleges kernellel rendelkező SVM-ek. Sokkal könnyebb megbízni egy predikcióban, ha láthatóak a mögötte álló okok, és ugyanilyen könnyebb eldönteni, hogy mikor nem szabad megbízni egy modellben. A LIME megmondja, hogy mely jellemzők befolyásolták az osztályozó döntését.
Adatok előkészítése
Van néhány dolog, amit meg kell változtatnod a LIME futtatásához PythonElőször telepítsd a lime-ot a terminálban a pip install lime paranccsal.
A Lime egy LimeTabularExplainer objektumot használ a modell lokális közelítéséhez. Ehhez az objektumhoz a következők szükségesek:
- egy adathalmaz numpy formátum
- A jellemzők neve: feature_names
- Az osztályok neve: class_names
- A kategorikus jellemzők oszlopának indexe: categorical_features
- Az egyes kategorikus jellemzők csoportjának neve: categorical_names
Hozza létre a NumPy vonatkészletet
A df_train fájlt nagyon könnyen másolhatod és konvertálhatod pandából NumPy-ba.
df_train.head(5)
# Create numpy data
df_lime = df_train
df_lime.head(3)
Szerezd meg az osztály nevét
A címke a unique() függvénnyel érhető el. A következőt kell látnia:
- „<=50 ezer”
- ">50K"
# Get the class name
class_names = df_lime.label.unique()
class_names
array(['<=50K', '>50K'], dtype=object)
A kategorikus jellemzőoszlopok indexelése
Használd a korábban tanult módszert az egyes csoportok nevének lekéréséhez. A címkét LabelEncoderrel kódolod, és a műveletet minden kategorikus jellemzőn megismételed.
##
import sklearn.preprocessing as preprocessing
categorical_names = {}
for feature in CATE_FEATURES:
    le = preprocessing.LabelEncoder()
    le.fit(df_lime[feature])
    df_lime[feature] = le.transform(df_lime[feature])
    categorical_names[feature] = le.classes_
print(categorical_names)
{'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}

df_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
label              object
dtype: object
Most, hogy az adathalmaz elkészült, létrehozhatja az alábbi Scikit tanulási példákban bemutatott különböző adathalmazokat. Az adatokat itt a folyamaton kívül alakítjuk át, hogy elkerüljük a LIME-mal kapcsolatos hibákat: a LimeTabularExplainernek átadott betanító halmaznak egy karakterláncok nélküli NumPy tömbnek kell lennie, és a fenti metódus már létrehozott egyet.
from sklearn.model_selection import train_test_split
X_train_lime, X_test_lime, y_train_lime, y_test_lime = train_test_split(df_lime[features],
                                                    df_lime.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train_lime.head(5)
A pipeline-t az XGBoost által talált optimális paraméterekkel készítheted el.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(max_depth = 3,
                          gamma = 0.5,
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1))

model_xgb.fit(X_train_lime, y_train_lime)
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/preprocessing/_encoders.py:351: FutureWarning: The handling of integer data will change in version 0.22. Currently, the categories are determined based on the range [0, max(values)], while in the future they will be determined based on the unique values.
If you want the future behavior and silence this warning, you can specify "categories='auto'."In case you used a LabelEncoder before this OneHotEncoder to convert the categories to integers, then you can now use the OneHotEncoder directly.
  warnings.warn(msg, FutureWarning)
Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))])
Figyelmeztetést kapsz. Ez elmagyarázza, hogy nem kell címkekódolót létrehoznod a folyamat előtt. Ha nem használsz LIME-ot, akkor a Scikit-learn gépi tanulásról szóló útmutató első részében leírt metódus rendben van. Egyébként tartsd meg ezt a megközelítést: először hozz létre egy kódolt adathalmazt, majd alkalmazd az egyszer használatos kódolót a folyamaton belül.
print("best logistic regression from grid search: %f" % model_xgb.score(X_test_lime, y_test_lime))
best logistic regression from grid search: 0.873157
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
Mielőtt a LIME-ot működésbe hoznád, hozz létre egy NumPy tömböt, amely a helytelenül osztályozott sorok jellemzőit tartalmazza. Ezt a listát később felhasználhatod annak megértéséhez, hogy mi vezette félre az osztályozót.
temp = pd.concat([X_test_lime, y_test_lime], axis= 1)
temp['predicted'] = model_xgb.predict(X_test_lime)
temp['wrong']=  temp['label'] != temp['predicted']
temp = temp.query('wrong==True').drop('wrong', axis=1)
temp= temp.sort_values(by=['label'])
temp.shape
(826, 16)
Ezután létrehozol egy lambda függvényt, amely kiolvassa az új adatokra vonatkozó predikciót a modellből. Hamarosan szükséged lesz rá.
predict_fn = lambda x: model_xgb.predict_proba(x).astype(float)
X_test_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
dtype: object
predict_fn(X_test_lime)
array([[7.96461046e-01, 2.03538969e-01],
       [9.51730132e-01, 4.82698716e-02],
       [7.93448269e-01, 2.06551731e-01],
       ...,
       [9.90314305e-01, 9.68566816e-03],
       [6.45816326e-04, 9.99354184e-01],
       [9.71042812e-01, 2.89571714e-02]])
A pandas dataframe-et NumPy tömbbé alakítod.
X_train_lime = X_train_lime.values
X_test_lime = X_test_lime.values
X_test_lime
array([[4.00000e+01, 5.00000e+00, 1.93524e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.70000e+01, 4.00000e+00, 2.16481e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.50000e+01, 4.00000e+00, 2.56263e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       ...,
       [2.80000e+01, 6.00000e+00, 2.11032e+05, ..., 0.00000e+00,
        4.00000e+01, 2.50000e+01],
       [4.40000e+01, 4.00000e+00, 1.67005e+05, ..., 0.00000e+00,
        6.00000e+01, 3.80000e+01],
       [5.30000e+01, 4.00000e+00, 2.57940e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01]])
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
print(features,
      class_names,
      categorical_features,
      categorical_names)
['age', 'workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country'] ['<=50K' '>50K'] [1, 3, 5, 6, 7, 8, 9, 13] {'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}
import lime
import lime.lime_tabular
### Train should be label encoded not one hot encoded
explainer = lime.lime_tabular.LimeTabularExplainer(X_train_lime ,
                                                   feature_names = features,
                                                   class_names=class_names,
                                                   categorical_features=categorical_features,
                                                   categorical_names=categorical_names,
                                                   kernel_width=3)
Most válassz ki egy véletlenszerű háztartást a teszthalmazból, és nézd meg mind a jóslatot, mind azt, hogy a számítógép hogyan jutott el hozzá.
import numpy as np
np.random.seed(1)
i = 100
print(y_test_lime.iloc[i])
>50K
X_test_lime[i]
array([4.20000e+01, 4.00000e+00, 1.76286e+05, 7.00000e+00, 1.20000e+01,
       2.00000e+00, 4.00000e+00, 0.00000e+00, 4.00000e+00, 1.00000e+00,
       0.00000e+00, 0.00000e+00, 4.00000e+01, 3.80000e+01])
A magyarázó elemet az explain_instance függvénnyel együtt használhatod a modell mögötti érvelés vizsgálatához. Az általa megjelenített diagram alább látható.
exp = explainer.explain_instance(X_test_lime[i], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

Az osztályozó helyesen jósolta meg a háztartást: a jövedelem valóban meghaladja az 50 ezer dollárt.
Az első dolog, amit meg kell jegyezni, hogy az osztályozó nem túl biztos önmagában. 64%-os valószínűséggel jósolja meg az 50 ezer dollár feletti jövedelmet, és ezt a 64%-ot a tőkenyereség és a családi állapot határozza meg. A kék szín negatívan járul hozzá a pozitív osztályhoz, a narancssárga vonal pedig pozitívan.
Az osztályozó habozik, mivel ennek a háztartásnak a tőkenyeresége nulla, miközben a tőkenyereség általában jó előrejelzője a vagyonnak. A háztartás emellett heti 40 óránál kevesebbet dolgozik. Az életkor, a foglalkozás és a nem mind pozitívan járul hozzá.
Ha a családi állapot egyedülálló lenne, az osztályozó 50 ezer alatti jövedelmet jósolt volna (0.64 – 0.18 = 0.46).
Most próbálj meg egy másik háztartást, olyat, amelyet rosszul osztályoztak. A hozzá tartozó magyarázó táblázat a kódot követi.
temp.head(3)
temp.iloc[1,:-2]
age                  58
workclass             4
fnlwgt            68624
education            11
education_num         9
marital               2
occupation            4
relationship          0
race                  4
sex                   1
capital_gain          0
capital_loss          0
hours_week           45
native_country       38
Name: 20931, dtype: object
i = 1
print('This observation is', temp.iloc[i,-2:])
This observation is label        <=50K
predicted     >50K
Name: 20931, dtype: object
exp = explainer.explain_instance(temp.iloc[1,:-2], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

Az osztályozó 50 ezer alatti jövedelmet jósolt, ami téves. Ez a háztartás szokatlan: sem tőkenyereség, sem tőkeveszteség nem történt, a személy elvált, közel 60 éves és iskolázott, azaz az education_num > 12. Az általános mintát követve az osztályozó 50 ezer alá sorolta a háztartást.
Játssz a LIME-mal, és rengeteg durva hibát fogsz észrevenni az osztályozóban. A könyvtár szerzőjének GitHub repójában további dokumentáció található a kép- és szövegosztályozáshoz.
Scikit-learn parancsreferencia
Az alábbiakban a scikit-learn 0.20-as és újabb verzióira vonatkozó hasznos parancsok listája található.
| Feladat | Függvény vagy osztály |
|---|---|
| A vonat/teszt adatkészlet létrehozása | train_test_split |
| Építs csővezetéket | |
| Jelölje ki az oszlopokat, és alkalmazza az átalakítást | oszloptranszformátor készítése |
| Az átalakítás típusa | |
| Szabványosítás | StandardScaler |
| Min-max skálázás | MinMaxScaler |
| Normalizálni | Normalizáló |
| Hiányzó értékek pótlása | SimpleIputer |
| Átalakítás kategorikus | OneHotEncoder |
| Illessze és alakítsa át az adatokat | fit_transform |
| Készítse el a csővezetéket | make_pipeline |
| Alapmodell | |
| Logisztikus regresszió | Logisztikus regresszió |
| XGBoost | XGBClassifier |
| Neurális háló | MLPC-osztályozó |
| Rács keresés | GridSearchCV |
| Véletlenszerű keresés | Véletlenszerű keresés CV |
