
GLM في R: النموذج الخطي المعمم والانحدار اللوجستي
 فريق التحرير
⚡ ملخص ذكي
يُوسّع النموذج الخطي المعمم (GLM) في لغة البرمجة R نطاق الانحدار الخطي العادي ليشمل النتائج الثنائية، أو القائمة على العد، أو غير الطبيعية. يشرح هذا الدليل كيفية بناء نموذج GLM لوجستي على مجموعة بيانات دخل البالغين، وتقييمه باستخدام معايير الدقة، والضبط، والاستدعاء، ومنحنى ROC.
ما هو النموذج الخطي المعمم (GLM) في لغة البرمجة R؟
A النموذج الخطي المعمم (GLM) يوسّع هذا النموذج الانحدار الخطي العادي بحيث يمكن أن يتبع المتغير التابع توزيعًا مختلفًا عن التوزيع الطبيعي. R، يمكنك تركيب واحد مزود بخاصية مدمجة جي إل إم () دالة من حزمة الإحصاءات.
يتم تعريف كل نموذج خطي معمّم بثلاثة مكونات:
- عنصر عشوائي: التوزيع الاحتمالي لمتغير الاستجابة، مأخوذ من العائلة الأسية (ذات الحدين، بواسون، جاما، غاوس، وغيرها).
- المكون المنهجي: المتنبئ الخطي، أي التركيبة المرجحة لمتغيراتك التفسيرية.
- وظيفة الارتباط: الدالة التي تربط متوسط الاستجابة بالمتنبئ الخطي، على سبيل المثال دالة الربط اللوجستي للبيانات الثنائية أو دالة الربط اللوغاريتمي للعد.
هذا الهيكل هو ما يجعل النموذج "معمماً". فبدلاً من فرض نتيجة موزعة توزيعاً طبيعياً، فإنك تحدد التوزيع الصحيح من خلال للعائلات تستخدم لغة R وسيطًا لتقدير المعاملات باستخدام طريقة الاحتمال الأقصى. الانحدار اللوجستي هو ببساطة نموذج خطي معمّم ذو عائلة ذات حدين ورابط لوجيت، لذا فهو نقطة البداية الطبيعية.
ما هو الانحدار اللوجستي في لغة البرمجة R؟
يستخدم الانحدار اللوجستي للتنبؤ بفئة ما، أي الاحتمالية. يمكن للانحدار اللوجستي التنبؤ بنتيجة ثنائية بدقة.
تخيل أنك تريد التنبؤ بما إذا كان سيتم رفض/قبول القرض بناءً على العديد من السمات. الانحدار اللوجستي هو من النموذج 0/1. y = 0 إذا تم رفض القرض، y = 1 إذا تم قبوله.
يختلف نموذج الانحدار اللوجستي عن نموذج الانحدار الخطي بطريقتين.
- أولاً، يقبل الانحدار اللوجستي فقط المدخلات الثنائية (الثنائية) كمتغير تابع (أي متجه 0 و1).
- ثانيًا، يتم تمثيل النتيجة من خلال دالة ارتباط احتمالية تسمى السيني الوظيفة (اللوجستية) بسبب شكلها على شكل حرف S:

يكون إخراج الوظيفة دائمًا بين 0 و1. تحقق من الصورة أدناه
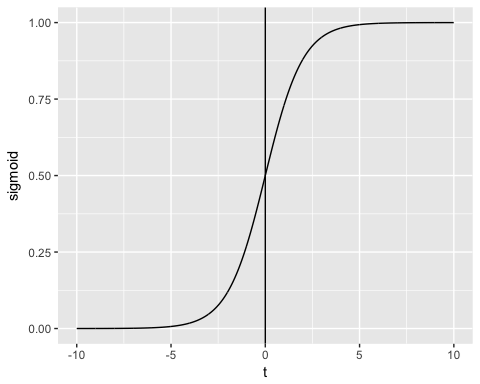
تقوم الدالة السيني بإرجاع القيم من 0 إلى 1. بالنسبة لمهمة التصنيف، نحتاج إلى مخرجات منفصلة من 0 أو 1.
لتحويل التدفق المستمر إلى قيمة منفصلة، يمكننا تعيين قرار محدد عند 0.5. يتم تصنيف جميع القيم فوق هذا الحد على أنها 1

الآن وقد أصبح تعريف دالة الربط واضحاً، قارن النموذج المعمم بالنموذج الخطي العادي الذي تعرفه بالفعل.
الانحدار الخطي العام مقابل الانحدار الخطي: الاختلافات الرئيسية في R
قبل كتابة أي كود، من المفيد معرفة متى يكون المعيار بالضبط الانحدارالخطي لم تعد الدالة lm() مناسبة ويجب أن تحل محلها الدالة glm().
| المعايير | الانحدار الخطي (lm) | النموذج الخطي المعمم (glm) |
|---|---|---|
| متغير الاستجابة | مستمر وغير محدود | ثنائي، أو عددي، أو نسبي، أو موجب مستمر |
| توزيع الأخطاء | عادي فقط | أي فرد من أفراد العائلة ذوي النمو الأسي |
| وظيفة الارتباط | الهوية (الضمنية) | صريح: لوجيت، لوغاريتم، معكوس، بروبيت |
| طريقة التقدير | المربعات الصغرى العادية | الاحتمال الأقصى (IRLS) |
| افتراض التباين | ثابت عبر جميع الملاحظات | يُسمح بالاعتماد على المتوسط |
| مقياس جودة المطابقة | الجذر التربيعي | معيار معلومات أكايكي والانحراف المتبقي |
| وظيفة R | lm(formula, data) | glm(formula, data, family) |
باختصار، اختر دالة lm() عندما تكون النتيجة قياسًا موزعًا توزيعًا طبيعيًا، ودالة glm() عندما تكون النتيجة قرارًا بنعم/لا، وهي مهمة يمكنك تفويضها إلى... شجرة القرار المصنف، أو عدد الأحداث، أو كمية موجبة تمامًا يزداد انتشارها مع متوسطها.
كيفية إنشاء نموذج خطي معمّم (GLM) في لغة البرمجة R
بعد حسم النظرية، يطبق الجزء المتبقي من هذا البرنامج التعليمي نموذج GLM ذو الحدين من البداية إلى النهاية على مجموعة بيانات حقيقية.
دعنا نستخدم بالغ مجموعة بيانات لتوضيح الانحدار اللوجستي. تُعدّ مجموعة بيانات "البالغين" مثالية لمهمة التصنيف. الهدف هو التنبؤ بما إذا كان الدخل السنوي للفرد بالدولار الأمريكي سيتجاوز 50,000 دولار. تحتوي مجموعة البيانات على 48,842 مشاهدة وعشرة متغيرات.
- العمر: عمر الفرد. رقمي
- التعليم: المستوى التعليمي للفرد. عامل.
- الحالة الزوجية: Mariالوضع التل للفرد. العامل على سبيل المثال: لم يسبق له الزواج، متزوج، زوج مدني، ...
- الجنس: جنس الفرد. العامل، أي ذكر أو أنثى
- الإيرادات: Target عامل. الدخل فوق أو أقل من 50 ألف. العامل على سبيل المثال > 50 ألفًا، <= 50 ألفًا
من بين أمور أخرى
library(dplyr)
data_adult <-read.csv("https://raw.githubusercontent.com/guru99-edu/R-Programming/master/adult.csv")
glimpse(data_adult)
الإخراج:
Observations: 48,842
Variables: 10
$ x               <int> 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15,...
$ age             <int> 25, 38, 28, 44, 18, 34, 29, 63, 24, 55, 65, 36, 26...
$ workclass       <fctr> Private, Private, Local-gov, Private, ?, Private,...
$ education       <fctr> 11th, HS-grad, Assoc-acdm, Some-college, Some-col...
$ educational.num <int> 7, 9, 12, 10, 10, 6, 9, 15, 10, 4, 9, 13, 9, 9, 9,...
$ marital.status  <fctr> Never-married, Married-civ-spouse, Married-civ-sp...
$ race            <fctr> Black, White, White, Black, White, White, Black, ...
$ gender          <fctr> Male, Male, Male, Male, Female, Male, Male, Male,...
$ hours.per.week  <int> 40, 50, 40, 40, 30, 30, 40, 32, 40, 10, 40, 40, 39...
$ income          <fctr> <=50K, <=50K, >50K, >50K, <=50K, <=50K, <=50K, >5...
سنتصرف على النحو التالي:
- الخطوة 1: التحقق من المتغيرات المستمرة
- الخطوة 2: التحقق من متغيرات العوامل
- الخطوة 3: هندسة الميزات
- الخطوة 4: ملخص الإحصائية
- الخطوة 5: تدريب/مجموعة الاختبار
- الخطوة 6: بناء النموذج
- الخطوة 7: تقييم أداء النموذج
- الخطوة 8: تحسين النموذج
مهمتك هي التنبؤ بالفرد الذي سيحصل على إيرادات أعلى من 50 ألفًا.
في هذا البرنامج التعليمي، سيتم تفصيل كل خطوة لإجراء تحليل على مجموعة بيانات حقيقية.
الخطوة 1) التحقق من المتغيرات المستمرة
في الخطوة الأولى، يمكنك رؤية توزيع المتغيرات المستمرة.
continuous <-select_if(data_adult, is.numeric)
summary(continuous)
Code تفسير
- مستمر <- Select_if(data_adult, is.numeric): استخدم الوظيفة Select_if() من مكتبة dplyr لتحديد الأعمدة الرقمية فقط
- ملخص (مستمر): طباعة إحصائية الملخص
الإخراج:
##        X              age        educational.num hours.per.week
##  Min.   :    1   Min.   :17.00   Min.   : 1.00   Min.   : 1.00
##  1st Qu.:11509   1st Qu.:28.00   1st Qu.: 9.00   1st Qu.:40.00
##  Median :23017   Median :37.00   Median :10.00   Median :40.00
##  Mean   :23017   Mean   :38.56   Mean   :10.13   Mean   :40.95
##  3rd Qu.:34525   3rd Qu.:47.00   3rd Qu.:13.00   3rd Qu.:45.00
##  Max.   :46033   Max.   :90.00   Max.   :16.00   Max.   :99.00
من الجدول أعلاه، يمكنك أن ترى أن البيانات لها مقاييس مختلفة تمامًا وأن hours.per.weeks بها قيم متطرفة كبيرة (أي انظر إلى الربع الأخير والقيمة القصوى).
يمكنك التعامل معها باتباع خطوتين:
- ارسم توزيع الساعات في الأسبوع
- توحيد المتغيرات المستمرة
- ارسم التوزيع
دعونا نلقي نظرة عن كثب على توزيع الساعات في الأسبوع
# Histogram with kernel density curve
library(ggplot2)
ggplot(continuous, aes(x = hours.per.week)) +
    geom_density(alpha = .2, fill = "#FF6666")
الإخراج:

يحتوي المتغير على الكثير من القيم المتطرفة والتوزيع غير المحدد جيدًا. يمكنك معالجة هذه المشكلة جزئيًا عن طريق حذف أعلى 0.01 بالمائة من الساعات في الأسبوع.
بناء الجملة الأساسي للكمية:
quantile(variable, percentile)
arguments:
-variable:  Select the variable in the data frame to compute the percentile
-percentile:  Can be a single value between 0 and 1 or multiple value. If multiple, use this format:  `c(A,B,C, ...)
- `A`,`B`,`C` and `...` are all integer from 0 to 1.
نقوم بحساب النسبة المئوية 99 لساعات العمل الأسبوعية.
top_one_percent <- quantile(data_adult$hours.per.week, .99)
top_one_percent
Code تفسير
- quantile(data_adult$hours.per.week, .99): حساب النسبة المئوية 99 من وقت العمل الأسبوعي
الإخراج:
## 99%
##  80
99 بالمائة من السكان يعملون أقل من 80 ساعة في الأسبوع.
يمكنك إسقاط الملاحظات فوق هذا الحد. يمكنك استخدام الفلتر من com.dplyr مكتبة.
data_adult_drop <-data_adult %>%
filter(hours.per.week<top_one_percent)
dim(data_adult_drop)
الإخراج:
## [1] 45537 10
- توحيد المتغيرات المستمرة
يمكنك توحيد كل عمود لتحسين الأداء لأن بياناتك ليس لها نفس المقياس. يمكنك استخدام الدالة mutate_if من مكتبة dplyr. بناء الجملة الأساسي هو:
mutate_if(df, condition, funs(function))
arguments:
-`df`: Data frame used to compute the function
- `condition`: Statement used. Do not use parenthesis
- funs(function):  Return the function to apply. Do not use parenthesis for the function
يمكنك توحيد الأعمدة الرقمية على النحو التالي:
data_adult_rescale <- data_adult_drop %>%
	mutate_if(is.numeric, funs(as.numeric(scale(.))))
head(data_adult_rescale)
Code تفسير
- mutate_if(is.numeric, funs(scale)): الشرط هو عمود رقمي فقط والدالة هي مقياس
الإخراج:
##           X         age        workclass    education educational.num
## 1 -1.732680 -1.02325949          Private         11th     -1.22106443
## 2 -1.732605 -0.03969284          Private      HS-grad     -0.43998868
## 3 -1.732530 -0.79628257        Local-gov   Assoc-acdm      0.73162494
## 4 -1.732455  0.41426100          Private Some-college     -0.04945081
## 5 -1.732379 -0.34232873          Private         10th     -1.61160231
## 6 -1.732304  1.85178149 Self-emp-not-inc  Prof-school      1.90323857
##       marital.status  race gender hours.per.week income
## 1      Never-married Black   Male    -0.03995944  <=50K
## 2 Married-civ-spouse White   Male     0.86863037  <=50K
## 3 Married-civ-spouse White   Male    -0.03995944   >50K
## 4 Married-civ-spouse Black   Male    -0.03995944   >50K
## 5      Never-married White   Male    -0.94854924  <=50K
## 6 Married-civ-spouse White   Male    -0.76683128   >50K
الخطوة 2) التحقق من متغيرات العوامل
هذه الخطوة لها هدفان:
- تحقق من المستوى في كل عمود فئوي
- تحديد مستويات جديدة
وسنقسم هذه الخطوة إلى ثلاثة أجزاء:
- حدد الأعمدة الفئوية
- قم بتخزين المخطط الشريطي لكل عمود في القائمة
- طباعة الرسوم البيانية
يمكننا تحديد أعمدة العوامل بالرمز أدناه:
# Select categorical column
factor <- data.frame(select_if(data_adult_rescale, is.factor))
	ncol(factor)
Code تفسير
- data.frame(select_if(data_adult, is.factor)): نقوم بتخزين أعمدة العوامل في نوع إطار البيانات. تتطلب مكتبة ggplot2 كائن إطار بيانات.
الإخراج:
## [1] 6
تحتوي مجموعة البيانات على 6 متغيرات فئوية
الخطوة الثانية أكثر تعقيدًا. أنت تريد رسم مخطط شريطي لكل عمود في إطار البيانات. من الأنسب أتمتة هذه العملية، خاصةً في حالة وجود عدد كبير من الأعمدة.
library(ggplot2)
# Create graph for each column
graph <- lapply(names(factor),
    function(x)
	ggplot(factor, aes(get(x))) +
		geom_bar() +
		theme(axis.text.x = element_text(angle = 90)))
Code تفسير
- lapply(): استخدم الدالة lapply() لتمرير دالة في جميع أعمدة مجموعة البيانات. يمكنك تخزين الإخراج في القائمة
- الوظيفة (x): ستتم معالجة الوظيفة لكل x. هنا x هي الأعمدة
- ggplot(factor, aes(get(x))) + Geom_bar()+ theme(axis.text.x = element_text(angle = 90)): قم بإنشاء مخطط شريطي لكل عنصر x. لاحظ أنه لإرجاع x كعمود، يجب عليك تضمينه داخل الدالة get()
الخطوة الأخيرة سهلة نسبيًا. تريد طباعة الرسوم البيانية 6.
# Print the graph
graph
الإخراج:
## [[1]]

## ## [[2]]

## ## [[3]]

## ## [[4]]

## ## [[5]]

## ## [[6]]

ملاحظة: استخدم الزر التالي للانتقال إلى الرسم البياني التالي

الخطوة 3) هندسة الميزات
يحتوي متغيران تصنيفيان على مستويات أكثر مما يحتاجه النموذج. ستعيد تجميعهما في فئات أوسع وأكثر شمولاً.
إعادة صياغة التعليم
ومن الرسم البياني أعلاه، يمكنك أن ترى أن متغير التعليم يحتوي على 16 مستوى. وهذا أمر كبير، وبعض المستويات لديها عدد منخفض نسبيا من الملاحظات. إذا كنت ترغب في تحسين كمية المعلومات التي يمكنك الحصول عليها من هذا المتغير، فيمكنك إعادة صياغتها إلى مستوى أعلى. أي أنك تقوم بإنشاء مجموعات أكبر ذات مستوى تعليمي مماثل. على سبيل المثال، سيتم تحويل المستوى التعليمي المنخفض إلى التسرب. سيتم تغيير مستويات التعليم العالي لإتقان.
وهنا التفاصيل:
| المستوى القديم | مستوى جديد |
|---|---|
| حضانة | التسرب |
| المرتبة الرابعة | أوقع |
| المرتبة الرابعة | أوقع |
| المرتبة الرابعة | أوقع |
| 1-4 | أوقع |
| 5th-6th | أوقع |
| 7th-8th | أوقع |
| المرتبة الرابعة | أوقع |
| HS-Grad | هايغراد |
| بعض الكليات | المجتمع |
| مساعد-ACDM | المجتمع |
| مساعد voc | المجتمع |
| البكالوريوس | البكالوريوس |
| الماجستير | الماجستير |
| أستاذ المدرسة | الماجستير |
| دكتوراه | بحث الدكتوراه |
recast_data <- data_adult_rescale %>%
	select(-X) %>%
	mutate(education = factor(ifelse(education == "Preschool" | education == "10th" | education == "11th" | education == "12th" | education == "1st-4th" | education == "5th-6th" | education == "7th-8th" | education == "9th", "dropout", ifelse(education == "HS-grad", "HighGrad", ifelse(education == "Some-college" | education == "Assoc-acdm" | education == "Assoc-voc", "Community",
    ifelse(education == "Bachelors", "Bachelors",
        ifelse(education == "Masters" | education == "Prof-school", "Master", "PhD")))))))
Code تفسير
- نستخدم الفعل متحور من مكتبة dplyr. نغير قيم التعليم بالبيان ifelse
في الجدول أدناه، يمكنك إنشاء إحصائية موجزة لمعرفة متوسط عدد سنوات التعليم (القيمة z) اللازمة للوصول إلى درجة البكالوريوس أو الماجستير أو الدكتوراه.
recast_data %>%
	group_by(education) %>%
	summarize(average_educ_year = mean(educational.num),
		count = n()) %>%
	arrange(average_educ_year)
الإخراج:
## # A tibble: 6 x 3
## education average_educ_year count
##      <fctr>             <dbl> <int>
## 1   dropout       -1.76147258  5712
## 2  HighGrad       -0.43998868 14803
## 3 Community        0.09561361 13407
## 4 Bachelors        1.12216282  7720
## 5    Master        1.60337381  3338
## 6       PhD        2.29377644   557
إعادة Mariحالة التل
من الممكن أيضًا إنشاء مستويات أقل للحالة الزوجية. في الكود التالي يمكنك تغيير المستوى على النحو التالي:
| المستوى القديم | مستوى جديد |
|---|---|
| لم يتزوج قط | غير متزوج |
| متزوج-زوج-غائب | غير متزوج |
| متزوج-AF-الزوج | متزوجة |
| متزوج-الزوجة المدنية | |
| منفصل | منفصل |
| طلق | |
| الأرامل | أرملة |
# Change level marry
recast_data <- recast_data %>%
	mutate(marital.status = factor(ifelse(marital.status == "Never-married" | marital.status == "Married-spouse-absent", "Not_married", ifelse(marital.status == "Married-AF-spouse" | marital.status == "Married-civ-spouse", "Married", ifelse(marital.status == "Separated" | marital.status == "Divorced", "Separated", "Widow")))))
يمكنك التحقق من عدد الأفراد داخل كل مجموعة.
table(recast_data$marital.status)
الإخراج:
## ##     Married Not_married   Separated       Widow
##       21165       15359        7727        1286
الخطوة 4) ملخص الإحصائية
لقد حان الوقت للتحقق من بعض الإحصائيات حول المتغيرات المستهدفة لدينا. في الرسم البياني أدناه، يمكنك حساب النسبة المئوية للأفراد الذين يكسبون أكثر من 50 ألفًا بالنظر إلى جنسهم.
# Plot gender income
ggplot(recast_data, aes(x = gender, fill = income)) +
    geom_bar(position = "fill") +
    theme_classic()
الإخراج:

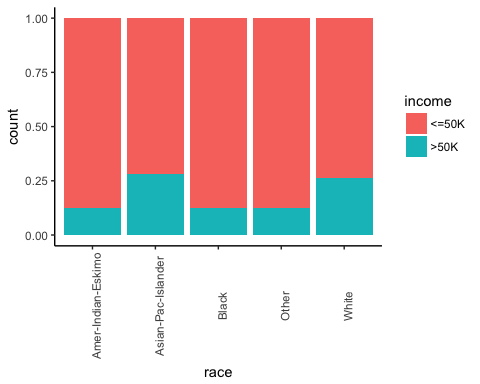
بعد ذلك، تحقق مما إذا كان أصل الفرد يؤثر على دخله.
# Plot origin income
ggplot(recast_data, aes(x = race, fill = income)) +
    geom_bar(position = "fill") +
    theme_classic() +
    theme(axis.text.x = element_text(angle = 90))
الإخراج:
عدد ساعات العمل حسب الجنس.
# box plot gender working time
ggplot(recast_data, aes(x = gender, y = hours.per.week)) +
    geom_boxplot() +
    stat_summary(fun.y = mean,
        geom = "point",
        size = 3,
        color = "steelblue") +
    theme_classic()
الإخراج:

يؤكد الرسم البياني الصندوقي أن توزيع وقت العمل يناسب مجموعات مختلفة. في الرسم البياني الصندوقي، لا توجد ملاحظات متجانسة بين الجنسين.
يمكنك التحقق من كثافة ساعات العمل الأسبوعية حسب نوع التعليم. تتضمن التوزيعات العديد من النقاط المميزة. ربما يُعزى ذلك إلى نوع التعليم.tract في الولايات المتحدة.
# Plot distribution working time by education
ggplot(recast_data, aes(x = hours.per.week)) +
    geom_density(aes(color = education), alpha = 0.5) +
    theme_classic()
Code تفسير
- ggplot(recast_data, aes(x= hours.per.week)): يتطلب رسم الكثافة متغيرًا واحدًا فقط
- Geom_density(aes(color = education), alpha =0.5): الكائن الهندسي للتحكم في الكثافة
الإخراج:

لتأكيد أفكارك، يمكنك إجراء اتجاه واحد اختبار التباين:
anova <- aov(hours.per.week~education, recast_data)
summary(anova)
الإخراج:
##                Df Sum Sq Mean Sq F value Pr(>F)
## education       5   1552  310.31   321.2 <2e-16 ***
## Residuals   45531  43984    0.97
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
يؤكد اختبار التحليل التبايني (ANOVA) الفرق في المتوسط بين المجموعات.
غير الخطي
قبل تشغيل النموذج، يمكنك معرفة ما إذا كان عدد ساعات العمل مرتبطًا بالعمر.
library(ggplot2)
ggplot(recast_data, aes(x = age, y = hours.per.week)) +
    geom_point(aes(color = income),
        size = 0.5) +
    stat_smooth(method = 'lm',
        formula = y~poly(x, 2),
        se = TRUE,
        aes(color = income)) +
    theme_classic()
Code تفسير
- ggplot(recast_data, aes(x = age, y = hours.per.week)): تعيين جمالية الرسم البياني
- Geom_point(aes(color= الدخل), size=0.5): أنشئ مخطط النقاط
- stat_smooth(): أضف خط الاتجاه بالحجج التالية:
- الطريقة = 'lm': ارسم القيمة المجهزة إذا كان الانحدارالخطي
- الصيغة = y~poly(x,2): تناسب الانحدار متعدد الحدود
- se = TRUE: أضف الخطأ القياسي
- aes (اللون = الدخل): قم بتقسيم النموذج حسب الدخل
الإخراج:

باختصار، يمكنك اختبار شروط التفاعل في النموذج لالتقاط تأثير عدم الخطية بين وقت العمل الأسبوعي والميزات الأخرى. من المهم اكتشاف الحالة التي يختلف فيها وقت العمل.
ارتباط
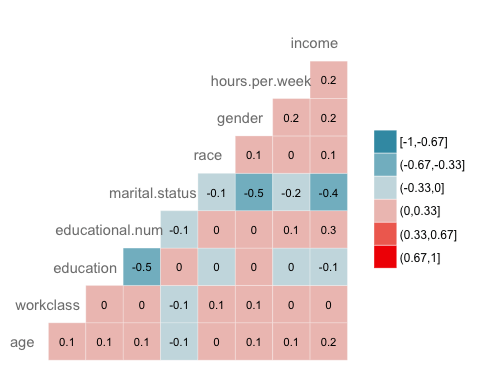
الفحص التالي هو تصور العلاقة بين المتغيرات. يمكنك تحويل نوع مستوى العامل إلى رقمي بحيث يمكنك رسم خريطة حرارية تحتوي على معامل الارتباط المحسوب باستخدام طريقة سبيرمان.
library(GGally)
# Convert data to numeric
corr <- data.frame(lapply(recast_data, as.integer))
# Plot the graphggcorr(corr,
    method = c("pairwise", "spearman"),
    nbreaks = 6,
    hjust = 0.8,
    label = TRUE,
    label_size = 3,
    color = "grey50")
Code تفسير
- data.frame(lapply(recast_data,as.integer)): تحويل البيانات إلى رقمية
- يقوم ggcorr() برسم خريطة حرارية باستخدام الوسائط التالية:
- الطريقة: طريقة لحساب الارتباط
- nbreaks = 6: عدد الفواصل
- hjust = 0.8: موضع التحكم لاسم المتغير في المخطط
- label = TRUE: إضافة تسميات في وسط النوافذ
- label_size = 3: تسميات الحجم
- اللون = "رمادي 50"): لون الملصق
الإخراج:
الخطوة 5) مجموعة التدريب/الاختبار
أي تحت الإشراف آلة التعلم تتطلب هذه المهمة تقسيم البيانات بين مجموعة تدريب ومجموعة اختبار. يمكنك استخدام "الدالة" التي أنشأتها في دروس التعلم الخاضع للإشراف الأخرى لإنشاء مجموعة تدريب/اختبار.
set.seed(1234)
create_train_test <- function(data, size = 0.8, train = TRUE) {
    n_row = nrow(data)
    total_row = size * n_row
    train_sample <- 1: total_row
    if (train == TRUE) {
        return (data[train_sample, ])
    } else {
        return (data[-train_sample, ])
    }
}
data_train <- create_train_test(recast_data, 0.8, train = TRUE)
data_test <- create_train_test(recast_data, 0.8, train = FALSE)
dim(data_train)
الإخراج:
## [1] 36429 9
dim(data_test)
الإخراج:
## [1] 9108 9
الخطوة 6) بناء النموذج
لمعرفة كيفية أداء الخوارزمية، يمكنك استخدام الدالة glm() من حزمة الإحصاءات. النموذج الخطي المعمم هي عبارة عن مجموعة من النماذج. بناء الجملة الأساسي هو:
glm(formula, data=data, family=linkfunction()
Argument:
- formula:  Equation used to fit the model- data: dataset used
- Family:     - binomial: (link = "logit")
- gaussian: (link = "identity")
- Gamma:    (link = "inverse")
- inverse.gaussian: (link = "1/mu^2")
- poisson:  (link = "log")
- quasi:    (link = "identity", variance = "constant")
- quasibinomial:    (link = "logit")
- quasipoisson: (link = "log")
أنت جاهز لتقدير النموذج اللوجستي لتقسيم مستوى الدخل بين مجموعة من الميزات.
formula <- income~.
logit <- glm(formula, data = data_train, family = 'binomial')
summary(logit)
Code تفسير
- الصيغة <- الدخل ~ .: قم بإنشاء النموذج المناسب
- logit <- glm(formula, data = data_train, Family = 'binomial'): قم بملاءمة النموذج اللوجستي (family = 'binomial') مع بيانات data_train.
- ملخص (لوجيت): طباعة ملخص النموذج
الإخراج:
##
## Call:
## glm(formula = formula, family = "binomial", data = data_train)
## ## Deviance Residuals:
##     Min       1Q   Median       3Q      Max
## -2.6456  -0.5858  -0.2609  -0.0651   3.1982
##
## Coefficients:
##                           Estimate Std. Error z value Pr(>|z|)
## (Intercept)                0.07882    0.21726   0.363  0.71675
## age                        0.41119    0.01857  22.146  < 2e-16 ***
## workclassLocal-gov        -0.64018    0.09396  -6.813 9.54e-12 ***
## workclassPrivate          -0.53542    0.07886  -6.789 1.13e-11 ***
## workclassSelf-emp-inc     -0.07733    0.10350  -0.747  0.45499
## workclassSelf-emp-not-inc -1.09052    0.09140 -11.931  < 2e-16 ***
## workclassState-gov        -0.80562    0.10617  -7.588 3.25e-14 ***
## workclassWithout-pay      -1.09765    0.86787  -1.265  0.20596
## educationCommunity        -0.44436    0.08267  -5.375 7.66e-08 ***
## educationHighGrad         -0.67613    0.11827  -5.717 1.08e-08 ***
## educationMaster            0.35651    0.06780   5.258 1.46e-07 ***
## educationPhD               0.46995    0.15772   2.980  0.00289 **
## educationdropout          -1.04974    0.21280  -4.933 8.10e-07 ***
## educational.num            0.56908    0.07063   8.057 7.84e-16 ***
## marital.statusNot_married -2.50346    0.05113 -48.966  < 2e-16 ***
## marital.statusSeparated   -2.16177    0.05425 -39.846  < 2e-16 ***
## marital.statusWidow       -2.22707    0.12522 -17.785  < 2e-16 ***
## raceAsian-Pac-Islander     0.08359    0.20344   0.411  0.68117
## raceBlack                  0.07188    0.19330   0.372  0.71001
## raceOther                  0.01370    0.27695   0.049  0.96054
## raceWhite                  0.34830    0.18441   1.889  0.05894 .
## genderMale                 0.08596    0.04289   2.004  0.04506 *
## hours.per.week             0.41942    0.01748  23.998  < 2e-16 ***
## ---## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
## ## (Dispersion parameter for binomial family taken to be 1)
## ##     Null deviance: 40601  on 36428  degrees of freedom
## Residual deviance: 27041  on 36406  degrees of freedom
## AIC: 27087
##
## Number of Fisher Scoring iterations: 6
يكشف ملخص نموذجنا عن معلومات مثيرة للاهتمام. يتم تقييم أداء الانحدار اللوجستي باستخدام مقاييس رئيسية محددة.
- AIC (معايير معلومات Akaike): هذا يعادل R2 في الانحدار اللوجستي. إنه يقيس الملاءمة عند تطبيق عقوبة على عدد المعلمات. الأصغر AIC تشير القيم إلى أن النموذج أقرب إلى الحقيقة.
- انحراف فارغ: يناسب النموذج فقط مع التقاطع. درجة الحرية هي n-1 يمكننا تفسيرها على أنها قيمة مربع كاي (قيمة مناسبة تختلف عن اختبار فرضية القيمة الفعلية).
- الانحراف المتبقي: نموذج يحتوي على جميع المتغيرات. يتم تفسيره أيضًا على أنه اختبار فرضية مربع كاي.
- عدد تكرارات تسجيل نقاط فيشر: عدد التكرارات قبل التقارب.
يتم تخزين مخرجات الدالة glm() في قائمة. يوضح الكود أدناه جميع العناصر المتوفرة في متغير السجل الذي قمنا بإنشائه لتقييم الانحدار اللوجستي.
# القائمة طويلة جدًا، اطبع العناصر الثلاثة الأولى فقط
lapply(logit, class)[1:3]
الإخراج:
## $coefficients
## [1] "numeric"
##
## $residuals
## [1] "numeric"
##
## $fitted.values
## [1] "numeric"
يمكن أن تكون كل قيمة مثالاًtracيُرمز له بعلامة الدولار ($) متبوعة باسم المقياس. على سبيل المثال، قمت بتخزين النموذج باسم logit.tracوفقًا لمعايير AIC، يمكنك استخدام ما يلي:
logit$aic
الإخراج:
## [1] 27086.65
الخطوة 7) تقييم أداء النموذج
الارتباك مصفوفة
استخدم الارتباك مصفوفة يعد خيارًا أفضل لتقييم أداء التصنيف مقارنةً بالمقاييس المختلفة التي شاهدتها من قبل. الفكرة العامة هي حساب عدد المرات التي يتم فيها تصنيف المثيلات الحقيقية على أنها خاطئة.

لحساب مصفوفة الارتباك، تحتاج أولاً إلى الحصول على مجموعة من التوقعات حتى يمكن مقارنتها بالأهداف الفعلية.
predict <- predict(logit, data_test, type = 'response')
# confusion matrix
table_mat <- table(data_test$income, predict > 0.5)
table_mat
Code تفسير
- توقع (logit,data_test, type = 'response'): احسب التنبؤ في مجموعة الاختبار. قم بتعيين النوع = "الاستجابة" لحساب احتمالية الاستجابة.
- الجدول (data_test$الدخل، التنبؤ > 0.5): حساب مصفوفة الارتباك. توقع > 0.5 يعني أنها تُرجع 1 إذا كانت الاحتمالات المتوقعة أعلى من 0.5، وإلا 0.
الإخراج:
##
##         FALSE TRUE
##   <=50K  6310  495
##   >50K   1074 1229
يمثل كل صف في مصفوفة الارتباك هدفًا فعليًا، بينما يمثل كل عمود هدفًا متوقعًا. يأخذ الصف الأول من هذه المصفوفة في الاعتبار الدخل الأقل من 50 ألفًا (الفئة السلبية): تم تصنيف 6,310 مشاهدة بشكل صحيح على أنها أفراد بدخل أقل من 50 ألفًا (صحيح سلبيبينما تم تصنيف 495 شخصًا بشكل خاطئ على أنهم فوق 50 ألفًا (إيجابية كاذبة). أما الصف الثاني فيتناول الدخل الذي يزيد عن 50 ألفًا: وقد تم تحديد 1,229 حالة بشكل صحيح (صحيح إيجابيبينما تم تفويت 1,074 حالة (سلبي خطأ).
يمكنك حساب النموذج دقة عن طريق جمع الإيجابية الحقيقية + السلبية الحقيقية على إجمالي الملاحظة

accuracy_Test <- sum(diag(table_mat)) / sum(table_mat)
accuracy_Test
Code تفسير
- sum(diag(table_mat)): مجموع القطر
- sum(table_mat): مجموع المصفوفة.
الإخراج:
## [1] 0.8277339
يبدو أن النموذج يعاني من مشكلة واحدة: وهي أنه ينتج الكثير من النتائج السلبية الخاطئة. وهذا ما يسمى بـ مفارقة اختبار الدقةذكرنا أن الدقة هي نسبة التنبؤات الصحيحة إلى إجمالي عدد الحالات. قد نحصل على دقة عالية نسبيًا ولكن بنموذج غير فعال. يحدث هذا عندما تكون هناك فئة مهيمنة. إذا نظرنا إلى مصفوفة الارتباك، سنجد أن معظم الحالات مصنفة على أنها سلبية حقيقية. تخيل الآن أن النموذج صنف كل ملاحظة على أنها سلبية (أي أقل من 50 ألفًا). ستحصل مع ذلك على دقة تبلغ حوالي 75% (6,805 / 9,108). سيتحسن أداء نموذجك، لكنه سيواجه صعوبة في التمييز بين الإيجابية الحقيقية والسلبية الحقيقية.
في مثل هذه الحالة، من الأفضل أن يكون لديك مقياس أكثر إيجازًا. يمكننا أن ننظر إلى:
- الدقة=TP/(TP+FP)
- استدعاء=TP/(TP+FN)
الدقة مقابل الاستدعاء
دقة ينظر إلى دقة التنبؤ الإيجابي. تذكر هي نسبة الحالات الإيجابية التي تم اكتشافها بشكل صحيح بواسطة المصنف؛
يمكنك إنشاء وظيفتين لحساب هذين المقياسين
- دقة البناء
precision <- function(matrix) {
	# True positive
    tp <- matrix[2, 2]
	# false positive
    fp <- matrix[1, 2]
    return (tp / (tp + fp))
}
Code تفسير
- mat[1,1]: قم بإرجاع الخلية الأولى من العمود الأول لإطار البيانات، أي القيمة الإيجابية الحقيقية
- حصيرة [1,2،XNUMX]؛ قم بإرجاع الخلية الأولى من العمود الثاني لإطار البيانات، أي الإيجابية الخاطئة
recall <- function(matrix) {
# true positive
    tp <- matrix[2, 2]# false positive
    fn <- matrix[2, 1]
    return (tp / (tp + fn))
}
Code تفسير
- mat[1,1]: قم بإرجاع الخلية الأولى من العمود الأول لإطار البيانات، أي القيمة الإيجابية الحقيقية
- حصيرة [2,1،XNUMX]؛ قم بإرجاع الخلية الثانية من العمود الأول لإطار البيانات، أي السلبية الخاطئة
يمكنك اختبار وظائفك
prec <- precision(table_mat)
prec
rec <- recall(table_mat)
rec
الإخراج:
## [1] 0.712877
## [2] 0.5336518
اقرأ هذين الرقمين بعناية. الدقة 0.71، لذا عندما يُشير النموذج إلى أن دخل الفرد يزيد عن 50 ألفًا، يكون صحيحًا في 71% من الحالات. أما الاستدعاء فهو 0.53، لذا لا يكتشف النموذج سوى 53% من الأفراد الذين يكسبون بالفعل أكثر من 50 ألفًا.
يمكنك إنشاء ملف  النتيجة على أساس الدقة والاستدعاء. ال هو متوسط توافقي لهذين المقياسين، مما يعني أنه يعطي وزنًا أكبر للقيم الأقل.

f1 <- 2 * ((prec * rec) / (prec + rec))
f1
الإخراج:
## [1] 0.6103799
مقايضة الدقة مقابل الاستدعاء
من المستحيل الحصول على دقة عالية واستدعاء عالي.
إذا قمنا بزيادة الدقة، فسيتم التنبؤ بشكل أفضل بالفرد الصحيح، ولكننا سنفقد الكثير منهم (تذكُّر أقل). في بعض الحالات، نفضل دقة أعلى من التذكر. هناك علاقة مقعرة بين الدقة والتذكر.
- تخيل أنك بحاجة إلى التنبؤ بما إذا كان المريض يعاني من مرض ما. تريد أن تكون دقيقًا قدر الإمكان.
- إذا كنت بحاجة إلى اكتشاف المحتالين المحتملين في الشارع من خلال التعرف على الوجه، فسيكون من الأفضل اكتشاف العديد من الأشخاص الذين يتم تصنيفهم على أنهم محتالون على الرغم من أن الدقة منخفضة. ستكون الشرطة قادرة على إطلاق سراح الشخص غير المحتال.
منحنى ROC
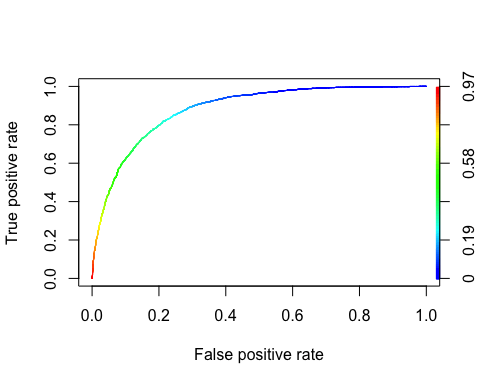
استخدم المتلقي Operaتينغ مميزة المنحنى هو أداة شائعة أخرى تستخدم في التصنيف الثنائي. وهو مشابه جدًا لمنحنى الدقة/الاستدعاء، ولكن بدلاً من رسم الدقة مقابل الاستدعاء، يُظهر منحنى ROC المعدل الإيجابي الحقيقي (أي الاستدعاء) مقابل المعدل الإيجابي الخاطئ. المعدل الإيجابي الكاذب هو نسبة الحالات السلبية التي تم تصنيفها بشكل غير صحيح على أنها إيجابية. وهو يساوي واحدًا ناقص المعدل السلبي الحقيقي. ويسمى أيضا المعدل السلبي الحقيقي النوعية. ومن هنا مؤامرات منحنى ROC حساسية (أذكر) مقابل 1-خصوصية
لرسم منحنى ROC، نحتاج إلى تثبيت حزمة تسمى ROCR. يمكننا العثور عليها في conda مكتبة. يمكنك كتابة الكود:
conda install -c r r-rocr --yes
يمكننا رسم ROC باستخدام وظائف التنبؤ () والأداء ().
library(ROCR)
ROCRpred <- prediction(predict, data_test$income)
ROCRperf <- performance(ROCRpred, 'tpr', 'fpr')
plot(ROCRperf, colorize = TRUE, text.adj = c(-0.2, 1.7))
Code تفسير
- التنبؤ (توقع، data_test $ الدخل): تحتاج مكتبة ROCR إلى إنشاء كائن تنبؤ لتحويل بيانات الإدخال
- Performance(ROCRpred, 'tpr','fpr'): قم بإرجاع المجموعتين اللتين سيتم إنتاجهما في الرسم البياني. هنا، يتم إنشاء tpr وfpr. لدقة الرسم والتذكر معًا، استخدم "prec"، "rec".
الإخراج:
الخطوة 8) تحسين النموذج
يمكنك محاولة إضافة عدم الخطية إلى النموذج مع التفاعل بينهما
- العمر والساعات في الاسبوع
- الجنس وساعات العمل في الأسبوع.
ثم تقوم بمقارنة درجة F1 لكلا النموذجين.
formula_2 <- income~age: hours.per.week + gender: hours.per.week + .
logit_2 <- glm(formula_2, data = data_train, family = 'binomial')
predict_2 <- predict(logit_2, data_test, type = 'response')
table_mat_2 <- table(data_test$income, predict_2 > 0.5)
precision_2 <- precision(table_mat_2)
recall_2 <- recall(table_mat_2)
f1_2 <- 2 * ((precision_2 * recall_2) / (precision_2 + recall_2))
f1_2
الإخراج:
## [1] 0.6109181
النتيجة في سباقات الفورمولا 1 أعلى قليلاً من النتيجة السابقة. يمكنك مواصلة العمل على البيانات ومحاولة تحسين النتيجة.
كيفية تفسير معاملات GLM ونسب الاحتمالات في R
يعرض الجدول الموجز المطبوع في الخطوة 6 معاملات على سجل الاحتمالات المقياس، الذي يصعب شرحه لغير المتخصصين. تحويلها إلى نسب احتمالية يجعل النموذج أسهل بكثير في التواصل.
اتبع هذه الخطوات الأربع.
- ارفع المعاملات إلى الأس. قم بتطبيق الدالة exp() على كل تقدير بحيث تصبح نسب الاحتمالات اللوغاريتمية نسب احتمالات ضربية.
- أضف فترة ثقة. قم بتغليف الدالة confint() داخل الدالة exp() للحصول على فاصل الثقة بنسبة 95% على نفس مقياس الاحتمالات.
- قارن كل قيمة بالقيمة 1. نسبة الاحتمالات التي تزيد عن 1 تزيد من احتمالية الفئة الإيجابية، والقيمة الأقل من 1 تقلل منها، والقيمة القريبة من 1 تعني أن المتنبئ لا يضيف الكثير.
- تحقق من الدلالة الإحصائية. قم بتفسير المتغيرات التنبؤية التي تكون قيمة p الخاصة بها في مخرجات الملخص أقل من العتبة التي اخترتها، والتي عادة ما تكون 0.05.
# Convert log-odds coefficients into odds ratios
odds_ratio <- exp(coef(logit))
round(odds_ratio, 3)

# Odds ratios with 95% confidence intervals
exp(cbind(OddsRatio = coef(logit), confint(logit)))
قراءة المخرجات. معامل ساعات العمل في الأسبوع في نموذجنا هو 0.41942. وبرفعه إلى الأس نحصل على exp(0.41942) = 1.52، مما يعني أن زيادة انحراف معياري واحد في ساعات العمل الأسبوعية تضاعف احتمالات كسب أكثر من 50 ألفًا بمقدار 1.5 تقريبًا، مع ثبات جميع المتغيرات الأخرى.
تعمل المعاملات السالبة بنفس الطريقة. قيمة marital.statusNot_married هي -2.50346، لذا فإن exp(-2.50346) = 0.08: أي أن الأفراد غير المتزوجين لديهم احتمالية تقارب 8% من احتمالية الأفراد المتزوجين. ولأن المتغيرات التنبؤية المستمرة قد تم توحيدها في الخطوة 1، فصف التغيرات بوحدات الانحراف المعياري، وليس بالساعات الخام.
ملاحظة للعائلات الأخرى: تُعتبر المعاملات الأسية نسب احتمالات فقط في ظل عائلة التوزيع الثنائي مع دالة الربط اللوجيتية. أما في حالة استخدام دالة الربط اللوغاريتمية مع عائلة التوزيع "بواسون"، فتُقرأ قيم exp() نفسها كنسب معدلات.
GLM في R: مرجع سريع للوظائف
احتفظ بهذا الجدول بجانبك أثناء كتابة الكود. فهو يسرد كل دالة مستخدمة في الخطوات الثماني المذكورة أعلاه، بالإضافة إلى الحزمة التي توفرها والوسائط التي تتوقعها.
| فئة الإشتراك | الهدف | الوظيفة | حجة |
|---|---|---|---|
| - | إنشاء مجموعة بيانات التدريب/الاختبار | create_train_set() | البيانات، الحجم، القطار |
| GLM | تدريب النموذج الخطي المعمم | جي إل إم () | الصيغة والبيانات والأسرة* |
| GLM | تلخيص النموذج | ملخص() | نموذج مناسب |
| قاعدة | يتوقع | تنبؤ() | النموذج المجهز، مجموعة البيانات، النوع = "الاستجابة" |
| قاعدة | إنشاء مصفوفة الارتباك | طاولة() | ص، توقع () |
| قاعدة | إنشاء درجة الدقة | مجموع (قطر (جدول ())/مجموع (جدول () | |
| روكر | إنشاء ROC: الخطوة 1 إنشاء التنبؤ | تنبؤ() | توقع ()، ذ |
| روكر | إنشاء ROC: الخطوة 2 إنشاء الأداء | أداء() | التنبؤ ()، 'tpr'، 'fpr' |
| روكر | إنشاء ROC: الخطوة 3 رسم الرسم البياني | قطعة() | أداء() |
الآخر GLM العائلات المتاحة من خلال حجة العائلة هي:
- التوزيع الثنائي: (الرابط = "logit")
- غاوسي: (رابط = "هوية")
- جاما: (الرابط = "معكوس")
- دالة غاوس العكسية: (رابط = "1/μ^2")
- poisson: (link = “log”)
- شبه: (الرابط = "الهوية"، التباين = "ثابت")
- شبه ثنائي الحدين: (رابط = "logit")
- شبه بواسون: (رابط = "log")
