
تحليل التباين في لغة البرمجة R: اختبار أحادي الاتجاه واختبار ثنائي الاتجاه مع أمثلة
 فريق التحرير
⚡ ملخص ذكي
يقارن تحليل التباين (ANOVA) في لغة البرمجة R متوسطات ثلاث مجموعات أو أكثر بتقسيم التباين الكلي إلى مكونات بين المجموعات وداخلها. يُجري هذا الدليل اختبارات أحادية وثنائية الاتجاه على مجموعة بيانات السموم، ويتحقق من صحة الافتراضات، ويعزل الأزواج المختلفة باستخدام اختبار Tukey HSD.
ما هو أنوفا؟
تحليل التباين تحليل التباين (ANOVA) هو أسلوب إحصائي يُستخدم لمقارنة متوسطات مجموعتين أو أكثر. يعمل هذا الاختبار عن طريق تقسيم التباين الكلي في القياس إلى جزء يُفسَّر بانتماء المجموعة وجزء آخر يُعتبر ضوضاء عشوائية. لذا، يُخبرك تحليل التباين في لغة R ما إذا كان متوسط مجموعة واحدة على الأقل يختلف عن المتوسطات الأخرى، وليس أيّها. وهو امتداد مباشر لـ اختبار تي إلى الحالات التي يكون فيها للمتغير العامل أكثر من مستويين.
قبل إجراء الاختبار، من المفيد معرفة أي عضو من عائلة ANOVA يناسب تصميمك.
أنواع اختبارات تحليل التباين في لغة البرمجة R
يُعدّ تحليل التباين (ANOVA) مجموعة من الاختبارات وليس إجراءً واحداً. ويعتمد اختيار الاختبار المناسب على عدد العوامل الموجودة وكيفية جمع البيانات.
| اختبار | متى يتم استخدامه | استدعاء R |
|---|---|---|
| اتجاه واحد أنوفا | عامل واحد بثلاثة مستويات أو أكثر | aov(y ~ x, data = df) |
| في اتجاهين ANOVA | عاملان مستقلان | aov(y ~ x1 + x2, data = df) |
| تفاعل ثنائي الاتجاه | يعتمد تأثير أحد العوامل على الآخر | aov(y ~ x1 * x2, data = df) |
| تحليل التباين للقياسات المتكررة | تم قياس نفس الأشخاص أكثر من مرة | aov(y ~ x + Error(subject/x)) |
| أنكوفا | يجب التحكم في المتغير المصاحب المستمر لـ | aov(y ~ x + covariate, data = df) |
| مانوفا | متغيران استجابة أو أكثر في آن واحد | manova(cbind(y1, y2) ~ x) |
يشرح هذا الدرس التعليمي أول ثلاثة منها. أما المتغيرات المتبقية فتستخدم نفس واجهة aov()، لذا بمجرد أن تتمكن من قراءة جدول إخراج واحد، يمكنك قراءة جميع الجداول.
تحليل التباين (ANOVA) مقابل اختبار T في لغة R: الاختلافات الرئيسية
يقارن كلا الاختبارين المتوسطات، لذا يجدر بنا أن نكون دقيقين بشأن مكان استبدال أحدهما بالآخر.
| المعايير | اختبار T | ANOVA |
|---|---|---|
| عدد المجموعات | اثنان بالضبط | اثنين أو أكثر |
| اختبار الإحصائية | t | F، تساوي مربع t عندما يكون هناك مجموعتان |
| نتيجة | يحدد اتجاه الفرق | التقارير الوحيدة التي تشير إلى وجود اختلاف |
| يلزم المتابعة | بدون سلوفان | اختبار ما بعد التحليل مثل اختبار توكي إتش إس دي |
| وظيفة R | اختبار t. | aov() |
قد يميل البعض عند التعامل مع ثلاث مجموعات إلى إجراء ثلاثة اختبارات t منفصلة. تجنب ذلك. يحمل كل اختبار نسبة خطأ خاصة به تبلغ 5%، لذا فإن إجراء ثلاث مقارنات يرفع احتمال الحصول على نتيجة إيجابية خاطئة إلى حوالي 14%. يجيب تحليل التباين (ANOVA) على السؤال نفسه باختبار واحد، ثم يتعامل اختبار Tukey HSD مع تفاصيل المقارنات الثنائية مع التحكم في نسبة الخطأ. للاطلاع على حالة المجموعتين، انظر... شرح اختبار t.
اتجاه واحد أنوفا
هناك العديد من المواقف التي تحتاج فيها إلى مقارنة المتوسط بين مجموعات متعددة. على سبيل المثال، يريد قسم التسويق معرفة ما إذا كانت هناك ثلاثة فرق لديها نفس أداء المبيعات.
- الفريق: عامل المستوى 3: A، B، وC
- البيع: مقياس الأداء
يمكن لاختبار التحليل التبايني (ANOVA) معرفة ما إذا كانت المجموعات الثلاث تتمتع بأداء مماثل.
لتوضيح ما إذا كانت البيانات تأتي من نفس المجموعة السكانية، يمكنك إجراء تحليل التباين في اتجاه واحد (يُشار إليه فيما يلي بتحليل التباين أحادي الاتجاه). وكأي اختبار إحصائي آخر، يُقدّم هذا الاختبار دليلاً حول إمكانية رفض الفرضية الصفرية (H0). تجدر الإشارة إلى أن عدم رفض الفرضية الصفرية لا يعني بالضرورة إثبات صحتها.
فرضية في اختبار التحليل التبايني أحادي الاتجاه
- H0: المتوسطات بين المجموعات متطابقة
- H1: على الأقل، يختلف متوسط مجموعة واحدة
بمعنى آخر، فإن عدم رفض الفرضية الصفرية يعني عدم وجود أدلة كافية للاستنتاج بأن متوسط أي مجموعة يختلف عن المتوسطات الأخرى.
يشبه هذا الاختبار اختبار t، لكن تحليل التباين (ANOVA) هو الخيار الأمثل عند وجود أكثر من مجموعتين. أما عند وجود مجموعتين فقط، فيكون الاختباران متكافئين، وتكون قيمة إحصائية F مساوية لمربع قيمة إحصائية t.
الافتراضات
يعتمد تحليل التباين أحادي الاتجاه (ANOVA) على ثلاثة شروط: أن تكون المشاهدات عشوائية ومستقلة عن بعضها البعض، وأن تكون البواقي داخل كل مجموعة موزعة توزيعًا طبيعيًا تقريبًا، وأن يكون التباين متساويًا في جميع المجموعات (تجانس التباين). يوضح القسم الخاص بالتحقق من الافتراضات أدناه كيفية اختبار كل شرط منها في لغة البرمجة R.
تفسير اختبار تحليل التباين
يتم استخدام إحصائية F لاختبار ما إذا كانت البيانات مأخوذة من مجموعات سكانية مختلفة بشكل كبير، أي وسائل عينة مختلفة.
لحساب إحصائية F، تحتاج إلى تقسيم التباين بين المجموعات خلال التباين داخل المجموعة.
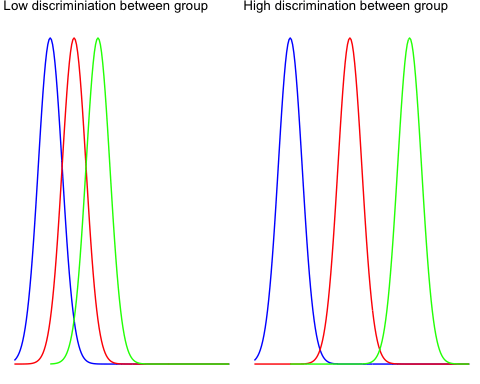
استخدم بين المجموعة يعكس التباين مدى بُعد متوسط كل مجموعة عن المتوسط العام. قارن بين الرسمين البيانيين أدناه لتوضيح الفكرة.
يُظهر الرسم البياني الأيسر اختلافًا طفيفًا جدًا بين المجموعات الثلاث، لذا فإن متوسطات المجموعات الثلاث جميعها قريبة من بعضها البعض. الكلي تعني.
يرسم الرسم البياني الأيمن ثلاثة توزيعات متباعدة جدًا بدون أي تداخل، لذا فإن الفجوة بين المتوسط العام ومتوسط كل مجموعة كبيرة.
استخدم داخل المجموعة يقيس التباين مدى ابتعاد الملاحظات الفردية عن متوسط مجموعتها. تقع بعض النقاط بعيدًا عن متوسط مجموعتها، ويعكس مصطلح "داخل المجموعة" هذا التباين تحديدًا، وهو ما يُعرف بخطأ المعاينة.
لفهم مفهوم التباين داخل المجموعة بصريًا، انظر إلى الرسم البياني أدناه.
يُظهر الجزء الأيسر من الرسم البياني توزيع ثلاث مجموعات مختلفة. لقد زدتَ من تشتت كل عينة، ومن الواضح أن التباين الفردي كبير. تنخفض قيمة إحصائية F، لذا لن تتمكن من رفض الفرضية الصفرية.
يُظهر الجزء الأيمن عينات ذات متوسطات متساوية ولكن بتشتت أقل بكثير. وهذا يرفع قيمة إحصائية F ويدعم الفرضية البديلة.

يمكنك استخدام كلا المقياسين لإنشاء إحصائيات F. من البديهي جدًا فهم إحصائية F. إذا زاد البسط، فهذا يعني أن التباين بين المجموعات مرتفع، ومن المحتمل أن تكون المجموعات في العينة مأخوذة من توزيعات مختلفة تمامًا.
بمعنى آخر، تشير قيمة إحصائية F المنخفضة إلى وجود فرق ضئيل أو معدوم بين متوسطات المجموعة.
مثال على اختبار تحليل التباين أحادي الاتجاه
ستستخدم مجموعة بيانات السم لتنفيذ اختبار التحليل التبايني أحادي الاتجاه. تحتوي مجموعة البيانات على 48 صفًا و3 متغيرات:
- الزمن: مدة بقاء الحيوان
- السم: نوع السم المستخدم: مستوى العامل: 1,2،3، XNUMX
- المعالجة: نوع العلاج المستخدم: مستوى العامل: 1,2،3، XNUMX
قبل أن تبدأ في حساب اختبار التحليل التبايني (ANOVA)، عليك إعداد البيانات على النحو التالي:
- الخطوة 1: استيراد البيانات
- الخطوة 2: إزالة المتغير غير الضروري
- الخطوة 3: تحويل السم المتغير حسب المستوى المطلوب
library(dplyr)
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/poisons.csv"
df <- read.csv(PATH) %>%
select(-X) %>%
mutate(poison = factor(poison, ordered = TRUE))
glimpse(df)
الإخراج:
## Observations: 48
## Variables: 3
## $ time   <dbl> 0.31, 0.45, 0.46, 0.43, 0.36, 0.29, 0.40, 0.23, 0.22, 0...
## $ poison <ord> 1, 1, 1, 1, 2, 2, 2, 2, 3, 3, 3, 3, 1, 1, 1, 1, 2, 2, 2...
## $ treat  <fctr> A, A, A, A, A, A, A, A, A, A, A, A, B, B, B, B, B, B, ...
هدفنا هو اختبار الافتراض التالي:
- H0: لا يوجد فرق في متوسط مدة البقاء بين المجموعات
- H1: يختلف متوسط وقت البقاء على قيد الحياة بالنسبة لمجموعة واحدة على الأقل.
بمعنى آخر، تريد أن تعرف ما إذا كان هناك فرق إحصائي بين متوسط وقت البقاء على قيد الحياة وفقًا لنوع السم الذي تم إعطاؤه لخنزير غينيا.
سوف تتصرف على النحو التالي:
- الخطوة 1: التحقق من تنسيق السم المتغير
- الخطوة 2: طباعة ملخص الإحصائية: العد والمتوسط والانحراف المعياري
- الخطوة 3: رسم مخطط صندوقي
- الخطوة 4: احسب اختبار التحليل التبايني أحادي الاتجاه
- الخطوة 5: إجراء مقارنة ثنائية باستخدام اختبار Tukey HSD
الخطوة 1) تحقق من مستويات السم باستخدام الكود أدناه. يجب أن ترى ثلاث قيم حرفية، لأن فعل التعديل حوّل العمود إلى عامل مرتب.
levels(df$poison)
الإخراج:
## [1] "1" "2" "3"
الخطوة 2) يمكنك حساب المتوسط والانحراف المعياري.
df %>%
	group_by(poison) %>%
	summarise(
		count_poison = n(),
		mean_time = mean(time, na.rm = TRUE),
		sd_time = sd(time, na.rm = TRUE)
	)
الإخراج:
##
# A tibble: 3 x 4
##   poison count_poison mean_time    sd_time
##    <ord>        <int>     <dbl>      <dbl>
## 1      1           16  0.617500 0.20942779
## 2      2           16  0.544375 0.28936641
## 3      3           16  0.276250 0.06227627
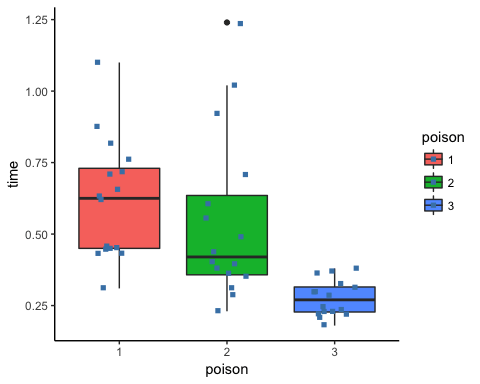
الخطوة 3) في الخطوة الثالثة، يمكنك التحقق بيانيًا مما إذا كان هناك اختلاف بين التوزيع. لاحظ أنك قمت بتضمين النقطة المتوترة.
ggplot(df, aes(x = poison, y = time, fill = poison)) +
    geom_boxplot() +
    geom_jitter(shape = 15,
        color = "steelblue",
        position = position_jitter(0.21)) +
    theme_classic()
الإخراج:
الخطوة 4) يمكنك تشغيل اختبار تحليل التباين أحادي الاتجاه باستخدام الأمر aov. الصيغة الأساسية لاختبار تحليل التباين هي:
aov(formula, data)
Arguments:
- formula: The equation you want to estimate
- data: The dataset used
بناء جملة الصيغة هو:
y ~ X1+ X2+...+Xn # X1 +  X2 +... refers to the independent variables
y ~ . # use all the remaining variables as independent variables
يمكنك الآن الإجابة على السؤال: هل هناك أي فرق في وقت البقاء على قيد الحياة بين خنازير غينيا، بالنظر إلى نوع السم الذي تم إعطاؤه؟
قم بتخزين النموذج في كائن وقم بتمريره إلى الدالة summary() للحصول على طباعة قابلة للقراءة للنتائج.
anova_one_way <- aov(time~poison, data = df)
summary(anova_one_way)
Code تفسير
- aov(time ~ poison, data = df): قم بتشغيل اختبار ANOVA بالصيغة التالية
- summary(anova_one_way): طباعة ملخص الاختبار
الإخراج:
##             Df Sum Sq Mean Sq F value   Pr(>F)
## poison       2  1.033  0.5165   11.79 7.66e-05 ***
## Residuals   45  1.972  0.0438
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
قيمة الاحتمالية (p-value) هي 7.66 × 05⁻⁵، وهي أقل بكثير من العتبة المعتادة البالغة 0.05، وتشير النجوم الثلاث إلى أعلى مستوى دلالة إحصائية. يمكنك رفض الفرضية الصفرية (H0) والاستنتاج بأن مجموعة واحدة على الأقل من مجموعات السموم لها متوسط عمر بقاء مختلف.
كيفية التحقق من افتراضات تحليل التباين في لغة البرمجة R
لا تكون قيمة p في تحليل التباين موثوقة إلا عند تحقق الشروط الثلاثة المذكورة سابقًا. ولكل شرط منها فحص مباشر في لغة البرمجة R، ويتم تطبيق جميع هذه الفحوصات على نموذج البيانات المُطابق.
1. استقلالية الملاحظات. هذه خاصية من خصائص تصميم الدراسة، وليست من خصائص البيانات، لذا لا يمكن لأي اختبار أن يُصلحها. يجب قياس كل خنزير غيني مرة واحدة وتوزيعه على مجموعته عشوائيًا. إذا ظهر نفس الخنزير في عدة صفوف، فستحتاج إلى نموذج قياسات متكررة.
2. توزيع البواقي الطبيعي. يفترض تحليل التباين (ANOVA) أن البواقي، وليس البيانات الأصلية، تتبع التوزيع الطبيعي تقريبًا. تفحّص مخطط QQ وتأكد من ذلك باستخدام اختبار شابيرو-ويلك.
par(mfrow = c(2, 2))
plot(anova_one_way)          # four diagnostic plots

shapiro.test(residuals(anova_one_way))
تشير النقاط الملاصقة لقطر مخطط التوزيع الطبيعي QQ إلى توزيع طبيعي للبواقي. قيمة احتمالية اختبار شابيرو-ويلك (Shapiro-Wilk p-value) التي تزيد عن 0.05 تعني أنه لا يمكن رفض فرضية التوزيع الطبيعي.
3. تجانس التباين. ينبغي أن تُظهر كل مجموعة انتشارًا مماثلًا. يجب أن يبدو الرسم البياني للبواقي مقابل القيم المتوقعة كشريط مسطح وليس كقمع. تأكد من ذلك باستخدام اختبار ليفين، وهو أكثر مقاومةً لعدم التوزيع الطبيعي من اختبار بارتليت.
library(car)
leveneTest(time ~ poison, data = df)

bartlett.test(time ~ poison, data = df)
قيمة p التي تزيد عن 0.05 تدعم تساوي التباينات.
ماذا تفعل عندما يفشل افتراض ما؟ إذا كانت التباينات غير متساوية، فقم بتشغيل اختبار التباين أحادي الاتجاه (oneway.test(time ~ poison, data = df, var.equal = FALSE))، مع تصحيح ويلش. إذا كانت البواقي غير طبيعية بشكل واضح وكانت العينة صغيرة، فانتقل إلى اختبار كروسكال-واليس الرتبي (kruskal.test(time ~ poison, data = df)). مع العينات الكبيرة المتوازنة، يكون تحليل التباين (ANOVA) قويًا نسبيًا في مواجهة الانحرافات المتوسطة عن التوزيع الطبيعي، لذا نادرًا ما تكون نتيجة اختبار شابيرو-ويلك الحدية كارثية.
مقارنة زوجية
يُشير اختبار F ذو الدلالة الإحصائية إلى أن متوسطات المجموعات ليست متساوية، ولكنه لا يُحدد أي زوج منها يختلف. يُجيب اختبار توكي للفرق الدال الصادق على هذا السؤال بمقارنة كل زوج مع ضبط معدل الخطأ الإجمالي.
TukeyHSD(anova_one_way)
الإخراج:

اقرأ الناتج صفًا واحدًا لكل زوج. فرق يحتوي العمود على الفرق بين متوسطي المجموعتين، لورا و رخصة حدد نطاق الثقة بنسبة 95% لهذا الفرق، و صفة تمثل قيمة p المعدلة للمقارنات المتعددة. يختلف الزوج اختلافًا معنويًا عندما لا تشمل فترته الصفر، أو عندما تكون قيمة p المعدلة أقل من 0.05. في هذه المجموعة من البيانات، تُعد المقارنات التي تتضمن السم 3 هي المقارنات المعنوية، وهو ما يتوافق مع مخطط الصندوق: فالمجموعة 3 لديها متوسط وقت بقاء أقل بشكل واضح من المجموعتين 1 و2، بينما لا يمكن تمييز المجموعتين 1 و2 إحصائيًا عن بعضهما البعض.
في اتجاهين ANOVA
يُضيف تحليل التباين ثنائي الاتجاه عاملاً ثانياً إلى الصيغة. وهو يعمل تماماً مثل اختبار التباين أحادي الاتجاه، مع اختلاف الصيغة فقط.
y ~ x1 + x2
هنا يمثل y متغير الاستجابة الكمي، بينما يمثل x1 و x2 عوامل فئوية.
فرضية في اختبار التحليل التبايني ثنائي الاتجاه
- H0: متوسطات المجموعات متساوية لكلا المتغيرين العامليين
- الفرضية الأولى: يختلف متوسط مجموعة واحدة على الأقل، بالنسبة لأحد العاملين على الأقل.
تُضاف متغيرات العلاج إلى النموذج. يسجل هذا المتغير العلاج المُقدّم لخنزير غينيا. تختبر الصيغة الجمعية أدناه ما إذا كان كل عامل يؤثر على مدة البقاء على قيد الحياة بمفرده، بعد الأخذ في الاعتبار العوامل الأخرى.
قم بتعديل الكود عن طريق إضافة كلمة treat بجانب المتغير المستقل الأول.
anova_two_way <- aov(time~poison + treat, data = df)
summary(anova_two_way)
الإخراج:
##             Df Sum Sq Mean Sq F value  Pr(>F)
## poison       2 1.0330  0.5165   20.64 5.7e-07 ***
## treat        3 0.9212  0.3071   12.27 6.7e-06 ***
## Residuals   42 1.0509  0.0250
## ---
كلا قيمتي p (5.7e-07 للسم و 6.7e-06 للعلاج) أقل بكثير من 0.05، لذلك ترفض H0 لكلا العاملين وتستنتج أن تغيير السم أو العلاج يؤثر على وقت البقاء على قيد الحياة.
إضافة مصطلح التفاعل
يفترض النموذج الإضافي أعلاه أن تأثير السم هو نفسه بغض النظر عن العلاج. لاختبار هذا الافتراض، استبدل علامة الجمع بعلامة النجمة، التي تناسب كلاً من التأثيرات الرئيسية وتفاعلها.
anova_interaction <- aov(time~poison * treat, data = df)
summary(anova_interaction)
إذا لم يكن صف السم:العلاج ذا دلالة إحصائية، فإن النموذج الإضافي هو الخيار الأفضل لأنه يستخدم درجات حرية أقل.
تحليل التباين في لغة البرمجة R: دليل سريع للاختبار
يسرد الجدول أدناه كل اختبار تم استخدامه أعلاه، واستدعاء R الذي يقوم بتشغيله، والفرضية التي يقيمها:
| اختبار | Code | فرضية | P ذات القيمة |
|---|---|---|---|
| تحليل التباين أحادي الاتجاه |
aov(y ~ X, data = df)
|
H1: يختلف المتوسط بالنسبة لمجموعة واحدة على الأقل | 0.05 |
| ثنائي |
TukeyHSD(ANOVA summary) |
0.05 | |
| تحليل التباين ثنائي الاتجاه |
aov(y ~ X1 + X2, data = df)
|
الفرضية الأولى: يختلف متوسط مجموعة واحدة على الأقل بالنسبة لأي من العاملين | 0.05 |
