
الانحدار الخطي المتعدد في لغة R: البسيط والمتدرج مع أمثلة
 إيفلين كلارك
⚡ ملخص ذكي
يُستخدم الانحدار الخطي البسيط والمتعدد في لغة البرمجة R لنمذجة النتائج المستمرة كمجموع مرجح للمتغيرات التنبؤية المُقدَّرة باستخدام طريقة المربعات الصغرى العادية. يشمل هذا الشرح استخدام دالة lm()، وقراءة المعاملات، والمتغيرات التنبؤية، وتشخيص البواقي، والتنبؤ، والاختيار التلقائي للمتغيرات.
أين يندرج الانحدار الخطي في مجال تعلم الآلة؟
الانحدار الخطي هو أحد أقدم أساليب التعلم الخاضع للإشراف آلة التعلم الخوارزميات، ولا يزال النموذج الأول الذي يلجأ إليه معظم المحللين. كان أحد أقدم تطبيقات التعلم الآلي هو فلتر البريد المزعج.
تشمل التطبيقات الشائعة الأخرى للتعلم الآلي ما يلي:
- تحديد رسائل البريد العشوائي غير المرغوب فيها في البريد الإلكتروني
- تجزئة سلوك العملاء للإعلانات المستهدفة
- الحد من المعاملات الاحتيالية ببطاقات الائتمان
- ترشيد استهلاك الطاقة في المنازل والمباني المكتبية
- التعرف على الوجه
التعلم تحت الإشراف
In التعلم تحت الإشراف، فإن بيانات التدريب التي تغذيها للخوارزمية تتضمن تسمية.
تصنيف ربما تكون هذه التقنية الأكثر استخدامًا في التعلم الخاضع للإشراف. ومن أوائل مهام التصنيف التي تناولها الباحثون هي فلترة البريد العشوائي. يهدف التعلم إلى التنبؤ بما إذا كان البريد الإلكتروني مصنفًا كبريد عشوائي أم بريد عادي (بريد إلكتروني جيد). بعد مرحلة التدريب، يستطيع الجهاز تحديد نوع البريد الإلكتروني.
الانحدار تُستخدم هذه النماذج بشكل شائع في مجال التعلم الآلي للتنبؤ بالقيم المستمرة. يمكن لمهمة الانحدار أن تتنبأ بقيمة المتغير التابع بناء على مجموعة من المتغيرات المستقلة (وتسمى أيضًا المتنبئين أو الراجعين). على سبيل المثال، يمكن للانحدارات الخطية التنبؤ بسعر السهم، وتوقعات الطقس، والمبيعات، وما إلى ذلك.
بعض خوارزميات التعلم الخاضع للإشراف الأساسية هي:
- الانحدارالخطي
- الانحدار اللوجستي
- أقرب الجيران
- آلة ناقلات الدعم (SVM)
- أشجار القرار والغابات العشوائية
- الشبكات العصبية
تعليم غير مشرف عليه
In تعليم غير مشرف عليهالبيانات التدريبية غير مُسمَّاة. يحاول النظام التعلم دون مرجع. فيما يلي قائمة بخوارزميات التعلم غير الخاضعة للإشراف.
- ك-يعني
- الهرمية Cluster تحليل الأداء
- زيادة التوقعات
- التخيل وتقليل الأبعاد
- تحليل المكون الرئيسي
- نواة PCA
- التضمين الخطي محليًا
مع وضع هذا السياق في الاعتبار، يقوم الجزء المتبقي من هذا البرنامج التعليمي ببناء نماذج الانحدار في لغة R خطوة بخطوة.
الانحدار الخطي البسيط في R
يجيب الانحدار الخطي على سؤال بسيط: هل يمكنك قياس علاقة دقيقة بين متغير مستهدف واحد ومجموعة من المتغيرات التنبؤية؟
أبسط نموذج احتمالي هو نموذج الخط المستقيم:

أين
- ص = المتغير التابع
- س = متغير مستقل
-
 = مكون الخطأ العشوائي
-
 = اعتراض
-
 = معامل س
خذ بعين الاعتبار الرسم البياني التالي:
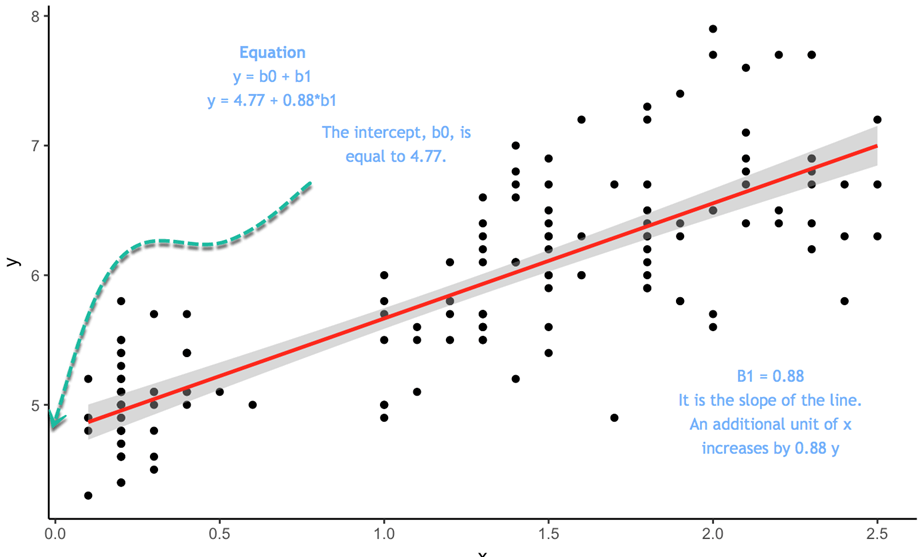
المعادلة 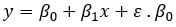 في هذه المعادلة، يبلغ التقاطع مع المحور الرأسي 4.77، لذا عندما تكون قيمة x تساوي صفرًا، تكون القيمة المتوقعة لـ y هي 4.77. أما الميل فيوضح النسبة التي تتغير بها قيمة y بتغير قيمة x.
لتقدير القيم المثلى ل  و
 ، يمكنك استخدام طريقة تسمى المربعات الصغرى العادية (OLS). تحاول هذه الطريقة العثور على المعلمات التي تقلل مجموع الأخطاء المربعة، وهي المسافة العمودية بين قيم y المتوقعة وقيم y الفعلية. ويعرف الفرق باسم مصطلح خطأ.
قبل تقدير النموذج، يمكنك تحديد ما إذا كانت العلاقة الخطية بين y وx معقولة من خلال رسم مخطط التشتت.
مبعثر
سوف نستخدم مجموعة بيانات بسيطة للغاية لشرح مفهوم الانحدار الخطي البسيط. سوف نقوم باستيراد متوسط الارتفاعات والأوزان للمرأة الأمريكية. تحتوي مجموعة البيانات على 15 ملاحظة. تريد قياس ما إذا كانت الارتفاعات مرتبطة بشكل إيجابي بالأوزان.
library(ggplot2)
path <- 'https://raw.githubusercontent.com/guru99-edu/R-Programming/master/women.csv'
df <-read.csv(path)
ggplot(df,aes(x=height, y =  weight))+
geom_point()
الإخراج:

يُشير الرسم البياني إلى ميل عام لزيادة الوزن مع زيادة الطول. في الخطوة التالية، ستقيس مقدار الزيادة في الوزن لكل وحدة إضافية من الطول.
تقديرات المربعات الصغرى
في انحدار OLS البسيط، يتم حساب  و الأمر بسيط. هذا الشرح لا يستنتج الصيغ، بل يذكرها فقط.
تريد تقدير: 
الهدف من الانحدار المربعات الصغرى العادية هو تقليل المعادلة التالية:

أين
 هي القيمة الفعلية و
 هي القيمة المتوقعة.
الحل ل is 
نلاحظ أن  يعني متوسط قيمة x
الحل ل  is

في لغة R، يمكنك استخدام الدالتين cov() و var() لتقدير ويمكنك استخدام الدالة mean() للتقدير 
beta <- cov(df$height, df$weight) / var (df$height)
beta
الإخراج:
##[1] 3.45
alpha <- mean(df$weight) - beta * mean(df$height)
alpha
الإخراج:
## [1] -87.51667
يشير معامل بيتا إلى أنه مقابل كل بوصة إضافية في الطول، يزداد متوسط الوزن بمقدار 3.45 رطل.
إن تقدير المعادلة الخطية يدوياً أمر مفيد ولكنه غير عملي. R تُوفّر لك هذه المكتبة الدالة lm() للقيام بذلك، وستستخدمها بدءًا من القسم التالي. في المشاريع الحقيقية، نادرًا ما ستُطبّق نموذجًا ذا مُتنبئ واحد؛ فمهام الانحدار عادةً ما تتضمن العديد من المُقدِّرات في آنٍ واحد.
الانحدار الخطي المتعدد في R
تستخدم التطبيقات العملية لتحليل الانحدار نماذج أكثر تعقيدًا من نموذج الخط المستقيم البسيط. ويُطلق على النموذج الاحتمالي الذي يتضمن أكثر من متغير مستقل واحد اسم نماذج الانحدار المتعددة. والشكل العام لهذا النموذج هو:

في تدوين المصفوفة، يمكنك إعادة كتابة النموذج:

المتغير التابع y أصبح الآن دالة للمتغيرات المستقلة k. قيمة المعامل  يحدد مساهمة المتغير المستقل
 و .
نقدم بإيجاز الافتراض الذي قمنا به حول الخطأ العشوائي  من عملية شريان الحياة:
- يعني يساوي 0
- التباين يساوي

- التوزيع الطبيعي
- الأخطاء العشوائية مستقلة (بالمعنى الاحتمالي)

تحتاج إلى حل ل ، متجه معاملات الانحدار التي تقلل مجموع الأخطاء المربعة بين قيم y المتوقعة والفعلية.
الحل ذو الشكل المغلق هو :

مع:
- يشير إلى تبديل موضع من المصفوفة X
 يشير إلى مصفوفة عكسية
 يشير إلى مصفوفة عكسية
تستخدم الأمثلة أدناه مجموعة بيانات mtcars المدمجة. والهدف هو التنبؤ بعدد الأميال المقطوعة لكل جالون (mpg) من مجموعة من الخصائص.
المتغيرات المستمرة في R
في الوقت الحالي، ستستخدم فقط المتغيرات المستمرة وتضع جانبًا الميزات التصنيفية. المتغير am هو متغير ثنائي يأخذ القيمة 1 إذا كان ناقل الحركة يدويًا و0 للسيارات الأوتوماتيكية؛ vs هو أيضًا متغير ثنائي.
library(dplyr)
df <- mtcars %>%
select(-c(am, vs, cyl, gear, carb))
glimpse(df)
الإخراج:
## Observations: 32
## Variables: 6
## $ mpg  <dbl> 21.0, 21.0, 22.8, 21.4, 18.7, 18.1, 14.3, 24.4, 22.8, 19....
## $ disp <dbl> 160.0, 160.0, 108.0, 258.0, 360.0, 225.0, 360.0, 146.7, 1...
## $ hp   <dbl> 110, 110, 93, 110, 175, 105, 245, 62, 95, 123, 123, 180, ...
## $ drat <dbl> 3.90, 3.90, 3.85, 3.08, 3.15, 2.76, 3.21, 3.69, 3.92, 3.9...
## $ wt   <dbl> 2.620, 2.875, 2.320, 3.215, 3.440, 3.460, 3.570, 3.190, 3...
## $ qsec <dbl> 16.46, 17.02, 18.61, 19.44, 17.02, 20.22, 15.84, 20.00, 2...
يمكنك استخدام الدالة lm() لحساب المعلمات. بناء الجملة الأساسي لهذه الوظيفة هو:
lm(formula, data, subset)
Arguments:
	-formula: The equation you want to estimate
	-data: The dataset used
	-subset: Estimate the model on a subset of the dataset
تذكر أن المعادلة هي من النموذج التالي

في R
- يتم استبدال الرمز = بـ ~
- يتم استبدال كل x باسم المتغير
- إذا كنت تريد إسقاط الثابت، أضف -1 في نهاية الصيغة
على سبيل المثال:
تريد تقدير وزن الأفراد بناءً على طولهم وإيراداتهم. المعادلة هي

المعادلة في R مكتوبة على النحو التالي:
y ~ X1+ X2+…+Xn # مع التقاطع
لذلك بالنسبة لمثالنا:
- الوزن ~ الطول + الإيرادات
هدفك هو تقدير الميل لكل جالون بناءً على مجموعة من المتغيرات. المعادلة المراد تقديرها هي:

سوف تقوم بتقدير الانحدار الخطي الأول الخاص بك وتخزين النتيجة في الكائن المناسب.
model <- mpg ~ disp + hp + drat + wt + qsec
fit <- lm(model, df)
fit
Code تفسير
- model <- mpg ~ disp + hp + drat + wt + qsec: خزّن النموذج لتقدير
- lm(model, df): قم بتقدير النموذج باستخدام إطار البيانات df
##
## Call:
## lm(formula = model, data = df)
##
## Coefficients:
## (Intercept)         disp           hp         drat           wt
##    16.53357      0.00872     -0.02060      2.01577     -4.38546
##        qsec
##     0.64015
لا يوفر الناتج معلومات كافية حول جودة الملاءمة. يمكنك الوصول إلى مزيد من التفاصيل مثل أهمية المعاملات ودرجة الحرية وشكل المتبقيات باستخدام دالة summary().
summary(fit)
الإخراج:
## return the p-value and coefficient
##
## Call:
## lm(formula = model, data = df)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -3.5404 -1.6701 -0.4264  1.1320  5.4996
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) 16.53357   10.96423   1.508  0.14362
## disp         0.00872    0.01119   0.779  0.44281
## hp          -0.02060    0.01528  -1.348  0.18936
## drat         2.01578    1.30946   1.539  0.13579
## wt          -4.38546    1.24343  -3.527  0.00158 **
## qsec         0.64015    0.45934   1.394  0.17523
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 2.558 on 26 degrees of freedom
## Multiple R-squared:  0.8489, Adjusted R-squared:  0.8199
## F-statistic: 29.22 on 5 and 26 DF, p-value: 6.892e-10
الاستدلال من إخراج الجدول أعلاه
- يُظهر الجدول علاقة سلبية قوية بين الوزن ومعدل استهلاك الوقود لكل جالون، ومعامل إيجابي لـ drat.
- فقط المتغير بالوزن له تأثير إحصائي على ميلا في الغالون. تذكر، لاختبار الفرضية في الإحصائية، نستخدم:
- H0: لا يوجد تأثير إحصائي
- H1: المتنبئ له تأثير ملموس على y
- إذا كانت قيمة p أقل من 0.05، فهذا يشير إلى أن المتغير ذو دلالة إحصائية
- معامل التحديد المعدل (R²): هو نسبة التباين في المتغير التابع (y) التي يفسرها النموذج، بعد تصحيحها وفقًا لعدد المتغيرات التنبؤية. هنا، تبلغ قيمته 0.8199، أي أن النموذج يفسر حوالي 82% من تباين معدل استهلاك الوقود (mpg). تتراوح قيمة R² دائمًا بين 0 و1، وكلما ارتفعت كانت القيمة أفضل.
يمكنك تشغيل ANOVA اختبار لتقدير تأثير كل ميزة على التباينات باستخدام دالة Anova().
anova(fit)
الإخراج:
## Analysis of Variance Table
##
## Response: mpg
##           Df Sum Sq Mean Sq  F value   Pr(>F)
## disp       1 808.89  808.89 123.6185 2.23e-11 ***
## hp         1  33.67   33.67   5.1449 0.031854 *
## drat       1  30.15   30.15   4.6073 0.041340 *
## wt         1  70.51   70.51  10.7754 0.002933 **
## qsec       1  12.71   12.71   1.9422 0.175233
## Residuals 26 170.13    6.54
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
الطريقة الأكثر تقليدية لتقدير أداء النموذج هي عرض المتبقي مقابل مقاييس مختلفة.
يمكنك استخدام الدالة مؤامرة () لإظهار أربعة رسوم بيانية:
- القيم المتبقية مقابل القيم المجهزة
- مؤامرة QQ العادية: الربع النظري مقابل المخلفات الموحدة
- موقع المقياس: القيم المجهزة مقابل الجذور التربيعية للبقايا الموحدة
- المخلفات مقابل الرافعة المالية: الرافعة المالية مقابل المخلفات الموحدة
أضف السطر البرمجي par(mfrow = c(2, 2)) قبل الأمر plot(fit). إذا لم تُضف هذا السطر، سيطلب منك برنامج R الضغط على مفتاح الإدخال لعرض الرسم البياني التالي.
par(mfrow = c(2, 2))
Code تفسير
- (mfrow=c(2,2)): قم بإرجاع نافذة بها الرسوم البيانية الأربعة جنبًا إلى جنب.
- يضيف أول 2 عدد الصفوف
- ويضيف الثاني 2 عدد الأعمدة.
- إذا كتبت (mfrow=c(3,2)): ستنشئ نافذة مكونة من 3 صفوف و2 عمود
plot(fit)
الإخراج:

تُعيد دالة lm() قائمةً تحتوي على الكثير من المعلومات المفيدة. يمكنك الوصول إليها باستخدام كائن fit الذي أنشأته، متبوعًا بعلامة $ والمعلومات التي تريد عرضها.tract.
- المعاملات: `معاملات $fit`
- المخلفات: `صالح $ المخلفات`
– القيمة المجهزة: `fit$fitted.values`
عوامل الانحدار في R
في تقدير النموذج الأخير، يمكنك التراجع عن ميل لكل جالون على المتغيرات المستمرة فقط. من السهل إضافة متغيرات العوامل إلى النموذج. يمكنك إضافة المتغير am إلى النموذج الخاص بك. ومن المهم التأكد من أن المتغير هو مستوى عامل وليس مستمرا.
df <- mtcars %>%
    mutate(cyl = factor(cyl),
        vs = factor(vs),
        am = factor(am),
        gear = factor(gear),
        carb = factor(carb))
model <- mpg ~ .
summary(lm(model, df))
الإخراج:
##
## Call:
## lm(formula = model, data = df)
##
## Residuals:
##     Min      1Q  Median      3Q     Max
## -3.5087 -1.3584 -0.0948  0.7745  4.6251
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) 23.87913   20.06582   1.190   0.2525
## cyl6        -2.64870    3.04089  -0.871   0.3975
## cyl8        -0.33616    7.15954  -0.047   0.9632
## disp         0.03555    0.03190   1.114   0.2827
## hp          -0.07051    0.03943  -1.788   0.0939 .
## drat         1.18283    2.48348   0.476   0.6407
## wt          -4.52978    2.53875  -1.784   0.0946 .
## qsec         0.36784    0.93540   0.393   0.6997
## vs1          1.93085    2.87126   0.672   0.5115
## am1          1.21212    3.21355   0.377   0.7113
## gear4        1.11435    3.79952   0.293   0.7733
## gear5        2.52840    3.73636   0.677   0.5089
## carb2       -0.97935    2.31797  -0.423   0.6787
## carb3        2.99964    4.29355   0.699   0.4955
## carb4        1.09142    4.44962   0.245   0.8096
## carb6        4.47757    6.38406   0.701   0.4938
## carb8        7.25041    8.36057   0.867   0.3995
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 2.833 on 15 degrees of freedom
## Multiple R-squared:  0.8931, Adjusted R-squared:  0.779
## F-statistic:  7.83 on 16 and 15 DF,  p-value: 0.000124
يستخدم R مستوى العامل الأول كمجموعة أساسية. تحتاج إلى مقارنة معاملات المجموعة الأخرى بالمجموعة الأساسية.
افتراضات الانحدار الخطي في لغة البرمجة R
لا تُنتج طريقة المربعات الصغرى العادية معاملات وقيم احتمالية موثوقة إلا عند تحقق خمسة شروط. وتُستخدم الرسوم البيانية التشخيصية الأربعة التي ينتجها الأمر plot(fit) تحديدًا للتحقق من هذه الشروط.
- الخطي: العلاقة بين كل متغير تنبؤي و y خطية. تحقق من البواقي مقابل القيم المتوقعة الرسم البياني؛ يعني وجود منحنى مرئي أنك بحاجة إلى تحويل أو حد متعدد الحدود.
- استقلال: تكون حدود الخطأ غير مترابطة. غالبًا ما تنتهك البيانات المرتبة زمنيًا هذا الشرط، ويمكنك اختبار ذلك باستخدام دالة durbinWatsonTest() من حزمة car.
- الشذوذ الجنسي: يكون تباين الخطأ ثابتًا عبر القيم المُقدَّرة. شكل قمعي في تحديد المقياس تشير الحبكة إلى وجود انتهاك.
- توزيع البواقي الطبيعي: تتبع الأخطاء التوزيع الطبيعي. يجب أن تقع النقاط على قطر عادي QQ قطعة.
- لا علاقة خطية متعددة: لا تُعدّ المتغيرات التنبؤية نسخاً متطابقة تقريباً. ويُعتبر عامل تضخم التباين الذي يزيد عن 5 بمثابة خط تحذيري معتاد.
library(car)
vif(fit)           # variance inflation factors
shapiro.test(residuals(fit))   # normality of residuals
لا تؤدي الانتهاكات دائمًا إلى إبطال النموذج، ولكنها تغير مدى ثقتك في قيم p، لذا تحقق منها قبل الإبلاغ عن أي معامل.
كيفية إجراء التنبؤات باستخدام نموذج الانحدار الخطي في لغة البرمجة R
إنّ ملاءمة النموذج ليست سوى نصف المهمة. تقوم الدالة predict() بتطبيق المعاملات الملائمة على المشاهدات الجديدة.
predict(object, newdata, interval = "none", level = 0.95)
arguments:
-object: The model returned by lm()
-newdata: A data frame whose columns match the predictors used in the formula
-interval: "none", "confidence" for the mean response, or "prediction" for a single new case
-level: The confidence level, 0.95 by default
اتبع هذه الخطوات الثلاث.
- قم بإنشاء إطار بيانات للحالات الجديدة. يجب أن تتطابق أسماء الأعمدة مع أسماء المتغيرات التنبؤية في الصيغة تمامًا، ويجب أن تتطابق مستويات العوامل مع بيانات التدريب.
- قم باستدعاء الدالة predict(). قم بتمرير الكائن المُلائم وإطار البيانات الجديد.
- أضف فاصلًا زمنيًا. اختر "الثقة" عندما تريد معرفة عدم اليقين حول متوسط الاستجابة، و"التنبؤ" عندما تريد معرفة النطاق لسيارة واحدة فردية.
new_cars <- data.frame(wt = c(2.5, 3.2), hp = c(110, 175))
fit_final <- lm(mpg ~ wt + hp, data = mtcars)

predict(fit_final, newdata = new_cars)
predict(fit_final, newdata = new_cars, interval = "prediction")
قراءة النتيجة. سيارة تزن 2.5 ألف رطل بقوة 110 حصان يُتوقع أن تستهلك حوالي 24.1 ميلًا للغالون. ويكون نطاق التوقع دائمًا أوسع من نطاق الثقة، لأنه يشمل عدم اليقين الناتج عن قياس واحد بالإضافة إلى عدم اليقين في الخط المُطابق.
هناك قاعدتان أساسيتان لضمان دقة التنبؤات. أولاً، تجنب التعميم خارج نطاق بيانات التدريب، لأن التنبؤات المباشرة لا تستند إلى بيانات واقعية. ثانياً، قيّم النموذج دائماً على بيانات لم يسبق له رؤيتها، وإلا ستكون نسبة الخطأ المُبلغ عنها متفائلة.
الانحدار الخطي مقابل الانحدار اللوجستي في لغة البرمجة R
يلجأ المحللون غالبًا إلى دالة الانحدار الخطي (lm()) عندما لا تكون النتيجة متصلة. يوضح الجدول أدناه موضع الحد الفاصل.
| المعايير | الانحدار الخطي | الانحدار اللوجستي |
|---|---|---|
| متغير الاستجابة | مستمر | ثنائي أو فئوي |
| الناتج المتوقع | أي عدد حقيقي | احتمال يتراوح بين 0 و 1 |
| تقدير | المربعات الصغرى العادية | أقصى احتمالية |
| قياس المقاس | معامل التحديد (R-squared)، جذر متوسط مربع الخطأ (RMSE) | معيار معلومات أكايكي (AIC)، الانحراف، الدقة |
| وظيفة R | lm(formula, data) | glm(formula, data, family = “binomial”) |
إذا كانت النتيجة قرارًا بنعم أو لا، فانتقل إلى نموذج خطي معمم بدلاً من فرض خط مستقيم يمر عبر الأصفار والآحاد.
الانحدار الخطي التدريجي في R
الجزء الأخير من هذا البرنامج التعليمي يتناول الانحدار التدريجي الغرض من هذه الخوارزمية هو إضافة وإزالة المرشحين المحتملين في النماذج والاحتفاظ بالمرشحين الذين لديهم تأثير كبير على المتغير التابع. تكون هذه الخوارزمية مفيدة عندما تحتوي مجموعة البيانات على قائمة كبيرة من المتنبئين. لست بحاجة إلى إضافة وإزالة المتغيرات المستقلة يدويًا. تم بناء الانحدار التدريجي لاختيار أفضل المرشحين لتناسب النموذج.
دعونا نرى عمليًا كيف يعمل. نستخدم مجموعة بيانات mtcars ذات المتغيرات المستمرة فقط لأغراض التوضيح التعليمي. قبل البدء بالتحليل، يُنصح بفحص العلاقات في البيانات باستخدام مصفوفة الارتباط. مكتبة GGally هي امتداد لمكتبة ggplot2.
تتضمن المكتبة وظائف مختلفة لإظهار إحصائيات ملخصة مثل الارتباط والتوزيع لجميع المتغيرات في المصفوفة. سوف نستخدم الدالة ggscatmat، ولكن يمكنك الرجوع إلى المقالة القصيرة لمزيد من المعلومات حول مكتبة GGally.
بناء الجملة الأساسي لـ ggscatmat() هو:
ggscatmat(df, columns = 1:ncol(df), corMethod = "pearson")
arguments:
-df:  A matrix of continuous variables
-columns: Pick up the columns to use in the function. By default, all columns are used
-corMethod: Define the function to compute the correlation between variable. By default, the algorithm uses the Pearson formula
تعرض معاملات الارتباط لجميع متغيراتك وتحدد أيها الأنسب للخطوة الأولى من الانحدار التدريجي. توجد بعض معاملات الارتباط القوية بين متغيراتك والمتغير التابع، وهو معدل استهلاك الوقود (mpg).
library(GGally)
df <- mtcars %>%
	select(-c(am, vs, cyl, gear, carb))
ggscatmat(df, columns = 1: ncol(df))
الإخراج:

مثال على الانحدار التدريجي خطوة بخطوة
يُعد اختيار المتغيرات جزءًا مهمًا من ملاءمة النموذج، ويقوم الانحدار التدريجي بإجراء هذا البحث تلقائيًا. لتقدير عدد الخيارات الممكنة في مجموعة البيانات، يمكنك حساب  مع k هو عدد المتنبئين. يزداد حجم الاحتمالات بزيادة عدد المتغيرات المستقلة. لهذا السبب يجب أن يكون لديك بحث تلقائي.
تحتاج إلى تثبيت حزمة olsrr من CRAN. الحزمة غير متوفرة بعد في اناكوندا. ومن ثم، يمكنك تثبيته مباشرة من سطر الأوامر:
install.packages("olsrr")
يمكنك رسم جميع المجموعات الفرعية من الاحتمالات باستخدام معايير الملاءمة (أي R-square، وR-square المعدلة، والمعايير البايزية). سيكون النموذج ذو أدنى معايير AIC هو النموذج النهائي.
library(olsrr)
model <- mpg~.
fit <- lm(model, df)
test <- ols_all_subset(fit)
plot(test)
Code تفسير
- ميلا في الغالون ~.: بناء النموذج للتقدير
- lm(model, df): تشغيل نموذج المربعات الصغرى العادية
- ols_all_subset(المطابقة): قم بإنشاء الرسوم البيانية بالمعلومات الإحصائية ذات الصلة
- مؤامرة (اختبار): ارسم الرسوم البيانية
الإخراج:

تستخدم نماذج الانحدار الخطي اختبار تي لتقدير الأثر الإحصائي لمتغير مستقل على المتغير التابع، يحدد الباحثون عادةً الحد الأقصى عند 10%، وتشير قيم p المنخفضة إلى ارتباط إحصائي أقوى. يعتمد الانحدار التدريجي على هذا الاختبار لإضافة المتغيرات التنبؤية المحتملة وإزالتها. وتعمل الخوارزمية على النحو التالي:

- الخطوة 1:: تراجع كل متنبئ على y بشكل منفصل. وهي التراجع x_1 على y، x_2 على y إلى x_n. قم بتخزين ف قيمة واحتفظ بالتراجع بقيمة p أقل من العتبة المحددة (0.1 افتراضيًا). سيتم إضافة المتنبئين ذوي الأهمية الأقل من العتبة إلى النموذج النهائي. إذا لم يكن هناك متغير له قيمة p أقل من عتبة الإدخال، فستتوقف الخوارزمية، ويكون لديك النموذج النهائي الخاص بك مع ثابت فقط.
- الخطوة 2::استخدم المتنبئ ذو أقل قيمة p وأضف متغيرًا واحدًا بشكل منفصل. يمكنك إرجاع ثابت وأفضل متنبئ للخطوة الأولى ومتغير ثالث. أضف إلى النموذج التدريجي المتنبئين الجدد بقيمة أقل من عتبة الدخول. إذا لم يكن لأي متغير قيمة p أقل من 0.1، فإن الخوارزمية تتوقف، ولديك النموذج النهائي بمتنبئ واحد فقط. يمكنك إرجاع النموذج التدريجي للتحقق من أهمية أفضل المتنبئين للخطوة الأولى. إذا كان أعلى من عتبة الإزالة، فاحتفظ به في النموذج التدريجي. وإلا، فاستبعده.
- الخطوة 3::يمكنك تكرار الخطوة 2 على أفضل نموذج تدريجي جديد. تضيف الخوارزمية المتنبئين إلى النموذج التدريجي بناءً على القيم المدخلة وتستبعد المتنبئ من النموذج التدريجي إذا لم يلبي حد الاستبعاد.
- تستمر الخوارزمية في العمل حتى لا يمكن إضافة أو استبعاد أي متغير.
بإمكانك تنفيذ الخوارزمية باستخدام الدالة ols_stepwise() من حزمة olsrr.
ols_stepwise(fit, pent = 0.1, prem = 0.3, details = FALSE)

arguments:
-fit:  Model to fit. Need to use `lm()`before to run `ols_stepwise()
-pent: Threshold of the p-value used to enter a variable into the stepwise model. By default, 0.1
-prem: Threshold of the p-value used to exclude a variable into the stepwise model. By default, 0.3
-details: Print the details of each step
⚠️ ملاحظة بخصوص العبوة: أعادت الإصدارات الحديثة من olsrr تسمية هذه الدوال. استخدم ols_step_all_possible() بدلاً من ols_all_subset() و ols_step_both_p() بدلاً من ols_stepwise(). لم تتغير الوسائط والمخرجات.
وقبل ذلك نعرض لكم خطوات الخوارزمية. وفيما يلي جدول بالمتغيرات التابعة والمستقلة:
| المتغير التابع | المتغيرات المستقلة |
|---|---|
| ميلا في الغالون | يمكن التخلص |
| hp | |
| درات | |
| wt | |
| com.qsec |
بالبداية
في البداية، تبدأ الخوارزمية بتشغيل النموذج على كل متغير مستقل على حدة. ويبين الجدول القيمة p لكل نموذج.
## [[1]]
##  (Intercept)         disp
## 3.576586e-21 9.380327e-10
##
## [[2]]
##  (Intercept)           hp
## 6.642736e-18 1.787835e-07
##
## [[3]]
##  (Intercept)         drat
## 0.1796390847 0.0000177624
##
## [[4]]
##  (Intercept)           wt
## 8.241799e-19 1.293959e-10
##
## [[5]
## (Intercept)        qsec
##  0.61385436  0.01708199
للدخول إلى النموذج، تحافظ الخوارزمية على المتغير ذي القيمة p الأدنى. من الناتج أعلاه، هو بالوزن
خطوة 1
في الخطوة الأولى، تقوم الخوارزمية بتشغيل ميلا في الغالون على الوزن والمتغيرات الأخرى بشكل مستقل.
## [[1]]
##  (Intercept)           wt         disp
## 4.910746e-16 7.430725e-03 6.361981e-02
##
## [[2]]
##  (Intercept)           wt           hp
## 2.565459e-20 1.119647e-06 1.451229e-03
##
## [[3]]
##  (Intercept)           wt         drat
## 2.737824e-04 1.589075e-06 3.308544e-01
##
## [[4]]
##  (Intercept)           wt         qsec
## 7.650466e-04 2.518948e-11 1.499883e-03
كل متغير مرشح محتمل للدخول في النموذج النهائي. مع ذلك، يحتفظ البرنامج فقط بالمتغير ذي قيمة الاحتمالية الأقل. اتضح أن قيمة الاحتمالية لـ hp أقل بقليل من قيمة الاحتمالية لـ qsec، لذا يدخل hp في النموذج النهائي.
خطوة 2
تكرر الخوارزمية الخطوة الأولى ولكن هذه المرة مع متغيرين مستقلين في النموذج النهائي.
## [[1]]
##  (Intercept)           wt           hp         disp
## 1.161936e-16 1.330991e-03 1.097103e-02 9.285070e-01
##
## [[2]]
##  (Intercept)           wt           hp         drat
## 5.133678e-05 3.642961e-04 1.178415e-03 1.987554e-01
##
## [[3]]
##  (Intercept)           wt           hp         qsec
## 2.784556e-03 3.217222e-06 2.441762e-01 2.546284e-01
لا يوجد أي مرشح من المرشحين المتبقين لديه قيمة احتمالية أقل من عتبة الدخول. تتوقف الخوارزمية هنا، وهذا هو النموذج النهائي:
##
## Call:
## lm(formula = mpg ~ wt + hp, data = df)
##
## Residuals:
##    Min     1Q Median     3Q    Max
## -3.941 -1.600 -0.182  1.050  5.854
##
## Coefficients:
##             Estimate Std. Error t value Pr(>|t|)
## (Intercept) 37.22727    1.59879  23.285  < 2e-16 ***
## wt          -3.87783    0.63273  -6.129 1.12e-06 ***
## hp          -0.03177    0.00903  -3.519  0.00145 **
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 2.593 on 29 degrees of freedom
## Multiple R-squared:  0.8268, Adjusted R-squared:  0.8148
## F-statistic: 69.21 on 2 and 29 DF,  p-value: 9.109e-12
بإمكانك استخدام الدالة ols_stepwise() لمقارنة النتائج.
stp_s <-ols_stepwise(fit, details=TRUE)
الإخراج:
تجد الخوارزمية حلاً بعد خطوتين وتعيد نفس المخرجات التي تم الحصول عليها من خلال الشرح اليدوي أعلاه.
وبالتالي، يتم تفسير النموذج النهائي بواسطة متغيرين تنبؤيين ونقطة تقاطع: يرتبط عدد الأميال لكل جالون بشكل سلبي بكل من القدرة الحصانية الإجمالية والوزن.
## You are selecting variables based on p value...
## 1 variable(s) added....
## Variable Selection Procedure
##  Dependent Variable: mpg
##
##  Stepwise Selection: Step 1
##
##  Variable wt Entered
##
##                         Model Summary
## --------------------------------------------------------------
## R                       0.868       RMSE                3.046
## R-Squared               0.753       Coef. Var          15.161
## Adj. R-Squared          0.745       MSE                 9.277
## Pred R-Squared          0.709       MAE                 2.341
## --------------------------------------------------------------
##  RMSE: Root Mean Square Error
##  MSE: Mean Square Error
##  MAE: Mean Absolute Error
##		ANOVA
## --------------------------------------------------------------------
##                 Sum of
##                Squares        DF    Mean Square      F         Sig.
## --------------------------------------------------------------------
## Regression     847.725         1        847.725    91.375    0.0000
## Residual       278.322        30          9.277
## Total         1126.047        31
## --------------------------------------------------------------------
##
##                                   Parameter Estimates
## ----------------------------------------------------------------------------------------
##       model      Beta    Std. Error    Std. Beta      t        Sig      lower     upper
## ----------------------------------------------------------------------------------------
## (Intercept)    37.285         1.878                 19.858    0.000    33.450    41.120
##          wt    -5.344         0.559       -0.868    -9.559    0.000    -6.486    -4.203
## ----------------------------------------------------------------------------------------
## 1 variable(s) added...
## Stepwise Selection: Step 2
##
##  Variable hp Entered
##
##                         Model Summary
## --------------------------------------------------------------
## R                       0.909       RMSE                2.593
## R-Squared               0.827       Coef. Var          12.909
## Adj. R-Squared          0.815       MSE                 6.726
## Pred R-Squared          0.781       MAE                 1.901
## --------------------------------------------------------------
##  RMSE: Root Mean Square Error
##  MSE: Mean Square Error
##  MAE: Mean Absolute Error
##			ANOVA
## --------------------------------------------------------------------
##                 Sum of
##                Squares        DF    Mean Square      F         Sig.
## --------------------------------------------------------------------
## Regression     930.999         2        465.500    69.211    0.0000
## Residual       195.048        29          6.726
## Total         1126.047        31
## --------------------------------------------------------------------
##
##                                   Parameter Estimates
## ----------------------------------------------------------------------------------------
##       model      Beta    Std. Error    Std. Beta      t        Sig      lower     upper
## ----------------------------------------------------------------------------------------
## (Intercept)    37.227         1.599                 23.285    0.000    33.957    40.497
##          wt    -3.878         0.633       -0.630    -6.129    0.000    -5.172    -2.584
##          hp    -0.032         0.009       -0.361    -3.519    0.001    -0.050    -0.013
## ----------------------------------------------------------------------------------------
## No more variables to be added or removed.
الانحدار الخطي في لغة R: أهم النقاط الرئيسية ومراجعة الدوال
- يجيب الانحدار الخطي على سؤال بسيط: هل يمكنك قياس علاقة دقيقة بين متغير مستهدف واحد ومجموعة من المتغيرات التنبؤية؟
- تجد طريقة المربعات الصغرى العادية المعلمات التي تقلل من مجموع مربعات الأخطاء، أي المسافة الرأسية بين قيم y المتوقعة وقيم y الفعلية.
- ويسمى النموذج الاحتمالي الذي يتضمن أكثر من متغير مستقل نماذج الانحدار المتعددة.
- الغرض من خوارزمية الانحدار الخطي التدريجي هو إضافة وإزالة المرشحين المحتملين في النماذج والاحتفاظ بالذين لديهم تأثير كبير على المتغير التابع.
- يُعد اختيار المتغيرات جزءًا مهمًا من ملاءمة النموذج، ويقوم الانحدار التدريجي بإجراء هذا البحث تلقائيًا.
جميع الوظائف المستخدمة في هذا البرنامج التعليمي مدرجة أدناه:
| المكتبة | الهدف | الوظيفة | الحجج |
|---|---|---|---|
| قاعدة | حساب الانحدار الخطي | لم () | الصيغة والبيانات |
| قاعدة | تلخيص النموذج | ملخص() | تناسب |
| قاعدة | Extracمعاملات t | معامل lm()$ | |
| قاعدة | Extracبواقي t | lm()$المخلفات | |
| قاعدة | Extracالقيمة المُقاسة | lm()$fitted.values | |
| olsrr | تشغيل الانحدار التدريجي | ols_stepwise() | مناسب، pent = 0.1، prem = 0.3، details = FALSE |
ملاحظاتتذكر تحويل المتغيرات الفئوية إلى عوامل قبل تركيب النموذج.
