
وظائف في برمجة R مع مثال
 إيفلين كلارك
⚡ ملخص ذكي
تُجمّع الدوال في لغة R مجموعة من التعليمات تحت اسم واحد، بحيث يتم تنفيذ مهمة متكررة من خلال استدعاء واحد. تتضمن هذه الدوال أدوات مساعدة مدمجة في الرياضيات والإحصاء، ودوالًا مُعرّفة من قِبل المستخدم، وبيئة scopingويتم تغطية الحجج الشرطية هنا مع أمثلة محلولة.
ما هي الوظيفة في R؟
A وظيفة، في بيئة البرمجة، عبارة عن مجموعة من التعليمات. يقوم المبرمج ببناء وظيفة لتجنبها تكرار نفس المهمة، أو تقليل تعقيد.
يجب أن تكون وظيفة
- مكتوب لتنفيذ مهمة محددة
- قد تتضمن أو لا تتضمن الحجج
- تحتوي على جسد
- قد تُرجع قيمة واحدة أو أكثر، أو قد لا تُرجع أي قيمة.
النهج العام للوظيفة هو استخدام جزء الوسيطة المدخلات، اطعم ال الجسد جزء وأخيرا العودة الناتج. بناء جملة الدالة هو التالي:
function (arglist)  {
  #Function body
}
R وظائف مدمجة مهمة
هناك الكثير من الوظائف المضمنة في R. يقوم R بمطابقة معلمات الإدخال الخاصة بك مع وسيطات الوظيفة الخاصة به، إما من خلال القيمة أو حسب الموضع، ثم ينفذ نص الوظيفة. يمكن أن تحتوي وسائط الدالة على قيم افتراضية: إذا لم تحدد هذه الوسائط، فسوف يأخذ R القيمة الافتراضية.
ملاحظات:
من الممكن رؤية الكود المصدري للوظيفة عن طريق تشغيل اسم الوظيفة نفسها في وحدة التحكم.
Typing اسم الدالة بدون أقواس يطبع مصدرها، كما هو موضح في وحدة التحكم أدناه.

سوف نرى ثلاث مجموعات من الوظائف في العمل
- الوظيفة العامة
- وظيفة الرياضيات
- الوظيفة الإحصائية
وظائف عامة
نحن على دراية بالفعل بالوظائف العامة مثل cbind() و rbind() و range()، فرز()و order(). لكل من هذه الدوال مهمة محددة، وتأخذ وسائط لإرجاع مخرجات. فيما يلي دوال مهمة يجب معرفتها:
دالة فرق ().
إذا كنت تعمل السلاسل الزمنية، تحتاج إلى تثبيت السلسلة عن طريق أخذها قيم التأخر. A عملية ثابتة يُتيح ذلك ثبات المتوسط والتباين والارتباط الذاتي بمرور الوقت، مما يُحسّن بشكل أساسي من دقة التنبؤ بالسلاسل الزمنية. يُمكن تحقيق ذلك باستخدام دالة diff(). يُمكننا إنشاء بيانات سلسلة زمنية عشوائية ذات اتجاه، ثم استخدام دالة diff() لتثبيت السلسلة. تقبل دالة diff() وسيطًا واحدًا، وهو متجه، وتُعيد الفروق المتأخرة والمتكررة المناسبة.
ملاحظاتنحتاج غالبًا إلى إنشاء بيانات عشوائية، ولكن لأغراض التعلم والمقارنة، نرغب في أن تكون الأرقام متطابقة على جميع الأجهزة. ولضمان توليد نفس البيانات، نستخدم الدالة set.seed() بقيمة عشوائية 123. تُثبّت الدالة set.seed() نقطة البداية لمولد الأرقام شبه العشوائية، بحيث يُنتج كل جهاز نفس التسلسل. بدون استخدام الدالة set.seed()، تُنتج كل عملية تشغيل تسلسلًا مختلفًا.
set.seed(123)
## Create the data
x = rnorm(1000)
ts <- cumsum(x)
## Stationary the serie
diff_ts <- diff(ts)
par(mfrow=c(1,2))
## Plot the series
plot(ts, type='l')
plot(diff(ts), type='l')
تضع اللوحتان أدناه السلسلة التراكمية الأصلية بجوار السلسلة المشتقة، والتي تتذبذب الآن حول متوسط ثابت.

دالة الطول ().
في كثير من الحالات، نرغب بمعرفة طول متجه لإجراء عمليات حسابية أو لاستخدامه في حلقة تكرارية. تقوم الدالة length() بحساب عدد الصفوف في المتجه x. تستورد الأكواد التالية مجموعة بيانات السيارات وتعيد عدد الصفوف.
ملاحظاتتُعيد الدالة length() عدد العناصر في المتجه. إذا تم تمرير الدالة إلى البخور أو إطار بيانات، يتم إرجاع عدد الأعمدة.
dt <- cars
## number columns
length(dt)
الإخراج:
## [1] 1
## number rows
length(dt[,1])
الإخراج:
## [1] 50
وظائف الرياضيات
بالإضافة إلى الأدوات المساعدة العامة، تحتوي لغة R على مجموعة من الدوال الرياضية التي تعمل عنصرًا تلو الآخر على متجه.
| المُشغل | الوصف |
|---|---|
| القيمة المطلقة (x) | تأخذ القيمة المطلقة لـ x |
| سجل (س ، قاعدة = ص) | تأخذ لوغاريتم x للقاعدة y ؛ إذا لم يتم تحديد الأساس ، يتم إرجاع اللوغاريتم الطبيعي |
| إكسب (x) | إرجاع أسي x |
| الجذر التربيعي (x) | إرجاع الجذر التربيعي لـ x |
| مضروب (خ) | إرجاع مضروب x (x!) |
# sequence of number from 44 to 55 both including incremented by 1
x_vector <- seq(45,55, by = 1)
#logarithm
log(x_vector)
الإخراج:
##  [1] 3.806662 3.828641 3.850148 3.871201 3.891820 3.912023 3.931826
##  [8] 3.951244 3.970292 3.988984 4.007333
#exponential
exp(x_vector)
#squared root
sqrt(x_vector)
الإخراج:
##  [1] 6.708204 6.782330 6.855655 6.928203 7.000000 7.071068 7.141428
##  [8] 7.211103 7.280110 7.348469 7.416198
#factorial
factorial(x_vector)
الإخراج:
##  [1] 1.196222e+56 5.502622e+57 2.586232e+59 1.241392e+61 6.082819e+62
##  [6] 3.041409e+64 1.551119e+66 8.065818e+67 4.274883e+69 2.308437e+71
## [11] 1.269640e+73
الدالات الإحصائية
بينما تقوم الدوال الرياضية بتحويل القيم، تقوم الدوال الإحصائية بتلخيصها. يحتوي برنامج R القياسي على مجموعة واسعة من الدوال الإحصائية. في هذا الدرس، سنلقي نظرة سريعة على أهمها.
الوظائف الإحصائية الأساسية
| المُشغل | الوصف |
|---|---|
| يعني (س) | يعني س |
| الوسيط (x) | متوسط x |
| فار (خ) | تباين x |
| التنمية المستدامة (خ) | الانحراف المعياري لـ x |
| مقياس (خ) | الدرجات القياسية (z-scores) لـ x |
| الكمي (س) | ربعيات x |
| ملخص(خ) | ملخص x: المتوسط، الحد الأدنى، الحد الأقصى وما إلى ذلك. |
speed <- dt$speed
speed
# Mean speed of cars dataset
mean(speed)
الإخراج:
## [1] 15.4
# Median speed of cars dataset
median(speed)
الإخراج:
## [1] 15
# Variance speed of cars dataset
var(speed)
الإخراج:
## [1] 27.95918
# Standard deviation speed of cars dataset
sd(speed)
الإخراج:
## [1] 5.287644
# Standardize vector speed of cars dataset
head(scale(speed), 5)
الإخراج:
##           [,1]
## [1,] -2.155969
## [2,] -2.155969
## [3,] -1.588609
## [4,] -1.588609
## [5,] -1.399489
# Quantile speed of cars dataset
quantile(speed)
الإخراج:
##   0%  25%  50%  75% 100%
##    4   12   15   19   25
# Summary speed of cars dataset
summary(speed)
الإخراج:
##    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
##     4.0    12.0    15.0    15.4    19.0    25.0
حتى هذه اللحظة، تعلمنا الكثير من وظائف R المضمنة.
ملاحظاتكن حذرًا مع نوع الحجةأي رقمي أو منطقي أو نصي. على سبيل المثال، إذا احتجنا إلى تمرير قيمة نصية، فسنحتاج إلى وضع النص بين علامتي اقتباس: "ABC".
وظيفة الكتابة في R
في بعض الأحيان، نحتاج إلى كتابة دالة خاصة بنا لأننا مطالبون بإنجاز مهمة معينة ولا توجد دالة جاهزة. تتضمن الدالة المعرفة من قبل المستخدم... الاسم, الحجج و الجسد.
function.name <- function(arguments)
{
    computations on the arguments
    some other code
}
ملاحظات: من الممارسات الجيدة تسمية دالة معرفة من قبل المستخدم تختلف عن الوظيفة المضمنة. إنه يتجنب الارتباك.
وظيفة وسيطة واحدة
في المقتطف التالي، نحدد دالة مربعة بسيطة. تقبل الدالة قيمة وترجع مربع القيمة.
square_function<- function(n)
{
  # compute the square of integer `n`
  n^2
}
# calling the function and passing value 4
square_function(4)
Code تفسير
- تم تسمية الدالة بـ Square_function؛ يمكن أن نسميها ما نريد.
- يتلقى الوسيطة "ن". نحن لم يحدد نوع المتغير حتى يتمكن المستخدم من تمرير عدد صحيح أو متجه أو مصفوفة
- تأخذ الدالة الإدخال "n" وترجع مربع الإدخال. عند الانتهاء من استخدام الدالة، يمكننا إزالتها باستخدام الدالة rm().
# بعد إنشاء الوظيفة
rm(square_function)
square_function
على وحدة التحكم، يمكننا رؤية رسالة خطأ: خطأ: لم يتم العثور على الكائن 'square_function' مما يشير إلى أن الوظيفة غير موجودة.
وزارة البيئةping
في ر، بيئة هي مجموعة من الكائنات مثل الدوال والمتغيرات وإطارات البيانات وما إلى ذلك.
يقوم برنامج R بفتح بيئة في كل مرة يتم فيها تشغيل RStudio.
بيئة المستوى الأعلى المتاحة هي البيئة العالمية، ويُسمى R_GlobalEnv. ولدينا البيئة المحلية.
يمكننا سرد محتوى البيئة الحالية.
ls(environment())
الناتج
## [1] "diff_ts"         "dt"              "speed"           "square_function"
## [5] "ts"              "x"               "x_vector"
يمكنك رؤية جميع المتغيرات والوظائف التي تم إنشاؤها في ملف R_GlobalEnv.
ستختلف القائمة أعلاه بالنسبة لك بناءً على الكود السابق الذي تقوم بتنفيذه في RStudio.
نلاحظ أن n، وسيط الدالة square_function ليس موجودًا في هذه البيئة العامة.
يتم إنشاء بيئة جديدة لكل دالة. في المثال أعلاه، تقوم الدالة square_function() بإنشاء بيئة جديدة داخل البيئة العالمية.
لتوضيح الفرق بين شامل و محلي لندرس المثال التالي في مجال البيئة
تأخذ هذه الوظيفة قيمة x كوسيطة وتضيفها إلى تعريف y خارج الوظيفة وداخلها

تقوم الدالة f بإرجاع الإخراج 15. وذلك لأن y تم تعريفه في البيئة العالمية. يمكن استخدام أي متغير محدد في البيئة العالمية محليًا. المتغير y له قيمة 10 أثناء كافة استدعاءات الوظائف ويمكن الوصول إليه في أي وقت.
دعونا نرى ما سيحدث إذا تم تعريف المتغير y داخل الدالة.
نحن بحاجة إلى إسقاط `y` قبل تشغيل هذا الرمز باستخدام rm r
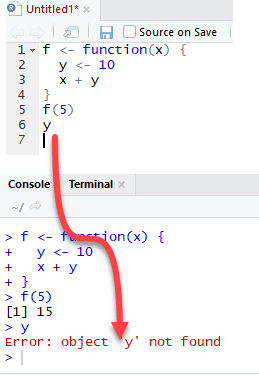
يكون الناتج أيضًا 15 عندما نستدعي f(5) ولكنه يُرجع خطأ عندما نحاول طباعة القيمة y. المتغير y غير موجود في البيئة العالمية.
أخيرًا، يستخدم R أحدث تعريف للمتغيرات لتمريره داخل نص الدالة. دعنا نفكر في المثال التالي:

يتجاهل R قيم y المحددة خارج الدالة لأننا أنشأنا متغيرًا صريحًا داخل نص الدالة.
وظيفة الوسائط المتعددة
يمكننا كتابة دالة بأكثر من وسيطة. خذ بعين الاعتبار الوظيفة التي تسمى "الأوقات". إنها دالة مباشرة تقوم بضرب متغيرين.
times <- function(x,y) {
  x*y
	}
times(2,4)
الإخراج:
## [1] 8
متى يجب أن نكتب الدالة؟
يحتاج علماء البيانات إلى القيام بالعديد من المهام المتكررة. في أغلب الأحيان، نقوم بنسخ ولصق أجزاء من التعليمات البرمجية بشكل متكرر. على سبيل المثال، يُنصح بشدة بتطبيع متغير قبل تشغيله. آلة التعلم خوارزمية. صيغة تطبيع المتغير هي:

نحن نعرف بالفعل كيفية استخدام الدالتين min() وmax() في R. نستخدم مكتبة tibble لإنشاء إطار البيانات. تعتبر Tibble حتى الآن الوظيفة الأكثر ملاءمة لإنشاء مجموعة بيانات من البداية.
library(tibble)
# Create a data frame
data_frame <- tibble(
  c1 = rnorm(50, 5, 1.5),
  c2 = rnorm(50, 5, 1.5),
  c3 = rnorm(50, 5, 1.5),
)
سنتبع خطوتين لحساب الدالة المذكورة أعلاه. في الخطوة الأولى، سننشئ متغيرًا باسم c1_norm، وهو عبارة عن إعادة تحجيم للمتغير c1. في الخطوة الثانية، سننسخ ونلصق كود c1_norm ونستبدله بالمتغيرين c2 و c3.
تفاصيل الدالة مع العمود c1:
المُرشِح: : data_frame$c1 -min(data_frame$c1))
المقام: الحد الأقصى (data_frame$c1)-min(data_frame$c1))
ولذلك، يمكننا تقسيمها للحصول على القيمة الطبيعية للعمود c1:
(data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
يمكننا إنشاء c1_norm وc2_norm وc3_norm:
Create c1_norm: rescaling of c1
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
# show the first five values
head(data_frame$c1_norm, 5)
الإخراج:
## [1] 0.3400113 0.4198788 0.8524394 0.4925860 0.5067991
إنها تعمل. يمكننا النسخ واللصق
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
ثم قم بتغيير c1_norm إلى c2_norm وc1 إلى c2. نحن نفعل الشيء نفسه لإنشاء c3_norm
data_frame$c2_norm <- (data_frame$c2 - min(data_frame$c2))/(max(data_frame$c2)-min(data_frame$c2))
data_frame$c3_norm <- (data_frame$c3 - min(data_frame$c3))/(max(data_frame$c3)-min(data_frame$c3))
لقد قمنا بإعادة قياس المتغيرات c1 وc2 وc3 بشكل مثالي.
مع ذلك، هذه الطريقة عرضة للأخطاء. فقد ننسخ الكود وننسى تغيير اسم العمود بعد لصقه. لذا، من الأفضل كتابة دالة في كل مرة نحتاج فيها إلى لصق نفس الكود أكثر من مرتين. يمكننا إعادة ترتيب الكود في صيغة واستدعائها عند الحاجة. لكتابة دالتنا الخاصة، نحتاج إلى:
- الاسم: normalize.
- عدد الوسائط: نحتاج فقط إلى وسيطة واحدة، وهي العمود الذي نستخدمه في حساباتنا.
- الجسد: هذه ببساطة هي الصيغة التي نريد إرجاعها.
سنتابع خطوة بخطوة لإنشاء وظيفة التطبيع.
الخطوة 1) نُنشئ البسط، وهو x – min(x). في لغة R، يُمكننا تخزين البسط في متغير على النحو التالي:
nominator <- x-min(x)
الخطوة 2) نحسب المقام: max(x) – min(x). يمكننا تكرار فكرة الخطوة 1 وتخزين الحساب في متغير.
denominator <- max(x)-min(x)
الخطوة 3) نقوم بإجراء القسمة بين المقام والمقام.
normalize <- nominator/denominator
الخطوة 4) لإرجاع قيمة إلى دالة الاستدعاء، نحتاج إلى تمرير التطبيع داخل return() للحصول على مخرجات الدالة.
return(normalize)
الخطوة 5) نحن جاهزون لاستخدام الدالة عن طريق التغليفping كل شيء داخل القوس.
normalize <- function(x){
  # step 1: create the nominator
  nominator <- x-min(x)
  # step 2: create the denominator
  denominator <- max(x)-min(x)
  # step 3: divide nominator by denominator
  normalize <- nominator/denominator
  # return the value
  return(normalize)
}
دعونا نختبر وظيفتنا مع المتغير c1:
normalize(data_frame$c1)
إنه يعمل بشكل مثالي. لقد أنشأنا وظيفتنا الأولى.
تُعدّ الدالة طريقةً أكثر شموليةً لأداء مهمة متكررة. يمكننا استخدام صيغة التطبيع على أعمدة مختلفة، كما يلي:
data_frame$c1_norm_function <- normalize (data_frame$c1)
data_frame$c2_norm_function <- normalize	(data_frame$c2)
data_frame$c3_norm_function <- normalize	(data_frame$c3)
على الرغم من بساطة المثال، إلا أنه يُظهر قوة الصيغة. الكود أعلاه أسهل في القراءة ويتجنب الأخطاء المصاحبة للصق الكود.
وظائف مع الشرط
تؤدي الدالة normalize() دائمًا نفس الوظيفة. أحيانًا، نحتاج إلى تضمين شروط في الدالة للسماح للبرنامج بإرجاع مخرجات مختلفة.
في مهام التعلم الآلي، نحتاج إلى تقسيم مجموعة البيانات بين مجموعة قطار ومجموعة اختبار. تسمح مجموعة القطار للخوارزمية بالتعلم من البيانات. من أجل اختبار أداء نموذجنا، يمكننا استخدام مجموعة الاختبار لإرجاع مقياس الأداء. ليس لدى R وظيفة لإنشاء مجموعتين من البيانات. يمكننا كتابة دالتنا الخاصة للقيام بذلك. تأخذ وظيفتنا وسيطتين وتسمى Split_data (). الفكرة وراء ذلك بسيطة، حيث نقوم بضرب طول مجموعة البيانات (أي عدد الملاحظات) بـ 0.8. على سبيل المثال، إذا أردنا تقسيم مجموعة البيانات بنسبة 80/20، وكانت مجموعة البيانات الخاصة بنا تحتوي على 100 صف، فسوف تضرب وظيفتنا 0.8*100 = 80. وسيتم اختيار 80 صفًا لتصبح بيانات التدريب الخاصة بنا.
سوف نستخدم مجموعة بيانات جودة الهواء لاختبار الوظيفة المحددة من قبل المستخدم. تحتوي مجموعة بيانات جودة الهواء على 153 صفًا. يمكننا رؤيته من خلال الكود أدناه:
nrow(airquality)
الإخراج:
## [1] 153
سنتصرف على النحو التالي:
split_data <- function(df, train = TRUE)
Arguments:
-df: Define the dataset
-train: Specify if the function returns the train set or test set. By default, set to TRUE
تحتوي دالتنا على وسيطتين. الوسيطة train هي معلمة منطقية. إذا تم تعيينها على TRUE، فإن دالتنا تنشئ مجموعة بيانات train، وإلا فإنها تنشئ مجموعة بيانات الاختبار.
يمكننا المتابعة كما فعلنا مع دالة normalize(). نكتب الكود كما لو كان يُنفذ لمرة واحدة فقط، ثم نُغلّف كل شيء بالشرط داخل جسم الدالة لإنشاء الدالة.
الخطوة 1 :
نحن بحاجة لحساب طول مجموعة البيانات. يتم ذلك باستخدام الدالة nrow (). تقوم الدالة Nrow بإرجاع إجمالي عدد الصفوف في مجموعة البيانات. نحن نسمي الطول المتغير.
length<- nrow(airquality)
length
الإخراج:
## [1] 153
الخطوة 2 :
نضرب الطول في 0.8. سيعود عدد الصفوف التي سيتم تحديدها. ينبغي أن يكون 153*0.8 = 122.4
total_row <- length*0.8
total_row
الإخراج:
## [1] 122.4
نريد تحديد 122 صفًا من بين 153 صفًا في مجموعة بيانات جودة الهواء. نقوم بإنشاء قائمة تحتوي على قيم من 1 إلى Total_row. نقوم بتخزين النتيجة في المتغير المسمى سبليت
split <- 1:total_row
split[1:5]
الإخراج:
## [1] 1 2 3 4 5
يختار التقسيم أول 122 صفًا من مجموعة البيانات. على سبيل المثال، يمكننا أن نرى أن تقسيم المتغير يجمع القيم 1، 2، 3، 4، 5، وهكذا. ستكون هذه القيم بمثابة الفهرس عندما نختار الصفوف المراد إرجاعها.
الخطوة 3 :
نحن بحاجة إلى تحديد الصفوف في مجموعة بيانات جودة الهواء بناءً على القيم المخزنة في متغير الانقسام. يتم ذلك على النحو التالي:
train_df <- airquality[split, ]
head(train_df)
الإخراج:
##[1]    Ozone Solar.R Wind Temp Month Day
##[2]  51    13     137 10.3   76     6  20
##[3]  15    18      65 13.2   58     5  15
##[4]  64    32     236  9.2   81     7   3
##[5]  27    NA      NA  8.0   57     5  27
##[6]  58    NA      47 10.3   73     6  27
##[7]  44    23     148  8.0   82     6  13
الخطوة 4 :
يمكننا إنشاء مجموعة بيانات الاختبار باستخدام الصفوف المتبقية، 123:153. يتم ذلك باستخدام – أمام الانقسام.
test_df <- airquality[-split, ]
head(test_df)
الإخراج:
##[1] Ozone Solar.R Wind Temp Month Day
##[2]  123    85     188  6.3   94     8  31
##[3]  124    96     167  6.9   91     9   1
##[4]  125    78     197  5.1   92     9   2
##[5]  126    73     183  2.8   93     9   3
##[6]  127    91     189  4.6   93     9   4
##[7]  128    47      95  7.4   87     9   5
الخطوة 5 :
يمكننا إنشاء الشرط داخل نص الوظيفة. تذكر، لدينا مجموعة وسيطات تم تعيينها منطقيًا على TRUE افتراضيًا لإرجاع مجموعة القطارات. لإنشاء الشرط نستخدم صيغة if:
  if (train ==TRUE){
    train_df <- airquality[split, ]
      return(train)
  } else {
    test_df <- airquality[-split, ]
      return(test)
  }
هذا هو، يمكننا كتابة الدالة. نحتاج فقط إلى تغيير جودة الهواء إلى df لأننا نريد تجربة وظيفتنا على أي حال إطار البياناتليس فقط جودة الهواء:
split_data <- function(df, train = TRUE){
  length<- nrow(df)
  total_row <- length *0.8
  split <- 1:total_row
  if (train ==TRUE){
    train_df <- df[split, ]
      return(train_df)
  } else {
    test_df <- df[-split, ]
      return(test_df)
  }
}
لنجرب دالتنا على مجموعة بيانات جودة الهواء. يجب أن يكون لدينا مجموعة تدريب واحدة تحتوي على 122 صفًا ومجموعة اختبار تحتوي على 31 صفًا.
train <- split_data(airquality, train = TRUE)
dim(train)
الإخراج:
## [1] 122 6
test <- split_data(airquality, train = FALSE)
dim(test)
الإخراج:
## [1] 31 6
