
PyTorالفصل التعليمي
 فريق التحرير
⚡ ملخص ذكي
PyTorch هو إطار عمل التعلم العميق مفتوح المصدر من ميتا، والذي يدعم الآن 85 بالمائة من أوراق البحث في مجال الذكاء الاصطناعي في عام 2026. Lessتغطي هذه الدورة التدريبية التثبيت، وأساسيات الإطار، والانحدار البسيط، وتصنيف الصور، ونشر AWS SageMaker.
ما هو بيTorالفصل؟
PyTorch هو مصدر مفتوح Torمكتبة تعلم الآلة القائمة على ch لمعالجة اللغة الطبيعية باستخدام Pythonيشبه NumPy ولكنه يتميز بدعم قوي لوحدات معالجة الرسومات (GPU). يوفر رسومًا بيانية حسابية ديناميكية يمكنك تعديلها أثناء العمل باستخدام autograd.pyTorكما أن ch أسرع من بعض الأطر الأخرى. وقد طُوِّر بواسطة مجموعة أبحاث الذكاء الاصطناعي التابعة لشركة فيسبوك في عام 2016.
معرفة ما هو بايثونTorيقدم هذا التقرير نظرة متوازنة على نقاط قوته وعيوبه.
PyTorالفصل: المزايا والعيوب
فيما يلي مزايا وعيوب لغة بايثونTorالفصل:
مزايا بايثونTorch
- مكتبة بسيطة
PyTorكود ch بسيط وسهل الفهم، ويمكنك استخدام المكتبة فورًا. على سبيل المثال، انظر إلى مقتطف الكود أدناه:
class Net(torch.nn.Module):
   def __init__(self):
       super(Net, self).__init__()
       self.layer = torch.nn.Linear(1, 1)

   def forward(self, x):
       x = self.layer(x)
       return x
كما ذكرنا أعلاه، يمكنك تحديد نموذج الشبكة بسهولة، ويمكنك فهم الكود بسرعة دون الكثير من التدريب.
- الرسم البياني الحسابي الديناميكي

مصدر الصورة: استكشاف التعلم العميق باستخدام بايثونTorch
PyTorتقدم ch الرسوم البيانية الحسابية الديناميكية (DAG). الرسوم البيانية الحسابية هي طريقة للتعبير عن التعبيرات الرياضية في نماذج أو نظريات بيانية مثل العقد والحواف. تقوم العقدة بإجراء العملية الحسابية، والحافة عبارة عن موتر يتم إدخاله إلى العقد ويحمل مخرجات العقدة كموتر.
DAG عبارة عن رسم بياني يحمل شكلًا عشوائيًا وقادرًا على إجراء عمليات بين رسوم بيانية إدخال مختلفة. في كل تكرار، يتم إنشاء رسم بياني جديد. لذا، من الممكن أن يكون لدينا نفس بنية الرسم البياني أو إنشاء رسم بياني جديد بعملية مختلفة، أو يمكننا تسميته رسمًا بيانيًا ديناميكيًا.
- أفضل أداء
تقوم المجتمعات والباحثون بقياس ومقارنة الأطر لمعرفة أي منها أسرع. ريبو جيثب المعيار في أطر التعلم العميق ووحدات معالجة الرسومات أفاد PyTorيُعدّ إطار العمل ch أسرع من الإطار الآخر من حيث عدد الصور التي تتم معالجتها في الثانية الواحدة.
كما ترون أدناه، مقارنة الرسوم البيانية مع vgg16 وresnet152


- محلي Python
PyTorتعتمد مكتبة ch بشكل أكبر على لغة بايثون. على سبيل المثال، إذا كنت ترغب في تدريب نموذج، يمكنك استخدام تدفق التحكم الأصلي مثل looping ويمكن تشغيل الاستدعاءات المتكررة دون الحاجة إلى إضافة متغيرات أو جلسات خاصة إضافية. وهذا مفيد جدًا لعملية التدريب.
PyTorتُطبّق مكتبة ch أيضًا البرمجة الإجرائية، وهي بالتأكيد أكثر مرونة. لذا، من الممكن طباعة قيمة الموتر أثناء عملية الحساب.
عيوب PyTorch
PyTorيتطلب ch تطبيقات خارجية للعرض المرئي. كما يحتاج إلى خادم API للإنتاج.
التالي في هذا بايثونTorفي هذا الدرس التعليمي، سنتعرف على الفرق بين لغة بايثونTorch و TensorFlow.
PyTorمقارنة بين ch و TensorFlow
| معامل | PyTorch | TensorFlow |
|---|---|---|
| تعريف النموذج | يتم تعريف النموذج في فئة فرعية ويقدم حزمة سهلة الاستخدام | يتم تعريف النموذج بالعديد، وتحتاج إلى فهم بناء الجملة |
| دعم GPU | نعم | نعم |
| نوع الرسم البياني | التفاعل | ساكن |
| الأدوات | لا توجد أداة التصور | يمكنك استخدام أداة التصور Tensorboard |
| المجتمع | المجتمع لا يزال ينمو | مجتمعات نشطة كبيرة |
مع وضع المقارنة في الاعتبار، فإن الخطوة التالية هي الحصول على بايثونTorch يعمل محليًا أو في السحابة.
تثبيت بايثونTorch
لينكس
من السهل تثبيته في Linux. يمكنك اختيار استخدام بيئة افتراضية أو تثبيتها مباشرة من خلال الوصول إلى الجذر. اكتب هذا الأمر في المحطة
pip3 install --upgrade torch torchvision
AWS ساجيماكر
Sagemaker هي إحدى المنصات الموجودة في Amazon خدمة ويب يوفر محركًا قويًا للتعلم الآلي مزودًا بتكوينات التعلم العميق المثبتة مسبقًا لعالم البيانات أو المطورين لإنشاء النماذج وتدريبها ونشرها على أي نطاق.
أولا افتح ملف Amazon ساجيماكر انتقل إلى وحدة التحكم وانقر على إنشاء مثيل دفتر الملاحظات وقم بملء جميع التفاصيل الخاصة بدفتر الملاحظات الخاص بك.

الخطوة التالية، انقر فوق فتح لتشغيل مثيل الكمبيوتر الدفتري الخاص بك.

وأخيرا، في Jupyterانقر على "جديد" واختر conda_pytorch_p36، وبذلك تكون جاهزًا لاستخدام نسخة دفتر الملاحظات الخاصة بك مع بايثون.Torتم تثبيت ch.
التالي في هذا بايثونTorفي هذا الدرس التعليمي، سنتعلم عن لغة بايثون (Py).Torأساسيات إطار عمل ch.
بعد اكتمال التثبيت، ستكون واجهة برمجة التطبيقات (API) هي المحطة التالية.
PyTorأساسيات إطار العمل ch
لنتعلم المفاهيم الأساسية للغة بايثونTorقبل أن نتعمق في الموضوع.Torيستخدم ch موترًا لكل متغير، على غرار مصفوفة numpy متعددة الأبعاد، ولكن مع دعم حساب وحدة معالجة الرسومات. سنشرح هنا نموذج الشبكة، ودالة الخسارة، وخوارزمية الانتشار العكسي، والمُحسِّن.
نموذج الشبكة
يمكن إنشاء الشبكة عن طريق التصنيف الفرعي torch.nn. هناك 2 أجزاء رئيسية،
- الجزء الأول هو تحديد المعلمات والطبقات التي ستستخدمها
- الجزء الثاني هو المهمة الرئيسية التي تسمى العملية الأمامية التي ستأخذ مدخلات وتتنبأ بالمخرجات.
Import torch
import torch.nn as nn
import torch.nn.functional as F

class Model(nn.Module):
 def __init__(self):
        super(Model, self).__init__()
        self.conv1 = nn.Conv2d(3, 20, 5)
        self.conv2 = nn.Conv2d(20, 40, 5)
self.fc1 = nn.Linear(320, 10)

def forward(self, x):
       x = F.relu(self.conv1(x))
       x = F.relu(self.conv2(x))
       x = x.view(-1, 320)
       x = F.relu(self.fc1(x))
       return F.log_softmax(x)

net = Model()
كما ترون أعلاه، يمكنك إنشاء فئة من nn.Module تسمى Model. يحتوي على طبقتين Conv2d وطبقة خطية. الطبقة conv2d الأولى تأخذ مدخلاً 2 وشكل الإخراج 3. الطبقة الثانية ستأخذ مدخلاً 20 وستنتج شكل مخرجات 20. الطبقة الأخيرة هي طبقة متصلة بالكامل على شكل 40 وستنتج الناتج 320.
ستأخذ العملية الأمامية مدخلات X وتغذيها إلى طبقة conv1 وتؤدي وظيفة ReLU،
وبالمثل، سيتم أيضًا تغذية طبقة conv2. بعد ذلك، سيتم إعادة تشكيل x إلى (-1، 320) وإدخالها في طبقة FC النهائية. قبل إرسال الإخراج، ستستخدم وظيفة تنشيط softmax.
يتم تعريف العملية الخلفية تلقائيًا عن طريق الترقية التلقائية، لذلك ما عليك سوى تحديد العملية الأمامية.
فقدان وظيفة
تُستخدم دالة الخسارة لقياس مدى قدرة نموذج التنبؤ على توقع النتائج المتوقعة. بايثونTorيحتوي برنامج ch بالفعل على العديد من دوال الخسارة القياسية في وحدة torch.nn. على سبيل المثال، يمكنك استخدام دالة خسارة الإنتروبيا المتقاطعة لحل مشكلة تصنيف متعدد الفئات في بايثون.Torمشكلة تصنيف ch. من السهل تحديد دالة الخسارة وحساب الخسائر:
loss_fn = nn.CrossEntropyLoss()

#training process
loss = loss_fn(out, target)
من السهل استخدام حساب دالة الخسارة الخاصة بك مع بايثونTorالفصل.
دعامة خلفية
لإجراء الانتشار العكسي، ما عليك سوى استدعاء التابع los.backward(). سيتم حساب الخطأ ولكن تذكر مسح التدرج الموجود باستخدام Zero_grad()
net.zero_grad() # to clear the existing gradient
loss.backward() # to perform backpropragation
محسن
يوفر torch.optim خوارزميات تحسين شائعة. يمكنك تعريف مُحسِّن من خلال خطوة بسيطة:
optimizer = torch.optim.SGD(net.parameters(), lr = 0.01, momentum=0.9)
تحتاج إلى تمرير معلمات نموذج الشبكة ومعدل التعلم بحيث يتم تحديث المعلمات عند كل تكرار بعد عملية الدعم الخلفي.
أفضل طريقة لتعلم واجهة برمجة التطبيقات (API) هي من خلال مثال صغير وشامل.
الانحدار البسيط باستخدام بايثونTorch
لنتعلم الانحدار البسيط باستخدام بايثونTorأمثلة على الفصل:
الخطوة 1) إنشاء نموذج شبكتنا
نموذج شبكتنا عبارة عن طبقة خطية بسيطة ذات شكل مدخلات ومخرجات يساوي 1.
from __future__ import print_function

import torch
import torch.nn as nn
import torch.nn.functional as F
from torch.autograd import Variable

class Net(nn.Module):
   def __init__(self):
       super(Net, self).__init__()
       self.layer = torch.nn.Linear(1, 1)

   def forward(self, x):
       x = self.layer(x)
       return x

net = Net()
print(net)
وينبغي أن يكون إخراج الشبكة مثل هذا
Net(
  (hidden): Linear(in_features=1, out_features=1, bias=True)
)
الخطوة 2) بيانات الاختبار
قبل أن تبدأ عملية التدريب، عليك أن تعرف بياناتنا. يمكنك إنشاء وظيفة عشوائية لاختبار نموذجنا. ص = س3 الخطيئة (س) + 3س + 0.8 راند (100)
# Visualize our data
import matplotlib.pyplot as plt
import numpy as np

x = np.random.rand(100)
y = np.sin(x) * np.power(x,3) + 3*x + np.random.rand(100)*0.8

plt.scatter(x, y)
plt.show()
هنا هو مخطط مبعثر من وظيفتنا:

قبل بدء عملية التدريب، عليك تحويل مصفوفة NumPy إلى متغيرات مدعومة من قِبل Torch و autograd كما هو موضح في بايثون أدناهTorمثال على الانحدار الخطي.
# convert numpy array to tensor in shape of input size
x = torch.from_numpy(x.reshape(-1,1)).float()
y = torch.from_numpy(y.reshape(-1,1)).float()
print(x, y)
الخطوة 3) المحسن والخسارة
بعد ذلك، يجب عليك تحديد المُحسِّن ووظيفة الخسارة لعملية التدريب لدينا.
# Define Optimizer and Loss Function
optimizer = torch.optim.SGD(net.parameters(), lr=0.2)
loss_func = torch.nn.MSELoss()
الخطوة 4) التدريب
الآن لنبدأ عملية التدريب لدينا. في فترة زمنية تبلغ 250 عامًا، ستقوم بتكرار بياناتنا للعثور على أفضل قيمة لمعلماتنا الفائقة.
inputs = Variable(x)
outputs = Variable(y)
for i in range(250):
   prediction = net(inputs)
   loss = loss_func(prediction, outputs)
   optimizer.zero_grad()
   loss.backward()
   optimizer.step()

   if i % 10 == 0:
       # plot and show learning process
       plt.cla()
       plt.scatter(x.data.numpy(), y.data.numpy())
       plt.plot(x.data.numpy(), prediction.data.numpy(), 'r-', lw=2)
       plt.text(0.5, 0, 'Loss=%.4f' % loss.data.numpy(), fontdict={'size': 10, 'color':  'red'})
       plt.pause(0.1)

plt.show()
الخطوة 5) النتيجة
كما ترى أدناه، لقد نفذتَ عملية بايثون بنجاحTorالانحدار باستخدام الشبكة العصبية. في الواقع، في كل تكرار، يتم تحديث الخط الأحمر في الرسم البياني وتغيير موضعه ليتناسب مع البيانات. ولكن في هذه الصورة، يظهر لك فقط النتيجة النهائية كما هو موضح في كود بايثون أدناه.Torمثال على الفصل:

يُعدّ الانحدار بمثابة تمرين تمهيدي؛ بينما يُمرّن تصنيف الصور عضلات التعلّم العميق في بايثون.Torالفصل.
مثال على تصنيف الصور باستخدام بايثونTorch
إحدى الطرق الشائعة لتعلم أساسيات التعلم العميق توجد مجموعة بيانات MNIST. وهي بمثابة "Hello World" في التعلم العميق. تحتوي مجموعة البيانات على أرقام مكتوبة بخط اليد من 0 إلى 9 بإجمالي 60,000 عينة تدريب و10,000 عينة اختبار مُسمَّاة بالفعل بحجم 28×28 بكسل.

الخطوة 1) المعالجة المسبقة للبيانات
في الخطوة الأولى من هذا PyTorفي مثال تصنيف ch، ستقوم بتحميل مجموعة البيانات باستخدام وحدة torchvision.
قبل أن تبدأ عملية التدريب، عليك أن تفهم البيانات. Torسيقوم برنامج chvision بتحميل مجموعة البيانات وتحويل الصور وفقًا للمتطلبات المناسبة للشبكة مثل الشكل وتطبيع الصور.
import torch
import torchvision
import numpy as np
from torchvision import datasets, models, transforms

# This is used to transform the images to Tensor and normalize it
transform = transforms.Compose(
   [transforms.ToTensor(),
    transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5))])

training = torchvision.datasets.MNIST(root='./data', train=True,
                                       download=True, transform=transform)
train_loader = torch.utils.data.DataLoader(training, batch_size=4,
                                         shuffle=True, num_workers=2)

testing = torchvision.datasets.MNIST(root='./data', train=False,
                                      download=True, transform=transform)
test_loader = torch.utils.data.DataLoader(testing, batch_size=4,
                                        shuffle=False, num_workers=2)

classes = ('0', '1', '2', '3',
          '4', '5', '6', '7', '8', '9')

import matplotlib.pyplot as plt
import numpy as np

#create an iterator for train_loader
# get random training images
data_iterator = iter(train_loader)
images, labels = data_iterator.next()

#plot 4 images to visualize the data
rows = 2
columns = 2
fig=plt.figure()
for i in range(4):
   fig.add_subplot(rows, columns, i+1)
   plt.title(classes[labels[i]])
   img = images[i] / 2 + 0.5     # this is for unnormalize the image
   img = torchvision.transforms.ToPILImage()(img)
   plt.imshow(img)
plt.show()
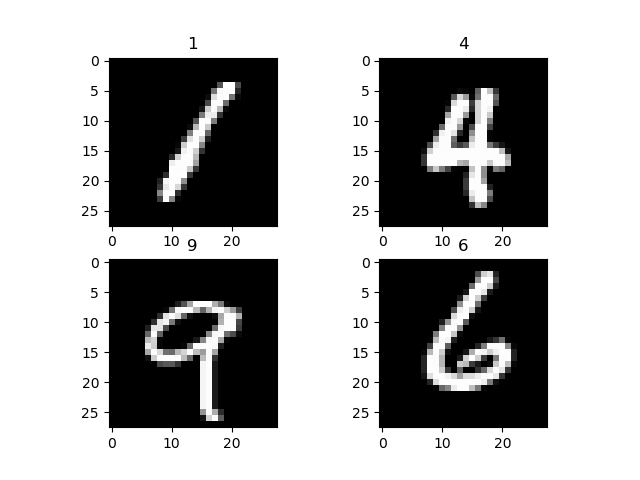
تقوم وظيفة التحويل بتحويل الصور إلى موتر وتطبيع القيمة. ستقوم الوظيفة torchvision.transforms.MNIST بتنزيل مجموعة البيانات (إذا لم تكن متوفرة) في الدليل، وتعيين مجموعة البيانات للتدريب إذا لزم الأمر وإجراء عملية التحويل.
لتصور مجموعة البيانات، يمكنك استخدام data_iterator للحصول على الدفعة التالية من الصور والتسميات. يمكنك استخدام matplot لرسم هذه الصور والتسمية المناسبة لها. كما ترون أدناه صورنا وتسمياتها.
الخطوة 2) تكوين نموذج الشبكة
الآن في هذا بايثونTorفي المثال، ستقوم بإنشاء شبكة عصبية بسيطة لـ PyTorتصنيف الصور ch.
نقدم لكم هنا طريقة أخرى لإنشاء نموذج الشبكة في بايثونTorسنستخدم nn.Sequential لإنشاء نموذج تسلسلي بدلاً من إنشاء فئة فرعية من nn.Module.
import torch.nn as nn

# flatten the tensor into
class Flatten(nn.Module):
   def forward(self, input):
       return input.view(input.size(0), -1)

#sequential based model
seq_model = nn.Sequential(
           nn.Conv2d(1, 10, kernel_size=5),
           nn.MaxPool2d(2),
           nn.ReLU(),
           nn.Dropout2d(),
           nn.Conv2d(10, 20, kernel_size=5),
           nn.MaxPool2d(2),
           nn.ReLU(),
           Flatten(),
           nn.Linear(320, 50),
           nn.ReLU(),
           nn.Linear(50, 10),
           nn.Softmax(),
         )

net = seq_model
print(net)
هنا هو إخراج نموذج شبكتنا
Sequential(
  (0): Conv2d(1, 10, kernel_size=(5, 5), stride=(1, 1))
  (1): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  (2): ReLU()
  (3): Dropout2d(p=0.5)
  (4): Conv2d(10, 20, kernel_size=(5, 5), stride=(1, 1))
  (5): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  (6): ReLU()
  (7): Flatten()
  (8): Linear(in_features=320, out_features=50, bias=True)
  (9): ReLU()
  (10): Linear(in_features=50, out_features=10, bias=True)
  (11): Softmax()
)
شرح الشبكة
- التسلسل هو أن الطبقة الأولى هي طبقة Conv2D مع شكل إدخال 1 وشكل إخراج 10 وحجم نواة 5
- بعد ذلك، لديك طبقة MaxPool2D
- وظيفة تفعيل ReLU
- طبقة التسرب لإسقاط قيم الاحتمالية المنخفضة.
- ثم Conv2d ثاني بشكل الإدخال 10 من الطبقة الأخيرة وشكل الإخراج 20 بحجم النواة 5
- التالي طبقة MaxPool2d
- وظيفة تنشيط ReLU.
- بعد ذلك، سوف تقوم بتسوية الموتر قبل إدخاله في الطبقة الخطية
- ستقوم الطبقة الخطية بتعيين مخرجاتنا في الطبقة الخطية الثانية باستخدام وظيفة تنشيط softmax
الخطوة 3) تدريب النموذج
قبل البدء في عملية التدريب، يلزم إعداد وظيفة المعيار والمحسن.
بالنسبة للمعيار، ستستخدم دالة خسارة الإنتروبيا المتقاطعة. أما بالنسبة للمُحسِّن، فستستخدم خوارزمية التدرج العشوائي (SGD) بمعدل تعلّم 0.001 ومعامل زخم 0.9 كما هو موضح في ملف بايثون أدناه.Torمثال الفصل.
import torch.optim as optim

criterion = nn.CrossEntropyLoss()
optimizer = optim.SGD(net.parameters(), lr=0.001, momentum=0.9)
ستأخذ العملية الأمامية شكل الإدخال وتمريره إلى طبقة conv2d الأولى. ومن هناك، سيتم إدخاله إلى maxpool2d ووضعه أخيرًا في وظيفة تنشيط ReLU. ستحدث نفس العملية في طبقة conv2d الثانية. بعد ذلك، سيتم إعادة تشكيل المدخلات إلى (-1,320) وتغذيتها في طبقة FC للتنبؤ بالمخرجات.
الآن سوف تبدأ عملية التدريب. سوف تقوم بالتكرار من خلال مجموعة البيانات الخاصة بنا مرتين أو بفترة 2 وطباعة الخسارة الحالية في كل 2 دفعة.
for epoch in range(2):

#set the running loss at each epoch to zero
   running_loss = 0.0
# we will enumerate the train loader with starting index of 0
# for each iteration (i) and the data (tuple of input and labels)
   for i, data in enumerate(train_loader, 0):
       inputs, labels = data

# clear the gradient
       optimizer.zero_grad()

#feed the input and acquire the output from network
       outputs = net(inputs)

#calculating the predicted and the expected loss
       loss = criterion(outputs, labels)

#compute the gradient
       loss.backward()

#update the parameters
       optimizer.step()

       # print statistics
       running_loss += loss.item()
       if i % 1000 == 0:
           print('[%d, %5d] loss: %.3f' %
                 (epoch + 1, i + 1, running_loss / 1000))
           running_loss = 0.0
في كل فترة، سيحصل العداد على الصف التالي من المدخلات والتسميات المقابلة. قبل أن نقوم بتغذية نموذج شبكتنا بالمدخلات، نحتاج إلى مسح التدرج السابق. وهذا مطلوب لأنه بعد العملية العكسية (عملية الانتشار العكسي)، سيتم تجميع التدرج بدلاً من استبداله. ثم نقوم بحساب الخسائر من الناتج المتوقع من الناتج المتوقع. بعد ذلك، سنقوم بإجراء انتشار عكسي لحساب التدرج، وأخيرا، سنقوم بتحديث المعلمات.
وهنا نتائج عملية التدريب
[1, 	1] loss: 0.002
[1,  1001] loss: 2.302
[1,  2001] loss: 2.295
[1,  3001] loss: 2.204
[1,  4001] loss: 1.930
[1,  5001] loss: 1.791
[1,  6001] loss: 1.756
[1,  7001] loss: 1.744
[1,  8001] loss: 1.696
[1,  9001] loss: 1.650
[1, 10001] loss: 1.640
[1, 11001] loss: 1.631
[1, 12001] loss: 1.631
[1, 13001] loss: 1.624
[1, 14001] loss: 1.616
[2, 	1] loss: 0.001
[2,  1001] loss: 1.604
[2,  2001] loss: 1.607
[2,  3001] loss: 1.602
[2,  4001] loss: 1.596
[2,  5001] loss: 1.608
[2,  6001] loss: 1.589
[2,  7001] loss: 1.610
[2,  8001] loss: 1.596
[2,  9001] loss: 1.598
[2, 10001] loss: 1.603
[2, 11001] loss: 1.596
[2, 12001] loss: 1.587
[2, 13001] loss: 1.596
[2, 14001] loss: 1.603
الخطوة 4) اختبار النموذج
بعد تدريب نموذجنا، تحتاج إلى اختباره أو تقييمه باستخدام مجموعات أخرى من الصور.
سنستخدم مُكررًا لـ test_loader، وسيقوم بإنشاء مجموعة من الصور والعلامات التي سيتم تمريرها إلى النموذج المُدرَّب. سيتم عرض الناتج المتوقع ومقارنته بالناتج المتوقع.
#make an iterator from test_loader
#Get a batch of training images
test_iterator = iter(test_loader)
images, labels = test_iterator.next()

results = net(images)
_, predicted = torch.max(results, 1)

print('Predicted: ', ' '.join('%5s' % classes[predicted[j]] for j in range(4)))

fig2 = plt.figure()
for i in range(4):
   fig2.add_subplot(rows, columns, i+1)
   plt.title('truth ' + classes[labels[i]] + ': predict ' + classes[predicted[i]])
   img = images[i] / 2 + 0.5     # this is to unnormalize the image
   img = torchvision.transforms.ToPILImage()(img)
   plt.imshow(img)
plt.show()

