
PyTorبرنامج تعليمي حول نقل التعلم مع أمثلة
 فريق التحرير
⚡ ملخص ذكي
يعيد التعلم بالنقل استخدام شبكة تم تدريبها بالفعل على مجموعة بيانات كبيرة بحيث يمكن حل مهمة جديدة ذات صلة بعدد أقل بكثير من الصور المصنفة وجزء من وقت التدريب الأصلي.
ما هو نقل التعلم؟
نقل التعلم هي تقنية تستخدم نموذجًا مُدرَّبًا لحل مهمة أخرى ذات صلة. تعلم آلة أسلوب بحثي يخزن المعرفة المكتسبة أثناء حل مشكلة معينة، ويستخدم هذه المعرفة نفسها لحل مشكلة أخرى مختلفة ولكنها ذات صلة. وهذا يحسن الكفاءة من خلال إعادة استخدام المعلومات التي تم جمعها من المهمة التي تم تعلمها سابقاً.
من الشائع إعادة استخدام أوزان نموذج شبكة آخر لأن تدريب شبكة من الصفر يتطلب كمية هائلة من البيانات. ولتقليل وقت التدريب، يتم استخدام شبكة موجودة وأوزانها، ثم تعديل الطبقة الأخيرة لحل المشكلة المطلوبة. وتكمن الميزة في إمكانية تدريب هذه الطبقة الأخيرة باستخدام مجموعة بيانات صغيرة.
قبل كتابة أي شيء بلغة بايثونTorفي الكود ch، من المفيد معرفة أي عائلة من التعلم النقل تنتمي إليها مشكلتك، لأن ذلك يحدد مقدار البيانات المصنفة التي تحتاجها.
أنواع نقل التعلم
تقسم الدراسات البحثية هذه التقنية إلى ثلاث مجموعات. ويعتمد تحديد المجموعة التي تنطبق عليك على أي جانب من جوانب المشكلة يحمل التصنيفات، وليس على الإطار الذي تستخدمه.
| النوع | مجال المصدر | Target نطاق | الاستخدام النموذجي |
|---|---|---|---|
| استقرائية | المسمى | مُصنّفة، لكنها مهمة مختلفة | إعادة توجيه بنية ImageNet الأساسية نحو مشكلة تصنيف الكائنات الفضائية ضد المفترسات إلى فئتين |
| التحويلي | المسمى | بدون تصنيف، نفس المهمة، توزيع بيانات مختلف | تكييف المجال، مثل نقل نموذج من صور الاستوديو إلى صور الهاتف |
| غير خاضع للرقابة | غير مصنف | غير مصنف | Clusterأو تقليل الأبعاد حيث يكون تصنيف كل سجل غير عملي |
المثال الذي تم بناؤه في هذا البرنامج التعليمي هو التعلم الاستقرائي بالنقل. يصل VGG19 مزودًا بمعرفة ImageNet المصنفة، ثم يتم توجيهه إلى مشكلة تصنيف ثنائية مصنفة لم يسبق له رؤيتها من قبل.
ميزة إكسtracالضبط مقابل الضبط الدقيق
بعد اختيار شبكة مدربة مسبقًا، هناك طريقتان لتكييفها. الفرق ببساطة هو عدد الطبقات التي تسمح لها بمواصلة التعلم.
| البعد | مثال مميزtracالإنتاج | الكون المثالى |
|---|---|---|
| طبقات التدريب | المصنف المستبدل فقط | المصنف بالإضافة إلى بعض أو كل الكتل الالتفافية |
| يتطلب_التخرج على العمود الفقري | خطأ | ينطبق هذا على الكتل التي يتم تحديثها |
| البيانات المطلوبة | صور صغيرة، غالباً بضع مئات من الصور لكل فصل دراسي | أكبر حجماً، عادةً ما يصل إلى الآلاف |
| تكلفة التدريب | الأقل تكلفة، يعمل على وحدة المعالجة المركزية | كلما ارتفع مستوى وحدة معالجة الرسومات، كلما أصبحت تستحق الاقتناء. |
| الدقة النموذجية | يكون ذلك مفيدًا عندما تتشابه الصور المصدر والهدف. | عادةً ما يكون الوضع أفضل عندما يختلف المجالان |
تستخدم الخطوات التالية ميزة extracفي هذه الحالة، يتم تجميد جميع معلمات VGG19، وتتعلم الطبقة الخطية النهائية الجديدة فقط. أما الانتقال إلى الضبط الدقيق فهو تغيير بسيط، يتمثل في ترك خاصية requires_grad مضبوطة على True في الكتل التي ترغب بتحديثها، وخفض معدل التعلم حتى لا تُفقد الأوزان المُستعارة.
تحميل مجموعة البيانات
قبل البدء في استخدام التعلم بالنقل مع بايثونTorch، عليك فهم مجموعة البيانات التي ستستخدمها. في هذا التعلم النقل باستخدام بايثونTorفي المثال المذكور، ستصنف كائنًا فضائيًا ومفترسًا من بين ما يقارب 700 صورة. لا تتطلب هذه التقنية كمية كبيرة من البيانات للتدريب. يمكنك تنزيل مجموعة البيانات من كاغل: ألين ضد بريداتور.
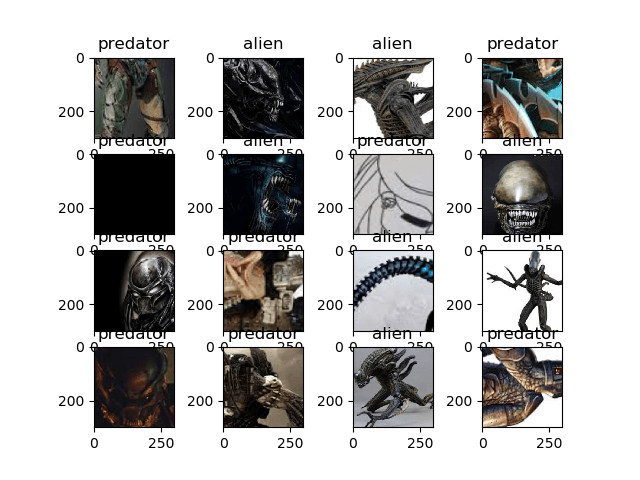
المجموعة صغيرة عمداً، ويتم عرض عينة من الصور التي تحتويها أدناه.

المصدر مقابل الغريبة المفترس Kaggle
التالي في هذا بايثونTorفي هذا الدرس التعليمي حول التعلم بالنقل، ستتعلم كيفية تطبيق التعلم بالنقل باستخدام لغة بايثون.Torخطوة بخطوة.
كيفية استخدام نقل التعلم؟
إليك شرحًا تفصيليًا لكيفية استخدام التعلم بالنقل في التعلم العميق باستخدام بايثونTorالفصل:
الخطوة 1) تحميل البيانات
تتمثل الخطوة الأولى في تحميل البيانات وتطبيق بعض التحويلات على الصور بحيث تتطابق مع متطلبات الشبكة.
ستقوم بتحميل البيانات من مجلد يحتوي على torchvision.datasets. يقوم البرنامج بتكرار العملية على المجلد لتقسيم البيانات إلى مجموعتي تدريب وتحقق. تقوم عملية التحويل المستخدمة هنا باقتصاص الصور من المركز، وتحويلها إلى موتر، ثم تطبيعها لـ تعلم عميق.
from __future__ import print_function, division
import os
import time
import torch
import torchvision
from torchvision import datasets, models, transforms
import torch.optim as optim
import numpy as np
import matplotlib.pyplot as plt

data_dir = "alien_pred"
input_shape = 224
mean = [0.5, 0.5, 0.5]
std = [0.5, 0.5, 0.5]

#data transformation
data_transforms = {
   'train': transforms.Compose([
       transforms.CenterCrop(input_shape),
       transforms.ToTensor(),
       transforms.Normalize(mean, std)
   ]),
   'validation': transforms.Compose([
       transforms.CenterCrop(input_shape),
       transforms.ToTensor(),
       transforms.Normalize(mean, std)
   ]),
}

image_datasets = {
   x: datasets.ImageFolder(
       os.path.join(data_dir, x),
       transform=data_transforms[x]
   )
   for x in ['train', 'validation']
}

dataloaders = {
   x: torch.utils.data.DataLoader(
       image_datasets[x], batch_size=32,
       shuffle=True, num_workers=4
   )
   for x in ['train', 'validation']
}

dataset_sizes = {x: len(image_datasets[x]) for x in ['train', 'validation']}

print(dataset_sizes)
class_names = image_datasets['train'].classes

device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
والآن، قم بتصور مجموعة البيانات. تأخذ خطوة التصور الدفعة التالية من الصور والتصنيفات من مُحمِّل بيانات التدريب وتعرضها باستخدام مكتبة Matplotlib.
images, labels = next(iter(dataloaders['train']))

rows = 4
columns = 4
fig=plt.figure()
for i in range(16):
   fig.add_subplot(rows, columns, i+1)
   plt.title(class_names[labels[i]])
   img = images[i].numpy().transpose((1, 2, 0))
   img = std * img + mean
   plt.imshow(img)
plt.show()
تشغيل هذا المقتطف يرسم شبكة من أربعة في أربعة من صور التدريب، كل منها يحمل عنوان اسم الفئة التي أعادها المحمل.
الخطوة 2) تحديد النموذج
في عملية التعلم العميق هذه، ستستخدم VGG19 من وحدة torchvision.
ستستخدم مكتبة torchvision.models لتحميل مجموعة بيانات vgg19 مع تفعيل الأوزان المدربة مسبقًا. بعد ذلك، ستقوم بتجميد الطبقات بحيث لا يمكن تدريبها. ثم ستُعدّل الطبقة الأخيرة بإضافة طبقة خطية مناسبة للمشكلة، والتي تعني هنا فئتين. سيتم استخدام دالة خسارة الإنتروبيا المتقاطعة (CrossEntropyLoss)، والمُحسِّن هو SGD بمعدل تعلّم 0.001 ومعامل زخم 0.9، كما هو موضح في كود بايثون أدناه.Torمثال على التعلم الانتقالي.
## Load the model based on VGG19
vgg_based = torchvision.models.vgg19(pretrained=True)

## freeze the layers
for param in vgg_based.parameters():
   param.requires_grad = False

# Modify the last layer
number_features = vgg_based.classifier[6].in_features
features = list(vgg_based.classifier.children())[:-1] # Remove last layer
features.extend([torch.nn.Linear(number_features, len(class_names))])
vgg_based.classifier = torch.nn.Sequential(*features)

vgg_based = vgg_based.to(device)

print(vgg_based)

criterion = torch.nn.CrossEntropyLoss()
optimizer_ft = optim.SGD(vgg_based.parameters(), lr=0.001, momentum=0.9)
ملاحظة حول الإصدار: القادم pretrained=True لا تزال الحجة صالحة، ولكن تم استبدالها منذ إصدار torchvision 0.13 بواسطة الأوزان لذا تتوقع عمليات التثبيت الأحدث وجود هذا الوسيط. torchvision.models.vgg19(weights=VGG19_Weights.DEFAULT) وإلا، فسيتم طباعة تحذير بشأن الإهمال. كلا النموذجين يحملان نفس أوزان ImageNet.
هيكل نموذج الإخراج
طباعة النموذج تُعيد رسم VGG19 البياني الكامل. اقرأ السطر الأخير من كتلة المصنف للتأكد من نجاح عملية التبديل: فهو يُنتج الآن مُخرجين بدلاً من 1,000 فئة من فئات ImageNet.
VGG(
  (features): Sequential(
	(0): Conv2d(3, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(1): ReLU(inplace)
	(2): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(3): ReLU(inplace)
	(4): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(5): Conv2d(64, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(6): ReLU(inplace)
	(7): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(8): ReLU(inplace)
	(9): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(10): Conv2d(128, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(11): ReLU(inplace)
	(12): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(13): ReLU(inplace)
	(14): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(15): ReLU(inplace)
	(16): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(17): ReLU(inplace)
	(18): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(19): Conv2d(256, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(20): ReLU(inplace)
	(21): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(22): ReLU(inplace)
	(23): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(24): ReLU(inplace)
	(25): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(26): ReLU(inplace)
	(27): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(28): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(29): ReLU(inplace)
	(30): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(31): ReLU(inplace)
	(32): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(33): ReLU(inplace)
	(34): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(35): ReLU(inplace)
	(36): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  )
  (classifier): Sequential(
	(0): Linear(in_features=25088, out_features=4096, bias=True)
	(1): ReLU(inplace)
	(2): Dropout(p=0.5)
	(3): Linear(in_features=4096, out_features=4096, bias=True)
	(4): ReLU(inplace)
	(5): Dropout(p=0.5)
	(6): Linear(in_features=4096, out_features=2, bias=True)
  )
)
الخطوة 3) تدريب واختبار النموذج
سنستخدم بعض الوظائف من هذا PyTorالفصل التعليمي لمساعدتنا في تدريب وتقييم نموذجنا.
def train_model(model, criterion, optimizer, num_epochs=25):
   since = time.time()

   for epoch in range(num_epochs):
       print('Epoch {}/{}'.format(epoch, num_epochs - 1))
       print('-' * 10)

       #set model to trainable
       # model.train()

       train_loss = 0

       # Iterate over data.
       for i, data in enumerate(dataloaders['train']):
           inputs , labels = data
           inputs = inputs.to(device)
           labels = labels.to(device)

           optimizer.zero_grad()

           with torch.set_grad_enabled(True):
               outputs  = model(inputs)
               loss = criterion(outputs, labels)

           loss.backward()
           optimizer.step()

           train_loss += loss.item() * inputs.size(0)

           print('{} Loss: {:.4f}'.format(
               'train', train_loss / dataset_sizes['train']))

   time_elapsed = time.time() - since
   print('Training complete in {:.0f}m {:.0f}s'.format(
       time_elapsed // 60, time_elapsed % 60))

   return model

def visualize_model(model, num_images=6):
   was_training = model.training
   model.eval()
   images_so_far = 0
   fig = plt.figure()

   with torch.no_grad():
       for i, (inputs, labels) in enumerate(dataloaders['validation']):
           inputs = inputs.to(device)
           labels = labels.to(device)

           outputs = model(inputs)
           _, preds = torch.max(outputs, 1)

           for j in range(inputs.size()[0]):
               images_so_far += 1
               ax = plt.subplot(num_images//2, 2, images_so_far)
               ax.axis('off')
               ax.set_title('predicted: {} truth: {}'.format(class_names[preds[j]], class_names[labels[j]]))
               img = inputs.cpu().data[j].numpy().transpose((1, 2, 0))
               img = std * img + mean
               ax.imshow(img)

               if images_so_far == num_images:
                   model.train(mode=was_training)
                   return
       model.train(mode=was_training)
وأخيرًا في هذا التعلم النقل في بايثونTorفي المثال المذكور، ابدأ عملية التدريب بضبط عدد الدورات التدريبية على 25، ثم قيّم الشبكة. في كل خطوة تدريب، يأخذ النموذج المدخلات ويتنبأ بالمخرجات. تُمرر التنبؤات إلى المعيار لحساب الخسارة، ثم تحسب خوارزمية الانتشار العكسي التدرجات، ويُحدّث المُحسِّن الأوزان باستخدام التدرج التلقائي.
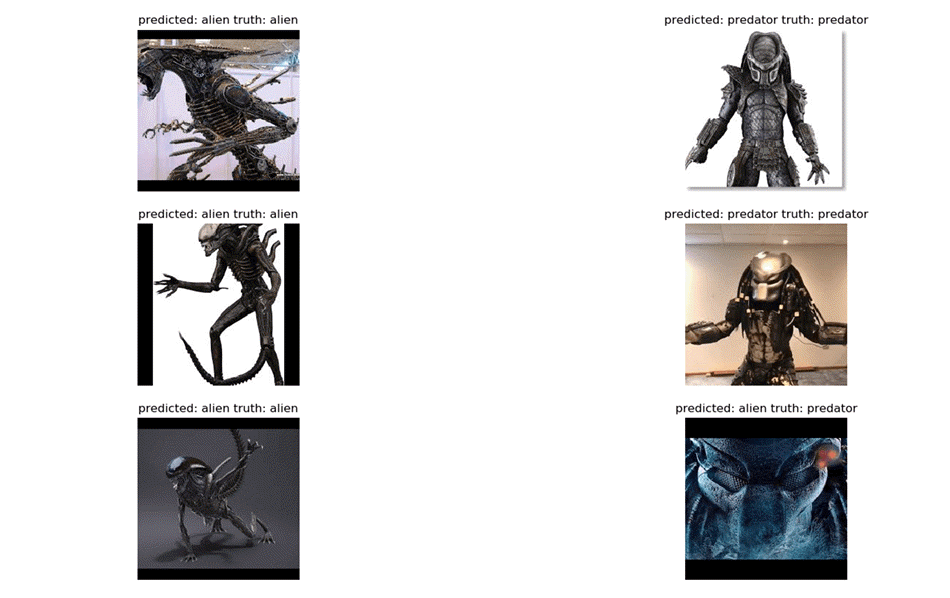
في وظيفة التصور، يتم اختبار الشبكة المدربة بمجموعة من الصور للتنبؤ بالتصنيفات، ويتم رسم النتيجة باستخدام Matplotlib.
vgg_based = train_model(vgg_based, criterion, optimizer_ft, num_epochs=25)

visualize_model(vgg_based)

plt.show()
الخطوة 4) النتائج
بلغت دقة هذه العملية 92%. يُظهر السجل المطبوع في نهاية التدريب نسبة الخطأ في آخر دورتين تدريبيتين بالإضافة إلى إجمالي وقت التدريب.
Epoch 23/24
----------
train Loss: 0.0044
train Loss: 0.0078
train Loss: 0.0141
train Loss: 0.0221
train Loss: 0.0306
train Loss: 0.0336
train Loss: 0.0442
train Loss: 0.0482
train Loss: 0.0557
train Loss: 0.0643
train Loss: 0.0763
train Loss: 0.0779
train Loss: 0.0843
train Loss: 0.0910
train Loss: 0.0990
train Loss: 0.1063
train Loss: 0.1133
train Loss: 0.1220
train Loss: 0.1344
train Loss: 0.1382
train Loss: 0.1429
train Loss: 0.1500
Epoch 24/24
----------
train Loss: 0.0076
train Loss: 0.0115
train Loss: 0.0185
train Loss: 0.0277
train Loss: 0.0345
train Loss: 0.0420
train Loss: 0.0450
train Loss: 0.0490
train Loss: 0.0644
train Loss: 0.0755
train Loss: 0.0813
train Loss: 0.0868
train Loss: 0.0916
train Loss: 0.0980
train Loss: 0.1008
train Loss: 0.1101
train Loss: 0.1176
train Loss: 0.1282
train Loss: 0.1323
train Loss: 0.1397
train Loss: 0.1436
train Loss: 0.1467
Training complete in 2m 47s
ثم يتم عرض تنبؤات النموذج باستخدام Matplotlib، كما هو موضح أدناه.
أخطاء شائعة في التعلم الانتقالي وكيفية إصلاحها
معظم حالات الفشل في برنامج التعلم بالنقل هي حالات ميكانيكية وليست رياضية. هذه هي الحالات التي تمنع تشغيل الكود المذكور أعلاه، وهذا شرح لمعنى كل حالة منها.
- عدم تطابق الحجم في الطبقة الأخيرة: يجب أن تقبل الطبقة الخطية المُستبدلة الميزات المُدخلة التي أبلغ عنها المصنف الأصلي، وأن تُخرج عددًا من المخرجات يساوي طول (أسماء الفئات). تُعد طباعة النموذج، كما في الخطوة 2، أسرع طريقة للتأكد من كلا الرقمين.
- لم يتجمد العمود الفقري أبداً: إذا تم ترك قيمة requires_grad على True، فسيتم تحديث جميع معلمات VGG19، مما يؤدي إلى تباطؤ كبير في عملية التشغيل على وحدة المعالجة المركزية. لذا، يُنصح بتغييرها إلى False قبل استبدال المصنف.
- عدم تطابق التطبيع: يجب أن تكون قيم المتوسط والانحراف المعياري المستخدمة في التحويلات.Normalize هي نفسها في وقت التدريب والاستدلال، وإلا فإن التنبؤات ستنحرف دون سبب واضح.
- وسيط الأوزان المهمل: في الإصدار 0.13 من torchvision والإصدارات الأحدث، يؤدي pretrained=True إلى ظهور تحذير بشأن الإهمال ويتم تفضيل تعداد الأوزان.
- عدد العمال قيد التشغيل Windows والدفاتر: يحتاج مُحمِّل البيانات الذي يحتوي على num_workers=4 إلى حماية نقطة الدخول، لذا اضبط num_workers=0 إذا Python يُثير خطأً في عملية التفريخ أو التخليل.
- التقييم في وضع التدريب: قم باستدعاء model.eval() قبل التسجيل حتى يتصرف Dropout و BatchNorm بشكل حتمي، ثم قم بالتبديل مرة أخرى باستخدام model.train() بعد ذلك.
