
البرنامج التعليمي Scikit-Learn: كيفية التثبيت وأمثلة Scikit-Learn
 فريق التحرير
⚡ ملخص ذكي
Scikit-learn هو برنامج مفتوح المصدر Python مكتبة تغطي المعالجة المسبقة والتصنيف والانحدار والتجميع واختيار النموذج خلف واجهة تقدير متسقة واحدة، مما يحافظ على سير عمل التعلم الآلي الكامل قصيرًا وسهل القراءة وقابلًا للتكرار من البيانات الأولية إلى التنبؤات المسجلة.
ما هو سكيكيت ليرن؟
Scikit تعلم هو مصدر مفتوح Python مكتبة ل آلة التعلميدعم هذا النظام خوارزميات راسخة مثل خوارزمية أقرب جار (KNN)، وتعزيز التدرج، والغابة العشوائية، وآلة المتجهات الداعمة (SVM)، وهو مبني على أساس نمباي وSciPy. تُستخدم مكتبة Scikit-learn على نطاق واسع في مسابقات Kaggle وكذلك في شركات التكنولوجيا البارزة. وهي تغطي المعالجة المسبقة، وتقليل الأبعاد، والتصنيف، والانحدار، والتجميع، واختيار النموذج.
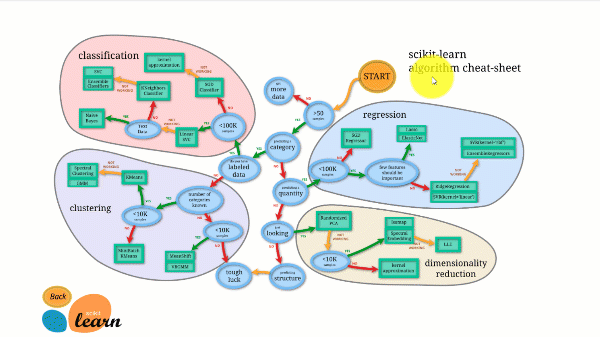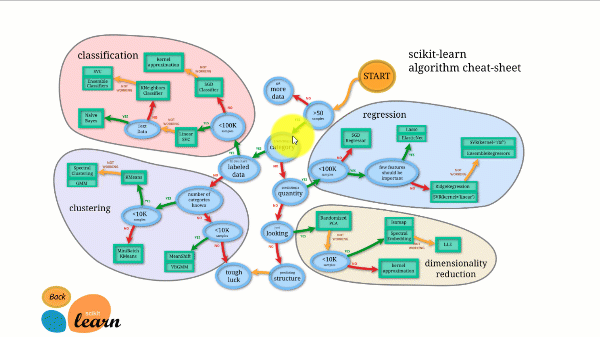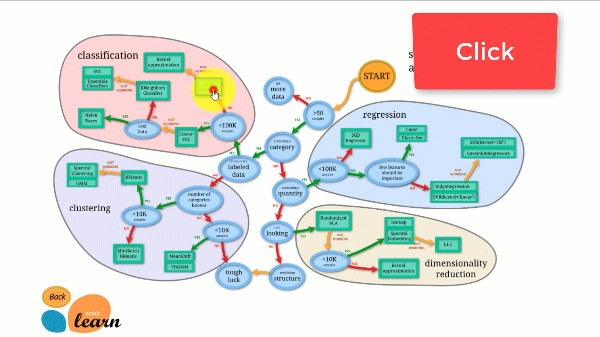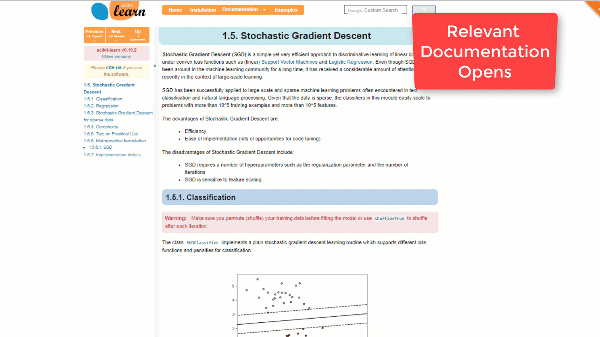
تتميز مكتبة Scikit-learn ببعض أفضل الوثائق بين المكتبات مفتوحة المصدر. بل إنها توفر مخططًا تفاعليًا للتقدير. اختيار المُقدِّر المناسب، الذي يرشدك من حجم مجموعة البيانات الخاصة بك إلى قائمة مختصرة من الخوارزميات التي تستحق التجربة.
يوضح الشكل أدناه كيفية عمل مكتبة Scikit-learn.
مكتبة Scikit-learn سهلة الاستخدام وتُعطي نتائج ممتازة. مع ذلك، فهي تُدرّب على وحدة المعالجة المركزية (CPU): حيث يتم توزيع العمل بالتوازي على النوى باستخدام الوسيط n_jobs بدلاً من وحدة معالجة الرسومات (GPU). يُمكن تشغيل خوارزمية التعلم العميق باستخدامها، لكن ذلك نادرًا ما يكون مثاليًا، خاصةً إذا كنت تعرف بالفعل كيفية استخدامها. TensorFlow.
كيفية تنزيل وتثبيت Scikit-Learn
الآن في هذا Python برنامج تعليمي حول مكتبة Scikit-learn، ستتعلم فيه كيفية تنزيل وتثبيت مكتبة Scikit-learn:
الخيار الأول: AWS
يمكن استخدام مكتبة Scikit-learn عبر AWS. توفر صورة Docker المثبتة مسبقًا مع مكتبة Scikit-learn عناء الإعداد بالكامل.
لتثبيت نسخة المطور، قم بتشغيل الأمر أدناه في الداخل Jupyter:
import sys
!{sys.executable} -m pip install git+git://github.com/scikit-learn/scikit-learn.git
الخيار الثاني: ماك أو Windows باستخدام اناكوندا
لمعرفة المزيد حول تثبيت برنامج أناكوندا، راجع كيفية تنزيل وتثبيت TensorFlow.
عند كتابة هذا الدليل، كان مطورو مكتبة scikit قد أصدروا نسخة تجريبية تُصلح المشاكل الموجودة في الإصدار الحالي آنذاك، لذا فإن الخطوات التالية تستخدم تلك النسخة التجريبية. على جهاز جديد اليوم، يحتوي الإصدار المستقر الحالي بالفعل على جميع المحولات المستخدمة هنا، و pip install -U scikit-learn كفى.
كيفية تثبيت scikit-learn مع بيئة Conda
إذا قمت بتثبيت scikit-learn باستخدام بيئة conda، فاتبع الخطوات التالية للتحديث إلى الإصدار 0.20.
الخطوة 1) تفعيل بيئة TensorFlow
source activate hello-tf
الخطوة الثانية: قم بإزالة مكتبة scikit-learn باستخدام أمر conda
conda remove scikit-learn
الخطوة 3) تثبيت نسخة المطور
قم بتثبيت إصدار المطورين من مكتبة scikit-learn بالإضافة إلى المكتبات اللازمة.
conda install -c anaconda git
pip install Cython
pip install h5py
pip install git+git://github.com/scikit-learn/scikit-learn.git
NOTE: Windows يحتاج المستخدمون Microsoft مرئي C++ 14. يمكنك الحصول عليه اضغط هنا.
مثال Scikit-Learn مع التعلم الآلي
ينقسم هذا البرنامج التعليمي Scikit إلى قسمين:
- التعلم الآلي باستخدام scikit-Learn
- كيف تثق بنموذجك مع LIME
يتناول الجزء الأول بالتفصيل كيفية بناء خط أنابيب، وإنشاء نموذج، وضبط المعلمات الفائقة، بينما يغطي الجزء الثاني تفسير النموذج.
الخطوة 1) استيراد البيانات
خلال هذا الدرس التعليمي لـ Scikit learn، ستستخدم مجموعة بيانات تعداد السكان للبالغين.
يُقرأ الملف مباشرةً من مستودع UCI للتعلم الآلي في الكود أدناه، لذا لا حاجة إلى تنزيل يدوي. إذا كنت مهتمًا بالإحصاءات الوصفية، فإن أدوات Dive وOverview تستحق الاطلاع. راجع هذا البرنامج التعليمي لمعرفة المزيد عن الغوص ونظرة عامة.
يمكنك استيراد مجموعة البيانات باستخدام مكتبة Pandas. لاحظ أنه يجب عليك تحويل المتغيرات المستمرة إلى صيغة عددية عشرية.
تتضمن مجموعة البيانات هذه ثمانية متغيرات فئوية، مدرجة في CATE_FEATURES:
- فئة العمل
- التعليم
- الزوجي
- احتلال
- صلة
- سباق
- جنس
- الوطن الأم
كما يتضمن ستة متغيرات مستمرة، مدرجة في CONTI_FEATURES:
- السن
- com.fnlwgt
- education_num
- مكاسب رأس المال
- خسارة رأس المال
- ساعات_الاسبوع
تم ملء القوائم هنا يدويًا لتوضيح الأعمدة المستخدمة. هناك طريقة أسرع لإنشاء قائمة بالأعمدة التصنيفية أو المتصلة، وهي:
## List Categorical
CATE_FEATURES = df_train.iloc[:,:-1].select_dtypes('object').columns
print(CATE_FEATURES)

## List continuous
CONTI_FEATURES =  df_train._get_numeric_data()
print(CONTI_FEATURES)
إليك الكود لاستيراد البيانات:
# Import dataset
import pandas as pd

## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country', 'label']
### Define continuous list
CONTI_FEATURES  = ['age', 'fnlwgt','capital_gain', 'education_num', 'capital_loss', 'hours_week']
### Define categorical list
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']

## Prepare the data
features = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country']

PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"

df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_train[CONTI_FEATURES] =df_train[CONTI_FEATURES].astype('float64')
df_train.describe()
يؤدي استدعاء الدالة describe() على الإطار إلى إرجاع الإحصائيات الموجزة للأعمدة الستة المتصلة:
| السن | com.fnlwgt | education_num | مكاسب رأس المال | خسارة رأس المال | ساعات_الاسبوع | |
|---|---|---|---|---|---|---|
| عد | 32561.000000 | 3.256100e + 04 | 32561.000000 | 32561.000000 | 32561.000000 | 32561.000000 |
| تعني | 38.581647 | 1.897784e + 05 | 10.080679 | 1077.648844 | 87.303830 | 40.437456 |
| الأمراض المنقولة جنسيا | 13.640433 | 1.055500e + 05 | 2.572720 | 7385.292085 | 402.960219 | 12.347429 |
| دقيقة | 17.000000 | 1.228500e + 04 | 1.000000 | 0.000000 | 0.000000 | 1.000000 |
| 25% | 28.000000 | 1.178270e + 05 | 9.000000 | 0.000000 | 0.000000 | 40.000000 |
| 50% | 37.000000 | 1.783560e + 05 | 10.000000 | 0.000000 | 0.000000 | 40.000000 |
| 75% | 48.000000 | 2.370510e + 05 | 12.000000 | 0.000000 | 0.000000 | 45.000000 |
| ماكس | 90.000000 | 1.484705e + 06 | 16.000000 | 99999.000000 | 4356.000000 | 99.000000 |
يمكنك التحقق من عدد القيم الفريدة لخاصية native_country. أسرة واحدة فقط من هولندا. هذه الأسرة لا تُضيف أي معلومات، وسيظهر خطأ أثناء التدريب.
df_train.native_country.value_counts()
United-States                 29170
Mexico                          643
?                               583
Philippines                     198
Germany                         137
Canada                          121
Puerto-Rico                     114
El-Salvador                     106
India                           100
Cuba                             95
England                          90
Jamaica                          81
South                            80
China                            75
Italy                            73
Dominican-Republic               70
Vietnam                          67
Guatemala                        64
Japan                            62
Poland                           60
Columbia                         59
Taiwan                           51
Haiti                            44
Iran                             43
Portugal                         37
Nicaragua                        34
Peru                             31
France                           29
Greece                           29
Ecuador                          28
Ireland                          24
Hong                             20
Cambodia                         19
Trinadad&Tobago                  19
Thailand                         18
Laos                             18
Yugoslavia                       16
Outlying-US(Guam-USVI-etc)       14
Honduras                         13
Hungary                          13
Scotland                         12
Holand-Netherlands                1
Name: native_country, dtype: int64
يمكنك استبعاد هذا الصف غير المفيد من مجموعة البيانات:
## Drop Netherland, because only one row
df_train = df_train[df_train.native_country != "Holand-Netherlands"]
بعد ذلك، تقوم بتخزين موضع الميزات المستمرة في القائمة. سوف تحتاج إليها في الخطوة التالية لبناء خط الأنابيب.
يقوم الكود أدناه بالتكرار على جميع أسماء الأعمدة في CONTI_FEATURES، ويقرأ كل موقع (أي رقم عموده) ويلحقه بقائمة تسمى conti_features.
## Get the column index of the categorical features
conti_features = []
for i in CONTI_FEATURES:
    position = df_train.columns.get_loc(i)
    conti_features.append(position)
print(conti_features)
[0, 2, 10, 4, 11, 12]
تقوم الكتلة التالية بنفس المهمة بالنسبة للمتغيرات الفئوية.
## Get the column index of the categorical features
categorical_features = []
for i in CATE_FEATURES:
    position = df_train.columns.get_loc(i)
    categorical_features.append(position)
print(categorical_features)
[1, 3, 5, 6, 7, 8, 9, 13]
والآن انظر إلى مجموعة البيانات نفسها. كل سمة تصنيفية عبارة عن سلسلة نصية، ولا يمكن إدخال قيمة نصية إلى النموذج، لذلك يجب تحويل مجموعة البيانات باستخدام متغيرات وهمية.
df_train.head(5)
في الواقع، أنت بحاجة إلى عمود واحد لكل مجموعة في كل ميزة. أولاً، شغّل الكود أدناه لحساب إجمالي عدد الأعمدة المطلوبة.
print(df_train[CATE_FEATURES].nunique(),
      'There are',sum(df_train[CATE_FEATURES].nunique()), 'groups in the whole dataset')
workclass          9
education         16
marital            7
occupation        15
relationship       6
race               5
sex                2
native_country    41
dtype: int64 There are 101 groups in the whole dataset
تحتوي مجموعة البيانات الكاملة على 101 مجموعة، كما هو موضح أعلاه. تحتوي خاصية فئة العمل وحدها على تسع مجموعات. يمكنك سرد أسماء المجموعات باستخدام الكود أدناه؛ تُعيد الدالة unique() القيم المميزة لكل خاصية تصنيفية.
for i in CATE_FEATURES:
    print(df_train[i].unique())
['State-gov' 'Self-emp-not-inc' 'Private' 'Federal-gov' 'Local-gov' '?'
 'Self-emp-inc' 'Without-pay' 'Never-worked']
['Bachelors' 'HS-grad' '11th' 'Masters' '9th' 'Some-college' 'Assoc-acdm'
 'Assoc-voc' '7th-8th' 'Doctorate' 'Prof-school' '5th-6th' '10th'
 '1st-4th' 'Preschool' '12th']
['Never-married' 'Married-civ-spouse' 'Divorced' 'Married-spouse-absent'
 'Separated' 'Married-AF-spouse' 'Widowed']
['Adm-clerical' 'Exec-managerial' 'Handlers-cleaners' 'Prof-specialty'
 'Other-service' 'Sales' 'Craft-repair' 'Transport-moving'
 'Farming-fishing' 'Machine-op-inspct' 'Tech-support' '?'
 'Protective-serv' 'Armed-Forces' 'Priv-house-serv']
['Not-in-family' 'Husband' 'Wife' 'Own-child' 'Unmarried' 'Other-relative']
['White' 'Black' 'Asian-Pac-Islander' 'Amer-Indian-Eskimo' 'Other']
['Male' 'Female']
['United-States' 'Cuba' 'Jamaica' 'India' '?' 'Mexico' 'South'
 'Puerto-Rico' 'Honduras' 'England' 'Canada' 'Germany' 'Iran'
 'Philippines' 'Italy' 'Poland' 'Columbia' 'Cambodia' 'Thailand' 'Ecuador'
 'Laos' 'Taiwan' 'Haiti' 'Portugal' 'Dominican-Republic' 'El-Salvador'
 'France' 'Guatemala' 'China' 'Japan' 'Yugoslavia' 'Peru'
 'Outlying-US(Guam-USVI-etc)' 'Scotland' 'Trinadad&Tobago' 'Greece'
 'Nicaragua' 'Vietnam' 'Hong' 'Ireland' 'Hungary']
وبالتالي، ستحتوي مجموعة بيانات التدريب على 101 + 6 أعمدة: مجموعات الترميز الأحادي بالإضافة إلى الميزات الست المستمرة.
يمكن لمكتبة Scikit-learn أن تتولى عملية التحويل، على مرحلتين:
- حوّل السلسلة النصية إلى مُعرّف. على سبيل المثال، يصبح State-gov هو المُعرّف 1، ويصبح Self-emp-not-inc هو المُعرّف 2، وهكذا. يقوم LabelEncoder بذلك نيابةً عنك.
- انقل كل مُعرّف إلى عمود جديد. تحتوي مجموعة البيانات على 101 مُعرّف مجموعة، لذا سيكون هناك 101 عمودًا تُغطي كل مجموعة من مجموعات الميزات الفئوية. توفر مكتبة Scikit-learn مُشفّر OneHotEncoder لهذه العملية.
الخطوة 2) إنشاء مجموعة القطار/الاختبار
الآن وقد أصبحت مجموعة البيانات جاهزة، قم بتقسيمها بنسبة 80/20: 80 بالمائة لمجموعة التدريب و 20 بالمائة لمجموعة الاختبار.
يمكنك استخدام دالة train_test_split. الوسيط الأول هو إطار بيانات الميزات، والثاني هو التصنيف. يمكنك تحديد حجم مجموعة الاختبار باستخدام test_size.
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(df_train[features],
                                                    df_train.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train.head(5)
print(X_train.shape, X_test.shape)
(26048, 14) (6512, 14)
الخطوة 3) بناء خط الأنابيب
تسهّل هذه الآلية تزويد النموذج ببيانات متسقة. وتتلخص الفكرة في تمرير البيانات الأولية عبر كائن واحد يقوم بتنفيذ جميع العمليات بالتسلسل.
باستخدام هذه المجموعة من البيانات، ستحتاج إلى توحيد المتغيرات المستمرة وتحويل المتغيرات الفئوية. يمكن تنفيذ أي عملية ضمن مسار معالجة البيانات: يمكن استبدال القيم المفقودة بالمتوسط أو الوسيط، ويمكن إنشاء متغيرات جديدة.
أمامك خياران: إما برمجة العمليتين بشكل مباشر، أو إنشاء مسار معالجة. قد يؤدي البرمجة المباشرة إلى تسريب بيانات الاختبار إلى الإحصائيات المُعدّة، كما أنها تُسبب تناقضات مع مرور الوقت، لذا يُعدّ مسار المعالجة الخيار الأفضل.
from sklearn.preprocessing import StandardScaler, OneHotEncoder, LabelEncoder
from sklearn.compose import ColumnTransformer, make_column_transformer
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LogisticRegression
يقوم خط الأنابيب بعمليتين قبل تغذية المصنف اللوجستي:
- توحيد المتغير: StandardScaler()
- تحويل الميزات الفئوية: OneHotEncoder(sparse=False)
يمكنك تنفيذ كلتا الخطوتين باستخدام الدالة make_column_transformer. عند كتابة هذا الدليل، لم تكن هذه الدالة موجودة في الإصدار الرسمي من مكتبة scikit-learn (0.19)، ولذلك تم استخدام نسخة المطورين؛ وقد أُضيفت إلى جميع الإصدارات المستقرة منذ الإصدار 0.20.
تُعدّ دالة make_column_transformer بسيطة: ما عليك سوى تحديد الأعمدة المراد تحويلها ونوع التحويل المطلوب تطبيقه. ولتوحيد خصائص البيانات المتصلة، عليك تمرير ما يلي:
- conti_features، StandardScaler() داخل make_column_transformer
- conti_features: قائمة الأعمدة المتصلة
- StandardScaler: يقوم بتوحيد تلك الأعمدة
يقوم كائن OneHotEncoder الموجود داخل make_column_transformer بتشفير التسميات تلقائيًا.
preprocess = make_column_transformer(
    (conti_features, StandardScaler()),
    ### Need to be numeric not string to specify columns name
    (categorical_features, OneHotEncoder(sparse=False))
)
ملاحظة حول الإصدار: تم نقل وسيطين في الكتلة أعلاه. تتوقع الإصدارات الحالية تمرير المحول أولاً ثم الأعمدة ثانياً، و متناثر تمت إعادة تسميته مخرجات متفرقة تمت إضافته في مكتبة scikit-learn الإصدار 1.2، وتمت إزالته في الإصدار 1.4، لذا فإن الكود الأحدث يقرأ OneHotEncoder(sparse_output=False).
يمكنك اختبار ما إذا كانت عملية المعالجة تعمل باستخدام دالة fit_transform. يجب أن يكون شكل الناتج 26048 × 107.
preprocess.fit_transform(X_train).shape
(26048, 107)
مُحَوِّل البيانات جاهز. أنشئ مسار البيانات باستخدام make_pipeline، وبمجرد تحويل البيانات، قم بتغذية نموذج الانحدار اللوجستي.
model = make_pipeline(
    preprocess,
    LogisticRegression())
يصبح تدريب النموذج باستخدام مكتبة scikit-learn أمراً بسيطاً: ما عليك سوى استدعاء دالة fit في مسار البيانات. يمكنك طباعة دقة النموذج باستخدام دالة score.
model.fit(X_train, y_train)
print("logistic regression score: %f" % model.score(X_test, y_test))
logistic regression score: 0.850891
وأخيرًا، يمكنك التنبؤ بالفئات باستخدام دالة predict_proba، التي تُعيد احتمالية كل فئة. لاحظ أن مجموع الاحتمالين يساوي واحدًا.
model.predict_proba(X_test)
array([[0.83576663, 0.16423337],
       [0.94582765, 0.05417235],
       [0.64760587, 0.35239413],
       ...,
       [0.99639252, 0.00360748],
       [0.02072181, 0.97927819],
       [0.56781353, 0.43218647]])
الخطوة 4) استخدام خط الأنابيب الخاص بنا في بحث الشبكة
إن ضبط المعلمات الفائقة، وهي القيم التي تحدد بنية النموذج، يمكن أن يكون أمراً شاقاً ومرهقاً.
إحدى طرق تقييم النموذج هي تغيير حجم مجموعة التدريب وقياس الأداء، مع تكرار العملية عشر مرات لملاحظة مدى تباين النتائج. وهذا يتطلب جهداً يدوياً كبيراً.
بدلاً من ذلك، يوفر scikit-learn وظائف تقوم بضبط المعلمات والتحقق المتبادل نيابةً عنك.
عبر المصادقة
يعني التحقق المتقاطع أنه أثناء التدريب، تُقسّم مجموعة التدريب إلى n مجموعة فرعية، ويُقيّم النموذج n مرة. إذا تم ضبط قيمة التحقق المتقاطع على 10، فسيتم تدريب النموذج وتقييمه عشر مرات. في كل جولة، يتدرب المصنف على تسع مجموعات فرعية مختارة عشوائيًا، وتُحفظ المجموعة الفرعية العاشرة للتقييم.
بحث الشبكة
لكل مصنف معلمات فائقة قابلة للضبط. يمكنك تجربة القيم واحدة تلو الأخرى، أو تحديد شبكة معلمات. توضح وثائق مكتبة scikit-learn جميع المعلمات التي يقبلها المصنف اللوجستي. ولتسريع عملية التدريب، يركز هذا المثال على ضبط المعلمة C فقط، التي تتحكم في التنظيم. يجب أن تكون قيمتها موجبة، وكلما كانت صغيرة، زاد تأثير التنظيم.
يمكنك استخدام كائن GridSearchCV، الذي يأخذ قاموسًا بالمعلمات الفائقة المراد ضبطها. اذكر كل معلمة فائقة متبوعة بالقيم التي تريد تجربتها. لضبط لغة C، اكتب ما يلي:
- 'logisticregression__C': [0.001, 0.01, 0.1, 1.0] — اسم المعلمة مسبوق باسم المصنف بأحرف صغيرة وشرطتين سفليتين.
سيجرب النموذج أربع قيم مختلفة: 0.001، 0.01، 0.1 و 1. يتم تدريبه باستخدام 10 طيات، أي cv=10.
from sklearn.model_selection import GridSearchCV
# Construct the parameter grid
param_grid = {
    'logisticregression__C': [0.001, 0.01,0.1, 1.0],
    }
يمكنك الآن تدريب النموذج باستخدام GridSearchCV مع المعلمات grid و cv.
# Train the model
grid_clf = GridSearchCV(model,
                        param_grid,
                        cv=10,
                        iid=False)
grid_clf.fit(X_train, y_train)
الإخراج:
GridSearchCV(cv=10, error_score='raise-deprecating',
       estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...ty='l2', random_state=None, solver='liblinear', tol=0.0001,
          verbose=0, warm_start=False))]),
       fit_params=None, iid=False, n_jobs=1,
       param_grid={'logisticregression__C': [0.001, 0.01, 0.1, 1.0]},
       pre_dispatch='2*n_jobs', refit=True, return_train_score='warn',
       scoring=None, verbose=0)
ملاحظة حول الإصدار: القادم IID تم إيقاف الوسيط المرئي في هذا الإخراج في scikit-learn 0.22 وإزالته في 0.24، لذلك يجب ببساطة إسقاطه من استدعاء GridSearchCV في الإصدارات الحالية.
للوصول إلى أفضل المعلمات، يمكنك استخدام best_params_.
grid_clf.best_params_
الإخراج:
{'logisticregression__C': 1.0}
بعد تدريب النموذج باستخدام أربع قيم تنظيمية مختلفة، تعطي المعلمة المثلى ما يلي:
print("best logistic regression from grid search: %f" % grid_clf.best_estimator_.score(X_test, y_test))
أفضل انحدار لوجستي من بحث الشبكة: 0.850891
للوصول إلى الاحتمالات المتوقعة:
grid_clf.best_estimator_.predict_proba(X_test)
array([[0.83576677, 0.16423323],
       [0.9458291 , 0.0541709 ],
       [0.64760416, 0.35239584],
       ...,
       [0.99639224, 0.00360776],
       [0.02072033, 0.97927967],
       [0.56782222, 0.43217778]])
نموذج XGBoost مع scikit-Learn
والآن، جرّب أحد أقوى المصنفات المتوفرة في السوق. XGBoost هو تحسينٌ مُعزِّزٌ للتدرج على الغابة العشوائية. أما خلفيته النظرية فهي خارج نطاق هذا المقال. Python شرحٌ لـ Scikit، ولكن تذكر أن XGBoost قد فاز بالعديد من مسابقات Kaggle. على مجموعة بيانات متوسطة الحجم، يمكنه أن يؤدي أداءً مماثلاً لخوارزمية التعلم العميق، أو حتى أفضل.
يُعدّ تدريب هذا المصنّف تحديًا نظرًا لكثرة المعاملات التي يعرضها. يمكنك بالطبع استخدام GridSearchCV لاختيارها لك.
يُعدّ RandomizedSearchCV خيارًا أفضل هنا. إذ يُصبح GridSearchCV بطيئًا عند استخدام شبكة كبيرة، لأنّ مساحة البحث تتسع مع كل مُعامل مُضاف. بينما يقوم RandomizedSearchCV بأخذ عينات عشوائية من قيم كل مُعامل فائق في كل تكرار، ما يعني أنّ 1,000 تكرار تُقيّم 1,000 تركيبة. وبخلاف ذلك، فهو يعمل بشكل مُشابه لـ GridSearchCV.
تحتاج إلى استيراد مكتبة xgboost. إذا لم تكن المكتبة مثبتة، فقم بتشغيل الأمر pip3 install xgboost، أو قم بتثبيتها من داخل بيئة Jupyter دفتر ملاحظات يحتوي على:
use import sys
!{sys.executable} -m pip install xgboost
ثم استورد المصنف ومساعدي البحث:
import xgboost
from sklearn.model_selection import RandomizedSearchCV
from sklearn.model_selection import StratifiedKFold
الخطوة التالية في هذا Scikit Python يهدف هذا البرنامج التعليمي إلى تحديد المعلمات المراد ضبطها. تُدرج وثائق XGBoost الرسمية جميع هذه المعلمات. لهذا الغرض Python في برنامج Sklearn التعليمي، يمكنك اختيار اثنين فقط من المعلمات الفائقة بقيمتين لكل منهما، لأن XGBoost يستغرق وقتًا طويلاً للتدريب وكل نقطة شبكة إضافية تزيد من وقت الانتظار.
params = {
        'xgbclassifier__gamma': [0.5, 1],
        'xgbclassifier__max_depth': [3, 4]
        }
بعد ذلك، تقوم بإنشاء مسار معالجة جديد باستخدام مصنف XGBoost و600 مُقدِّر. يمكن ضبط قيمة n_estimators، وقد تؤدي القيمة العالية إلى فرط التخصيص. يمكنك تجربة قيم أخرى، ولكن ضع في اعتبارك أن ذلك قد يستغرق ساعات. تبقى جميع المعلمات الأخرى على قيمها الافتراضية.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1)
)
يمكنك تحسين عملية التحقق المتقاطع باستخدام مُدقِّق التحقق المتقاطع الطبقي ذي الطيات المتعددة (Stratified K-Folds). يُستخدم هنا ثلاث طيات فقط لتسريع الحساب، على حساب بعض الجودة؛ يمكنك زيادة هذا العدد إلى 5 أو 10 على جهازك للحصول على نتائج أفضل. يتم تدريب النموذج على مدار أربع دورات.
skf = StratifiedKFold(n_splits=3,
                      shuffle = True,
                      random_state = 1001)

random_search = RandomizedSearchCV(model_xgb,
                                   param_distributions=params,
                                   n_iter=4,
                                   scoring='accuracy',
                                   n_jobs=4,
                                   cv=skf.split(X_train, y_train),
                                   verbose=3,
                                   random_state=1001)
البحث العشوائي جاهز، لذا يمكنك تدريب النموذج.
#grid_xgb = GridSearchCV(model_xgb, params, cv=10, iid=False)
random_search.fit(X_train, y_train)
Fitting 3 folds for each of 4 candidates, totalling 12 fits
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8759645283888057, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8729701715996775, total= 1.0min
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8706519235199263, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8735460094437406, total= 1.3min
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8722791661868018, total=  57.7s
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8753886905447426, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8697304768486523, total= 1.3min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8740066797189912, total= 1.4min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8707671043538355, total= 1.0min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8729701715996775, total= 1.2min
[Parallel(n_jobs=4)]: Done  10 out of  12 | elapsed:  3.6min remaining:   43.5s
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8736611770125533, total= 1.2min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8692697535130154, total= 1.2min
[Parallel(n_jobs=4)]: Done  12 out of  12 | elapsed:  3.6min finished
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/model_selection/_search.py:737: DeprecationWarning: The default of the `iid` parameter will change from True to False in version 0.22 and will be removed in 0.24. This will change numeric results when test-set sizes are unequal. DeprecationWarning)
RandomizedSearchCV(cv=<generator object _BaseKFold.split at 0x1101eb830>,
          error_score='raise-deprecating',
          estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))]),
          fit_params=None, iid='warn', n_iter=4, n_jobs=4,
          param_distributions={'xgbclassifier__gamma': [0.5, 1], 'xgbclassifier__max_depth': [3, 4]},
          pre_dispatch='2*n_jobs', random_state=1001, refit=True,
          return_train_score='warn', scoring='accuracy', verbose=3)
كما ترون، فإن XGBoost يحقق نتائج أفضل من الانحدار اللوجستي السابق.
print("أفضل parameter", random_search.best_params_)
print("best logistic regression from grid search: %f" % random_search.best_estimator_.score(X_test, y_test))
أفضل parameter {'xgbclassifier__max_depth': 3, 'xgbclassifier__gamma': 0.5}
best logistic regression from grid search: 0.873157
random_search.best_estimator_.predict(X_test)
array(['<=50K', '<=50K', '<=50K', ..., '<=50K', '>50K', '<=50K'], dtype=object)
قم بإنشاء DNN باستخدام MLPClassifier في scikit-learn
وأخيرًا، يمكنك تدريب شبكة عصبية باستخدام مكتبة scikit-learn نفسها. الطريقة هي نفسها المستخدمة مع أي مصنف آخر، والمُقدِّر هو MLPClassifier.
from sklearn.neural_network import MLPClassifier
تُعرَّف الشبكة أدناه بما يلي:
- آدم حلال
- وظيفة تنشيط ReLU
- ألفا = 0.0001
- حجم الدفعة 150
- طبقتان مخفيتان تحتويان على 200 و100 خلية عصبية على التوالي
model_dnn = make_pipeline(
    preprocess,
    MLPClassifier(solver='adam',
                  alpha=0.0001,
                  activation='relu',
                    batch_size=150,
                    hidden_layer_sizes=(200, 100),
                    random_state=1))
يمكنك تغيير عدد الطبقات لتحسين النموذج.
model_dnn.fit(X_train, y_train)
  print("DNN regression score: %f" % model_dnn.score(X_test, y_test))
درجة انحدار DNN: 0.821253
لايم: ثق بنموذجك
الآن وقد أصبح لديك نموذج جيد، فأنت بحاجة إلى طريقة للوثوق به. تُعرف خوارزميات التعلم الآلي، وخاصة الغابات العشوائية والشبكات العصبية، بنماذج الصندوق الأسود: فهي تعمل، ولكن لا أحد يستطيع معرفة السبب.
قام ثلاثة باحثين بتطوير أداة توضح كيف يتوصل الحاسوب إلى التنبؤ. ورقتهم البحثية بعنوان: "لماذا يجب أن أثق بك؟"والخوارزمية التي نشروها تسمى التفسيرات المحلية القابلة للتفسير غير المعتمدة على النموذج (LIME).
لنأخذ مثالاً. أحياناً لا يمكنك التأكد من مدى موثوقية تنبؤات التعلم الآلي. لا يمكن للطبيب قبول تشخيص لمجرد أن الحاسوب أصدره، ويجب التأكد من موثوقية النموذج قبل استخدامه في الإنتاج.
تخيل أن تكون قادرًا على فهم سبب تنبؤ أي مصنف، حتى بالنسبة للنماذج المعقدة كالشبكات العصبية، والغابات العشوائية، وآلات المتجهات الداعمة ذات النواة العشوائية. يصبح من الأسهل بكثير الوثوق بالتنبؤ عندما تكون الأسباب الكامنة وراءه واضحة، كما يصبح من الأسهل تحديد متى لا ينبغي الوثوق بنموذج ما. يُخبرك LIME بالخصائص التي دفعت المصنف إلى اتخاذ قراره.
تحضير البيانات
هناك بعض الأشياء التي تحتاج إلى تغييرها لتشغيل LIME Pythonأولاً، قم بتثبيت Lime في الطرفية باستخدام الأمر pip install lime.
يستخدم Lime كائن LimeTabularExplainer لتقريب النموذج محليًا. يتطلب هذا الكائن ما يلي:
- مجموعة بيانات في نمباي شكل
- اسم الميزات: feature_names
- اسم الفئات: class_names
- فهرس عمود الميزات الفئوية: categorical_features
- اسم المجموعة لكل سمة تصنيفية: categorical_names
أنشئ مجموعة بيانات التدريب NumPy
يمكنك نسخ وتحويل df_train من pandas إلى NumPy بسهولة بالغة.
df_train.head(5)
# Create numpy data
df_lime = df_train
df_lime.head(3)
احصل على اسم الفصل
يمكن الوصول إلى الوسم من خلال الدالة unique(). يجب أن ترى ما يلي:
- "<= 50 ألف"
- "> 50 ألفًا"
# Get the class name
class_names = df_lime.label.unique()
class_names
array(['<=50K', '>50K'], dtype=object)
فهرسة أعمدة السمات الفئوية
استخدم الطريقة التي تعلمتها سابقًا للحصول على اسم كل مجموعة. قم بتشفير التسمية باستخدام LabelEncoder وكرر العملية على كل سمة تصنيفية.
##
import sklearn.preprocessing as preprocessing
categorical_names = {}
for feature in CATE_FEATURES:
    le = preprocessing.LabelEncoder()
    le.fit(df_lime[feature])
    df_lime[feature] = le.transform(df_lime[feature])
    categorical_names[feature] = le.classes_
print(categorical_names)
{'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}

df_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
label              object
dtype: object
الآن وقد أصبحت مجموعة البيانات جاهزة، يمكنك إنشاء مجموعات البيانات المختلفة الموضحة في أمثلة Scikit-learn أدناه. يتم تحويل البيانات خارج مسار المعالجة هنا لتجنب أخطاء LIME: يجب أن تكون مجموعة التدريب المُمررة إلى LimeTabularExplainer عبارة عن مصفوفة NumPy بدون سلاسل نصية، وقد أنتجت الطريقة المذكورة أعلاه واحدة بالفعل.
from sklearn.model_selection import train_test_split
X_train_lime, X_test_lime, y_train_lime, y_test_lime = train_test_split(df_lime[features],
                                                    df_lime.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train_lime.head(5)
يمكنك إنشاء خط الأنابيب باستخدام المعلمات المثلى التي تم العثور عليها بواسطة XGBoost.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(max_depth = 3,
                          gamma = 0.5,
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1))

model_xgb.fit(X_train_lime, y_train_lime)
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/preprocessing/_encoders.py:351: FutureWarning: The handling of integer data will change in version 0.22. Currently, the categories are determined based on the range [0, max(values)], while in the future they will be determined based on the unique values.
If you want the future behavior and silence this warning, you can specify "categories='auto'."In case you used a LabelEncoder before this OneHotEncoder to convert the categories to integers, then you can now use the OneHotEncoder directly.
  warnings.warn(msg, FutureWarning)
Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))])
ستتلقى تحذيرًا. يوضح هذا التحذير أنه ليس من الضروري إنشاء مُشفِّر تصنيفات قبل بدء عملية المعالجة. إذا كنت لا تستخدم LIME، فإن الطريقة المذكورة في الجزء الأول من هذا الدليل التعليمي حول التعلم الآلي باستخدام Scikit-learn مناسبة. وإلا، فاتبع هذه الطريقة: أنشئ أولًا مجموعة بيانات مُشفَّرة، ثم طبِّق مُشفِّر one-hot داخل عملية المعالجة.
print("best logistic regression from grid search: %f" % model_xgb.score(X_test_lime, y_test_lime))
best logistic regression from grid search: 0.873157
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
قبل استخدام LIME، أنشئ مصفوفة NumPy تحتوي على خصائص الصفوف المصنفة بشكل خاطئ. يمكنك استخدام هذه القائمة لاحقًا لفهم سبب تضليل المصنف.
temp = pd.concat([X_test_lime, y_test_lime], axis= 1)
temp['predicted'] = model_xgb.predict(X_test_lime)
temp['wrong']=  temp['label'] != temp['predicted']
temp = temp.query('wrong==True').drop('wrong', axis=1)
temp= temp.sort_values(by=['label'])
temp.shape
(826، 16)
ثم تقوم بإنشاء دالة لامدا تسترجع التنبؤ من النموذج لبيانات جديدة. ستحتاج إليها قريبًا.
predict_fn = lambda x: model_xgb.predict_proba(x).astype(float)
X_test_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
dtype: object
predict_fn(X_test_lime)
array([[7.96461046e-01, 2.03538969e-01],
       [9.51730132e-01, 4.82698716e-02],
       [7.93448269e-01, 2.06551731e-01],
       ...,
       [9.90314305e-01, 9.68566816e-03],
       [6.45816326e-04, 9.99354184e-01],
       [9.71042812e-01, 2.89571714e-02]])
تقوم بتحويل إطار بيانات Pandas إلى مصفوفة NumPy.
X_train_lime = X_train_lime.values
X_test_lime = X_test_lime.values
X_test_lime
array([[4.00000e+01, 5.00000e+00, 1.93524e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.70000e+01, 4.00000e+00, 2.16481e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.50000e+01, 4.00000e+00, 2.56263e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       ...,
       [2.80000e+01, 6.00000e+00, 2.11032e+05, ..., 0.00000e+00,
        4.00000e+01, 2.50000e+01],
       [4.40000e+01, 4.00000e+00, 1.67005e+05, ..., 0.00000e+00,
        6.00000e+01, 3.80000e+01],
       [5.30000e+01, 4.00000e+00, 2.57940e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01]])
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
print(features,
      class_names,
      categorical_features,
      categorical_names)
['age', 'workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country'] ['<=50K' '>50K'] [1, 3, 5, 6, 7, 8, 9, 13] {'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}
import lime
import lime.lime_tabular
### Train should be label encoded not one hot encoded
explainer = lime.lime_tabular.LimeTabularExplainer(X_train_lime ,
                                                   feature_names = features,
                                                   class_names=class_names,
                                                   categorical_features=categorical_features,
                                                   categorical_names=categorical_names,
                                                   kernel_width=3)
والآن اختر أسرة عشوائية من مجموعة الاختبار وشاهد كلاً من التوقع وكيف توصل الكمبيوتر إليه.
import numpy as np
np.random.seed(1)
i = 100
print(y_test_lime.iloc[i])
>50K
X_test_lime[i]
array([4.20000e+01, 4.00000e+00, 1.76286e+05, 7.00000e+00, 1.20000e+01,
       2.00000e+00, 4.00000e+00, 0.00000e+00, 4.00000e+00, 1.00000e+00,
       0.00000e+00, 0.00000e+00, 4.00000e+01, 3.80000e+01])
يمكنك استخدام أداة الشرح مع دالة explain_instance لفحص المنطق الكامن وراء النموذج. يظهر الرسم البياني الذي تُنتجه أدناه.
exp = explainer.explain_instance(X_test_lime[i], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

لقد تنبأ المصنف بهذه الأسرة بشكل صحيح: الدخل بالفعل أعلى من 50 ألف.
أول ما يُلاحظ هو أن المصنف غير واثق تمامًا من نفسه. فهو يتوقع دخلًا يزيد عن 50 ألفًا باحتمالية 64%، وتعتمد هذه النسبة على مكاسب رأس المال والحالة الاجتماعية. يُساهم اللون الأزرق سلبًا في الفئة الإيجابية، بينما يُساهم الخط البرتقالي إيجابًا.
يتردد المصنف لأن مكاسب رأس المال لهذه الأسرة معدومة، مع أن مكاسب رأس المال عادةً ما تكون مؤشراً جيداً للثروة. كما أن الأسرة تعمل أقل من 40 ساعة أسبوعياً. ويساهم كل من العمر والمهنة والجنس بشكل إيجابي.
إذا كانت الحالة الاجتماعية هي العزوبية، فإن المصنف كان سيتوقع دخلاً أقل من 50 ألف (0.64 – 0.18 = 0.46).
والآن، جرب أسرة أخرى، أسرة تم تصنيفها بشكل خاطئ. ستجد جدول الشرح الخاص بها بعد الرمز.
temp.head(3)
temp.iloc[1,:-2]
age                  58
workclass             4
fnlwgt            68624
education            11
education_num         9
marital               2
occupation            4
relationship          0
race                  4
sex                   1
capital_gain          0
capital_loss          0
hours_week           45
native_country       38
Name: 20931, dtype: object
i = 1
print('This observation is', temp.iloc[i,-2:])
This observation is label        <=50K
predicted     >50K
Name: 20931, dtype: object
exp = explainer.explain_instance(temp.iloc[1,:-2], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

توقع المصنف دخلاً أقل من 50 ألفاً، وهذا خطأ. هذه الأسرة غير معتادة: فهي لا تملك ربحاً رأسمالياً ولا خسارة رأسمالية، وصاحبها مطلق، ويقارب الستين من عمره، ومتعلم (عدد سنوات دراسته > 12). وبناءً على النمط العام، صنّف المصنف دخل الأسرة بأقل من 50 ألفاً.
جرّب LIME بنفسك وستلاحظ العديد من الأخطاء الواضحة في المصنف. يحتوي مستودع GitHub الخاص بمؤلف المكتبة على وثائق إضافية لتصنيف الصور والنصوص.
مرجع أوامر مكتبة Scikit-learn
فيما يلي قائمة بالأوامر المفيدة التي تنطبق على إصدار scikit-learn 0.20 والإصدارات الأحدث.
| مهمة | دالة أو فئة |
|---|---|
| أنشئ مجموعة بيانات التدريب/الاختبار | Train_test_split |
| بناء خط أنابيب | |
| حدد الأعمدة وقم بتطبيق التحويل | إنشاء محول الأعمدة |
| نوع التحويل | |
| توحيد المعايير | مقياس قياسي |
| التحجيم الأدنى والأقصى | MinMaxScaler |
| تطبيع | عادي |
| إدخال القيم المفقودة | SimpleImputer |
| تحويل الفئوية | OneHotEncoder |
| ملاءمة البيانات وتحويلها | fit_transform |
| اصنع خط الانابيب | make_pipeline |
| النموذج الأساسي | |
| الانحدار اللوجستي | الانحدار اللوجستي |
| XGBoost | XGBClassifier |
| الشبكة العصبية | MLPC التصنيف |
| بحث الشبكة | GridSearchCV |
| بحث عشوائي | البحث العشوائي |
