
البرنامج التعليمي للانحدار الخطي باستخدام TensorFlow [أمثلة]
 فريق التحرير
⚡ ملخص ذكي
يُستخدم الانحدار الخطي في TensorFlow لنمذجة العلاقة بين المتغيرات العددية وقيمة الهدف المستمرة. يشرح هذا الدليل كيفية تدريب نموذج تنبؤ أسعار المساكن في بوسطن بثلاث طرق مختلفة، باستخدام مكتبات Pandas وNumPy وTensorFlow الأصلية مع مُقدِّر LinearRegressor.
ما هو الانحدار الخطي؟
الانحدار الخطي الانحدار الخطي هو أسلوب إحصائي لنمذجة العلاقات بين متغيرين. تتم هذه النمذجة بين استجابة عددية ومتغير تفسيري واحد أو أكثر. تُسمى العلاقة مع متغير تفسيري واحد بالانحدار الخطي البسيط، ومع أكثر من متغير تفسيري بالانحدار الخطي المتعدد.
يوفر TensorFlow أدوات للتحكم الكامل في العمليات الحسابية. يتم ذلك باستخدام واجهة برمجة التطبيقات (API) ذات المستوى المنخفض. علاوة على ذلك، تم تجهيز TensorFlow بمجموعة واسعة من واجهات برمجة التطبيقات (APIs) لأداء العديد منها آلة التعلم الخوارزميات. هذه هي واجهة برمجة التطبيقات عالية المستوى، ويطلق عليها TensorFlow اسم المُقدِّرات.
- واجهة برمجة التطبيقات ذات المستوى المنخفضقم ببناء بنية النموذج وتحسينه من الصفر. إنه أمر معقد بالنسبة للمبتدئين.
- API عالي المستوىحدد الخوارزمية. إنها سهلة الاستخدام. يوفر TensorFlow مجموعة أدوات تسمى مقدر لبناء وتدريب وتقييم والتنبؤ.
في هذا البرنامج التعليمي، سوف تستخدم المقدرين فقطتتميز هذه العمليات الحسابية بالسرعة وسهولة التنفيذ. يشرح الجزء الأول كيفية استخدام مُحسِّن التدرج الهبوطي لتدريب نموذج الانحدار الخطي في TensorFlow. في الجزء الثاني، ستستخدم مجموعة بيانات بوسطن للتنبؤ بسعر منزل باستخدام مُقدِّر TensorFlow.
كيفية تدريب نموذج الانحدار الخطي
قبل أن نبدأ بتدريب النموذج، دعونا نلقي نظرة على ماهية الانحدار الخطي في الواقع.
تخيل أن لديك متغيرين، x و y، ومهمتك هي التنبؤ بقيمة y بمعرفة قيمة x. إذا قمت برسم البيانات، يمكنك أن ترى علاقة إيجابية بين المتغير المستقل x والمتغير التابع y، كما يوضح مخطط الانتشار أدناه.

قد تلاحظ أنه إذا كانت x=1، فإن y ستكون مساوية تقريبًا لـ 6، وإذا كانت x=2، فإن y ستكون حوالي 8.5.
هذه ليست طريقة دقيقة للغاية وعرضة للخطأ، خاصة مع مجموعة بيانات تحتوي على مئات الآلاف من النقاط.
يتم تقييم الانحدار الخطي بمعادلة. يتم تفسير المتغير y بمتغير واحد أو أكثر. في المثال الخاص بك، هناك متغير تابع واحد فقط. إذا كان عليك كتابة هذه المعادلة فستكون:

مع:
 هذا هو الانحياز. أي، إذا كانت x=0، فإن y=
 الوزن المرتبط بـ x
 يمثل الباقي، أو خطأ النموذج. وهو يشمل ما لا يستطيع النموذج تعلمه من البيانات.
تخيل أنك قمت بتركيب النموذج ووجدت الحل التالي لـ:
- = 3.8
- = 2.78
يمكنك استبدال تلك الأرقام في المعادلة وتصبح:
ص = 3.8 + 2.78x
أصبح لديك الآن طريقة أفضل لإيجاد قيم y. أي أنه يمكنك استبدال x بأي قيمة تريدها للتنبؤ بـ y. في الصورة أدناه، استبدلنا x في المعادلة بجميع القيم الموجودة في مجموعة البيانات ورسمنا النتيجة.

يمثل الخط الأحمر القيمة المتوقعة، أي قيم y لكل قيمة من قيم x. لا تحتاج إلى معرفة قيمة x للتنبؤ بقيمة y؛ فلكل قيمة x قيمة تقع على الخط الأحمر. يمكنك أيضًا التنبؤ بقيم x الأكبر من 2.
إذا أردتَ توسيع نطاق الانحدار الخطي ليشمل المزيد من المتغيرات المساعدة، يمكنك فعل ذلك بإضافة المزيد من المتغيرات إلى النموذج. والفرق بين التحليل التقليدي والانحدار الخطي هو أن الانحدار الخطي يدرس كيفية تفاعل المتغير y مع كل متغير x على حدة.
لنلقِ نظرة على مثال. تخيل أنك تريد التنبؤ بمبيعات محل آيس كريم. تحتوي مجموعة البيانات على معلومات مختلفة مثل حالة الطقس (ممطر، مشمس، غائم) ومعلومات العملاء (الراتب، الجنس، الحالة الاجتماعية).
تحاول التحليلات التقليدية التنبؤ بالمبيعات، على سبيل المثال، بحساب متوسط كل متغير ومحاولة تقدير المبيعات في سيناريوهات مختلفة. وهذا يؤدي إلى تنبؤات غير دقيقة ويحصر التحليل في السيناريو المختار.
إذا كنت تستخدم الانحدار الخطي، يمكنك كتابة هذه المعادلة:
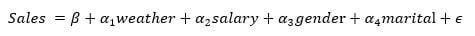
ستجد الخوارزمية أفضل حل للأوزان؛ وهذا يعني أنها ستحاول تقليل التكلفة، وهي الفرق بين الخط المُلائم ونقاط البيانات.
كيف تعمل الخوارزمية
يلخص الرسم البياني أدناه الحلقة التي تكررها الخوارزمية: اختيار الأوزان، والتنبؤ بـ y، وقياس الخطأ، وتصحيح الأوزان.

ستختار الخوارزمية رقمًا عشوائيًا لكل منها  و
 واستبدل قيمة x للحصول على القيمة المتوقعة لـ y. إذا كانت مجموعة البيانات تحتوي على 100 ملاحظة، فإن الخوارزمية تحسب 100 قيمة متوقعة.
وأشار إلى أنه يمكننا حساب الخطأ  يمثل الخطأ في النموذج الفرق بين القيمة المتوقعة والقيمة الحقيقية. يشير الخطأ الموجب إلى أن النموذج يقلل من قيمة التنبؤ لـ y، بينما يشير الخطأ السالب إلى أن النموذج يبالغ في تقدير قيمة التنبؤ لـ y.

هدفكم هو تقليل مربع الخطأ. تحسب الخوارزمية متوسط مربع الخطأ. تُسمى هذه الخطوة تقليل الخطأ. بالنسبة للانحدار الخطي، هذا هو متوسط مربع الخطأ، وتسمى أيضًا MSE. رياضياً فهو:

أين:
 هذه هي الأوزان، لذا
 يشير إلى القيمة المتوقعة
- y هي القيم الحقيقية
- يمثل m عدد المشاهدات
 يشير إلى القيمة المتوقعة
نلاحظ أن  يعني أنه يستخدم تبديل المصفوفات. ال
 هو التدوين الرياضي للمتوسط.
الهدف هو العثور على الأفضل  مما يقلل من متوسط مربع الخطأ.
إذا كان متوسط الخطأ كبيرا، فهذا يعني أن أداء النموذج ضعيف ولم يتم اختيار الأوزان بشكل صحيح. لتصحيح الأوزان، تحتاج إلى استخدام محسن. يسمى المحسن التقليدي نزول متدرج.
تعتمد خوارزمية التدرج الهبوطي على حساب المشتقة، ثم تُقلل أو تزيد الوزن. إذا كانت المشتقة موجبة، يُقلل الوزن. وإذا كانت سالبة، يزيد الوزن. يقوم النموذج بتحديث الأوزان وإعادة حساب الخطأ. تتكرر هذه العملية حتى يستقر الخطأ. تُسمى كل دورة دورةً واحدة. تكريرإلى جانب ذلك، يتم ضرب التدرجات بمعدل التعلم، مما يشير إلى سرعة التعلم.
إذا كان معدل التعلم منخفضًا جدًا، فسيستغرق تقارب الخوارزمية وقتًا طويلاً جدًا، لأنها تتطلب عددًا أكبر بكثير من التكرارات. أما إذا كان معدل التعلم مرتفعًا جدًا، فقد لا تتقارب الخوارزمية أبدًا. يوضح منحنى الخسارة أدناه العلاقة بين الخطأ وعدد التكرارات لهذه المجموعة من البيانات.

يمكنك أن ترى من الصورة أعلاه أن النموذج يكرر العملية حوالي 20 مرة قبل أن يجد قيمة مستقرة للأوزان، وبالتالي يصل إلى أقل خطأ.
لاحظ أن الخطأ لا يساوي الصفر، بل يستقر عند حوالي 5. وهذا يعني أن النموذج يرتكب خطأً نموذجياً قدره 5. إذا كنت ترغب في تقليل الخطأ، فأنت بحاجة إلى إضافة المزيد من المعلومات إلى النموذج، مثل المزيد من المتغيرات، أو استخدام مقدرات مختلفة.
هل تتذكر المعادلة الأولى؟

الأوزان النهائية هي 3.8 و 2.78. يوضح الفيديو أدناه كيف تعمل خوارزمية التدرج الهبوطي على تحسين دالة الخسارة لإيجاد هذه الأوزان.
كيفية تدريب الانحدار الخطي مع TensorFlow
الآن بعد أن أصبح لديك فهم أفضل لما يحدث خلف الغطاء، أصبحت جاهزًا لاستخدام واجهة برمجة التطبيقات المقدرة التي توفرها TensorFlow لتدريب الانحدار الخطي الأول باستخدام TensorFlow.
ملاحظة حول الإصدار: تمت كتابة سير عمل المُقدِّر الموضح أدناه باستخدام TensorFlow 1.x والإصدارات الأولى من 2.x. وقد مثّل TensorFlow tf.estimator و tf.feature_column تم إيقاف واجهات برمجة التطبيقات (APIs) بالكامل في الإصدار 2.12، وتم حذف المُقدِّرات (Estimators) في الإصدار 2.16. في التثبيت الحالي، شغِّل هذا الكود داخل TensorFlow 1.15 أو 2.x-with-tf.compat.v1 البيئة، أو قم بنقلها إلى Keras، حيث tf.keras.layers.Dense(1) بالإضافة إلى ذلك، تحل طبقات المعالجة المسبقة محل نموذج الانحدار الخطي وأعمدة الميزات. أما المفاهيم - الميزات، والتصنيفات، والدفعات، والحقب، ومتوسط مربعات الخطأ، وانحدار التدرج - فتبقى كما هي دون تغيير.
ستستخدم مجموعة بيانات بوسطن، والتي تتضمن المتغيرات التالية.
| متغير | الوصف |
| الجريمة | معدل الجريمة للفرد حسب المدينة |
| zn | نسبة الأراضي السكنية المخصصة للقطع التي تزيد مساحتها عن 25,000 قدم مربع. |
| وال | نسبة فدان الأعمال غير التجزئة لكل مدينة. |
| أكاسيد النيتروجين | تركيز أكاسيد النيتريك |
| rm | متوسط عدد الغرف لكل مسكن |
| السن | نسبة الوحدات التي يشغلها المالك والتي تم بناؤها قبل عام 1940 |
| ديس | المسافات الموزونة إلى خمسة مراكز توظيف في بوسطن |
| ضريبة | معدل ضريبة الأملاك كاملة القيمة لكل دولار 10,000 |
| com.ptratio | نسبة التلاميذ إلى المعلمين حسب المدينة |
| medv | القيمة المتوسطة للمنازل التي يشغلها مالكوها بآلاف الدولارات |
ستقوم بإنشاء ثلاث مجموعات بيانات مختلفة:
| بيانات | موضوعي | شكل |
| التدريب | تدريب النموذج والحصول على الأوزان | 400 , 10 |
| التقييم | تقييم أداء النموذج على البيانات غير المرئية | 100 , 10 |
| تنبؤ | استخدم النموذج للتنبؤ بقيمة المنزل بناءً على البيانات الجديدة | 6 , 10 |
الهدف هو استخدام خصائص مجموعة البيانات للتنبؤ بقيمة المنزل.
خلال الجزء الثاني من البرنامج التعليمي، ستتعلم كيفية استخدام TensorFlow بثلاث طرق مختلفة لاستيراد البيانات:
- مع الباندا
- مع نمباي
- TensorFlow فقط
لاحظ أن الخيارات الثلاثة جميعها تعطي نفس النتائج.
ستتعلم كيفية استخدام واجهة برمجة التطبيقات عالية المستوى لبناء نموذج انحدار خطي في TensorFlow وتدريبه وتقييمه. أما إذا كنت تستخدم واجهة برمجة التطبيقات منخفضة المستوى، فسيتعين عليك تعريف ما يلي يدويًا:
- فقدان وظيفة
- المُحسِّن: انحدار التدرج
- مصفوفة الضرب
- الرسم البياني والموتر
هذا الأمر ممل ومعقد بالنسبة للمبتدئين.
حلول باندا
تحتاج إلى استيراد المكتبات اللازمة لتدريب النموذج.
import pandas as pd
from sklearn import datasets
import tensorflow as tf
import itertools
الخطوة 1) استيراد البيانات مع الباندا.
تقوم بتحديد أسماء الأعمدة وتخزينها في COLUMNS. يمكنك استخدام pd.read_csv() لاستيراد البيانات.
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
           "dis", "tax", "ptratio", "medv"]
قم بتوجيه كل مكالمة إلى ملفات CSV التي قمت بتنزيلها سابقًا.
training_set = pd.read_csv("E:/boston_train.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
test_set = pd.read_csv("E:/boston_test.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
prediction_set = pd.read_csv("E:/boston_predict.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
يمكنك طباعة شكل البيانات.
print(training_set.shape, test_set.shape, prediction_set.shape)
الناتج
(400, 10) (100, 10) (6, 10)
لاحظ أن التصنيف، أي المتغير y، مُضمّن في مجموعة البيانات. لذا، عليك تعريف قائمتين إضافيتين: إحداهما تحتوي على الميزات فقط، والأخرى تحتوي على اسم التصنيف فقط. ستُخبر هاتان القائمتان المُقدِّرَ الخاص بك ما هي الميزات في مجموعة البيانات، وما هو اسم العمود الذي يُمثِّل التصنيف.
يتم ذلك باستخدام الكود أدناه.
FEATURES = ["crim", "zn", "indus", "nox", "rm",
                 "age", "dis", "tax", "ptratio"]
LABEL = "medv"
الخطوة 2) تحويل البيانات
يجب تحويل المتغيرات الرقمية إلى التنسيق الصحيح. يوفر TensorFlow طريقة لتحويل متغير مستمر: tf.feature_column.numeric_column().
في الخطوة السابقة، حددتَ قائمةً بالخصائص التي ترغب في تضمينها في النموذج. يمكنك الآن استخدام هذه القائمة لتحويلها إلى بيانات رقمية. إذا كنت ترغب في استبعاد خصائص من نموذجك، يمكنك حذف متغير واحد أو أكثر من قائمة الخصائص (FEATURES) قبل إنشاء أعمدة الخصائص (feature_cols).
لاحظ أنك ستستخدم Python استخدام دالة فهم القوائم مع القائمة FEATURES لإنشاء قائمة جديدة باسم feature_cols. هذا يُجنّبك كتابة tf.feature_column.numeric_column() تسع مرات. تُعدّ دالة فهم القوائم طريقة أسرع وأكثر سلاسة لإنشاء قوائم جديدة.
feature_cols = [tf.feature_column.numeric_column(k) for k in FEATURES]
الخطوة 3) تحديد المقدر
في هذه الخطوة، عليك تحديد المُقدِّر. يوفر TensorFlow ستة مُقدِّرات جاهزة، ثلاثة منها لمهام التصنيف وثلاثة لمهام الانحدار في TensorFlow:
- تراجع
- DNNRegressor
- الانحدار الخطي
- نموذج الانحدار الخطي المدمج DNN
- صنف
- مصنف DNN
- المصنف الخطي
- DNNLinearCombinedClassifier
في هذا البرنامج التعليمي، سوف تستخدم الخطي الانحداري. للوصول إلى هذه الوظيفة، تحتاج إلى استخدام tf.estimator.
تحتاج الدالة إلى وسيطتين:
- أعمدة الميزات: تحتوي على المتغيرات المراد تضمينها في النموذج
- model_dir: مسار تخزين الرسم البياني، وحفظ معلمات النموذج، وما إلى ذلك
سيقوم TensorFlow تلقائيًا بإنشاء مجلد باسم train في دليل العمل الخاص بك. ستحتاج إلى استخدام هذا المسار للوصول إليه. TensorBoardكما هو موضح في مثال الانحدار باستخدام TensorFlow أدناه.
estimator = tf.estimator.LinearRegressor(
        feature_columns=feature_cols,
        model_dir="train")
الناتج
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a215dc550>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
يكمن التحدي في TensorFlow في طريقة تغذية النموذج. صُمم TensorFlow للعمل مع الحوسبة المتوازية ومجموعات البيانات الضخمة جدًا. ونظرًا لمحدودية موارد الجهاز، يستحيل تغذية النموذج بجميع البيانات دفعة واحدة. لذا، يجب تغذية النموذج بدفعة من البيانات في كل مرة. تجدر الإشارة إلى أننا نتحدث هنا عن مجموعات بيانات ضخمة تضم ملايين السجلات أو أكثر. في حال عدم إضافة دفعة، ستواجه خطأ في الذاكرة.
على سبيل المثال، إذا كانت بياناتك تحتوي على 100 ملاحظة وقمت بتحديد حجم دفعة قدره 10، فهذا يعني أن النموذج سوف يرى 10 ملاحظات لكل تكرار (10*10).
عندما يُعاين النموذج جميع البيانات، يُنهي دورة تدريبية واحدة. تُحدد الدورة التدريبية عدد مرات معاينة النموذج للبيانات. من الأفضل ضبط هذه الخطوة على "لا شيء" والسماح للنموذج بتنفيذ عدد محدد من التكرارات.
معلومة أخرى جديرة بالذكر هي ما إذا كنت ترغب في خلط البيانات قبل كل تكرار. أثناء التدريب، من المهم خلط البيانات حتى لا يتعلم النموذج نمطًا محددًا من مجموعة البيانات. إذا تعلم النموذج تفاصيل النمط الأساسي للبيانات، فسيواجه صعوبة في تعميم التنبؤ على البيانات غير المرئية. يُسمى هذا التجاوز بالتدريب الزائد. يؤدي النموذج أداءً جيدًا على بيانات التدريب، لكنه لا يستطيع التنبؤ بدقة على البيانات غير المرئية.
يُسهّل TensorFlow تنفيذ هاتين الخطوتين. فعندما تنتقل البيانات إلى خط المعالجة، يعرف عدد الملاحظات التي يحتاجها (الدفعة) وما إذا كان عليه إعادة ترتيب البيانات.
لإرشاد TensorFlow حول كيفية تغذية النموذج، يمكنك استخدام pandas_input_fn. يحتاج هذا الكائن إلى خمسة معلمات:
- x: بيانات الميزة
- ذ: تسمية البيانات
- حجم الدفعة: دفعة. افتراضيا 128
- عدد الحقب: عدد الحقب، القيمة الافتراضية هي 1
- خلط: خلط البيانات أو عدم خلطها. القيمة الافتراضية هي "لا شيء".
تحتاج إلى تغذية النموذج عدة مرات، لذا عليك تعريف دالة لتكرار هذه العملية. سمِّ هذه الدالة get_input_fn.
def get_input_fn(data_set, num_epochs=None, n_batch = 128, shuffle=True):
         return tf.estimator.inputs.pandas_input_fn(
         x=pd.DataFrame({k: data_set[k].values for k in FEATURES}),
         y = pd.Series(data_set[LABEL].values),
         batch_size=n_batch,
         num_epochs=num_epochs,
         shuffle=shuffle)
الطريقة المعتادة لتقييم أداء النموذج هي:
- درب النموذج
- قم بتقييم النموذج على مجموعة بيانات مختلفة
- قم بالتنبؤ
يوفر مُقدِّر TensorFlow ثلاث وظائف مختلفة لتنفيذ هذه الخطوات الثلاث بسهولة.
الخطوة 4) درب النموذج
يمكنك استخدام طريقة تدريب المُقدِّر لتدريب النموذج. تتطلب هذه الطريقة دالة إدخال وعددًا من الخطوات. يمكنك استخدام الدالة التي أنشأتها سابقًا لتغذية النموذج. ثم تُوجِّه النموذج للتكرار 1000 مرة. لاحظ أنك لا تُحدِّد عدد الدورات التدريبية؛ بل تترك النموذج يُكرِّر 1000 مرة. إذا حددت عدد الدورات التدريبية بواحدة، فسيُكرِّر النموذج أربع مرات، لأن مجموعة التدريب تحتوي على 400 سجل، وحجم الدفعة 128.
- صفوف 128
- صفوف 128
- صفوف 128
- صفوف 16
لذلك، من الأسهل ضبط عدد الدورات التدريبية على لا شيء وتحديد عدد التكرارات، كما هو موضح في مثال تصنيف TensorFlow أدناه.
estimator.train(input_fn=get_input_fn(training_set,
                                           num_epochs=None,
                                           n_batch = 128,
                                           shuffle=False),
                                           steps=1000)
الناتج
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 238.616
INFO:tensorflow:loss = 13909.657, step = 101 (0.420 sec)
INFO:tensorflow:global_step/sec: 314.293
INFO:tensorflow:loss = 12881.449, step = 201 (0.320 sec)
INFO:tensorflow:global_step/sec: 303.863
INFO:tensorflow:loss = 12391.541, step = 301 (0.327 sec)
INFO:tensorflow:global_step/sec: 308.782
INFO:tensorflow:loss = 12050.5625, step = 401 (0.326 sec)
INFO:tensorflow:global_step/sec: 244.969
INFO:tensorflow:loss = 11766.134, step = 501 (0.407 sec)
INFO:tensorflow:global_step/sec: 155.966
INFO:tensorflow:loss = 11509.922, step = 601 (0.641 sec)
INFO:tensorflow:global_step/sec: 263.256
INFO:tensorflow:loss = 11272.889, step = 701 (0.379 sec)
INFO:tensorflow:global_step/sec: 254.112
INFO:tensorflow:loss = 11051.9795, step = 801 (0.396 sec)
INFO:tensorflow:global_step/sec: 292.405
INFO:tensorflow:loss = 10845.855, step = 901 (0.341 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
يمكنك التحقق من TensorBoard باستخدام الأمر التالي:
activate hello-tf
# For MacOS
tensorboard --logdir=./train
# For Windows
tensorboard --logdir=train
الخطوة 5) تقييم النموذج الخاص بك
يمكنك تقييم ملاءمة النموذج الخاص بك في مجموعة الاختبار باستخدام الكود أدناه:
ev = estimator.evaluate(
          input_fn=get_input_fn(test_set,
          num_epochs=1,
          n_batch = 128,
          shuffle=False))
الناتج
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
يمكنك طباعة الخسارة بالرمز أدناه:
loss_score = ev["loss"]
print("Loss: {0:f}".format(loss_score))
الناتج
Loss: 3215.895996
يبلغ الخطأ في النموذج 3215. يمكنك مراجعة الإحصائيات الموجزة للحصول على فكرة عن حجم الخطأ.
training_set['medv'].describe()
الناتج
count    400.000000
mean      22.625500
std        9.572593
min        5.000000
25%       16.600000
50%       21.400000
75%       25.025000
max       50.000000
Name: medv, dtype: float64
من الإحصائية الموجزة أعلاه، يتضح أن متوسط سعر المنزل هو 22 ألفًا، بحد أدنى 5 آلاف وحد أقصى 50 ألفًا. ولأن الخسارة المُبلغ عنها هي متوسط مربع الخطأ، فإن الخطأ النموذجي بالوحدات الأصلية يُقارب الجذر التربيعي لـ 32.16، أي ما يُعادل 5.7 ألف دولار تقريبًا.
الخطوة 6) قم بالتنبؤ
وأخيرًا، يمكنك استخدام طريقة التنبؤ في TensorFlow لتقدير قيمة ستة منازل في بوسطن.
y = estimator.predict(
         input_fn=get_input_fn(prediction_set,
         num_epochs=1,
         n_batch = 128,
         shuffle=False))
لطباعة القيم المقدرة، يمكنك استخدام هذا الكود:
predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
الناتج
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.96125], dtype=float32), array([27.270979], dtype=float32), array([29.299236], dtype=float32), array([16.436684], dtype=float32), array([21.460876], dtype=float32)]
يتوقع النموذج القيم التالية:
| منزل | تنبؤ |
| 1 | 32.29 |
| 2 | 18.96 |
| 3 | 27.27 |
| 4 | 29.29 |
| 5 | 16.43 |
| 6 | 21.46 |
لاحظ أننا لا نعرف القيمة الحقيقية لهذه المنازل الستة. في درس التعلم العميق، ستحاول التغلب على النموذج الخطي.
حل NumPy
يشرح هذا القسم كيفية تدريب النموذج باستخدام مُقدِّر NumPy لتغذية البيانات. الطريقة هي نفسها، باستثناء أنك ستستخدم مُقدِّر numpy_input_fn.
اقرأ نفس ملفات CSV الثلاثة، ولكن احتفظ فقط بمصفوفات NumPy الخام التي تحتوي على .values.
training_set_n = pd.read_csv("E:/boston_train.csv").values
test_set_n = pd.read_csv("E:/boston_test.csv").values
prediction_set_n = pd.read_csv("E:/boston_predict.csv").values
الخطوة 1) استيراد البيانات
أولاً، عليك التمييز بين متغيرات الميزات والتصنيفات. يجب عليك فعل ذلك لبيانات التدريب وبيانات التقييم. من الأسرع تعريف دالة لتقسيم البيانات.
def prepare_data(df):
        X_train = df[:, :-3]
        y_train = df[:,-3]
        return X_train, y_train
يمكنك استخدام هذه الوظيفة لفصل التصنيف عن ميزات مجموعات بيانات التدريب وتقييمها.
X_train, y_train = prepare_data(training_set_n)
X_test, y_test = prepare_data(test_set_n)
يجب استبعاد العمود الأخير من مجموعة بيانات التنبؤ لأنه يحتوي فقط على NaN.
x_predict = prediction_set_n[:, :-2]
تأكد من شكل المصفوفة. لاحظ أن التسمية يجب ألا تحتوي على بُعد ثانٍ، أي (400,).
print(X_train.shape, y_train.shape, x_predict.shape)
الناتج
(400, 9) (400,) (6, 9)
يمكنك إنشاء أعمدة الميزات على النحو التالي:
feature_columns = [ tf.feature_column.numeric_column('x', shape=X_train.shape[1:])]
يتم تعريف المُقدِّر كما كان من قبل: أنت تحدد أعمدة الميزات ومكان حفظ الرسم البياني.
estimator = tf.estimator.LinearRegressor(
         feature_columns=feature_columns,
         model_dir="train1")
الناتج
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train1', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a218d8f28>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
يمكنك استخدام مُقدِّر NumPy لتغذية البيانات إلى النموذج ثم تدريب النموذج. لاحظ أننا نُعرِّف دالة input_fn مُسبقًا لتسهيل القراءة.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
           x={"x": X_train},
           y=y_train,
           batch_size=128,
           shuffle=False,
           num_epochs=None)
estimator.train(input_fn = train_input,steps=5000)
الناتج
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train1/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 490.057
INFO:tensorflow:loss = 13909.656, step = 101 (0.206 sec)
INFO:tensorflow:global_step/sec: 788.986
INFO:tensorflow:loss = 12881.45, step = 201 (0.126 sec)
INFO:tensorflow:global_step/sec: 736.339
INFO:tensorflow:loss = 12391.541, step = 301 (0.136 sec)
INFO:tensorflow:global_step/sec: 383.305
INFO:tensorflow:loss = 12050.561, step = 401 (0.260 sec)
INFO:tensorflow:global_step/sec: 859.832
INFO:tensorflow:loss = 11766.133, step = 501 (0.117 sec)
INFO:tensorflow:global_step/sec: 804.394
INFO:tensorflow:loss = 11509.918, step = 601 (0.125 sec)
INFO:tensorflow:global_step/sec: 753.059
INFO:tensorflow:loss = 11272.891, step = 701 (0.134 sec)
INFO:tensorflow:global_step/sec: 402.165
INFO:tensorflow:loss = 11051.979, step = 801 (0.248 sec)
INFO:tensorflow:global_step/sec: 344.022
INFO:tensorflow:loss = 10845.854, step = 901 (0.288 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train1/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.985.
Out[23]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x1a1b6ea860>
تقوم بتكرار نفس الخطوة باستخدام دالة إدخال مختلفة لتقييم النموذج الخاص بك.
eval_input = tf.estimator.inputs.numpy_input_fn(
       x={"x": X_test},
       y=y_test,
       shuffle=False,
       batch_size=128,
       num_epochs=1)
   estimator.evaluate(eval_input,steps=None)
الناتج
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.158947, global_step = 1000, loss = 3215.8945
Out[24]:
{'average_loss': 32.158947, 'global_step': 1000, 'loss': 3215.8945}
وأخيرًا، يمكنك حساب التنبؤ. ينبغي أن يكون مشابهًا لنتيجة Pandas.
test_input = tf.estimator.inputs.numpy_input_fn(
        x={"x": x_predict},
        batch_size=128,
        num_epochs=1,
        shuffle=False)
        y = estimator.predict(test_input)

predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
الناتج
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.961248], dtype=float32), array([27.270979], dtype=float32), array([29.299242], dtype=float32), array([16.43668], dtype=float32), array([21.460878], dtype=float32)]
حل TensorFlow
القسم الأخير مخصص لـ TensorFlow الحل. هذه الطريقة أكثر تعقيداً قليلاً من الطريقتين الأخريين.
لاحظ أنه إذا كنت تستخدم Jupyter مفكرة، ستحتاج إلى إعادة التشغيل ومسح النواة لتشغيل هذه الجلسة.
لقد طورت TensorFlow أداة رائعة لتمرير البيانات إلى مسار المعالجة. في هذا القسم، ستقوم بإنشاء دالة input_fn بنفسك.
الخطوة 1) تحديد مسار وتنسيق البيانات
أولاً، قم بتعريف متغيرين يحتويان على مسار ملفات CSV. لاحظ أن لديك ملفين، أحدهما لمجموعة التدريب والآخر لمجموعة الاختبار.
import tensorflow as tf
df_train = "E:/boston_train.csv"
df_eval = "E:/boston_test.csv"
بعد ذلك، عليك تحديد الأعمدة التي ترغب في استخدامها من ملف CSV. سنستخدمها جميعاً. ثم عليك تحديد نوع كل متغير.
يتم تعريف المتغيرات العشرية بواسطة [0.]
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
                "dis", "tax", "ptratio", "medv"]
RECORDS_ALL = [[0.0], [0.0], [0.0], [0.0],[0.0],[0.0],[0.0],[0.0],[0.0],[0.0]]
الخطوة 2) تعريف الدالة input_fn
يمكن تقسيم الوظيفة إلى ثلاثة أجزاء:
- استيراد البيانات
- قم بإنشاء المكرر
- تستهلك البيانات
فيما يلي الكود الكامل لتعريف الدالة. سيتم شرح الكود لاحقاً.
def input_fn(data_file, batch_size, num_epoch = None):
       # Step 1
          def parse_csv(value):
          columns = tf.decode_csv(value, record_defaults= RECORDS_ALL)
          features = dict(zip(COLUMNS, columns))
          #labels = features.pop('median_house_value')
          labels =  features.pop('medv')
          return features, labels

          # Extract lines from input files using the Dataset API.
          dataset = (tf.data.TextLineDataset(data_file) # Read text file
          .skip(1) # Skip header row
          .map(parse_csv))

          dataset = dataset.repeat(num_epoch)
          dataset = dataset.batch(batch_size)
          # Step 3
          iterator = dataset.make_one_shot_iterator()
          features, labels = iterator.get_next()
          return features, labels
استيراد البيانات
بالنسبة لملف CSV، تقرأ دالة dataset سطرًا واحدًا في كل مرة. لإنشاء مجموعة البيانات، تحتاج إلى استخدام الكائن TextLineمجموعة البيانات. تحتوي مجموعة البيانات على رأس، لذا عليك استخدام skip(1) لتجاوز السطر الأول. عند هذه النقطة، تقرأ البيانات فقط وتستبعد الرأس من مسار المعالجة. لتغذية النموذج، عليك فصل الميزات عن التصنيفات. تُستخدم دالة map لتطبيق أي تحويل على البيانات.
تستدعي هذه الطريقة دالةً ستنشئها بنفسك لتحديد كيفية تحويل البيانات. باختصار، عليك تمرير البيانات إلى TextLineكائن مجموعة البيانات، استبعد الرأس، وقم بتطبيق تحويل يتم توجيهه بواسطة دالة.
Code تفسير
- tf.data.TextLineDataset(data_file): يقوم هذا السطر بقراءة ملف CSV
- .skip(1): يتخطى الترويسة
- .map(parse_csv)): يقوم بتحليل السجلات إلى موترات
يجب عليك تعريف دالة لتوجيه كائن الخريطة. يمكنك تسمية هذه الدالة parse_csv.
تقوم هذه الدالة بتحليل ملف CSV باستخدام الدالة tf.decode_csv، وتُعرّف الميزات والتصنيفات. يمكن تعريف الميزات كقاموس أو مجموعة. يُفضّل استخدام القاموس لسهولة استخدامه.
Code تفسير
- tf.decode_csv(value, Record_defaults= RECORDS_ALL): تستخدم الطريقة decode_csv مخرجات TextLineمجموعة البيانات لقراءة ملف CSV. يُعلم record_defaults مكتبة TensorFlow بأنواع الأعمدة. في TensorFlow 2.x، يوجد هذا الرمز في tf.io.decode_csv.
- dict(zip(COLUMNS, columns)): يملأ القاموس بجميع الأعمدة، على سبيل المثالtracتيد أثناء معالجة البيانات هذه
- features.pop('medv'): يستبعد المتغير المستهدف من متغيرات الميزات وينشئ متغيرًا تصنيفيًا.
تحتاج مجموعة البيانات إلى عناصر إضافية لتغذية الموترات بشكل متكرر. في الواقع، عليك إضافة دالة التكرار للسماح لمجموعة البيانات بمواصلة تغذية النموذج إلى ما لا نهاية. إذا لم تُضِف هذه الدالة، فسيتكرر النموذج مرة واحدة فقط ثم يُظهر خطأً لعدم وجود بيانات إضافية تُغذّى إلى مسار المعالجة.
بعد ذلك، يمكنك التحكم في حجم الدفعة باستخدام طريقة الدفعات. وهذا يعني أنك تحدد لمجموعة البيانات مقدار البيانات التي تريد تمريرها إلى مسار المعالجة في كل تكرار. إذا حددت حجم دفعة كبيرًا، فسيكون أداء النموذج بطيئًا.
الخطوة 3) قم بإنشاء المكرر
أنت الآن جاهز للخطوة الثانية: إنشاء مُكرِّر لإرجاع العناصر الموجودة في مجموعة البيانات.
الطريقة الأبسط لإنشاء عامل هي باستخدام طريقة make_one_shot_iterator.
بعد ذلك، يمكنك إنشاء الميزات والتسميات من المكرر.
الخطوة 4) تستهلك البيانات
يمكنك التحقق مما يحدث مع دالة input_fn. تحتاج إلى استدعاء الدالة في جلسة لمعالجة البيانات. جرب استخدام حجم دفعة يساوي 1.
لاحظ أنه يطبع الميزات في قاموس والتسمية كمصفوفة.
سيعرض السطر الأول من ملف CSV. يمكنك تجربة تشغيل هذا الكود عدة مرات بأحجام دفعات مختلفة.
next_batch = input_fn(df_train, batch_size = 1, num_epoch = None)
with tf.Session() as sess:
     first_batch  = sess.run(next_batch)
     print(first_batch)
الناتج
({'crim': array([2.3004], dtype=float32), 'zn': array([0.], dtype=float32), 'indus': array([19.58], dtype=float32), 'nox': array([0.605], dtype=float32), 'rm': array([6.319], dtype=float32), 'age': array([96.1], dtype=float32), 'dis': array([2.1], dtype=float32), 'tax': array([403.], dtype=float32), 'ptratio': array([14.7], dtype=float32)}, array([23.8], dtype=float32))
الخطوة 5) تحديد عمود الميزة
يجب عليك تعريف الأعمدة الرقمية على النحو التالي:
X1= tf.feature_column.numeric_column('crim')
X2= tf.feature_column.numeric_column('zn')
X3= tf.feature_column.numeric_column('indus')
X4= tf.feature_column.numeric_column('nox')
X5= tf.feature_column.numeric_column('rm')
X6= tf.feature_column.numeric_column('age')
X7= tf.feature_column.numeric_column('dis')
X8= tf.feature_column.numeric_column('tax')
X9= tf.feature_column.numeric_column('ptratio')
لاحظ أنه يجب عليك دمج جميع المتغيرات في مجموعة واحدة.
base_columns = [X1, X2, X3,X4, X5, X6,X7, X8, X9]
الخطوة 6) قم ببناء النموذج
يمكنك تدريب النموذج باستخدام المقدر LinearRegressor.
model = tf.estimator.LinearRegressor(feature_columns=base_columns, model_dir='train3')
الناتج
INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_model_dir': 'train3', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1820a010f0>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
يجب عليك استخدام وظيفة لامدا لتمكينك من كتابة وسائط الدالة input_fn. إذا لم تستخدم دالة لامدا، فلن تتمكن من تدريب النموذج.
# Train the estimator
model.train(steps =1000,
          input_fn= lambda : input_fn(df_train,batch_size=128, num_epoch = None))
الناتج
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train3/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 72.5646
INFO:tensorflow:loss = 13909.657, step = 101 (1.380 sec)
INFO:tensorflow:global_step/sec: 101.355
INFO:tensorflow:loss = 12881.449, step = 201 (0.986 sec)
INFO:tensorflow:global_step/sec: 109.293
INFO:tensorflow:loss = 12391.541, step = 301 (0.915 sec)
INFO:tensorflow:global_step/sec: 102.235
INFO:tensorflow:loss = 12050.5625, step = 401 (0.978 sec)
INFO:tensorflow:global_step/sec: 104.656
INFO:tensorflow:loss = 11766.134, step = 501 (0.956 sec)
INFO:tensorflow:global_step/sec: 106.697
INFO:tensorflow:loss = 11509.922, step = 601 (0.938 sec)
INFO:tensorflow:global_step/sec: 118.454
INFO:tensorflow:loss = 11272.889, step = 701 (0.844 sec)
INFO:tensorflow:global_step/sec: 114.947
INFO:tensorflow:loss = 11051.9795, step = 801 (0.870 sec)
INFO:tensorflow:global_step/sec: 111.484
INFO:tensorflow:loss = 10845.855, step = 901 (0.897 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train3/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Out[8]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x18225eb8d0>
يمكنك تقييم ملاءمة النموذج الخاص بك في مجموعة الاختبار باستخدام الكود أدناه:
results = model.evaluate(steps =None,input_fn=lambda: input_fn(df_eval, batch_size =128, num_epoch = 1))
for key in results:
print("   {}, was: {}".format(key, results[key]))
الناتج
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
   average_loss, was: 32.158958435058594
   loss, was: 3215.89599609375
   global_step, was: 1000
الخطوة الأخيرة هي التنبؤ بقيمة الهدف بناءً على قيمة مصفوفة الميزات. يمكنك كتابة قاموس بالقيم التي تريد التنبؤ بها. يحتوي نموذجك على تسع ميزات، لذا عليك تحديد قيمة لكل منها. سيقدم النموذج تنبؤًا لكل منها.
في الكود أدناه، تقوم بكتابة قيم كل ميزة موجودة في ملف df_predict CSV.
يجب عليك كتابة دالة input_fn جديدة لأنه لا يوجد تصنيف في مجموعة البيانات. يمكنك استخدام واجهة برمجة التطبيقات from_tensors من كائن مجموعة البيانات.
prediction_input = {
          'crim': [0.03359,5.09017,0.12650,0.05515,8.15174,0.24522],
          'zn': [75.0,0.0,25.0,33.0,0.0,0.0],
          'indus': [2.95,18.10,5.13,2.18,18.10,9.90],
          'nox': [0.428,0.713,0.453,0.472,0.700,0.544],
          'rm': [7.024,6.297,6.762,7.236,5.390,5.782],
          'age': [15.8,91.8,43.4,41.1,98.9,71.7],
          'dis': [5.4011,2.3682,7.9809,4.0220,1.7281,4.0317],
          'tax': [252,666,284,222,666,304],
          'ptratio': [18.3,20.2,19.7,18.4,20.2,18.4]
     }
     def test_input_fn():
     dataset = tf.data.Dataset.from_tensors(prediction_input)
     return dataset

     # Predict all our prediction_input
     pred_results = model.predict(input_fn=test_input_fn)
وأخيراً، تقوم بطباعة التوقعات.
for pred in enumerate(pred_results):
print(pred)
الناتج
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
(0, {'predictions': array([32.297546], dtype=float32)})
(1, {'predictions': array([18.96125], dtype=float32)})
(2, {'predictions': array([27.270979], dtype=float32)})
(3, {'predictions': array([29.299236], dtype=float32)})
(4, {'predictions': array([16.436684], dtype=float32)})
(5, {'predictions': array([21.460876], dtype=float32)})

INFO:tensorflow:Calling model_fn. INFO:tensorflow:Done calling model_fn. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from train3/model.ckpt-5000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. (0, {'predictions': array([35.60663], dtype=float32)}) (1, {'predictions': array([22.298521], dtype=float32)}) (2, {'predictions': array([25.74533], dtype=float32)}) (3, {'predictions': array([35.126694], dtype=float32)}) (4, {'predictions': array([17.94416], dtype=float32)}) (5, {'predictions': array([22.606628], dtype=float32)})
جميع خطوط المعالجة الثلاثة تُرجع نفس التنبؤات الستة، مما يؤكد أن الاختيار بين Pandas و NumPy ومجموعة بيانات TensorFlow الأصلية هو مسألة ملاءمة، وليس مسألة دقة.
