
برنامج تعليمي حول dplyr في لغة R: دمج البيانات وربطها مع أمثلة
 فريق التحرير
⚡ ملخص ذكي
تقوم حزمة dplyr بدمج وربط إطارات البيانات في لغة R باستخدام أربعة أفعال: left_join() و right_join() و inner_join() و full_join(). ثم تقوم حزمة tidyr المرافقة لها بإعادة تشكيل النتيجة المدمجة باستخدام gather() و spread() و separate() و unite().
مقدمة في تحليل البيانات
قبل أي انضمام أو إعادة مشاركةping الفعل منطقي، فهو يساعد على فهم مكانة معالجة البيانات. تحليل البيانات يمكن تقسيمها إلى ثلاثة أجزاء:
- Extracالإنتاج: أولا، نحتاج إلى جمع البيانات من عدة مصادر ودمجها.
- تحول: تتضمن هذه الخطوة معالجة البيانات. بمجرد دمج جميع مصادر البيانات، يمكننا البدء في تنظيف البيانات.
- تصور: الخطوة الأخيرة هي تصور بياناتنا للتحقق من عدم انتظامها.
يوضح الرسم البياني أدناه كيفية ترابط المراحل الثلاث.
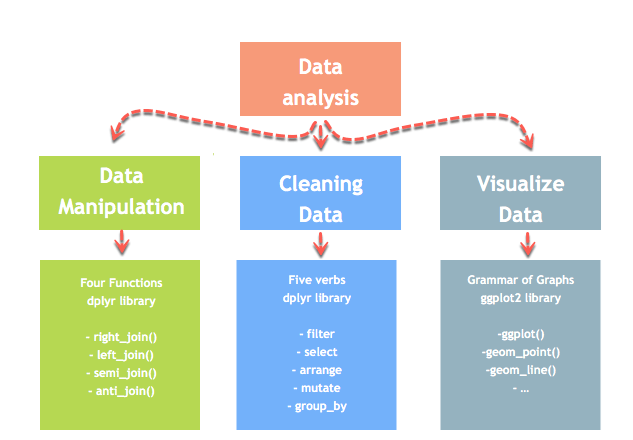
يُعدّ التعامل مع البيانات أحد أبرز التحديات التي تواجه علماء البيانات، إذ لا تتوفر البيانات عادةً بالصيغة المطلوبة. لذا، يضطر علماء البيانات إلى تخصيص نصف وقتهم على الأقل لتنظيف البيانات ومعالجتها، وهو ما يُعتبر من أهم مهامهم. فإذا لم تكن عملية معالجة البيانات كاملة ودقيقة ومنضبطة، فلن يعمل النموذج بالشكل المطلوب.
R dplyr
تحتوي لغة البرمجة R على حزمة تُسمى dplyr تُعنى بتحويل البيانات. وهي مبنية على مجموعة صغيرة من الدوال الأساسية - filter() و select() و arrange() و mutate() و summarise() - بالإضافة إلى مجموعة من دوال الربط. وبمجرد أن تصبح البيانات جاهزة، يُمكن لـ ggplot2 عرضها بيانيًا.
سنتعلم كيفية استخدام حزمة dplyr لمعالجة إطار البياناتإذا لم يكن برنامج R مثبتًا بعد، فاتبع التعليمات التالية خطوات إعداد R و RStudioثم قم بتشغيل install.packages(“dplyr”).
دمج البيانات باستخدام dplyr
يوفر dplyr طريقة لطيفة ومريحة لدمج مجموعات البيانات. قد يكون لدينا العديد من مصادر البيانات المدخلة، وفي مرحلة ما، نحتاج إلى دمجها. يؤدي الانضمام إلى dplyr إلى إضافة متغيرات إلى يمين مجموعة البيانات الأصلية.
ينضم dplyr
فيما يلي أربعة أنواع مهمة من عمليات الربط المستخدمة في مكتبة dplyr لدمج مجموعتي بيانات. جميعها تأخذ نفس الوسائط - الجدولين والمفتاح - وتختلف فقط في الصفوف غير المتطابقة التي تبقى:
| الوظيفة | الهدف | الحجج | مفاتيح متعددة |
|---|---|---|---|
| left_join() | دمج مجموعتين من البيانات. احتفظ بجميع الملاحظات من الجدول الأصلي | x، y، by = "ID" | x, y, by = c(“ID”, “ID2”) |
| right_join() | دمج مجموعتين من البيانات. احتفظ بجميع الملاحظات من الجدول الوجهة | x، y، by = "ID" | x, y, by = c(“ID”, “ID2”) |
| صلة داخلية() | دمج مجموعتي بيانات. استبعاد جميع الصفوف غير المتطابقة | x، y، by = "ID" | x, y, by = c(“ID”, “ID2”) |
| كامل_الانضمام () | ادمج مجموعتي البيانات. احتفظ بجميع المشاهدات | x، y، by = "ID" | x, y, by = c(“ID”, “ID2”) |
تُطابق هذه الأفعال الأربعة وصلات LEFT و RIGHT و INNER و FULL OUTER لـ SQL. تصل لغة R الأساسية إلى نفس النتائج من خلال الوسائط all و all.x و all.y دمج().
سندرس جميع أنواع الربط من خلال مثال بسيط.
أولاً، نقوم بإنشاء مجموعتي بيانات. يحتوي الجدول 1 على متغيرين، ID و y، بينما يجمع الجدول 2 المتغيرين ID و z. في كل حالة، نحتاج إلى زوج المفتاح عامل. في حالتنا، الهوية هي ملكنا مفتاح متغير. ستبحث الدالة عن القيم المتطابقة في كلا الجدولين وتربط القيم المُعادة إلى يمين الجدول 1. يوضح الشكل أدناه الجدولين جنبًا إلى جنب.

library(dplyr)
df_primary <- tribble(
  ~ID, ~y,
   "A", 5,
   "B", 5,
   "C", 8,
   "D", 0,
  "F", 9)
df_secondary <- tribble(
  ~ID, ~z,
   "A", 30,
   "B", 21,
   "C", 22,
   "D", 25,
   "E", 29)
dplyr left_join()
الطريقة الأكثر شيوعًا لدمج مجموعتي بيانات هي استخدام دالة left_join(). يوضح الشكل أدناه أن زوج المفاتيح يطابق الصفوف A وB وC وD، بينما يبقى الصفان E وF. باستخدام left_join()، نحتفظ بجميع الصفوف في الجدول الأصلي ونتجاهل الصفوف التي لا يوجد لها زوج مفاتيح في جدول الوجهة. في مثالنا، القيمة E غير موجودة في الجدول 1، لذلك تم حذف هذا الصف. أما القيمة F فهي من الجدول الأصلي، لذا يتم الاحتفاظ بها بعد دالة left_join() وتُرجع قيمة NA في العمود z.
مثال على dplyr left_join()
يوضح الرسم البياني أدناه ما يحدث أثناء عملية الربط الأيسر (left_join()).

left_join(df_primary, df_secondary, by ='ID')
الإخراج:
##
# A tibble: 5 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
## 5     F     9    NA
لاحظ أنه عندما يحتوي كلا الجدولين على عمود بنفس الاسم، فإن dplyr يقوم بتمييزهما باستخدام اللاحقتين .x و .y الموضحتين أعلاه.
dplyr right_join()
تعمل الدالة right_join() تمامًا مثل left_join(). والفرق الوحيد هو إسقاط الصف. القيمة E، المتوفرة في إطار البيانات الوجهة، موجودة في الجدول الجديد وتأخذ القيمة NA للعمود y.
مثال على dplyr right_join()
يوضح الرسم البياني أدناه الصورة المعكوسة.

right_join(df_primary, df_secondary, by = 'ID')
الإخراج:
##
# A tibble: 5 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
## 5     E    NA    29
dplyr inner_join()
عندما تصبح الملاحظات غير المتطابقة عديمة الفائدة تمامًا، يمكننا العودة فقط الصفوف الموجودة في على حد سواء مجموعات البيانات. هذا هو الخيار الصحيح عندما نحتاج إلى مجموعة بيانات كاملة ولا نريد استكمال القيم المفقودة بالمتوسط أو الوسيط.
تأتي وظيفة inner_join() لتساعد هنا. فهي تستبعد الصفوف غير المتطابقة على كلا الجانبين.
مثال على dplyr inside_join()
يوضح الرسم البياني أدناه المعرفات الأربعة التي تبقى بعد عملية الربط.

inner_join(df_primary, df_secondary, by ='ID')
الإخراج:
##
# A tibble: 4 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
dplyr full_join()
وأخيرًا، تحتفظ الدالة full_join() بجميع الملاحظات وتستبدل القيم المفقودة بـ NA.
مثال على dplyr full_join()
يوضح الرسم البياني أدناه كل معرف من كلا الجدولين الذي بقي بعد عملية الربط.

full_join(df_primary, df_secondary, by = 'ID')
الإخراج:
## # A tibble: 6 x 3
##      ID   y.x   y.y
##   <chr> <dbl> <dbl>
## 1     A     5    30
## 2     B     5    21
## 3     C     8    22
## 4     D     0    25
## 5     F     9    NA
## 6     E    NA    29
أزواج مفاتيح متعددة
وأخيرًا وليس آخرًا، يمكننا استخدام عدة مفاتيح في مجموعة البيانات. لنفترض مجموعة البيانات التالية التي تحتوي على السنوات وقائمة بالمنتجات التي اشتراها العميل. تُظهر لقطة الشاشة أدناه الجدولين وعمودي المعرّف والسنة اللذين يُحددان معًا صفًا.
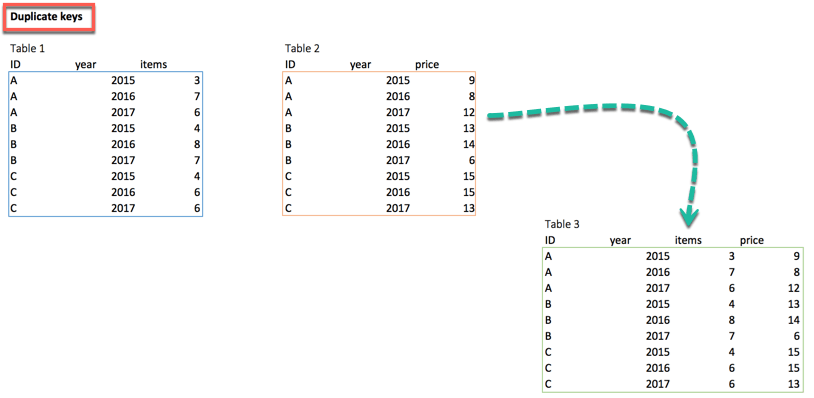
إذا قمنا بربط الجدولين باستخدام المعرّف فقط، فسيتم مطابقة كل سنة مع كل سنة أخرى، مما يؤدي إلى زيادة عدد الصفوف بشكل كبير. ولحل هذه المشكلة، يمكننا استخدام متغيرين مكونين من زوج مفتاح، وهما المعرّف والسنة، واللذان يظهران في كلا مجموعتي البيانات. يمكننا استخدام الكود التالي لدمج الجدول 1 والجدول 2:
df_primary <- tribble(
  ~ID, ~year, ~items,
  "A", 2015,3,
  "A", 2016,7,
  "A", 2017,6,
  "B", 2015,4,
  "B", 2016,8,
  "B", 2017,7,
  "C", 2015,4,
  "C", 2016,6,
  "C", 2017,6)
df_secondary <- tribble(
  ~ID, ~year, ~prices,
  "A", 2015,9,
  "A", 2016,8,
  "A", 2017,12,
  "B", 2015,13,
  "B", 2016,14,
  "B", 2017,6,
  "C", 2015,15,
  "C", 2016,15,
  "C", 2017,13)
left_join(df_primary, df_secondary, by = c('ID', 'year'))
الإخراج:
## # A tibble: 9 x 4
##      ID  year items prices
##   <chr> <dbl> <dbl>  <dbl>
## 1     A  2015     3      9
## 2     A  2016     7      8
## 3     A  2017     6     12
## 4     B  2015     4     13
## 5     B  2016     8     14
## 6     B  2017     7      6
## 7     C  2015     4     15
## 8     C  2016     6     15
## 9     C  2017     6     13
منذ إصدار dplyr 1.1.0 (يناير 2023)، أصبح بالإمكان كتابة المفتاح نفسه على النحو التالي: join_by(ID, year)، ويُصدر dplyr الآن تحذيرات بشأن التطابقات غير المتوقعة من نوع "متعدد إلى متعدد"، حيث إعلان انضمام dplyr 1.1.0 يفسر.
وظائف تنظيف البيانات في R
لا يحلّ دمج الجداول سوى نصف المشكلة، إذ لا يزال يتعين إعادة تشكيل الجدول المدمج. فيما يلي أربع وظائف مهمة لترتيب (تنظيف) البيانات:
| الوظيفة | الهدف | الحجج |
|---|---|---|
| يجتمع() | تحويل البيانات من واسعة إلى طويلة | (البيانات، المفتاح، القيمة، na.rm = FALSE) |
| الانتشار() | تحويل البيانات من طويلة إلى واسعة | (البيانات، المفتاح، القيمة) |
| متفرق() | قسّم متغيرًا واحدًا إلى متغيرين | (data, col, into, sep = “”, remove = TRUE) |
| توحد() | دمج متغيرين في متغير واحد | (data, col, conc, sep = “”, remove = TRUE) |
ملاحظة حول الإصدار: تم استبدال الدالتين gather() و spread() بالدالتين pivot_longer() و pivot_wider() في tidyr 1.0.0، وتم استبدال الدالة separate() بمجموعة الدوال separate_wider_delim() في tidyr 1.3.0. لا تزال الدوال المستبدلة تعمل، لذا فإن جميع الأمثلة أدناه تعمل، ولكن يُفضل استخدام مجموعات الدوال الأحدث الموضحة في الكود الجديد. مشهد متحرك مرتبيبقى .unite() ساريًا.
نستخدم حزمة tidyr، وهي جزء من مجموعة tidyverse، لمعالجة البيانات وتنظيفها وعرضها بصريًا. إذا تم تثبيت R باستخدام Anaconda، فإن الحزمة متوفرة بالفعل من https://anaconda.org/r/r-tidyr.
إذا لم يتم تثبيته بالفعل، أدخل الأمر التالي لتثبيت tidyr:
install.packages("tidyr")
يجتمع()
الهدف من دالة gather() هو تحويل البيانات من عريضة إلى طويلة.
بناء الجملة
gather(data, key, value, na.rm = FALSE)
Arguments:
-data: The data frame used to reshape the dataset
-key: Name of the new column created
-value: Select the columns used to fill the key column
-na.rm: Remove missing values. FALSE by default
مثال
فيما يلي، يمكننا تصور مفهوم إعادة التدويرping من الجدول العريض إلى الجدول الطويل. نريد إنشاء عمود واحد باسم "النمو"، مملوء بصفوف متغيرات الربع. يوضح الشكل أدناه الجدول العريض على اليسار والجدول الطويل بعد إعادة تشكيله على اليمين.

library(tidyr)
# Create a messy dataset
messy <- data.frame(
  country = c("A", "B", "C"),
  q1_2017 = c(0.03, 0.05, 0.01),
  q2_2017 = c(0.05, 0.07, 0.02),
  q3_2017 = c(0.04, 0.05, 0.01),
  q4_2017 = c(0.03, 0.02, 0.04))
messy
الإخراج:
##   country q1_2017 q2_2017 q3_2017 q4_2017
## 1       A    0.03    0.05    0.04    0.03
## 2       B    0.05    0.07    0.05    0.02
## 3       C    0.01    0.02    0.01    0.04
# Reshape the data
tidier <-messy %>%
gather(quarter, growth, q1_2017:q4_2017)
tidier
الإخراج:
##    country quarter growth
## 1        A q1_2017   0.03
## 2        B q1_2017   0.05
## 3        C q1_2017   0.01
## 4        A q2_2017   0.05
## 5        B q2_2017   0.07
## 6        C q2_2017   0.02
## 7        A q3_2017   0.04
## 8        B q3_2017   0.05
## 9        C q3_2017   0.01
## 10       A q4_2017   0.03
## 11       B q4_2017   0.02
## 12       C q4_2017   0.04
في دالة gather()، نُنشئ متغيرين جديدين، quarter و growth، لأن مجموعة البيانات الأصلية لدينا تحتوي على متغير مجموعة واحد، country، وأزواج المفتاح والقيمة. في tidyr 1.0.0 والإصدارات الأحدث، تُكتب عملية إعادة التشكيل نفسها على النحو التالي: pivot_longer(messy, cols = q1_2017:q4_2017, names_to = “quarter”, values_to = “growth”).
الانتشار()
تقوم الدالة spread() بعكس وظيفة gather().
بناء الجملة
spread(data, key, value)
arguments:
data: The data frame used to reshape the dataset
key: Column to reshape long to wide
value: Rows used to fill the new column
مثال
يمكننا إعادة تشكيل مجموعة البيانات الأكثر تنظيماً إلى مجموعة البيانات الفوضوية باستخدام الدالة spread().
# Reshape the data
messy_1 <- tidier %>%
  spread(quarter, growth)
messy_1
الإخراج:
##   country q1_2017 q2_2017 q3_2017 q4_2017
## 1       A    0.03    0.05    0.04    0.03
## 2       B    0.05    0.07    0.05    0.02
## 3       C    0.01    0.02    0.01    0.04
المكافئ الحديث هو pivot_wider(tidier, names_from = quarter, values_from = growth).
متفرق()
تقوم الدالة `separate()` بتقسيم العمود إلى عمودين باستخدام فاصل. تُفيد هذه الدالة في الحالات التي يكون فيها المتغير تاريخًا. قد يتطلب تحليلنا التركيز على الشهر والسنة، ونرغب في فصل العمود إلى متغيرين جديدين.
بناء الجملة
separate(data, col, into, sep= "", remove = TRUE)
arguments:
-data: The data frame used to reshape the dataset
-col: The column to split
-into: The name of the new variables
-sep: Indicates the symbol used that separates the variable, i.e.:  "-", "_", "&"
-remove: Remove the old column. By default sets to TRUE.
مثال
يمكننا فصل الربع عن العام في مجموعة البيانات الأكثر ترتيبًا عن طريق تطبيق الدالة المنفصلة ().
separate_tidier <-tidier %>%
separate(quarter, c("Qrt", "year"), sep ="_")
head(separate_tidier)
الإخراج:
##   country Qrt year growth
## 1       A  q1 2017   0.03
## 2       B  q1 2017   0.05
## 3       C  q1 2017   0.01
## 4       A  q2 2017   0.05
## 5       B  q2 2017   0.07
## 6       C  q2 2017   0.02
توحد()
تقوم الدالة unite() بدمج عمودين في عمود واحد.
بناء الجملة
unite(data, col, conc ,sep= "", remove = TRUE)
arguments:
-data: The data frame used to reshape the dataset
-col: Name of the new column
-conc: Name of the columns to concatenate
-sep: Indicates the symbol used that unites the variable, i.e:  "-", "_", "&"
-remove: Remove the old columns. By default, sets to TRUE
مثال
في المثال أعلاه، فصلنا الربع عن السنة. ماذا لو أردنا دمجهما؟ نستخدم الكود التالي:
unit_tidier <- separate_tidier %>%
  unite(Quarter, Qrt, year, sep ="_")
head(unit_tidier)
الإخراج:
##   country Quarter growth
## 1       A q1_2017   0.03
## 2       B q1_2017   0.05
## 3       C q1_2017   0.01
## 4       A q2_2017   0.05
## 5       B q2_2017   0.07
## 6       C q2_2017   0.02
أصبح إطار البيانات المعاد تشكيله جاهزًا الآن لخطوات النمذجة التي سيتم تناولها في بقية القسم. سلسلة دروس R.
