
إطار بيانات R: كيفية إنشاء وإلحاق واختيار ومجموعة فرعية
 فريق التحرير
⚡ ملخص ذكي
يخزن إطار البيانات في لغة R أعمدة من أنواع مختلفة بأطوال متساوية، مما يجعله البنية المستطيلة القياسية للتحليل. تُستخدم الأقواس المربعة لتقسيم الصفوف والأعمدة، بينما يُستخدم رمز الدولار للوصول إلى عمود معين، وتُستخدم دالة subset() للتصفية حسب شرط محدد.
ما هو إطار البيانات؟
A إطار البيانات هي قائمة من المتجهات ذات الطول المتساوي. تحتوي المصفوفة على نوع واحد فقط من البيانات، بينما يقبل إطار البيانات أنواعًا مختلفة من البيانات (رقمية، حرفية، عاملية، إلخ).
يضع هذا التعريف إطار البيانات بين جارين ستصادفهما باستمرار في لغة R. البخور مستطيل الشكل ولكنه أحادي النوع، و الإدارية هو متعدد الأنواع ولكنه غير منتظم. يستعير إطار البيانات خاصية واحدة من كل نوع.
| الهيكلية | أنواع الأعمدة | أطوال العناصر | الاستخدام النموذجي |
|---|---|---|---|
| ناقلات | نوع واحد فقط | تسلسل واحد | متغير واحد |
| مصفوفة | نوع واحد فقط | مستطيل | الجبر العددي |
| قائمة | أي مزيج من الأنواع | قد يختلف ذلك باختلاف العنصر | مجموعات عشوائية |
| إطار البيانات | أي مزيج من الأنواع | كل عمود متساوي الطول | التحليل الجدولي |
لأن إطار البيانات هو في الواقع قائمة في الأساس، فإن أدوات الوصول المستخدمة في القوائم تعمل هنا أيضًا، وهذا هو سبب ظهور علامة الدولار مرة أخرى لاحقًا في هذا البرنامج التعليمي.
كيفية إنشاء إطار البيانات
يمكننا إنشاء إطار بيانات فيه R عن طريق تمرير المتغيرات a و b و c و d إلى دالة data.frame()، يمكننا إنشاء إطار البيانات وتسمية الأعمدة باستخدام names()، وذلك ببساطة عن طريق تحديد اسم كل متغير.
data.frame(df, stringsAsFactors = TRUE)
الحجج:
- df: يمكن أن تكون مصفوفة للتحويل كإطار بيانات أو مجموعة من المتغيرات للانضمام
- stringsAsFactorsيتحكم هذا الخيار فيما إذا كانت متجهات الأحرف ستتحول إلى أعمدة عوامل. القيمة الافتراضية هي TRUE في الإصدارات القديمة، وأصبحت FALSE منذ الإصدار R 4.0.0، لذا مررها صراحةً عندما يكون السلوك مهمًا.
يمكننا إنشاء إطار بيانات في R لمجموعة البيانات الأولى لدينا من خلال الجمع بين أربعة متغيرات بنفس الطول.
# Create a, b, c, d variables
a <- c(10,20,30,40)
b <- c('book', 'pen', 'textbook', 'pencil_case')
c <- c(TRUE,FALSE,TRUE,FALSE)
d <- c(2.5, 8, 10, 7)
# Join the variables to create a data frame
df <- data.frame(a,b,c,d)
df
الإخراج:
##     a         b     c     d
## 1  10        book  TRUE   2.5
## 2  20         pen  FALSE  8.0
## 3  30    textbook  TRUE   10.0
## 4  40 pencil_case  FALSE  7.0
أصبح كل متجه عمودًا، وأصبحت القيم الأربع في كل متجه الصفوف الأربعة. لاحظ أن الوسائط لم تكن مُسماة، لذا استنتجت لغة R عناوين الأعمدة من أسماء المتغيرات نفسها.
يمكننا أن نرى أن رؤوس الأعمدة لها نفس اسم المتغيرات. يمكننا تغيير اسم العمود في R باستخدام أسماء الوظائف (). تحقق من مثال R لإنشاء إطار بيانات أدناه:
# Name the data frame
names(df) <- c('ID', 'items', 'store', 'price')
df
الإخراج:
##   ID       items store price
## 1 10        book  TRUE   2.5
## 2 20         pen FALSE   8.0
## 3 30    textbook  TRUE  10.0
## 4 40 pencil_case FALSE   7.0
يؤدي تعيين قيمة للدالة names() إلى استبدال جميع عناوين الأعمدة دفعة واحدة، لذا يجب أن يحتوي متجه الاستبدال على عنصر واحد فقط لكل عمود. لإعادة تسمية عمود واحد فقط، استخدم فهرس متجه names، كما في names(df)[2] <- 'product'.
# Print the structure
str(df)
الإخراج:
## 'data.frame':    4 obs. of  4 variables:
##  $ ID   : num  10 20 30 40
##  $ items: Factor w/ 4 levels "book","pen","pencil_case",..: 1 2 4 3
##  $ store: logi  TRUE FALSE TRUE FALSE
##  $ price: num  2.5 8 10 7
ملاحظة حول الإصدار. تم إنتاج المخرجات أعلاه باستخدام إصدار من لغة R أقدم من 4.0.0، حيث كانت دالة data.frame() تحوّل متجهات الأحرف إلى عوامل افتراضيًا، ولهذا السبب تم الإبلاغ عن items كعامل بأربعة مستويات. تشير وثائق R الأساسية إلى أن هذا الإعداد الافتراضي هو الإعداد الافتراضي الجديد. تم تغيير قيمة stringsAsFactors إلى FALSE في R 4.0.0عند تشغيل نفس الكود على إصدار حالي، تظهر العناصر كعمود نصي عادي، بينما تطبع الدالة str() النص chr بدلاً من ذلك. أضف stringsAsFactors = TRUE إلى استدعاء data.frame() لإعادة إنتاج المخرجات المطبوعة، أو اقرأ شرح العوامل وذلك عندما تكون العوامل مطلوبة بالفعل.
شريحة إطار البيانات
بعد بناء الإطار، تتمثل المهمة التالية في سحب أجزاء منه للخارج. التقطيع هو الطريقة الأساسية في لغة R للقيام بذلك، ويستخدم نفس الأقواس المربعة المستخدمة في المتجهات، ولكن بموضعين بدلاً من موضع واحد.
من الممكن تقسيم قيم إطار البيانات. نختار الصفوف والأعمدة المراد إرجاعها داخل أقواس مسبوقة باسم إطار البيانات.
يتكون إطار البيانات من صفوف وأعمدة، df[A, B]. يمثل A الصفوف و B يمثل الأعمدة. يمكننا التقطيع إما عن طريق تحديد الصفوف و/أو الأعمدة.
من الصورة رقم 1 أدناه، يمثل الجزء الأيسر صفوف والجزء الأيمن هو الأعمدة. لاحظ أن الرمز: يعني إلى. على سبيل المثال، 1:3 يهدف إلى تحديد القيم من 1 إلى 3.

يوضح الرسم البياني أدناه كيفية الوصول إلى اختيارات مختلفة من إطار البيانات:
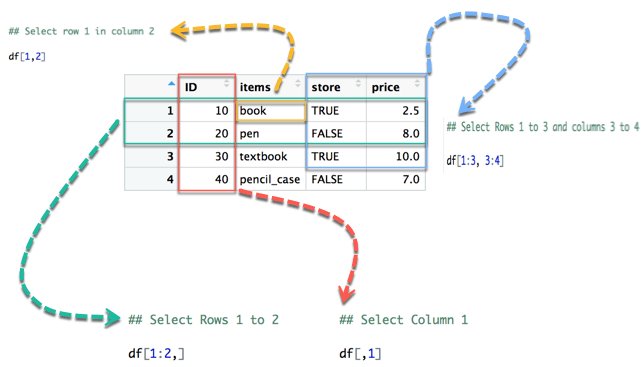
- السهم الأصفر يختار صف 1 في عمود 2
- السهم الأخضر يختار الصفوف 1 إلى 2
- السهم الأحمر يختار عمود 1
- السهم الأزرق يختار الصفوف 1 إلى 3 و الأعمدة 3 إلى 4
لاحظ أنه إذا تركنا الجزء الأيسر فارغًا، فسيقوم R بالاختيار كل الصفوف. وقياسًا على ذلك، إذا تركنا الجزء الأيمن فارغًا، فسيقوم R بالاختيار كل الأعمدة.
يمكننا تشغيل الكود في وحدة التحكم:
## Select row 1 in column 2
df[1,2]
الإخراج:
## [1] book
## Levels: book pen pencil_case textbook
يظهر سطر "المستويات" لأن "العناصر" عاملٌ في هذه الجلسة. في الإصدار R 4.0.0 والإصدارات الأحدث، تطبع نفس الاستدعاءات السلسلة النصية "book" فقط دون سطر "المستويات".
## Select Rows 1 to 2
df[1:2,]
الإخراج:
##   ID items store price
## 1 10  book  TRUE   2.5
## 2 20   pen FALSE   8.0
## Select Columns 1
df[,1]
الإخراج:
## [1] 10 20 30 40
يؤدي تحديد عمود واحد باستخدام df[,1] إلى حذف غلاف الإطار وإرجاع متجه عادي. أضف drop = FALSE، كما في df[, 1, drop = FALSE]، عندما تكون هناك حاجة إلى إطار بيانات بعمود واحد.
## Select Rows 1 to 3 and columns 3 to 4
df[1:3, 3:4]
الإخراج:
##   store price
## 1  TRUE   2.5
## 2 FALSE   8.0
## 3  TRUE  10.0
من الممكن أيضًا تحديد الأعمدة بأسمائها. على سبيل المثال، الكود أدناه extracعمودان: المعرف والمتجر.
# Slice with columns name
df[, c('ID', 'store')]
الإخراج:
##   ID store
## 1 10  TRUE
## 2 20 FALSE
## 3 30  TRUE
## 4 40 FALSE
تعتبر الأسماء أكثر أمانًا من المواضع في كود الإنتاج، لأن إدراج عمود أو إعادة ترتيبه يغير بصمت ما يشير إليه df[, 3] بينما يستمر df[, 'store'] في الإشارة إلى نفس البيانات.
إلحاق عمود بإطار البيانات
يمكنك أيضًا إضافة عمود إلى إطار البيانات. ستحتاج إلى استخدام الرمز $ لتسمية المتغير الجديد وإضافة عمود إلى إطار البيانات في لغة R.
# Create a new vector
quantity <- c(10, 35, 40, 5)

# Add `quantity` to the `df` data frame
df$quantity <- quantity
df
الإخراج:
##   ID       items store price quantity
## 1 10        book  TRUE   2.5       10
## 2 20         pen FALSE   8.0       35
## 3 30    textbook  TRUE  10.0       40
## 4 40 pencil_case FALSE   7.0        5
ملاحظة: يجب أن يكون عدد العناصر في المتجه مساويًا لعدد العناصر في إطار البيانات. لإضافة عمود إلى إطار البيانات في لغة R، نفّذ العبارة التالية.
quantity <- c(10, 35, 40)
# Add `quantity` to the `df` data frame
df$quantity <- quantity
يعطي خطأ:
Error in `lt;-.data.frame`(`*tmp*`, quantity, value = c(10, 35, 40))
replacement has 3 rows, data has 4
تُحدد الرسالة مُعامل الاستبدال لإطارات البيانات وتُوضح كلا العددين، مما يُشير إلى ما يجب إصلاحه بدقة. لا يُعيد R استخدام الاستبدال إلا إذا كان طوله يُقسم عدد الصفوف بالتساوي، ولهذا السبب يتم قبول قيمة طولها 1 مثل df$currency <- 'EUR' بينما يتم رفض متجه طوله 3 مقابل أربعة صفوف. تُضيف الدالة cbind() عمودًا بنفس الطريقة، بينما تُعد الدالة rbind() مُقابلها لإضافة صفوف.
حدد عمودًا لإطار البيانات
أحيانًا، نحتاج إلى تخزين عمود من إطار بيانات لاستخدامه لاحقًا أو إجراء عملية عليه. يمكننا استخدام علامة الدولار ($) لتحديد العمود من إطار البيانات.
# Select the column ID
df$ID
الإخراج:
## [1] 1 2 3 4
اقرأ هذا الناتج بعناية. تم إنشاء المعرّف من المتجه c(10, 20, 30, 40)، لذا فإن وحدة التحكم المباشرة تطبع 10 20 30 40 هنا؛ الأرقام 1 2 3 4 الموضحة أعلاه هي مواقع الصفوف وليست القيم المخزنة. [1] في بداية السطر هو ببساطة فهرس العنصر الأول في ذلك السطر، وليس جزءًا من البيانات.
تصل ثلاثة مسارات إلى نفس العمود: df$ID و df[['ID']] و df[, 'ID']. تُجري علامة الدولار مطابقة جزئية، لذا سيظل df$I يعثر على ID، وهو أمر مناسب في سطر الأوامر ولكنه محفوف بالمخاطر في نص برمجي محفوظ.
مجموعة فرعية من إطار البيانات
في القسم السابق، اخترنا عمودًا كاملاً بدون شرط. من الممكن فرعية بناءً على ما إذا كان شرط معين صحيحًا أم لا.
نحن نستخدم وظيفة المجموعة الفرعية ().
subset(x, condition)
arguments:
- x: data frame used to perform the subset
- condition: define the conditional statement
نريد إرجاع المنتجات التي يزيد سعرها عن 5 فقط، لذلك يمكننا القيام بما يلي:
# Select price above 5
subset(df, subset = price > 5)
الإخراج:
ID       items store price
2 20         pen FALSE     8
3 30    textbook  TRUE    10
4 40 pencil_case FALSE     7
تمثل تسميات الصفوف 2 و3 و4 أسماء الصفوف الأصلية المنقولة من df، وهذا ما يُشير إلى أنه تم استبعاد الصف الأول. تقبل الدالة subset() أيضًا وسيطة select لاختيار الأعمدة في الوقت نفسه، والصيغة المكافئة لها بين قوسين هي df[df$price > 5, ]. تحتفظ الصيغة بين قوسين بالصفوف التي تحتوي على NA حيث لا يتحقق الشرط، بينما تحذفها الدالة subset()، لذا لا يمكن استخدام الصيغتين بشكل تبادلي دائمًا.
