
اختبار T في لغة البرمجة R: مثال واحد ومثال مزدوج
 فريق التحرير
⚡ ملخص ذكي
يقارن اختبار T في لغة R المتوسطات باستخدام الدالة t.test()، ويغطي عينة واحدة مقابل هدف ثابت، ومجموعتين مستقلتين، وقياسات متكررة مزدوجة. يشرح هذا الدليل كيفية تشغيل كل متغير، وقراءة قيمة p بشكل صحيح، والتحقق من صحة الافتراضات الأساسية.
ما هو الاستدلال الإحصائي؟
الاستدلال الإحصائي هو فن استخلاص النتائج حول توزيع البيانات. غالبًا ما يواجه عالم البيانات أسئلة لا يمكن الإجابة عنها إلا علميًا. لذا، يُعد الاستدلال الإحصائي استراتيجية لاختبار صحة الفرضية، أي التحقق من صحتها بالبيانات.
تُعد اختبارات t استراتيجية شائعة لتقييم الفرضيات، حيث تُحدد ما إذا كان متوسطان متساويين أم لا. وتُعرف أيضًا باسم اختبار الطالبيمكن حساب اختبار t لـ:
- متجه واحد مقابل قيمة ثابتة (اختبار t لعينة واحدة)
- متجهان من مجموعتين منفصلتين (اختبار t لعينتين مستقلتين)
- تم قياس متجهين على نفس الأشخاص (اختبار t المزدوج)
يفترض كل اختبار t أن البيانات مأخوذة عشوائياً وأن القيم (أو الفروق في حالة الاختبار المزدوج) تأتي من مجتمع ذي توزيع طبيعي تقريباً. ويفترض اختبار العينتين المستقلتين أيضاً أن المجموعتين مستقلتان عن بعضهما، بينما يفترض الشكل الكلاسيكي أن تبايناتهما متساوية.
ما هو اختبار T في برمجة R؟
الفكرة الأساسية وراء اختبار T هي استخدام الإحصائيات لتقييم فرضيتين متعارضتين:
- H0الفرضية الصفرية: أن متوسط المجتمع يساوي القيمة التي يتم اختبارها
- H1الفرضية البديلة هي أن متوسط المجتمع يختلف عن تلك القيمة.
صُمم اختبار t لأحجام العينات الصغيرة، حيث يكون التقريب الطبيعي غير موثوق. ويتطلب هذا الاختبار أن تكون البيانات موزعة توزيعًا طبيعيًا تقريبًا.
بناء جملة اختبار T في R
بناء الجملة الأساسي لـ t.test() في R هو:
t.test(x, y = NULL,
       mu = 0, var.equal = FALSE)
arguments:
- x : A vector to compute the one-sample t-test
- y: A second vector to compute the two sample t-test
- mu: Mean of the population under the null hypothesis
- var.equal: Specify whether the variances of the two vectors are equal. By default, set to `FALSE`
- paired: Set to `TRUE` when the two vectors are repeated measures on the same subjects
قبل تشغيل أي شيء، تأكد من مطابقة تخطيط بياناتك مع المتغير الصحيح للاختبار.
أنواع اختبار T في لغة R
يُعد اختيار المتغير الخاطئ الخطأ الأكثر شيوعًا في اختبار t، لذا ابدأ بمطابقة تخطيط بياناتك مع الاستدعاء الصحيح.
| النوع | استخدمه عندما | استدعاء R |
|---|---|---|
| عينة واحدة | تمت مقارنة إحدى المجموعات بقيمة مستهدفة معروفة | t.test(x, mu = value) |
| اختبار ويلش المستقل لعينتين | مجموعتان منفصلتان، وقد تكون التباينات غير متساوية | t.test(x, y) |
| عينتان مستقلتان (مجمعتان) | مجموعتان منفصلتان لهما تباين متساوٍ | t.test(x, y, var.equal = TRUE) |
| يقترن | تم قياس نفس الأشخاص مرتين | t.test(x, y, paired = TRUE) |
| من طرف واحد | أنت لا تهتم إلا بالاختلاف في اتجاه واحد | t.test(x, mu = value, alternative = “greater”) |
بعد ثلاث مجموعات، لم يعد اختبار t مناسبًا. انتقل إلى اختبار التباين، مما يحافظ على معدل الخطأ الإجمالي عند 5 بالمائة بدلاً من تضخيمه عبر المقارنات الزوجية المتكررة.
عينة واحدة من اختبار T في R
اختبار t للعينة الواحدة، أو اختبار الطالب، يقارن متوسط المتجه بالمتوسط النظري،  . الصيغة المستخدمة لحساب اختبار t هي:

هنا،
 يشير إلى المتوسط
 إلى الوسط النظري
- s هو الانحراف المعياري
- ن عدد الملاحظات.
 يشير إلى المتوسط
لتقييم الأهمية الإحصائية لاختبار t، تحتاج إلى حساب ف قيمة. ف قيمة تتراوح من 0 إلى 1، ويتم تفسيرها على النحو التالي:
- قيمة p أقل من 0.05 تعني إمكانية رفض الفرضية الصفرية. تجدر الإشارة إلى أن رفض H0 لا يعني بالضرورة صحة H1، بل يعني فقط أن البيانات غير محتملة في ظل H0.
- تشير قيمة p الأعلى من 0.05 إلى أنه ليس لديك أدلة كافية لرفض الفرضية الصفرية.
يمكنك إنشاء القيمة p من خلال النظر إلى القيمة المطلقة المقابلة لاختبار t في توزيع الطالب بدرجات حرية تساوي 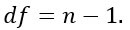
على سبيل المثال، عند استخدام 5 مشاهدات، تتم مقارنة قيمة t الخاصة بك مع توزيع Student ذي 4 درجات حرية عند مستوى ثقة 95%. لرفض الفرضية الصفرية في اختبار ثنائي الجانب، يجب أن تتجاوز القيمة المطلقة لـ t 2.776.
جدول CF أدناه:

مثال واحد لاختبار T في R
لنفترض أنك شركة تنتج ملفات تعريف الارتباط. من المفترض أن تحتوي كل قطعة كوكيز على 10 جرام من السكر. يتم إنتاج ملفات تعريف الارتباط بواسطة آلة تضيف السكر في وعاء قبل خلط كل شيء. أنت تعتقد أن الآلة لا تضيف 10 جرامات من السكر لكل ملف تعريف ارتباط. إذا كان افتراضك صحيحًا، فيجب إصلاح الجهاز. لقد قمت بتخزين مستوى السكر في ثلاثين قطعة من البسكويت.
ملاحظات: يمكنك إنشاء متجه عشوائي باستخدام الدالة rnorm(). تولد هذه الدالة قيمًا موزعة بشكل طبيعي. بناء الجملة الأساسي هو:
rnorm(n, mean, sd)
arguments
- n: Number of observations to generate
- mean: The mean of the distribution. Optional
- sd: The standard deviation of the distribution. Optional
يمكنك إنشاء توزيع يحتوي على 30 ملاحظة بمتوسط 9.99 وانحراف معياري قدره 0.04.
set.seed(123)
sugar_cookie <- rnorm(30, mean = 9.99, sd = 0.04)
head(sugar_cookie)
الإخراج:
## [1] 9.967581 9.980793 10.052348 9.992820 9.995172 10.058603
يمكنك استخدام اختبار t لعينة واحدة للتحقق مما إذا كان مستوى السكر مختلفًا عن الوصفة. يمكنك رسم اختبار الفرضيات:
- H0: متوسط مستوى السكر يساوي 10
- H1: متوسط مستوى السكر يختلف عن 10
يمكنك استخدام مستوى أهمية 0.05.
# H0 : mu = 10
t.test(sugar_cookie, mu = 10)
هنا هو الإخراج:

قيمة الاحتمالية (p-value) لاختبار t لعينة واحدة هي 0.1079، وهي أعلى من عتبة 0.05. وتتراوح فترة الثقة بنسبة 95% للمتوسط بين 9.973 و10.002 غرام، وهي تشمل القيمة المستهدفة 10. لذا، لا يمكن رفض الفرضية الصفرية (H0): لا يوجد دليل كافٍ على أن الجهاز ينحرف عن الوصفة.
اختبار T لعينتين مستقلتين في لغة البرمجة R
يُعد اختبار t المستقل لعينتين هو المتغير الأكثر استخدامًا، وينطبق كلما جاءت مجموعتا القياسات من موضوعين مختلفين: متجران، وآلتان، ومجموعتان علاجيتان.
لنفترض أن مصنعًا يدير خطي إنتاج وتريد معرفة ما إذا كانا يقومان بتعبئة البرطمانات بنفس الوزن.
set.seed(123)
line_a <- rnorm(25, mean = 500, sd = 8)
line_b <- rnorm(25, mean = 505, sd = 8)

# Welch test, the safe default
t.test(line_a, line_b)

# Pooled test, only when the variances are equal
t.test(line_a, line_b, var.equal = TRUE)
اقرأ المخرجات في أربع خطوات.
- t يمثل هذا الحجم المعياري للفجوة بين المتوسطين. وتعكس إشارته فقط ترتيب تمرير المتجهات.
- df تمثل درجات الحرية. ينتج اختبار ويلش قيمة كسرية؛ بينما يعطي الاختبار المجمع عددًا صحيحًا يساوي n1 + n2 – 2.
- ف قيمة ما هو احتمال رؤية فجوة بهذا الحجم إذا كانت المتوسطات الحقيقية متطابقة؟
- فاصل الثقة يحدد هذا النطاق الفرق الحقيقي. عندما يحتوي على الصفر، يكون الفرق غير ذي دلالة إحصائية عند هذا المستوى.
إذا كانت بياناتك موجودة في إطار بيانات واحد يحتوي على عمود واحد للقيم وعمود واحد للعوامل، فاستخدم واجهة الصيغة بدلاً من ذلك، فهي أسهل في القراءة وتتجنب تقسيم البيانات يدويًا:
t.test(weight ~ line, data = jars)
أي إصدار يجب استخدامه؟ اترك قيمة var.equal على الوضع الافتراضي FALSE إلا إذا اختبرت وتأكدت من تساوي التباينات. لا يؤثر تصحيح ويلش تقريبًا على قوة المعالجة عندما تتطابق التباينات، وهو يحميك عندما لا تتطابق.
اختبار T المقترن في R
يُستخدم اختبار t المزدوج، والذي يُسمى أيضًا اختبار t للعينات المترابطة، عندما يتم قياس المجموعة نفسها مرتين. ومن تطبيقاته الشائعة ما يلي:
- A اختبار / B: قارن بين متغيرين
- دراسات الحالات والشواهدقبل وبعد العلاج على نفس الأشخاص
مثال اختبار T المقترن في R
ترغب إحدى شركات المشروبات في معرفة أداء برنامج الخصم على المبيعات. قررت الشركة متابعة المبيعات اليومية لأحد متاجرها التي يتم الترويج فيها للبرنامج. في نهاية البرنامج، تريد الشركة معرفة ما إذا كان هناك فرق إحصائي بين متوسط مبيعات المتجر قبل البرنامج وبعده.
- الشركة tracقمنا بتقييم المبيعات يوميًا قبل بدء البرنامج. هذه هي أولى خطواتنا.
- يتم الترويج للبرنامج لمدة أسبوع ويتم تسجيل المبيعات يوميًا. هذا هو ناقلنا الثاني.
- سوف تقوم بإجراء اختبار t للحكم على فعالية البرنامج. وهذا ما يسمى باختبار t المقترن لأن قيم كلا المتجهين تأتي من نفس التوزيع (أي نفس المتجر).
اختبار الفرضيات هو:
- H0: لا فرق في المتوسط
- H1: والوسيلتان مختلفتان
تذكر أن اختبار t الكلاسيكي يفترض تباينًا غير معروف ولكنه متساوٍ في كلتا المجموعتين. نادرًا ما تحقق البيانات الحقيقية هذا الافتراض بدقة، وقد يؤدي تجاهل هذا الاختلاف إلى تشويه النتيجة.
الحل هو اختبار ويلش t، الذي يُخفف من افتراض تساوي التباين. يطبقه برنامج R افتراضيًا لأن قيمة var.equal تكون FALSE ما لم تُحدد خلاف ذلك. في هذه المجموعة من البيانات، تم توليد كلا المتجهين بنفس الانحراف المعياري، لذا يمكنك ضبط var.equal = TRUE بأمان.
يمكنك إنشاء متجهين عشوائيين من توزيع غاوسي بمتوسط أعلى للمبيعات بعد البرنامج.
set.seed(123)
# sales before the program
sales_before <- rnorm(7, mean = 50000, sd = 50)
# sales after the program.This has higher mean
sales_after <- rnorm(7, mean = 50075, sd = 50)
# draw the distribution
t.test(sales_before, sales_after,var.equal = TRUE)

قيمة الاحتمالية (p-value) هي 0.04606، وهي أقل بقليل من عتبة 0.05، لذا نرفض الفرضية الصفرية (H0) ونستنتج أن المتوسطين يختلفان اختلافًا معنويًا. ويبدو أن برنامج الخصم قد ساهم في زيادة المبيعات.
⚠️ هام: يقارن الاستدعاء أعلاه بين المتجهين على النحو التالي: مستقل العينات. ولأن كلتا السلسلتين عبارة عن قياسات في نفس المتجر، فإن النتيجة الصحيحة إحصائيًا تضيف مقترن = صحيح:
t.test(sales_before, sales_after, paired = TRUE)
يختبر النموذج المزدوج متوسط الفروقات اليومية بدلاً من الفرق بين متوسطين. وهو يزيل التباين على مستوى المتجر المشترك بين المتجهين، وبالتالي يتمتع بقوة إحصائية أكبر.
كيفية التحقق من افتراضات اختبار T في لغة R
لا تكون قيمة p لاختبار t ذات معنى إلا إذا تحققت افتراضاته. ولكل افتراض منها طريقة تحقق مباشرة.
1. الوضع الطبيعي. يفترض اختبار العينة الواحدة واختبار العينتين أن القيم تتبع التوزيع الطبيعي تقريبًا؛ بينما يفترض اختبار العينات المزدوجة أن الخلافات قم بفحص مخطط QQ وتأكد من ذلك باستخدام اختبار شابيرو-ويلك:
qqnorm(sugar_cookie); qqline(sugar_cookie)
shapiro.test(sugar_cookie)

# for a paired design, test the differences
shapiro.test(sales_after - sales_before)
قيمة احتمالية اختبار شابيرو-ويلك التي تزيد عن 0.05 تعني أنه لا يمكن رفض فرضية التوزيع الطبيعي. ومع وجود أكثر من 30 مشاهدة لكل مجموعة، فإن نظرية النهاية المركزية تجعل اختبار t قويًا في مواجهة الانحراف المعتدل.
2. تباين متساوٍ. لا يتطلب ذلك إلا اختبار العينتين المجمعتين. اختبره باستخدام اختبار F.
var.test(line_a, line_b)
قيمة p أعلى من 0.05 تدعم تساوي التباينات، مما يبرر var.equal = TRUE.
3. الاستقلال. هذا ناتج عن تصميم الدراسة ولا يمكن اختباره بعد إجرائها. إذا ساهم نفس الشخص في كلا المتجهين، فإن الاختبار المستقل هو ببساطة الأداة الخاطئة، ويجب أن تكون قيمة paired = TRUE.
عندما يفشل الافتراض. بالنسبة للبيانات غير الطبيعية بوضوح ذات العينات الصغيرة، استخدم البدائل القائمة على الرتب: wilcox.test(x, y) يحل محل اختبار t لعينتين، و wilcox.test(x, y, paired = TRUE) يحل محل النسخة المزدوجة. لا يشترط أي منهما التوزيع الطبيعي، مع العلم أن كلاهما يقلل من قوة الاختبار قليلاً عندما تكون البيانات طبيعية بالفعل.
اختبار T في لغة R: أهم النقاط المرجعية للاختبار
- الاستدلال الإحصائي هو فن توليد استنتاجات حول توزيع البيانات.
- ينتمي اختبار T إلى عائلة الإحصاءات الاستدلالية. ويُستخدم عادةً لمعرفة ما إذا كان هناك فرق إحصائي بين متوسطات مجموعتين.
- يقارن اختبار t لعينة واحدة، أو اختبار Student، متوسط متجه مقابل متوسط نظري.
- يتم تطبيق اختبار t المزدوج، أو اختبار t للعينات المترابطة، عندما يتم قياس نفس المجموعة مرتين.
يلخص الجدول أدناه كل اختبار تم تناوله أعلاه:
| اختبار | فرضية للاختبار | ف قيمة | Code | حجة اختيارية |
|---|---|---|---|---|
| اختبار t لعينة واحدة | متوسط المتجه يختلف عن المتوسط النظري | 0.05 |
t.test(x, mu = mean)
|
|
| اختبار t للعينات المقترنة | المتوسط أ يختلف عن المتوسط ب لنفس الأشخاص | 0.05 |
t.test(A, B, paired = TRUE) |
var.equal = TRUE
|
إذا كنت ترغب في افتراض تباينات متساوية في اختبار عينتين مستقلتين، فعيّن قيمة var.equal إلى TRUE. اتركها على القيمة الافتراضية FALSE لتشغيل تصحيح ويلش الأكثر أمانًا.
