
使用示例在 Informatica 中进行排名转换
 编辑团队
什么是等级转换?
排名转换是一种主动且关联的转换,它基于分组和排名对数据进行筛选。例如,如果您想获取薪资最高的十名员工记录,就可以使用排名转换来实现这种筛选。
排名转换还提供了基于分组进行排名的功能。例如,如果您想按部门获取薪资最高的十名员工,则该分组为ping 通过这种转换可以实现。
等级转换是一种主动转换,因为它会影响输出行的数量。
排名转换有一个输出端口,用于为行分配排名。该端口名为 RANKINDEX,设计器会在将转换添加到数据库后立即自动创建它。 地图ping.
由于排名必须比较组内的每一行才能决定哪些行获胜,因此集成服务会缓存传入的数据。组值会进入索引缓存,其余的行数据会进入数据缓存,就像缓存数据一样。 连接器转型 拥有其主管道。
排名转换中的端口
在给出示例之前,了解“端口”选项卡上的每个端口标志的实际作用很有帮助,因为其中两个标志真正执行了此转换。
| 端口类型 | 它做什么 |
|---|---|
| 输入(I) | 从上游转换接收一列。链接到 Rank 转换的每一列都是一个输入端口。 |
| 输出(O) | 将列传递给下一个转换或目标。 |
| 变量(V) | 在转换内部进行局部计算,就像在表达式转换中一样。 |
| 等级 (R) | 标记用于计算排名的列。转换过程中只能有一个端口承载此标志。 |
| 通过...分组 | 对每个不同的值重新开始排名,因此前三名筛选器将返回每组三行,而不是总共三行。 |
| 排名指数 | 由设计器创建的仅输出端口。它存储每一行在其所属组中的排名位置,可以保持未连接状态。 |
排名只能在单个端口上进行,因此像“最高薪资,然后是最长服务年限”这样的要求需要上游准备打破平局的值,而不是第二个排名端口。
如何在 Informatica 中使用 Rank 转换
我们的需求是加载每个部门薪资最高的 3 名员工;我们将使用排名转换来实现这一点。请在 Map 中按照以下八个步骤操作。ping 设计师。
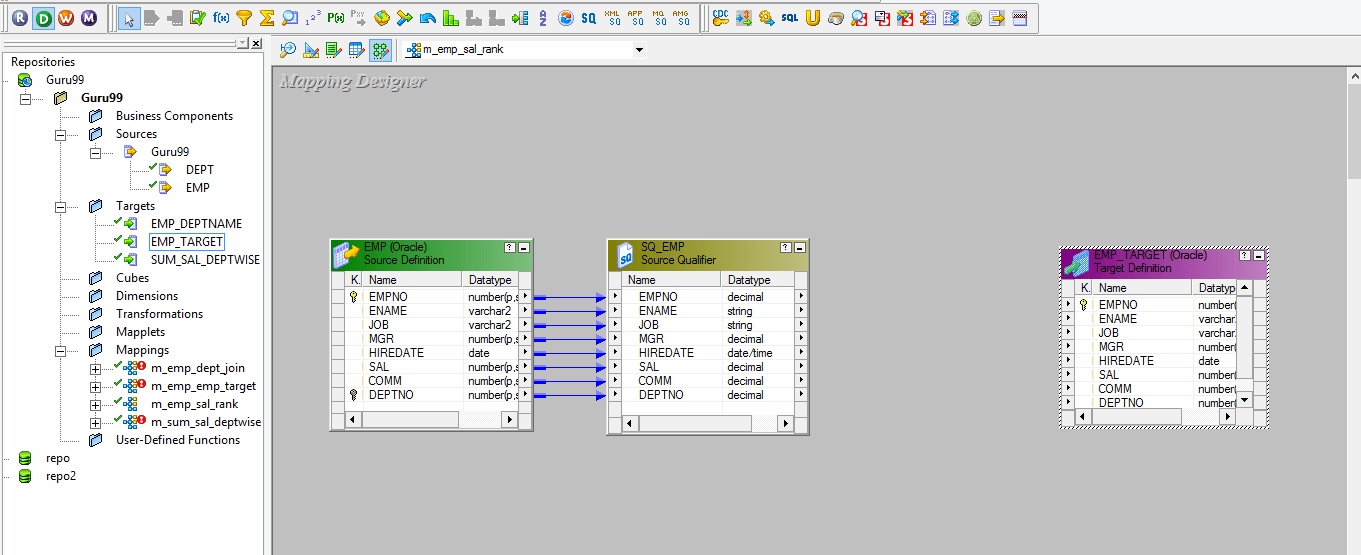
步骤1) 创建地图ping 源 EMP 和目标 EMP_TARGET。这两个定义现在都显示在画布上,如下图所示。
步骤2) 然后在地图上ping
- 选择变换菜单
- 选择创建选项
接下来显示的是“转换”菜单,其中包含“创建”选项。

步骤3) 在创建转换窗口中
- 选择等级转换
- 输入转换名称“rnk_salary”
- 选择“创建”按钮

步骤4) Rank转换将在映射中创建。ping点击窗口中的“完成”按钮。此时,画布上会出现一个空的 rnk_salary 对象。

步骤5) 连接所有端口 来源限定符 进行排名转换,以便每个员工列都可以用于排名。
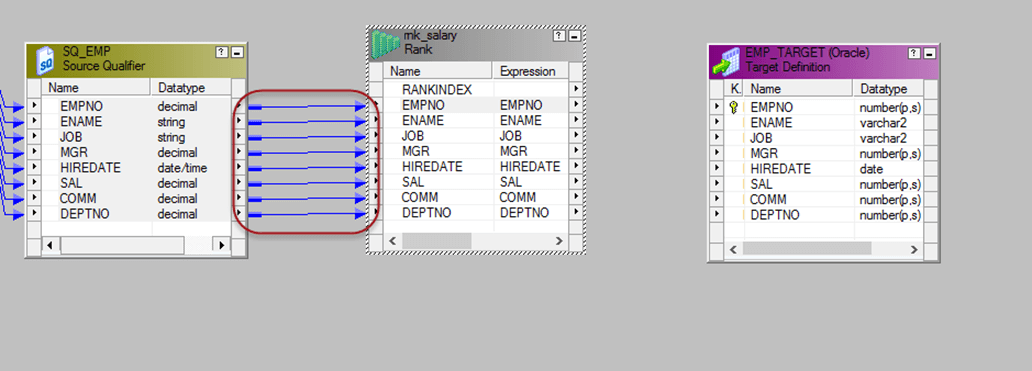
步骤6) Double 点击“排名转换”,即可打开“编辑转换”窗口。在此窗口中,
- 选择属性菜单
- 从顶部/底部属性中选择“顶部”选项
- 在排名数中输入 3
如屏幕截图所示,“属性”选项卡现在显示“排名靠前”,并有三个排名。

步骤7) 再次进入“编辑变换”窗口
- 选择端口选项卡
- 选择部门编号列的分组依据选项
- 在薪资栏中选择职级
- 选择确定按钮
“端口”选项卡现在在部门编号上带有组标志,在薪资上带有 R 标志。

步骤8) 将 Rank 转换的端口连接到目标表。映射ping 现在从 EMP 经由 rnk_salary 运行到 EMP_TARGET。

现在,保存地图ping 创建完成后执行它 会议 和 工作流程源限定符将获取所有记录,但排名转换将仅传递每个部门有三个最高薪资的记录。
秩变换属性
步骤 6 中使用的“属性”选项卡包含的设置不止示例中更改的两项。以下设置控制保留的行数、字符串比较方式以及缓存文件的写入位置。
| 特性 | 它控制什么 |
|---|---|
| 顶部/底部 | 排名列保留的是最高值还是最低值?示例中使用的是“最高”。 |
| 排名数量 | 每个组返回多少行?示例中使用 3,因此每个部门返回三名员工。 |
| 区分大小写的字符串比较 | 字符串比较在排名时是否区分字母大小写?这仅在排名端口包含文本时才重要。 |
| 缓存目录 | 索引和数据缓存文件所在的目录。默认值为 $PMCacheDir 进程变量。 |
| 排名数据缓存大小 | 用于存储行数据的数据缓存大小。默认值为“自动”,允许集成服务自动调整其大小。 |
| 排名索引缓存大小 | 用于存储组值的索引缓存大小。默认值为自动。 |
| 转型范围 | 将排名应用于每笔交易或所有传入数据。 |
| Tracing 级别 | 写入会话日志的详细程度:简略、正常、详细初始化或详细数据。 |
对于大型数据源,缓存大小是一个值得重新审视的设置。当缓存过小时,集成服务会将页面写入磁盘,这是在测试过程中首先要检查的项目之一。 性能调优 地图ping.
排名转换与聚合转换
这两个转换都处于激活状态,都会缓存输入数据,并且都提供分组依据端口,因此很容易选错。区别在于它们的输出结果。
| 比较点 | 秩变换 | 聚合器转换 |
|---|---|---|
| 目的 | 返回每个组的顶部或底部 N 个完整行。 | 返回计算值,例如 SUM、 AVG每组的最大值或最小值 |
| 返回的行 | 每个组最多可显示指定数量的排名,且所有列均保持不变。 | 通常每个组一行汇总信息 |
| 新增端口 | RANKINDEX,保存每一行的位置 | 没有 |
| 排名或聚合列 | 一个端口被标记为排名端口 | 任意数量的端口承载聚合表达式 |
简而言之, 聚合器转换 回答“本部门最高薪资是多少”的问题,而排名转换回答“哪些员工获得最高薪资”。当只需要根据简单条件丢弃一部分行,且不涉及排序时, 滤波器变换 是更便宜的选择,因为它完全不需要缓存。
