
Informatica 中的聚合器转换与示例
 大卫卡特
什么是聚合器转换?
聚合器转换是一种主动转换,它执行聚合计算,例如求和、平均值和计数。
例如,如果您想按部门计算所有员工的工资总和,可以使用聚合器转换。
聚合操作是在一组行上执行的,因此需要一个临时占位符来存储所有这些记录并执行计算。
为此,需要使用聚合器缓存。聚合器缓存是分配给聚合器转换以执行此类操作的临时主内存,它分为两部分:索引缓存存储组值,而数据缓存存储要聚合的行数据。
该转换处于活动状态,因为它会改变管道中的行数。数千条员工记录可以输入管道,但每个部门只有一行记录输出。
如何在 Informatica 中使用聚合转换
在此示例中,我们将按部门计算工资总额。为此,我们需要一个新列来存储此总额。因此,首先,我们将准备一个新列。
步骤1) 使用以下脚本创建一个新的数据库目标表,例如“sum_sal_deptwise”。您将在以下位置看到新创建的数据库目标表: Target下一步将文件保存到 s 文件夹中。
下载上述 Create_table_sal_deptwise.txt 文件
步骤2) 创建一个新的 地图ping “m_sum_sal_deptwise”。
为了创建新地图ping我们需要 Map 中的源表 (EMP) 和目标表 (sum_sal_deptwise)。ping 设计师,所以我们需要
- 将目标表“sum_sal_deptwise”导入到映射中ping.
- 导入源表“emp”。
这两个定义现在都显示在画布上,如下所示。
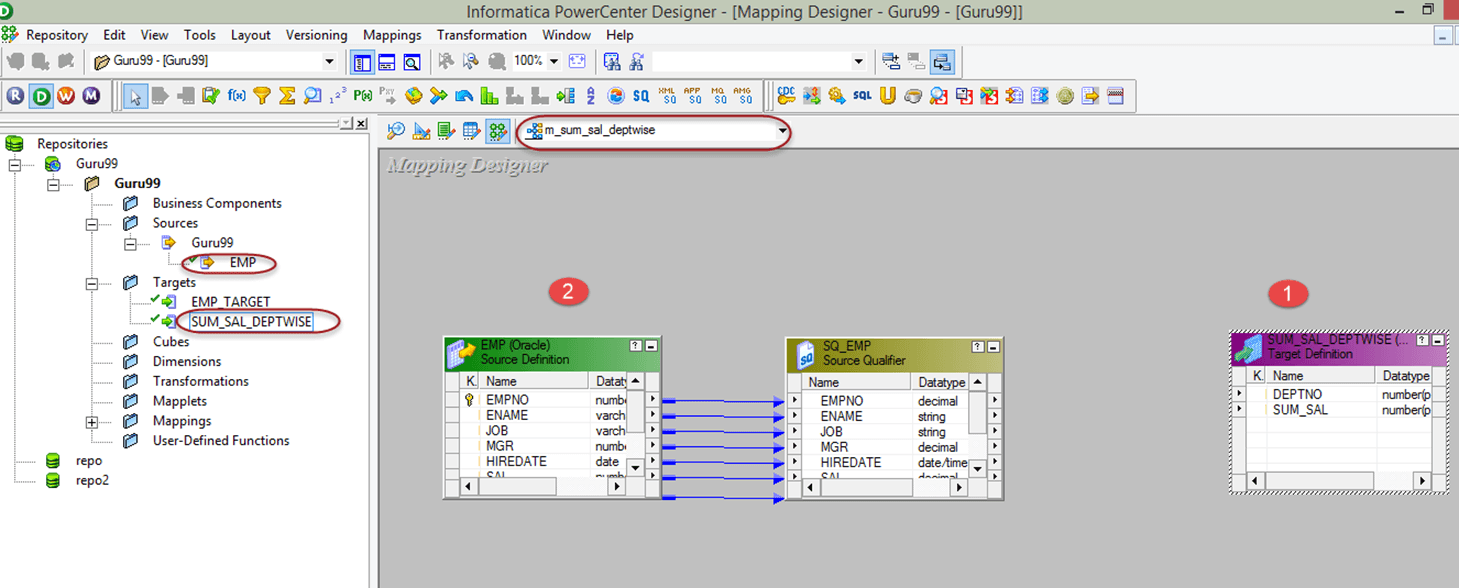
步骤3) 在地图上ping,
- 来自 源限定符删除 empno、ename、job、mgr、hiredate 和 comm 列,只保留 deptno 和 sal 列。
- 使用工具箱菜单创建新的聚合器转换,如图所示。单击聚合器图标后,将创建一个新的聚合器转换。
新的 AGGTRANS 对象出现在修剪后的源限定符旁边。

步骤4) 将源限定符 (SQ_EMP) 中的 SAL 和 DEPTNO 列拖放到聚合转换中。现在,这两个端口已连接到 AGGTRANS。

步骤5) Double单击聚合器转换以打开其属性,然后
- 在转换中添加新端口
- 将端口重命名为 SUM_SAL
- 将此新端口的数据类型更改为双精度
- 选中输出端口复选框,将此端口设为输出端口。
- 点击表达式选项
“端口”选项卡现在列出了 SAL、DEPTNO 和新的 SUM_SAL 输出端口。

步骤6) 在表达式编辑器窗口中
- 添加表达式 sum(SAL);这个表达式需要你自己编写。
- 选择“确定”按钮,这将重新打开“编辑变换”窗口。
表达式编辑器显示分配给 SUM_SAL 的聚合表达式。

步骤7) 在“编辑转换”窗口中,选中“分组依据”选项(选中“部门编号”列旁边的复选框),然后单击“确定”。选中“分组依据”复选框后,我们将指示 Informatica 按部门编号对薪资进行分组。

步骤8) 将聚合转换中的 deptno 和 sum_sal 列链接到目标表。ping 从源到目标的传输就完成了。

现在保存地图ping 创建新文件后执行它 会议 这张地图ping目标表将包含按部门划分的薪资总和。这样,我们就可以使用聚合转换来计算汇总结果。
聚合器转换中的按端口分组
上述步骤将单个端口标记为“分组依据”,从而将公司整体总计转换为每个部门的总计。任何输入端口、输入/输出端口、输出端口或可变端口都可以用相同的方式进行标记。
结果集遵循以下三条规则:
- 每组一行。 当值被分组时,集成服务会为分组端口的每个唯一组合生成一行。
- 没有分组依据,只有一行。 如果没有标记端口,则将整个输入视为一个整体,并为所有输入行返回一行。
- 最后一排获胜。 除了汇总结果之外,集成服务通常会传递组中接收到的最后一行,除非像 FIRST 这样的函数指定了不同的行。
如果标记了多个港口,则港口顺序决定分组。ping 顺序,而顺序会改变结果。ping 按部门编号 (DEPTNO) 和工作 (JOB) 划分与组划分不同ping 按 JOB 和 DEPTNO 排序,因为第二列的值不一定是唯一的。
聚合变换属性
“编辑转换”窗口的“属性”选项卡包含决定缓存位置和缓存使用量的设置。下表列出了这些设置。
| 设置 | 它控制什么 |
|---|---|
| 缓存目录 | 集成服务会在本地目录中创建索引和数据缓存文件。默认值为工作流管理器中设置的 $PMCacheDir 进程变量。 |
| Tracing 级别 | 本次转换写入会话日志的详细程度。 |
| 已排序输入 | 声明传入数据已按端口分组排序。仅当映射表满足条件时才选择此项。ping 确实能提供排序后的数据。 |
| 聚合器数据缓存大小 | 数据缓存的大小。默认值为 2,000,000 字节,“自动”选项允许集成服务自动调整其大小。 |
| 聚合索引缓存大小 | 索引缓存的大小。默认值为 1,000,000 字节,“自动”选项允许集成服务自动调整其大小。 |
| 转型范围 | 将逻辑应用于每个事务,或应用于所有传入数据。“全部输入”会忽略传入事务的边界。 |
启用增量聚合后,集成服务会在每次运行时写入缓存文件的备份,因此缓存目录必须保存两组文件而不是一组文件。
聚合表达式规则和性能技巧
聚合表达式可以将聚合函数与条件子句和非聚合函数组合在一起,从而可以在同一个端口内进行条件求和与计数。有两个规则限制了可以编写的内容。
- 一层嵌套结构。 一个聚合函数只能嵌套在另一个聚合函数中,并且首先计算内部表达式。
- 没有混合。 转换可以包含单层函数或嵌套函数,但不能同时包含两者。如果同时包含两者,设计器会标记映射。ping 无效,因此将逻辑拆分到两个聚合器转换中。
在调音方面,三个设置就足以完成大部分工作:
- 输入已排序。 当数据行按端口分组排序后到达时,每个组在其最后一行到达后即可释放,因此缓存的数据量更少,会话运行速度更快。排序后的输入不能与增量聚合结合使用。
- 增量聚合。 新的源行会通过映射传递。ping 并且结合历史缓存而不是重新计算历史记录,这适合每晚加载到运行总数上。
- 尽早筛选。 永远不会对总数产生贡献的行应该在聚合器之前删除,可以在源限定符查询中或在聚合器中执行此操作。 滤波器变换因为每一行数据到达聚合器都会消耗缓存内存。这是标准检查之一。 性能调优.
