
Як налаштувати Cassandra Cluster на кількох вузлах
 Редакційна колегія
⚡ Розумний підсумок
Cassandra Cluster групує кілька вузлів таким чином, щоб дані були розподілені, і жодна машина не могла зберігати все на одному комп'ютері. На цій сторінці пояснюються компоненти кластера, роздільник і Token Ring, передумови, параметри конфігурації, що об'єднують вузли, і як перевірити результат.
Що таке Cassandra Cluster?
A Cassandra кластер є однією з оболонок цілого Cassandra база даних. Cassandra Кластер містить численні різні шари одиниць зберігання даних, і кожен шар містить інші.
Велика організація, наприклад Amazon, Facebook тощо мають величезні обсяги даних для керування. Тому ці організації не можуть зберігати такий величезний обсяг даних на одному комп’ютері. Саме тоді вони використовують такі бази даних, як Cassandra з розподіленою архітектурою.
Ці організації зберігають величезну кількість даних на кількох вузлах. Ці вузли взаємодіють один з одним. Для цього, Cassandra створено кластер.
- Cluster це, по суті, група вузлів, завдяки чому вузли можуть легко взаємодіяти один з одним.
- Координаторний вузол – це вузол, який отримує запит клієнта та взаємодіє з репліками від імені цього клієнта. Будь-який вузол може виступати координатором для будь-якого запиту.
Розділювач
Розділювач визначає, як дані повинні бути розподілені в кластері. Partitioner використовує хеш-функцію для розподілу даних у кластері. Для обчислення хешу потрібен ключ розділу. Цей хеш називається знак. Дані поширюються на основі цього токена.
Розділювач за замовчуванням — це Murmur3Partitioner, який створює токени, рівномірно розподілені по фіксованому діапазону. Кожен вузол володіє одним або кількома діапазонами цього діапазону, і колекція діапазонів утворює жетонне кільцеОскільки присвоєння здійснюється за хешем, а не за значенням, додавання вузла переміщує лише діапазони, які він займає, а не перетасовує весь набір даних.
Передумови для Cassandra Cluster
Існують наступні вимоги до налаштування кластера.
- У вас має бути кілька машин, фізичних або віртуальних, які виступають у ролі вузлів.
- Вузли повинні мати можливість зв'язку один з одним у мережі. Між ними мають бути відкриті порти 7000 для міжвузлового трафіку, 7001, якщо TLS увімкнено, та 9042 для клієнтських з'єднань.
- Linux має бути встановлений на кожному вузлі. Це платформа Cassandra протестовано та підтримується на.
- Apache Cassandra має бути встановлено на кожному вузлі однієї версії. Змішані версії не можуть завершити угоду про схему.
- Підтримуваний JDK має бути встановлено на кожній машині з встановленим JAVA_HOME.
- Годинники повинні бути синхронізовані з NTP. Cassandra вирішує конфліктні записи за міткою часу, тому дрейф годинника непомітно призводить до неправильних результатів.
Остання вимога найчастіше пропускається, і вона спричиняє проблеми з даними, а не збої запуску.
.
Як встановити Cassandra Cluster на Linux
Cassandra має бути встановлено на кожному комп’ютері, перш ніж будь-який з них зможе приєднатися до кластера. Знімки екрана нижче взяті з графічного інсталятора DataStax Enterprise, який був поширеним маршрутом під час написання цього посібника. Цей інсталятор більше не розповсюджується для спільного використання, тому поточний підхід наведено спочатку, а майстер наведено далі для довідки.
Поточний метод: встановити Apache Cassandra пакет або бінарний tar-архів на кожному вузлі однаково, а потім перевірте, чи кожен з них запускається самостійно, перш ніж намагатися приєднатися до них.
tar -xzf apache-cassandra-x.y.z-bin.tar.gz -C /opt/
export CASSANDRA_HOME=/opt/apache-cassandra-x.y.z
$CASSANDRA_HOME/bin/cassandra -f
Після коректного запуску одного вузла зупиніть його, очистіть його каталог даних і перейдіть до розділу налаштування кластера нижче.
Крок 1) Запустіть Cassandra Налаштування корпоративної версії. Увімкнено Linux термінал, запустіть програму налаштування. З’явиться наступна сторінка.

Ця сторінка не надає жодної необхідної інформації. Він просто надає інформацію про Cassandra версія. Тож пройдіть цю сторінку та натисніть кнопку «Далі».
Крок 2) Прийміть ліцензійну угоду. Після натискання кнопки «Далі» відобразиться наступна сторінка.

Ця сторінка містить інформацію про пакети та підпакети в Cassandra який буде встановлено. Нижче з’явиться запит щодо ліцензії. Поставте прапорець «Я приймаю угоду» та натисніть кнопку «Далі».
Крок 3) Встановіть Builder та натисніть кнопку «Далі». Після натискання кнопки «Далі» ви побачите наступну сторінку.

На цій сторінці вас запитають про параметри встановлення.
- Перш за все, він запитає каталог встановлення. За замовчуванням він встановлений у домашній каталог.
- Далі запитає про тип інсталяції, виберіть Проста інсталяція.
- Далі запитує про систему оновлення, позначте «ні».
- Далі запитується інтерфейс за замовчуванням. Є два варіанти: ви можете встановити на локальний хост або вибрати IP-адресу. Виберіть IP-адресу для встановлення.
- Натисніть наступну кнопку.
Крок 4) Налаштуйте вузол і натисніть кнопку «Далі». Після натискання кнопки «Далі» відобразиться наступна сторінка.

Ця сторінка запитує про налаштування вузла.
- Спочатку виберіть тип вузла 'Cassandra Вузол'.
- Далі в полі «Ім’я кільця» введіть назву свого кластера. Cluster ім'я має бути однаковим для всіх вузлів в одному кластері.
- Далі виберіть початковий вузол. Початковий вузол – це вузол, з яким зв’язуються інші вузли, що не є початковим, під час запуску.
- Після надання цієї інформації натисніть наступну кнопку.
Крок 5) Встановіть агент моніторингу. Після натискання кнопки «Далі» відобразиться наступна сторінка. На цій сторінці запитується IP-адреса, на яку слід встановити агент.
- Агент потрібен для консолі моніторингу, де всі вузли можна спостерігати в одному місці.
- Після надання цієї інформації натисніть кнопку «Далі».

Крок 6) Натисніть кнопку «Далі» для встановлення. Після натискання кнопки «Далі» відобразиться наступна сторінка.

Тепер налаштування готове до встановлення. Натисніть наступну кнопку.
Крок 7) Зачекайте на завершення процесу встановлення. Після натискання кнопки «Далі» відобразиться наступна сторінка.
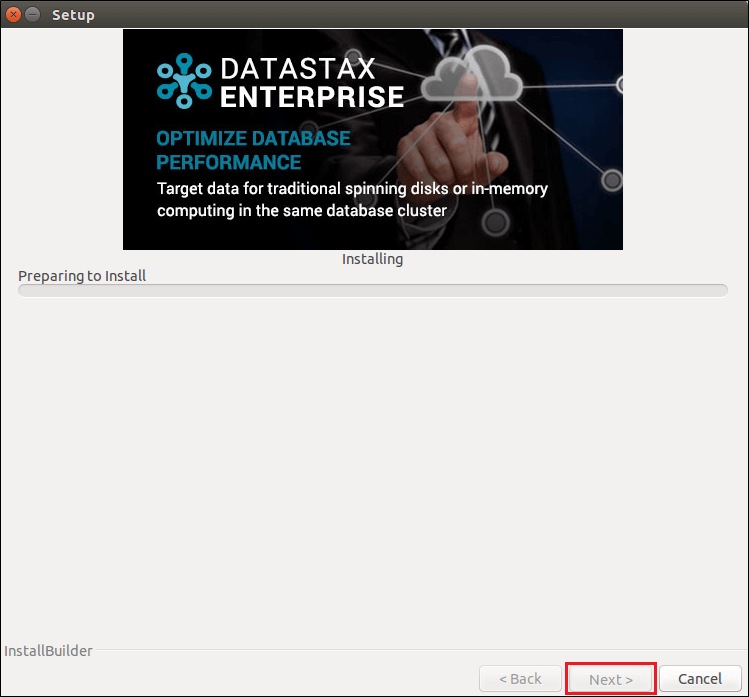
Розпочнеться встановлення.
Крок 8) Натисніть кнопку «Готово». Після встановлення відобразиться наступна сторінка. На цій же сторінці ви побачите позначку для опції, яка відображається за замовчуванням.

Налаштування cassandra.yaml для об'єднання вузлів
Сама лише установка не створює кластер. Вузли знаходять один одного лише після узгодження чотирьох налаштувань у cassandra.yaml, і саме в цьому файлі більшість налаштувань кластера йдуть не так.
cluster_name: 'Guru99 Cluster'
seed_provider:
  - class_name: org.apache.cassandra.locator.SimpleSeedProvider
    parameters:
      - seeds: "192.168.1.10,192.168.1.11"
listen_address: 192.168.1.10
rpc_address: 0.0.0.0
broadcast_rpc_address: 192.168.1.10
endpoint_snitch: GossipingPropertyFileSnitch
- назва_кластера повинні збігатися на кожному вузлі. Невідповідність є найпоширенішою причиною відмови вузла від приєднання.
- Насіння перераховує точки контакту, з якими спілкується початковий вузол. Двох або трьох насінин на центр обробки даних достатньо; перетворення кожного вузла на насінину запобігає автоматичному завантаженню.ping.
- адреса_слухання – це адреса, яку інші вузли використовують для зв’язку з цим вузлом. Це має бути справжня маршрутизується адреса, а не localhost.
- кінцева_точка розповідає Cassandra схема розташування стійки та центру обробки даних. GossipingPropertyFileSnitch – це звичайний вибір, значення якого встановлені у cassandra-rackdc.properties.
Зміна назви снітча або кластера після того, як дані вже існують, вимагає додаткових кроків, тому обидва варіанти слід вирішити до запуску першого вузла.
Починаючи Cassandra вузол
після установки Cassandra На кожному вузлі запустіть сервери та виконайте наведені нижче кроки. Порядок має значення: спочатку запускайте початкові вузли, по одному, чекаючи, поки кожен з них повідомить про роботу, перш ніж запускати наступний. Одночасний запуск кількох вузлів може призвести до конфліктів діапазонів токенів.
Крок 1) Перейдіть до Cassandra каталог встановлення та запустіть сервер.
bin/cassandra -f

Виконуючи цю команду, Cassandra сервер буде запущено. Ось скріншот, де Cassandra сервер запускається.
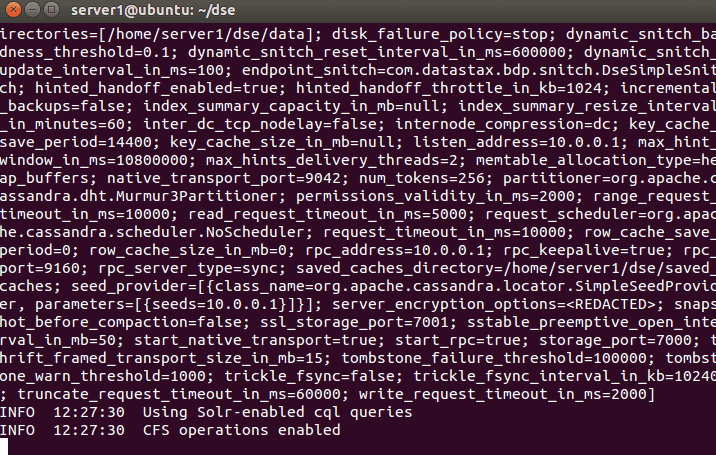
Приблизно через хвилину сервер буде запущено. Запускайте кожен вузловий сервер по черзі. Після запуску всіх вузлових серверів ваш Cassandra кластер готовий до використання.
Крок 2) Перевірте, чи приєднався кожен вузол, перевіривши кільце будь-якого з них.
nodetool status
nodetool describecluster
Кожен вузол повинен відображатися зі статусом UN, що означає «Вгору» та «Звичайно», а стовпець «Власне» має показувати приблизно рівні відсотки. Єдина версія схеми у виводі describecluster підтверджує, що всі вузли погоджуються зі схемою.
Три симптоми охоплюють більшість збоїв. Вузол, який ніколи не з'являється, зазвичай має невідповідне ім'я кластера або заблокований порт 7000. Вузол, що застряг на UJ, що приєднується, все ще передає дані потоком і просто потребує часу на великому кластері. Різко нерівномірне володіння вказує на неправильну конфігурацію збоченого вузла, коли вузли були розміщені не в тій стійці або центрі обробки даних.
За справного кільця параметри реплікації для кожного ключового простору визначають, як дані поширюються по ньому, як описано в Cassandra простір клавіш навчальний посібник та Cassandra архітектура зламатися.
