
Övervakad maskininlärning: Algorithms, Typer & Exempel
 Redaktionellt team
⚡ Smart sammanfattning
Övervakad maskininlärning tränar en algoritm på märkta exempel så att den kan förutsäga resultat för data den aldrig sett tidigare, med hjälp av regression för numeriska mål och klassificering för kategorimål som spam eller bedrägerier.
Vad är övervakad maskininlärning?
Övervakad maskininlärning är en algoritm som lär sig från märkta träningsdata för att hjälpa dig att förutsäga resultat för oförutsedda data. Vid övervakad inlärning tränar du maskinen med hjälp av data som är väl "märkta". Det betyder att en del data redan är märkta med korrekta svar. Det kan jämföras med inlärning i närvaro av en handledare eller lärare.
Att framgångsrikt bygga, skala och driftsätta noggranna övervakade maskininlärningsmodeller kräver tid och teknisk expertis från ett team av högkvalificerade dataforskare. Dataforskare måste också regelbundet bygga om modeller så att de insikter de producerar förblir sanna när underliggande data ändras.
Hur övervakat lärande fungerar
Övervakad maskininlärning använder träningsdatauppsättningar för att uppnå önskade resultat. Dessa datamängder innehåller indata och rätt utdata som hjälper modellen att lära sig snabbare. Du vill till exempel träna en maskin för att hjälpa dig att förutsäga hur lång tid det kommer att ta dig att köra hem från din arbetsplats.
Här börjar du med att skapa en uppsättning märkta data. Dessa uppgifter inkluderar:
- Väderförhållanden
- Tid på dagen
- Helgdagar
- Väg vald
Alla dessa detaljer är dina indata i detta exempel på handledd inlärning. Utdata är den tid det tog att köra hem den specifika dagen, som bilden nedan visar.
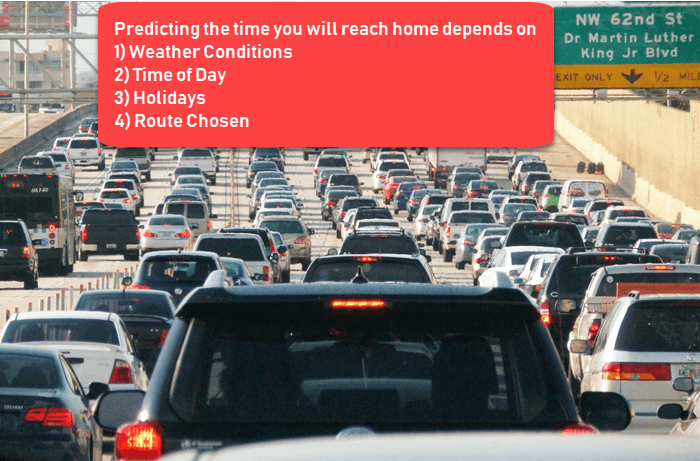
Du vet instinktivt att om det regnar ute, så tar det längre tid att köra hem. Men maskinen behöver data och statistik.
Det första du behöver skapa är en träningsuppsättning. Den kommer att innehålla den totala pendlingstiden och motsvarande faktorer som väder, tid etc. Baserat på denna träningsuppsättning kan din maskin se att det finns ett direkt samband mellan mängden regn och den tid det tar för dig att komma hem.
Så den konstaterar att ju mer det regnar, desto längre tid kommer du att köra för att komma hem. Den kan också se sambandet mellan den tid du lämnar jobbet och den tid du kommer att vara på vägen. Ju närmare klockan 6 du är, desto längre tid tar det för dig att komma hem.
Din maskin kan hitta några av relationerna med dina märkta data. Den inlärningsfasen visas nedan.
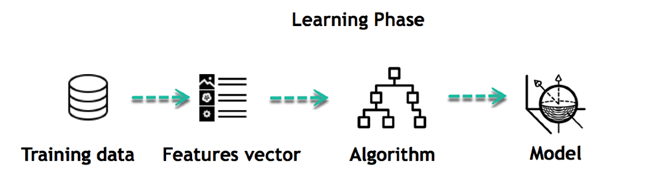
Detta är början på din datamodell. Den börjar registrera hur regn påverkar hur människor kör, och att fler människor reser under en viss tid på dygnet.
Typer av övervakad maskininlärning Algorithms
Följande är typerna av övervakade maskininlärningsalgoritmer:
Regression
Regressionstekniken förutsäger ett enda kontinuerligt utdatavärde med hjälp av träningsdata.
Exempel: Du kan använda regression för att förutsäga huspriset från träningsdata. Indatavariablerna kommer att vara lokalitet, storlek på ett hus, etc.
Styrkor: Utdata är lätta att tolka och algoritmen kan regulariseras för att undvika överanpassning.
Svagheter: En linjär modell är inte flexibel, så den fångar inte komplexa samband utan ytterligare funktioner.
Här är några typer av regression Algorithms:
- Linjär regression
- Polynomregression
- Ridge- och Lasso-regression
- Logistisk regression (för klassificering)
- Beslutsträd och slumpmässig skogsregression
- Stödvektorregression
Logistisk återgång:
Logistisk regression används för att uppskatta diskreta värden baserat på en given uppsättning oberoende variabler. Den hjälper dig att förutsäga sannolikheten för att en händelse inträffar genom att anpassa data till en logitfunktion. Därför är den även känd som logitregression. Eftersom den förutsäger en sannolikhet ligger dess utdatavärde mellan 0 och 1, och den kan underprestera när det finns flera eller icke-linjära beslutsgränser.
Klassificering
Klassificering innebär att gruppera utdata inom en klass. Om algoritmen försöker klassificera indata i två distinkta klasser kallas det binär klassificering. Att välja mellan mer än två klasser kallas multiklassificering.
Exempel: Att avgöra om någon kommer att vara en försumlig betalningsansvarare för lånet eller inte.
Styrkor: Klassificeringsträd fungerar mycket bra i praktiken.
Svagheter: Obegränsade, enskilda träd är benägna att överanpassa.
Här är några typer av klassificering Algorithms:
- Naiva Bayes klassificerare
- Besluts träd
- Stöd Vector Machine
- K-Närmaste grannar
- Slumpmässig skog och gradientförstärkning
Naiva Bayes klassificerare
Ocuco-landskapet Naiva Bayes Modellen är enkel att bygga och mycket användbar för stora datamängder. Denna metod består av riktade acykliska grafer med en förälder och flera barnnoder. Den antar oberoende mellan barnnoder separerade från deras föräldernoder.
Beslutsträd
Beslutsträd klassificerar en instans genom att sortera den baserat på funktionsvärdet. I den här metoden är varje nod den funktion hos en instans som ska klassificeras, och varje gren representerar ett värde som noden kan anta. Det är en allmänt använd teknik för klassificering.
Samma struktur fungerar för regression: ett regressionsträd hjälper dig att uppskatta verkliga värden (kostnad för att köpa en bil, antal samtal, total månadsförsäljning etc.).
Stöd Vector Machine
Support Vector Machine (SVM) är en typ av inlärningsalgoritm som introducerades på 1990-talet. Denna metod är baserad på resultat från statistisk inlärningsteori utvecklad av Vladimir Vapnik och hans kollegor.
SVM:er är också nära kopplade till kärnfunktioner, vilka är ett centralt koncept för de flesta inlärningsuppgifterna. Kärnramverket och SVM används inom en mängd olika områden. Det inkluderar multimediainformationshämtning, bioinformatik och mönsterigenkänning. Varje estimator ovan är dokumenterad med sina finjusteringsparametrar i scikit lära referens.
Övervakade kontra oövervakade maskininlärningstekniker
Placera metoden bredvid oövervakat lärande gör sina gränser tydliga.
| Baserat på | Övervakad maskininlärningsteknik | Oövervakad maskininlärningsteknik |
|---|---|---|
| Indata | Algorithms tränas med hjälp av märkta data. | Algorithms används mot data som inte är märkta |
| Beräkningskomplexitet | Handledd inlärning är en enklare metod. | Oövervakat lärande är beräkningsmässigt komplext |
| Noggrannhet | Mycket exakt och pålitlig metod. | Less korrekt och pålitlig metod. |
| Typiska algoritmer | Logistisk regression, beslutsträd, SVM, Naive Bayes | K-medelvärden, hierarkisk klustring, PCA |
| Hur resultaten bedöms | Poängsatt mot kända svar (noggrannhet, RMSE) | Bedömd genom interna åtgärder och mänsklig granskning |
Utmaningar inom övervakad maskininlärning
Här är utmaningar i övervakad maskininlärning:
- Irrelevanta inmatningsfunktioner i träningsdata kan ge felaktiga resultat
- Dataförberedelse och förbearbetning är alltid en utmaning.
- Noggrannheten blir lidande när omöjliga, osannolika och ofullständiga värden har matats in som träningsdata
- Om den berörda experten inte är tillgänglig är den andra metoden "brute-force". Det innebär att du måste gissa vilka funktioner (indatavariabler) du ska träna maskinen på, och den gissningen kan vara felaktig.
Fördelar med Supervised Learning
Mot bakgrund av dessa utmaningar är här fördelarna med övervakad maskininlärning:
- Övervakat lärande i Maskininlärning låter dig samla in data eller producera data från tidigare erfarenhet
- Hjälper dig att optimera prestandakriterier med hjälp av erfarenhet
- Övervakad maskininlärning hjälper dig att lösa olika typer av verkliga beräkningsproblem.
Nackdelar med Supervised Learning
Nedan följer nackdelarna med övervakad maskininlärning:
- Beslutsgränsen kan vara övertränad om din träningsuppsättning inte har exempel som du vill ha i en klass.
- Du måste välja ut massor av bra exempel från varje klass medan du tränar klassificeraren.
- Att klassificera stordata kan vara en riktig utmaning.
- Utbildning för övervakat lärande kräver mycket beräkningstid.
Bästa praxis för handledd inlärning
Följande sekvens håller ett projekt på track:
- Innan du gör något annat, bestäm vilken typ av data som ska användas som en träningsuppsättning.
- Bestäm strukturen för den inlärda funktionen och inlärningsalgoritmen.
- Samla in motsvarande resultat antingen från mänskliga experter eller från mätningar
- Håll tillbaka en testuppsättning som modellen aldrig ser och rapportera resultatet på den.
