
Skapa och släpp in INDEX Cassandra
 Redaktionellt team
⚡ Smart sammanfattning
Skapa och släpp index i Cassandra möjliggör filtrering på kolumner som inte ingår i primärnyckeln. Den här sidan behandlar kommandona CREATE INDEX och DROP INDEX, namngivningsregler, tillgängliga indextyper och de fall där ett index är fel svar.
Cassandra Skapa index
Kommandot 'Skapa index' skapar ett index på den kolumn som anges av användaren. Om data redan finns för kolumnen du vill indexera, Cassandra skapar index på data under körningen av "create index"-satsen.
- Efter att ha skapat ett index, Cassandra indexerar nya data automatiskt när data infogas.
- Indexet kan inte skapas på primärnyckeln eftersom en primärnyckel redan är indexerad.
- Index på samlingskolumner stöds med hjälp av formuläret NYCKLAR, VÄRDEN eller POSTER beroende på vad som behöver sökas i.
- Utan indexering på kolumnen, Cassandra kan inte filtrera den kolumnen om det inte är en primärnyckel.
Det är därför, för att filtrera kolumner i Cassandra, index behöver skapas.
syntax
CREATE INDEX IndexName ON KeyspaceName.TableName (ColumnName);
Exempelvis
Här är ögonblicksbilden där man försökte filtrera kolumnen "avd" utan att skapa indexet. Som svar returnerades felet.

Här är ögonblicksbilden där index skapas på avd kolumn.

CREATE INDEX DeptIndex ON University.Student (dept);
Här är ögonblicksbilden där den framgångsrikt kommer att filtreras "avd"-kolumnen.

SELECT * FROM University.Student WHERE dept = 'CS';
Indexnamnet är valfritt. Om du utelämnar det kan du Cassandra generera en automatiskt, vilket är viktigt när indexet senare måste tas bort.
CREATE INDEX IF NOT EXISTS ON University.Student (dept);
Cassandra Släpp index
Kommandot 'Släpp index' sänker det angivna indexet. Om indexnamnet inte gavs när indexet skapades, är indexnamnet Tabellnamn_Kolumnnamn_idx.
- Om indexet inte finns kommer det att returnera ett fel såvida inte IF EXISTS används som returnerar no-op.
- Du måste ange nyckelrymdsnamnet med indexnamnet, annars kommer indexet att sökas efter i det aktuella nyckelrymden.
syntax
DROP INDEX IF EXISTS KeyspaceName.IndexName;
Exempelvis
Här är ögonblicksbilden av det körda kommandot 'Drop index' som släpper index DeptIndex.
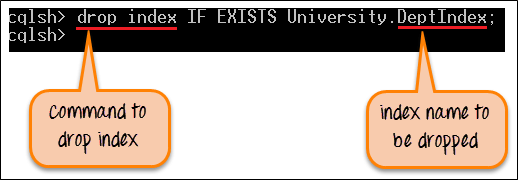
DROP INDEX IF EXISTS University.DeptIndex;
Efter lyckad exekvering av kommandot kommer DeptIndex att tas bort från tangentutrymmet. Nu kan data inte filtreras av kolumnavdelningen.
För att bekräfta vilka index som finns innan släppping ett, beskriv tabellen och läs indexdefinitionerna längst ner i utdata.
DESCRIBE TABLE University.Student;
Typer av index i Cassandra
Kommandot ovan skapar ett standardmässigt sekundärt index, men det finns tre distinkta mekanismer och de beter sig väldigt olika.
| Typ | Hur det fungerar | Bäst för |
|---|---|---|
| Sekundärt index | Varje nod indexerar endast sina egna lokala data, så en fråga utan partitionsnyckel måste kontakta varje nod. | Kolumner med måttlig kardinalitet efterfrågas tillsammans med en partitionsnyckel. |
| SASI-index | Ett bifogat index som stöder matchning av LIKE-prefix och -suffix plus numeriska intervall. | Sökmönster för text. Fortfarande markerade som experimentella, så testa innan produktionsanvändning. |
| Storage Attached Index (SAI) | Introducerad i Cassandra 5.0, som delar en indexstruktur över kolumner med lägre skrivkostnader. | Den moderna ersättningen för båda ovanstående på Cassandra 5 kluster. |
Indexering av en samlingskolumn använder en modifierare som anger vilken del som ska indexeras.
CREATE INDEX ON University.Teacher (VALUES(Email));
CREATE INDEX ON University.Course (KEYS(prereq));
CREATE INDEX ON University.Course (ENTRIES(prereq));
VÄRDEN söker efter elementen i en uppsättning eller lista, NYCKLAR söker efter mappnycklar och ENTRIES matchar ett nyckel- och värdepar tillsammans. Samlingsindexering behandlas vidare i Cassandra samlingar handledning.
När man inte ska använda ett index i Cassandra
Ett sekundärt index är praktiskt men det är inte ett relationsindex, och att använda ett på fel plats är en vanlig orsak till långsamma kluster. Fyra situationer kräver en annan metod.
- Mycket hög kardinalitet. Att indexera något som är nästan unikt, till exempel en e-postadress, innebär att nästan varje partition innehåller en matchande rad, så frågan sprider sig över hela klustret för att returnera en enda post.
- Mycket låg kardinalitet. Att indexera en flagga med två värden, såsom aktiv eller inaktiv, producerar enorma indexpartitioner, och om man läser en av dem returnerar man halva tabellen.
- Ofta uppdaterade kolumner. Varje ändring skriver en indexpost och en tombstone för den gamla, så tombstone-uppbyggnad försämrar läsningarna över tid.
- Frågor utan partitionsnyckel. Utan en sådan måste koordinatorn kontakta varje nod och sammanfoga resultaten, vilket inte skalas allt eftersom noder läggs till.
Det hållbara alternativet är en andra tabell som är nyckelad av den kolumn som behöver sökas, skriven samtidigt som den första. Det följer principen om att fråga först som beskrivs i Cassandra datamodellregler, och den sparar varje läsning till en enda partition på en enda nod.
Som en arbetsregel passar ett index en kolumn med måttlig kardinalitet som efterfrågas tillsammans med en känd partitionsnyckel. Allt utanför den beskrivningen fungerar bättre med en specialbyggd tabell.
