
Cum să înlocuiți valorile lipsă (NA) în R: na.omit & na.rm
 Evelyn Clarke
⚡ Rezumat inteligent
Înlocuirea valorilor lipsă în R acoperă detectarea valorilor NA, eliminarea rândurilor incomplete cu na.omit() și atribuirea mediei sau medianei acestora prin mutate(). Această demonstrație folosește setul de date Titanic, unde atât vârsta, cât și tariful poartă observații lipsă.
Ce sunt valorile lipsă în R?
Valorile lipsă apar atunci când o observație nu are nicio valoare înregistrată într-o coloană sau când un provizoriu nenumeric se află acolo unde ar trebui să fie un număr. Acestea trebuie eliminate sau înlocuite înainte de orice calcul, deoarece majoritatea funcțiilor R returnează NA în momentul în care este prezent unul.
Acest tutorial arată cum se gestionează valorile lipsă cu biblioteca dplyr, parte a ecosistemului tidyverse pentru analiza datelor.
Primul pas este întotdeauna să aflăm câte valori lipsesc și unde.
Cum să detectezi și să numeri valorile lipsă în R
Înainte de a decide ce să faci cu valorile lipsă, trebuie să știi câte sunt și unde se află. R oferă patru verificări, de la un singur răspuns de tip da-sau-nu până la o numărătoare completă pe coloană.
# 1. Is there any NA at all?
anyNA(df_titanic)

# 2. How many in total?
sum(is.na(df_titanic))

# 3. How many per column, the most useful view
colSums(is.na(df_titanic))

# 4. Percentage missing per column
round(colMeans(is.na(df_titanic)) * 100, 1)
Funcția colSums() este cea mai potrivită în practică. Returnează un vector denumit cu un numărător pe coloană, care arată imediat dacă unei variabile îi lipsesc câteva valori sau este în mare parte goală.
Numărarea rândurilor complete. complete.cases() returnează TRUE pentru rândurile fără valori lipsă nicăieri, ceea ce vă spune în avans câte date ar elimina na.omit():
sum(complete.cases(df_titanic))       # rows that would survive
sum(!complete.cases(df_titanic))      # rows that would be dropped
Un avertisment despre substituenți. R recunoaște doar NA. Seturile de date codifică frecvent valorile lipsă ca șir gol, spațiu, „N/A”, „-“ sau un număr santinelă, cum ar fi -99 sau 999. Acestea trec toate verificările de mai sus neobservate. Convertiți-le la import, astfel încât restul fluxului de lucru să se comporte astfel:
df <- read.csv(PATH, na.strings = c("", " ", "NA", "N/A", "-", "-99"))
Scanați întotdeauna intervalul fiecărei coloane numerice după import. O vârstă de -99 sau un tarif de 9999 este mult mai periculoasă decât un NA cinstit, deoarece nicio funcție nu vă va avertiza despre asta.
Tipuri de date lipsă: MCAR, MAR și MNAR
Motivul pentru care lipsește o valoare determină dacă imputarea acesteia este sigură. Statisticienii recunosc trei mecanisme.
- MCAR, dispărut complet la întâmplare. Probabilitatea de a fi dispărut nu are legătură cu nimic, observat sau nu, de exemplu un senzor care se defectează în momente aleatorii.ping sau imputarea acestor rânduri nu introduce nicio prejudecată, ci doar o pierdere de precizie.
- MAR, dispărut la întâmplare. Probabilitatea depinde de alte variabile observate, dar nu de valoarea lipsă în sine. Dacă vârsta pasagerilor mai în vârstă era mai mică, vârsta este MAR, date fiind celelalte coloane. Imputarea care utilizează aceste coloane gestionează bine acest lucru.
- MNAR, dispărut nu la întâmplare. Probabilitatea depinde de valoarea neobservată în sine, de exemplu, persoanele cu venituri mari refuză să își declare veniturile. Nicio metodă de imputare nu poate remedia acest lucru doar pe baza datelor, iar lipsa în sine conține informații care merită înregistrate într-o coloană de semnalizare.
Imputarea mediei, așa cum este utilizată în acest tutorial, este justificabilă doar în cadrul MCAR și MAR simplu. Chiar și în acest caz, are un cost cunoscut: completarea fiecărui gol cu același număr micșorează varianța coloanei și slăbește corelația acesteia cu orice altceva. Pentru lucrări serioase, utilizați o metodă bazată pe model, cum ar fi pachetul mice, și păstrați întotdeauna o coloană cu steguleț care marchează valorile care au fost imputate.
mutare()
mutate() este dplyr verb care creează o variabilă nouă sau suprascrie una existentă, ceea ce îl face instrumentul natural pentru construirea unei copii curățate a unei coloane.
Vom proceda în două părți. Vom învăța cum să:
- exclude valorile lipsă dintr-un cadru de date
- impută valorile lipsă cu media și mediana
Verbul mutate() este foarte ușor de folosit. Putem crea o nouă variabilă urmând această sintaxă:
mutate(df, name_variable_1 = condition, ...)
arguments:
-df: Data frame used to create a new variable
-name_variable_1: Name and the formula to create the new variable
-...: No limit constraint. Possibility to create more than one variable inside mutate()
Excludeți valorile lipsă (NA)
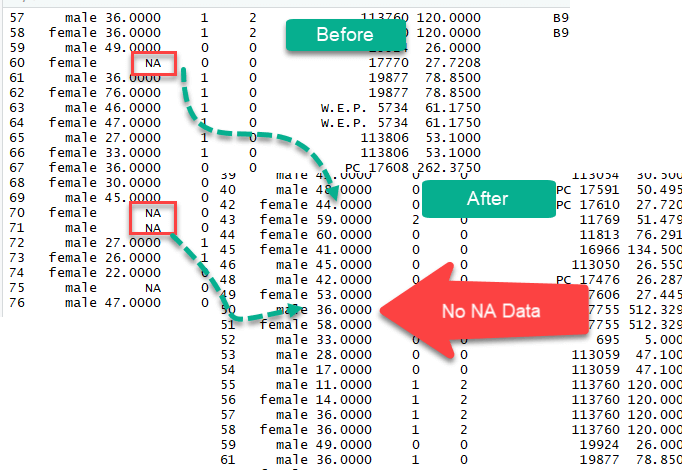
na.omit() este o funcție R de bază, nu un verb dplyr, dar se execută în același mod fără probleme. Elimină fiecare rând care conține cel puțin o valoare NA. Aceasta este cea mai rapidă opțiune și rareori cea mai bună, deoarece o singură valoare lipsă elimină întreaga observație.
Pentru a aborda problema observațiilor lipsă, vom folosi setul de date titan. În acest set de date, avem acces la informațiile pasagerilor aflați la bord în timpul tragediei. Acest set de date are multe NA care trebuie îngrijite.
Încărcați fișierul CSV de pe internet, apoi listați coloanele care conțin NA:
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/test.csv"
df_titanic <- read.csv(PATH, sep = ",")
# Return the column names containing missing observations
list_na <- colnames(df_titanic)[ apply(df_titanic, 2, anyNA) ]
list_na
ieșire:
## [1] "age" "fare"
Aici,
colnames(df_titanic)[apply(df_titanic, 2, anyNA)]
returnează numele coloanelor care conțin cel puțin o valoare lipsă.
Coloanele Vârstă și tarif au valori lipsă.
Le putem arunca cu na.omit().
library(dplyr)
# Exclude the missing observations
df_titanic_drop <-df_titanic %>%
na.omit()
dim(df_titanic_drop)
ieșire:
## [1] 1045 13
Noul set de date conține 1045 de rânduri, comparativ cu 1309 cu setul de date original.
Imputarea datelor lipsă cu media și mediana
De asemenea, puteți imputa, adică popula, valorile lipsă cu media sau mediana. O practică bună este să creați două variabile separate pentru medie și mediană. Odată create, putem înlocui valorile lipsă cu variabilele nou formate.
Vom folosi metoda de aplicare pentru a calcula media coloanei cu NA. Să vedem un exemplu
Pas 1) Mai devreme în tutorial, am stocat numele coloanelor cu valorile lipsă în lista numită list_na. Vom folosi această listă
Pas 2) Calculați media cu argumentul na.rm = TRUE. Acest argument este obligatoriu deoarece coloanele au date lipsă, iar acest lucru îi spune lui R să le ignore.
# Create mean
average_missing <- apply(df_titanic[,colnames(df_titanic) %in% list_na],
      2,
      mean,
      na.rm =  TRUE)
average_missing
Code Explicaţie:
Transmitem 4 argumente în metoda apply.
- df: df_titanic[,colnames(df_titanic) %in% list_na]. Acest cod va returna numele coloanelor din obiectul list_na (adică „vârsta” și „tarifa”)
- 2: Calculați funcția pe coloane
- medie: Calculați media
- na.rm = TRUE: Ignorați valorile lipsă
ieșire:
##      age     fare
## 29.88113 33.29548
Am creat cu succes media coloanelor care conțin observații lipsă. Aceste două valori vor fi folosite pentru a înlocui observațiile lipsă.
Pas 3) Înlocuiți valorile NA
Verbul mutare din biblioteca dplyr este util în crearea unei noi variabile. Nu vrem neapărat să schimbăm coloana originală, astfel încât să putem crea o nouă variabilă fără NA. mutate este ușor de utilizat, alegem doar un nume de variabilă și definim cum să creăm această variabilă. Aici este codul complet
# Create a new variable with the mean and median
df_titanic_replace <- df_titanic %>%
   mutate(replace_mean_age  = ifelse(is.na(age), average_missing[1], age),
   replace_mean_fare = ifelse(is.na(fare), average_missing[2], fare))
Code Explicaţie:
Creăm două variabile, replace_mean_age și replace_mean_fare după cum urmează:
- înlocuiți_vârsta_medie = ifelse(este.na(vârsta), lipsă_medie[1], vârsta)
- replace_mean_fare = ifelse(is.na(fare), average_missing[2],fare)
Dacă vârsta coloanei are valori lipsă, înlocuiți-l cu primul element de average_missing (media vârstei), altfel păstrați valorile originale. Aceeași logică pentru tarif
sum(is.na(df_titanic_replace$age))
ieșire:
## [1] 263
După înlocuire, noua coloană nu conține nicio valoare lipsă:
sum(is.na(df_titanic_replace$replace_mean_age))
ieșire:
## [1] 0
Coloana originală „vârstă” conține 263 de valori lipsă, în timp ce noua coloană „replace_mean_age” le-a completat pe fiecare cu vârsta medie.
Pas 4) Putem înlocui și observațiile lipsă cu mediana.
median_missing <- apply(df_titanic[,colnames(df_titanic) %in% list_na],
      2,
      median,
      na.rm =  TRUE)
df_titanic_replace <- df_titanic %>%
            mutate(replace_median_age  = ifelse(is.na(age), median_missing[1], age),
            replace_median_fare = ifelse(is.na(fare), median_missing[2], fare))
head(df_titanic_replace)
ieșire:

Pas 5) Pe un set de date extins, metoda pas cu pas devine plictisitoare. sapply() restrânge întreaga procedură într-o singură instrucțiune, cu prețul de a nu vedea niciodată valorile imputate.
Sapply nu creează o cadru de date, astfel încât să putem include funcția sapply() în data.frame() pentru a crea un obiect cadru de date.
# Quick code to replace missing values with the mean
df_titanic_impute_mean <- data.frame(
    sapply(
        df_titanic,
        function(x) ifelse(is.na(x),
            mean(x, na.rm = TRUE),
            x)))
Imputare modernă cu replace_na() și across()
Abordările apply() și sapply() de mai sus funcționează în continuare, dar tidyr și dplyr exprimă acum aceleași operații mai sigur și mai ușor de citit.
replace_na() pentru valori fixe. tidyr::replace_na() primește o listă denumită de coloane și înlocuitorii acestora:
library(tidyr)

df_titanic %>%
    replace_na(list(age = 29.88, fare = 33.30))
across() pentru fiecare coloană numerică. Aceasta este înlocuirea directă, sigură din punct de vedere al tipurilor, pentru codul unic sapply() și, spre deosebire de sapply(), nu atinge niciodată coloanele de caractere sau factori:
library(dplyr)

# Mean-impute every numeric column
df_titanic %>%
    mutate(across(where(is.numeric),
                  ~ ifelse(is.na(.x), mean(.x, na.rm = TRUE), .x)))

# Median-impute instead
df_titanic %>%
    mutate(across(where(is.numeric),
                  ~ ifelse(is.na(.x), median(.x, na.rm = TRUE), .x)))
⚠️ De ce este riscantă comanda rapidă sapply(): exemplul sapply() pe o singură linie rulează peste fiecare coloană, inclusiv cele de tip caracter și factor. Apelul mean() pe acestea returnează NA cu un avertisment, iar sapply() forțează apoi întregul rezultat la caracter. Versiunea across(where(is.numeric), …) de mai sus evită complet acest lucru.
coalesce() pentru coloanele de rezervă. Când o a doua coloană poate furniza valoarea lipsă, coalesce() returnează prima intrare care nu lipsește din argumentele sale:
df %>% mutate(age_final = coalesce(age, age_estimated, 0))
Păstrează o evidență a ceea ce ai schimbat. Adăugați un steguleț înainte de imputare, astfel încât orice model ulterior să poată învăța din faptul că o valoare lipsea:
df_titanic %>%
    mutate(age_was_missing = is.na(age),
           age = ifelse(is.na(age), mean(age, na.rm = TRUE), age))
Gestionarea valorilor lipsă în R: Referință pentru metode
Trei abordări sunt abordate în acest tutorial:
- Excludeți toate observațiile lipsă
- Imputați cu media
- Imputați cu mediana
Tabelul de mai jos prezintă pe scurt detectarea și eliminarea:
| Bibliotecă | Obiectiv | Code |
|---|---|---|
| de bază | Enumerați observațiile lipsă |
colnames(df)[apply(df, 2, anyNA)] |
| de bază | Eliminați fiecare rând care conține NA |
na.omit(df) |
Imputarea cu medie sau mediană se poate face în două moduri
- Folosind aplica
- Folosind sapply
| Metodă | Detalii | Avantaje | Dezavantaje |
|---|---|---|---|
| Pas cu pas cu aplica | Verificați coloanele cu lipsă, calculați media/mediana, stocați valoarea, înlocuiți cu mutate() | Puteți vedea media sau mediana imputată | Mai mult timp de execuție. Poate fi lent cu un set de date mare |
| Mod rapid cu sapply | Utilizați sapply() și data.frame() pentru a căuta automat și a înlocui valorile lipsă cu medie/mediană | Cod scurt și rapid | Valorile imputate nu sunt niciodată afișate |
