
R Data Frame: Cum se creează, se adaugă, se selectează și se subsetează
 Evelyn Clarke
⚡ Rezumat inteligent
Frame-ul de date R stochează coloane de diferite tipuri la lungimi egale, ceea ce îl face structura dreptunghiulară standard pentru analiză. Parantezele pătrate secționează rândurile și coloanele, semnul dolar ajunge la o coloană, iar subset() filtrează după condiție.
Ce este un cadru de date?
A cadru de date este o listă de vectori de lungime egală. O matrice conține un singur tip de date, în timp ce un cadru de date acceptă diferite tipuri de date (numerice, de caractere, factoriale etc.).
Această definiție plasează cadrul de date între doi vecini pe care îi veți întâlni constant în R. A matrice este dreptunghiulară, dar cu un singur tip și a listă este multi-tipizat, dar neuniform. Cadrul de date împrumută câte o proprietate de la fiecare.
| Structure | Tipuri de coloane | Lungimile elementelor | Utilizare tipică |
|---|---|---|---|
| Vector | Un singur tip | Secvență unică | O variabilă |
| Matrice | Un singur tip | Dreptunghiular | Algebră numerică |
| Listă | Orice amestec de tipuri | Poate diferi în funcție de element | Colecții arbitrare |
| Cadrul de date | Orice amestec de tipuri | Fiecare coloană de lungime egală | Analiză tabelară |
Deoarece un cadru de date este de fapt o listă dedesubt, accesorii utilizați în liste funcționează și aici, motiv pentru care semnul dolar apare din nou mai târziu în acest tutorial.
Cum se creează un cadru de date
Putem crea un cadru de date în R prin transmiterea variabilelor a, b, c și d în funcția data.frame(). Putem crea cadrul de date și denumi coloanele cu names(), specificând pur și simplu numele fiecărei variabile.
data.frame(df, stringsAsFactors = TRUE)
Argumente:
- df: Poate fi o matrice de convertit ca un cadru de date sau o colecție de variabile de alăturat
- stringsAsFactorsControlează dacă vectorii de caractere devin coloane de factori. Valoarea implicită din fabrică era TRUE în versiunile mai vechi și a fost FALSE începând cu R 4.0.0, așadar transmiteți-o explicit atunci când comportamentul contează.
Putem crea un cadru de date în R pentru primul nostru set de date combinând patru variabile de aceeași lungime.
# Create a, b, c, d variables
a <- c(10,20,30,40)
b <- c('book', 'pen', 'textbook', 'pencil_case')
c <- c(TRUE,FALSE,TRUE,FALSE)
d <- c(2.5, 8, 10, 7)
# Join the variables to create a data frame
df <- data.frame(a,b,c,d)
df
ieșire:
##     a         b     c     d
## 1  10        book  TRUE   2.5
## 2  20         pen  FALSE  8.0
## 3  30    textbook  TRUE   10.0
## 4  40 pencil_case  FALSE  7.0
Fiecare vector a devenit o coloană, iar cele patru valori din fiecare vector au devenit cele patru rânduri. Rețineți că argumentele nu aveau nume, așa că R a derivat anteturile coloanelor din numele variabilelor în sine.
Putem vedea că anteturile coloanei au același nume ca și variabilele. Putem schimba numele coloanei în R cu funcția names(). Verificați exemplul R create dataframe de mai jos:
# Name the data frame
names(df) <- c('ID', 'items', 'store', 'price')
df
ieșire:
##   ID       items store price
## 1 10        book  TRUE   2.5
## 2 20         pen FALSE   8.0
## 3 30    textbook  TRUE  10.0
## 4 40 pencil_case FALSE   7.0
Atribuirea funcției `names()` înlocuiește fiecare antet simultan, deci vectorul de înlocuire trebuie să aibă exact o intrare pe coloană. Pentru a redenumi o singură coloană, indexați vectorul `names`, ca în `names(df)[2] <- 'product'`.
# Print the structure
str(df)
ieșire:
## 'data.frame':    4 obs. of  4 variables:
##  $ ID   : num  10 20 30 40
##  $ items: Factor w/ 4 levels "book","pen","pencil_case",..: 1 2 4 3
##  $ store: logi  TRUE FALSE TRUE FALSE
##  $ price: num  2.5 8 10 7
Notă privind versiunea. Rezultatul de mai sus a fost produs pe o versiune R mai veche decât 4.0.0, unde data.frame() convertia vectorii de caractere în factori în mod implicit, motiv pentru care items sunt raportați ca Factor cu patru niveluri. Documentația R de bază consemnează că această versiune implicită, nouă din fabrică schimbat în stringsAsFactors = FALSE pentru R 4.0.0Rularea aceluiași cod pe o versiune curentă lasă elementele ca o coloană de caractere simple, iar str() afișează în schimb chr. Adăugați stringsAsFactors = TRUE la apelul data.frame() pentru a reproduce ieșirea afișată sau pentru a citi tutorialul factorilor pentru momentul în care factorii sunt într-adevăr necesari.
Secționează cadru de date
Odată ce cadrul este construit, următoarea sarcină este extragerea unor părți din acesta. Secționarea este metoda de bază în R pentru a face acest lucru și folosește aceleași paranteze pătrate ca și vectorii, doar cu două poziții în loc de una.
Este posibilă felierea valorilor unui cadru de date. Selectăm rândurile și coloanele care vor fi returnate între paranteze precedate de numele cadrului de date.
Un cadru de date este compus din rânduri și coloane, df[A, B]. A reprezintă rândurile și B coloanele. Putem tăia fie prin specificarea rândurilor și/sau coloanelor.
Din imaginea 1 de mai jos, partea din stânga reprezintă rânduri, iar partea dreaptă este coloane. Rețineți că simbolul : înseamnă la. De exemplu, 1:3 intenționează să selecteze valori din 1 la 3.

În diagrama de mai jos arătăm cum se accesează diferitele selecții ale cadrului de date:
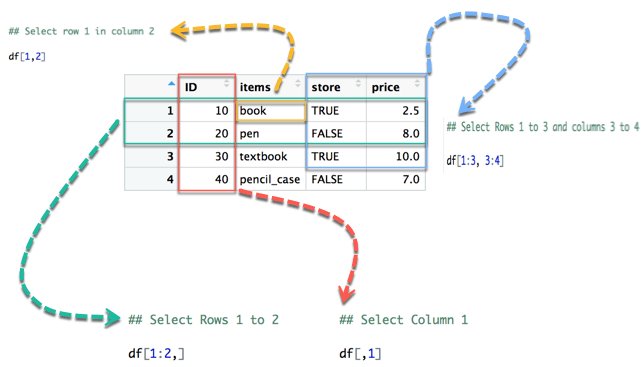
- Săgeata galbenă selectează rând 1 în coloană 2
- Săgeata verde selectează rânduri 1 la 2
- Săgeata roșie selectează coloană 1
- Săgeata albastră selectează rânduri 1 până în 3 și coloane 3 la 4
Rețineți că, dacă lăsăm partea stângă goală, R va selecta toate rândurile. Prin analogie, dacă lăsăm partea dreaptă goală, R va selecta toate coloanele.
Putem rula codul în consolă:
## Select row 1 in column 2
df[1,2]
ieșire:
## [1] book
## Levels: book pen pencil_case textbook
Linia Niveluri apare deoarece elementele reprezintă un factor în această sesiune. În R 4.0.0 și versiunile ulterioare, același apel afișează șirul unic „book” fără nicio linie Niveluri.
## Select Rows 1 to 2
df[1:2,]
ieșire:
##   ID items store price
## 1 10  book  TRUE   2.5
## 2 20   pen FALSE   8.0
## Select Columns 1
df[,1]
ieșire:
## [1] 10 20 30 40
Selectarea unei singure coloane cu df[,1] elimină wrapper-ul cadrului și returnează un vector simplu. Adăugați drop = FALSE, ca în df[, 1, drop = FALSE], atunci când este nevoie de un cadru de date pe o singură coloană.
## Select Rows 1 to 3 and columns 3 to 4
df[1:3, 3:4]
ieșire:
##   store price
## 1  TRUE   2.5
## 2 FALSE   8.0
## 3  TRUE  10.0
De asemenea, este posibil să selectați coloanele cu numele lor. De exemplu, codul de mai jos extracAre două coloane: ID și magazin.
# Slice with columns name
df[, c('ID', 'store')]
ieșire:
##   ID store
## 1 10  TRUE
## 2 20 FALSE
## 3 30  TRUE
## 4 40 FALSE
Numele sunt mai sigure decât pozițiile în codul de producție, deoarece inserarea sau reordonarea unei coloane modifică silențios la ce se referă df[, 3] în timp ce df[, 'store'] indică în mod constant aceleași date.
Adăugați o coloană la cadrul de date
De asemenea, puteți adăuga o coloană la un Data Frame. Trebuie să utilizați simbolul $ pentru a denumi noua variabilă și a adăuga o coloană la un dataframe în R.
# Create a new vector
quantity <- c(10, 35, 40, 5)

# Add `quantity` to the `df` data frame
df$quantity <- quantity
df
ieșire:
##   ID       items store price quantity
## 1 10        book  TRUE   2.5       10
## 2 20         pen FALSE   8.0       35
## 3 30    textbook  TRUE  10.0       40
## 4 40 pencil_case FALSE   7.0        5
Notă: Numărul de elemente din vector trebuie să fie egal cu numărul de elemente din cadrul de date. Executați următoarea instrucțiune pentru a adăuga o coloană la cadrul de date în R
quantity <- c(10, 35, 40)
# Add `quantity` to the `df` data frame
df$quantity <- quantity
Dă eroare:
Error in `lt;-.data.frame`(`*tmp*`, quantity, value = c(10, 35, 40))
replacement has 3 rows, data has 4
Mesajul denumește operatorul de înlocuire pentru cadrele de date și indică ambele numărătoare, deci vă spune exact ce trebuie corectat. R reciclează o înlocuire doar atunci când lungimea sa împarte în mod egal numărul de rânduri, motiv pentru care o valoare de lungime 1, cum ar fi df$currency <- 'EUR', este acceptată, în timp ce un vector de lungime 3 pentru patru rânduri este refuzat. cbind() adaugă o coloană în același mod, iar rbind() este omologul său pentru adăugarea de rânduri.
Selectați o coloană a unui cadru de date
Uneori, trebuie să stocăm o coloană dintr-un cadru de date pentru utilizare ulterioară sau să efectuăm o operație asupra unei coloane. Putem folosi semnul $ pentru a selecta coloana dintr-un cadru de date.
# Select the column ID
df$ID
ieșire:
## [1] 1 2 3 4
Citiți cu atenție rezultatul. ID-ul a fost construit din vectorul c(10, 20, 30, 40), deci o consolă live afișează aici 10 20 30 40; valorile 1 2 3 4 de mai sus sunt pozițiile pe rând, nu valorile stocate. [1] de la începutul liniei este pur și simplu indexul primului element de pe acea linie, nu face parte din date.
Trei rute ajung la aceeași coloană: df$ID, df[['ID']] și df[, 'ID']. Semnul dolar efectuează o potrivire parțială, deci df$I ar găsi în continuare ID-ul, ceea ce este convenabil în consolă și riscant într-un script salvat.
Subset un cadru de date
În secțiunea anterioară, am selectat o întreagă coloană fără condiție. Este posibil să submult pe baza faptului că o anumită condiție era sau nu adevărată.
Folosim funcția subset().
subset(x, condition)
arguments:
- x: data frame used to perform the subset
- condition: define the conditional statement
Dorim să returnăm doar articolele cu un preț mai mare de 5, așa că putem face:
# Select price above 5
subset(df, subset = price > 5)
ieșire:
ID       items store price
2 20         pen FALSE     8
3 30    textbook  TRUE    10
4 40 pencil_case FALSE     7
Etichetele rândurilor 2, 3 și 4 sunt numele originale ale rândurilor preluate de la df, așa se poate spune că primul rând a fost filtrat. subset() acceptă, de asemenea, un argument select pentru alegerea simultană a coloanelor, iar forma echivalentă de paranteze este df[df$price > 5, ]. Forma de paranteze păstrează NA rânduri unde condiția lipsește, în timp ce subset() le elimină, deci cele două nu sunt întotdeauna interschimbabile.
