
Tutorial de regresie liniară cu TensorFlow [Exemple]
 Echipa editorială
⚡ Rezumat inteligent
Regresia liniară în TensorFlow modelează relația dintre caracteristicile numerice și o valoare țintă continuă. Această demonstrație antrenează un predictor al prețurilor locuințelor din Boston în trei moduri separate, folosind Pandas, NumPy și conductele de intrare native TensorFlow cu estimatorul LinearRegressor.
Ce este regresia liniară?
linear Regression este o abordare în statistică pentru modelarea relațiilor dintre două variabile. Această modelare se realizează între un răspuns scalar și una sau mai multe variabile explicative. Relația cu o variabilă explicativă se numește regresie liniară simplă, iar cu mai multe variabile explicative se numește regresie liniară multiplă.
TensorFlow oferă instrumente pentru a avea control deplin asupra calculelor. Acest lucru se face cu API-ul de nivel scăzut. În plus, TensorFlow este echipat cu o gamă largă de API-uri pentru a realiza multe masina de învățare algoritmi. Aceasta este API-ul de nivel înalt, iar TensorFlow le numește estimatori.
- API de nivel scăzutConstruiți arhitectura și optimizarea modelului de la zero. Este complicat pentru un începător.
- API de nivel înaltDefiniți algoritmul. Este ușor de utilizat. TensorFlow oferă o cutie de instrumente numită estimator pentru a construi, antrena, evalua și face o predicție.
În acest tutorial, veți folosi numai estimatoriCalculele sunt mai rapide și mai ușor de implementat. Prima parte explică modul de utilizare a optimizatorului de descreștere a gradientului pentru a antrena o regresie liniară în TensorFlow. Într-o a doua parte, veți utiliza setul de date Boston pentru a prezice prețul unei case folosind un estimator TensorFlow.
Cum se antrenează un model de regresie liniară
Înainte de a începe antrenarea modelului, să vedem ce este de fapt o regresie liniară.
Imaginează-ți că ai două variabile, x și y, iar sarcina ta este să prezici valoarea lui y cunoscând valoarea lui x. Dacă reprezinți grafic datele, poți observa o relație pozitivă între variabila independentă, x, și variabila dependentă, y, așa cum arată diagrama de dispersie de mai jos.

Puteți observa că dacă x = 1, y va fi aproximativ egal cu 6, iar dacă x = 2, y va fi în jur de 8.5.
Aceasta nu este o metodă foarte precisă și este predispusă la erori, mai ales în cazul unui set de date care conține sute de mii de puncte.
O regresie liniară este evaluată cu o ecuație. Variabila y este explicată prin una sau mai multe covariabile. În exemplul dvs., există o singură variabilă dependentă. Dacă trebuie să scrieți această ecuație, va fi:

Cu:
 este tendința. Adică, dacă x=0, y=
 este greutatea asociată cu x
 este reziduul sau eroarea modelului. Include ceea ce modelul nu poate învăța din date
Imaginați-vă că vă potriviți modelul și găsiți următoarea soluție pentru:
- = 3.8
- = 2.78
Puteți înlocui acele numere în ecuație și devine:
y= 3.8 + 2.78x
Acum aveți o modalitate mai bună de a găsi valorile pentru y. Adică, puteți înlocui x cu orice valoare doriți pentru a prezice y. În imaginea de mai jos, am înlocuit x în ecuație cu toate valorile din setul de date și am reprezentat grafic rezultatul.

Linia roșie reprezintă valoarea ajustată, adică valorile lui y pentru fiecare valoare a lui x. Nu este nevoie să vedeți valoarea lui x pentru a prezice y; pentru fiecare x există o valoare care aparține liniei roșii. De asemenea, puteți prezice valori ale lui x mai mari de 2.
Dacă doriți să extindeți regresia liniară la mai multe covariate, puteți face acest lucru adăugând mai multe variabile la model. Diferența dintre analiza tradițională și regresia liniară este că regresia liniară analizează modul în care y va reacționa pentru fiecare variabilă x luată independent.
Să vedem un exemplu. Imaginați-vă că doriți să preziceți vânzările unei gelaterii. Setul de date conține diferite informații, cum ar fi vremea (ploios, însorit, înnorat) și informații despre clienți (salariu, sex, stare civilă).
Analiza tradițională va încerca să prezică vânzarea, să zicem, calculând media pentru fiecare variabilă și încercând să estimeze vânzarea pentru diferite scenarii. Aceasta va duce la predicții slabe și va restricționa analiza la scenariul ales.
Dacă utilizați regresia liniară, puteți scrie această ecuație:
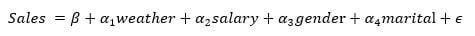
Algoritmul va găsi cea mai bună soluție pentru ponderi; asta înseamnă că va încerca să minimizeze costul, care este diferența dintre linia ajustată și punctele de date.
Cum funcționează algoritmul
Diagrama de mai jos rezumă bucla pe care o repetă algoritmul: alegerea ponderilor, prezicerea lui y, măsurarea erorii și corectarea ponderilor.

Algoritmul va alege un număr aleatoriu pentru fiecare  și
 și înlocuiți valoarea lui x pentru a obține valoarea prezisă a lui y. Dacă setul de date are 100 de observații, algoritmul calculează 100 de valori prezise.
Putem calcula eroarea, a notat  , a modelului, care este diferența dintre valoarea prezisă și valoarea reală. O eroare pozitivă înseamnă că modelul subestimează predicția lui y, iar o eroare negativă înseamnă că modelul supraestimează predicția lui y.

Scopul tău este să minimizezi pătratul erorii. Algoritmul calculează media erorii pătratice. Acest pas se numește minimizarea erorii. Pentru regresia liniară, aceasta este Eroare pătrată medie, numit și MSE. Din punct de vedere matematic, este:

Unde:
 sunt greutățile, deci
 se referă la valoarea prezisă
- y este valorile reale
- m este numărul de observații
 se referă la valoarea prezisă
Rețineți că  înseamnă că folosește transpunerea matricelor. The
 este notația matematică a mediei.
Scopul este de a găsi cel mai bun  care minimizează MSE-ul.
Dacă eroarea medie este mare, înseamnă că modelul are performanțe slabe și greutățile nu sunt alese corect. Pentru a corecta greutățile, trebuie să utilizați un optimizator. Optimizatorul tradițional este numit Coborâre în gradient.
Coborârea gradientului preia derivata și scade sau crește ponderea. Dacă derivata este pozitivă, ponderea scade. Dacă derivata este negativă, ponderea crește. Modelul va actualiza ponderile și va recalcula eroarea. Acest proces se repetă până când eroarea nu se mai modifică. Fiecare trecere se numește... repetareÎn plus, gradienții sunt înmulțiți cu o rată de învățare, care indică viteza învățării.
Dacă rata de învățare este prea mică, va dura foarte mult până când algoritmul va converge, deoarece necesită mult mai multe iterații. Dacă rata de învățare este prea mare, algoritmul s-ar putea să nu convergă niciodată. Curba de pierderi de mai jos reprezintă grafic eroarea în funcție de numărul de iterații pentru acest set de date.

Puteți observa din imaginea de mai sus că modelul repetă procesul de aproximativ 20 de ori înainte de a găsi o valoare stabilă pentru ponderi, atingând astfel cea mai mică eroare.
Rețineți că eroarea nu este egală cu zero, ci se stabilizează în jurul valorii de 5. Aceasta înseamnă că modelul face o eroare tipică de 5. Dacă doriți să reduceți eroarea, trebuie să adăugați mai multe informații la model, cum ar fi mai multe variabile sau să utilizați estimatori diferiți.
Îți amintești prima ecuație:

Ponderile finale sunt 3.8 și 2.78. Videoclipul de mai jos vă arată cum coborârea în gradient optimizează funcția de pierdere pentru a găsi aceste ponderi.
Cum să antrenezi o regresie liniară cu TensorFlow
Acum că înțelegeți mai bine ce se întâmplă în spatele capotei, sunteți gata să utilizați API-ul estimator furnizat de TensorFlow pentru a antrena prima regresie liniară folosind TensorFlow.
Notă privind versiunea: Fluxul de lucru al estimatorului prezentat mai jos a fost scris pentru TensorFlow 1.x și versiunile timpurii 2.x. TensorFlow a marcat tf.estimator și tf.feature_column API-urile au fost complet depreciate în versiunea 2.12 și au fost eliminate Estimators în versiunea 2.16. La o instalare curentă, rulați acest cod într-un TensorFlow 1.15 sau 2.x-with-tf.compat.v1 mediu sau să îl portezi la Keras, unde tf.keras.layers.Dense(1) plus straturile de preprocesare înlocuiesc LinearRegressor și coloanele de caracteristici. Conceptele - caracteristici, etichete, loturi, epoci, MSE și coborâre în gradient - rămân neschimbate.
Veți utiliza setul de date Boston, care include următoarele variabile.
| Variabil | Descriere |
| crim | rata criminalității pe cap de locuitor pe oraș |
| zn | proporție de teren rezidențial zonat pentru loturi de peste 25,000 sq.ft. |
| Indus | proporția de hectare comerciale non-retail pe oraș. |
| nox | concentrația de oxizi nitrici |
| rm | numărul mediu de camere pe locuință |
| vârstă | proporția de unități ocupate de proprietar construite înainte de 1940 |
| spune | distanțe ponderate până la cinci centre de angajare din Boston |
| impozit | cota de impozit pe proprietate la valoarea întreagă pe 10,000 de dolari |
| ptratio | raportul elev-profesor pe oraș |
| medv | Valoarea medie a caselor ocupate de proprietari în mii de dolari |
Veți crea trei seturi de date diferite:
| date CCD | obiectiv | forma |
| Pregătire | Antrenați modelul și obțineți greutățile | 400, 10 |
| Evaluare | Evaluați performanța modelului pe date nevăzute | 100, 10 |
| prezice | Utilizați modelul pentru a estima valoarea casei pe date noi | 6, 10 |
Obiectivul este de a utiliza caracteristicile setului de date pentru a prezice valoarea casei.
În a doua parte a tutorialului, veți învăța cum să utilizați TensorFlow în trei moduri diferite de a importa datele:
- Cu panda
- cu NumPy
- Doar TensorFlow
Rețineți că toate cele trei opțiuni oferă aceleași rezultate.
Vei învăța cum să utilizezi API-ul de nivel înalt pentru a construi, antrena și evalua un model de regresie liniară TensorFlow. Dacă ai utiliza API-ul de nivel scăzut, ar trebui să definești manual:
- Funcția de pierdere
- Optimizator: coborâre în gradient
- Înmulțirea matricelor
- Grafic și tensor
Acest lucru este plictisitor și mai complicat pentru un începător.
Soluția Pandas
Trebuie să importați bibliotecile necesare pentru a antrena modelul.
import pandas as pd
from sklearn import datasets
import tensorflow as tf
import itertools
Pas 1) Importă datele cu ursi panda.
Definești numele coloanelor și le stochezi în COLUMNS. Poți folosi pd.read_csv() pentru a importa datele.
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
           "dis", "tax", "ptratio", "medv"]
Îndreptați fiecare apel către fișierele CSV pe care le-ați descărcat anterior.
training_set = pd.read_csv("E:/boston_train.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
test_set = pd.read_csv("E:/boston_test.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
prediction_set = pd.read_csv("E:/boston_predict.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
Puteți imprima forma datelor.
print(training_set.shape, test_set.shape, prediction_set.shape)
producție
(400, 10) (100, 10) (6, 10)
Rețineți că eticheta, adică y-ul dvs., este inclusă în setul de date. Prin urmare, trebuie să definiți alte două liste: una care conține doar caracteristicile și una care conține doar numele etichetei. Aceste două liste îi vor spune estimatorului dvs. care sunt caracteristicile din setul de date și care nume de coloană este eticheta.
Se face cu codul de mai jos.
FEATURES = ["crim", "zn", "indus", "nox", "rm",
                 "age", "dis", "tax", "ptratio"]
LABEL = "medv"
Pas 2) Convertiți datele
Trebuie să convertiți variabilele numerice în formatul corect. TensorFlow oferă o metodă pentru a converti o variabilă continuă: tf.feature_column.numeric_column().
În pasul anterior, ați definit o listă de caracteristici pe care doriți să le includeți în model. Acum puteți utiliza această listă pentru a le converti în date numerice. Dacă doriți să excludeți caracteristici din model, puteți elimina una sau mai multe variabile din lista FEATURES înainte de a construi feature_cols.
Rețineți că veți folosi un Python înțelegerea listei cu lista FEATURES pentru a crea o listă nouă numită feature_cols. Acest lucru vă ajută să evitați scrierea funcției tf.feature_column.numeric_column() de nouă ori. O înțelegere a listei este o modalitate mai rapidă și mai curată de a crea liste noi.
feature_cols = [tf.feature_column.numeric_column(k) for k in FEATURES]
Pas 3) Definiți estimatorul
În acest pas, trebuie să definiți estimatorul. TensorFlow oferă șase estimatori predefiniti, trei pentru sarcini de clasificare și trei pentru sarcini de regresie TensorFlow:
- Regressor
- DNNRegressor
- LinearRegressor
- Regresor combinat liniar DNNLiner
- clasifica
- DNNClassifier
- Clasificator liniar
- DNNLinearCombinedClassifier
În acest tutorial, veți folosi Linear Regressor. Pentru a accesa această funcție, trebuie să utilizați tf.estimator.
Funcția are nevoie de două argumente:
- feature_columns: conține variabilele de inclus în model
- model_dir: calea pentru stocarea graficului, salvarea parametrilor modelului și așa mai departe
TensorFlow va crea automat un folder numit train în directorul de lucru. Trebuie să utilizați această cale pentru a accesa TensorBoard, așa cum se arată în exemplul de regresie TensorFlow de mai jos.
estimator = tf.estimator.LinearRegressor(
        feature_columns=feature_cols,
        model_dir="train")
producție
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a215dc550>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Partea dificilă cu TensorFlow este modul de alimentare a modelului. TensorFlow este conceput să funcționeze cu calcul paralel și seturi de date foarte mari. Din cauza limitării resurselor mașinii, este imposibil să se alimenteze modelul cu toate datele simultan. Pentru aceasta, trebuie să se alimenteze un lot de date de fiecare dată. Rețineți că vorbim despre seturi de date uriașe, cu milioane sau mai multe înregistrări. Dacă nu adăugați un lot, veți ajunge să aveți o eroare de memorie.
De exemplu, dacă datele dumneavoastră conțin 100 de observații și definiți o dimensiune a lotului de 10, înseamnă că modelul va vedea 10 observații pentru fiecare iterație (10*10).
Când modelul a văzut toate datele, acesta termină o epocă. O epocă definește de câte ori doriți ca modelul să vadă datele. Este mai bine să setați acest pas la zero și să lăsați modelul să efectueze un număr stabilit de iterații.
O a doua informație de adăugat este dacă doriți să amestecați datele înainte de fiecare iterație. În timpul antrenamentului, este important să amestecați datele astfel încât modelul să nu învețe un anumit model al setului de date. Dacă modelul învață detaliile modelului subiacent al datelor, va avea dificultăți în generalizarea predicției pentru datele nevăzute. Aceasta se numește supraadaptare. Modelul are performanțe bune pe datele de antrenament, dar nu poate prezice corect pentru datele nevăzute.
TensorFlow simplifică acești doi pași. Când datele ajung în canal, știe de câte observații are nevoie (în lot) și dacă trebuie să amestece datele.
Pentru a instrui TensorFlow cum să alimenteze modelul, puteți utiliza pandas_input_fn. Acest obiect are nevoie de cinci parametri:
- x: date caracteristice
- y: date de etichetă
- batch_size: lot. Implicit 128
- num_epoch: numărul de epoci, implicit 1
- amestecare: amestecă datele sau nu. În mod implicit, Niciuna
Trebuie să alimentați modelul de mai multe ori, așa că definiți o funcție pentru a repeta acest proces. Apelați această funcție get_input_fn.
def get_input_fn(data_set, num_epochs=None, n_batch = 128, shuffle=True):
         return tf.estimator.inputs.pandas_input_fn(
         x=pd.DataFrame({k: data_set[k].values for k in FEATURES}),
         y = pd.Series(data_set[LABEL].values),
         batch_size=n_batch,
         num_epochs=num_epochs,
         shuffle=shuffle)
Metoda obișnuită de evaluare a performanței unui model este:
- Antrenează modelul
- Evaluați modelul pe un set de date diferit
- Faceți o predicție
Estimatorul TensorFlow oferă trei funcții diferite pentru a realiza cu ușurință acești trei pași.
Pas 4) Antrenează modelul
Puteți utiliza metoda trenului de estimatori pentru a ajusta modelul. Estimatorul trenului are nevoie de un input_fn și de un număr de pași. Puteți utiliza funcția creată mai sus pentru a alimenta modelul. Apoi, instruiți modelul să iterateze de 1000 de ori. Rețineți că nu specificați numărul de epoci; lăsați modelul să iterateze de 1000 de ori. Dacă setați numărul de epoci la 1, atunci modelul va itera de patru ori, deoarece există 400 de înregistrări în setul de antrenament, iar dimensiunea lotului este de 128:
- 128 de rânduri
- 128 de rânduri
- 128 de rânduri
- 16 de rânduri
Prin urmare, este mai ușor să setezi numărul de epoci la zero și să definești numărul de iterații, așa cum se arată în exemplul de clasificare TensorFlow de mai jos.
estimator.train(input_fn=get_input_fn(training_set,
                                           num_epochs=None,
                                           n_batch = 128,
                                           shuffle=False),
                                           steps=1000)
producție
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 238.616
INFO:tensorflow:loss = 13909.657, step = 101 (0.420 sec)
INFO:tensorflow:global_step/sec: 314.293
INFO:tensorflow:loss = 12881.449, step = 201 (0.320 sec)
INFO:tensorflow:global_step/sec: 303.863
INFO:tensorflow:loss = 12391.541, step = 301 (0.327 sec)
INFO:tensorflow:global_step/sec: 308.782
INFO:tensorflow:loss = 12050.5625, step = 401 (0.326 sec)
INFO:tensorflow:global_step/sec: 244.969
INFO:tensorflow:loss = 11766.134, step = 501 (0.407 sec)
INFO:tensorflow:global_step/sec: 155.966
INFO:tensorflow:loss = 11509.922, step = 601 (0.641 sec)
INFO:tensorflow:global_step/sec: 263.256
INFO:tensorflow:loss = 11272.889, step = 701 (0.379 sec)
INFO:tensorflow:global_step/sec: 254.112
INFO:tensorflow:loss = 11051.9795, step = 801 (0.396 sec)
INFO:tensorflow:global_step/sec: 292.405
INFO:tensorflow:loss = 10845.855, step = 901 (0.341 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Puteți verifica TensorBoard cu următoarea comandă:
activate hello-tf
# For MacOS
tensorboard --logdir=./train
# For Windows
tensorboard --logdir=train
Pas 5) Evaluează-ți modelul
Puteți evalua potrivirea modelului dvs. pe setul de testare cu codul de mai jos:
ev = estimator.evaluate(
          input_fn=get_input_fn(test_set,
          num_epochs=1,
          n_batch = 128,
          shuffle=False))
producție
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
Puteți imprima pierderea cu codul de mai jos:
loss_score = ev["loss"]
print("Loss: {0:f}".format(loss_score))
producție
Loss: 3215.895996
Modelul are o pierdere de 3215. Puteți verifica statisticile rezumative pentru a vă face o idee despre cât de mare este eroarea.
training_set['medv'].describe()
producție
count    400.000000
mean      22.625500
std        9.572593
min        5.000000
25%       16.600000
50%       21.400000
75%       25.025000
max       50.000000
Name: medv, dtype: float64
Din statistica rezumativă de mai sus, știți că prețul mediu pentru o casă este de 22 de mii, cu un preț minim de 5 mii și un maxim de 50 de mii. Deoarece pierderea raportată este eroarea medie pătratică, eroarea tipică în unitățile originale este aproximativ rădăcina pătrată din 32.16, ceea ce reprezintă aproximativ 5.7 mii de dolari.
Pas 6) Faceți predicția
În cele din urmă, puteți utiliza metoda de predicție a estimatorului TensorFlow pentru a estima valoarea a șase case din Boston.
y = estimator.predict(
         input_fn=get_input_fn(prediction_set,
         num_epochs=1,
         n_batch = 128,
         shuffle=False))
Pentru a afișa valorile estimate, puteți utiliza acest cod:
predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
producție
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.96125], dtype=float32), array([27.270979], dtype=float32), array([29.299236], dtype=float32), array([16.436684], dtype=float32), array([21.460876], dtype=float32)]
Modelul prognozează următoarele valori:
| casă | Prezicere |
| 1 | 32.29 |
| 2 | 18.96 |
| 3 | 27.27 |
| 4 | 29.29 |
| 5 | 16.43 |
| 6 | 21.46 |
Rețineți că nu cunoaștem adevărata valoare a acestor șase case. În tutorialul de deep learning, veți încerca să depășiți modelul liniar.
Soluția NumPy
Această secțiune explică modul de antrenare a modelului folosind un estimator NumPy pentru a alimenta datele. Metoda este aceeași, cu excepția faptului că veți utiliza estimatorul numpy_input_fn.
Citește aceleași trei fișiere CSV, dar păstrează doar matricele NumPy brute cu .values.
training_set_n = pd.read_csv("E:/boston_train.csv").values
test_set_n = pd.read_csv("E:/boston_test.csv").values
prediction_set_n = pd.read_csv("E:/boston_predict.csv").values
Pas 1) Importă datele
În primul rând, trebuie să diferențiezi variabilele caracteristice de etichetă. Trebuie să faci acest lucru pentru datele de antrenament și datele de evaluare. Este mai rapid să definești o funcție pentru a diviza datele.
def prepare_data(df):
        X_train = df[:, :-3]
        y_train = df[:,-3]
        return X_train, y_train
Puteți utiliza funcția pentru a separa eticheta de caracteristicile trenului și a evalua seturile de date.
X_train, y_train = prepare_data(training_set_n)
X_test, y_test = prepare_data(test_set_n)
Trebuie să excludeți ultima coloană a setului de date de predicție, deoarece aceasta conține doar NaN.
x_predict = prediction_set_n[:, :-2]
Confirmați forma matricei. Rețineți că eticheta nu trebuie să aibă o a doua dimensiune, ceea ce înseamnă (400,).
print(X_train.shape, y_train.shape, x_predict.shape)
producție
(400, 9) (400,) (6, 9)
Puteți construi coloanele de caracteristici după cum urmează:
feature_columns = [ tf.feature_column.numeric_column('x', shape=X_train.shape[1:])]
Estimatorul este definit ca înainte: specificați coloanele de caracteristici și locul unde se salvează graficul.
estimator = tf.estimator.LinearRegressor(
         feature_columns=feature_columns,
         model_dir="train1")
producție
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train1', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a218d8f28>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Puteți utiliza estimatorul NumPy pentru a introduce datele în model și apoi pentru a antrena modelul. Rețineți că definim funcția input_fn în prealabil pentru a facilita lizibilitatea.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
           x={"x": X_train},
           y=y_train,
           batch_size=128,
           shuffle=False,
           num_epochs=None)
estimator.train(input_fn = train_input,steps=5000)
producție
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train1/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 490.057
INFO:tensorflow:loss = 13909.656, step = 101 (0.206 sec)
INFO:tensorflow:global_step/sec: 788.986
INFO:tensorflow:loss = 12881.45, step = 201 (0.126 sec)
INFO:tensorflow:global_step/sec: 736.339
INFO:tensorflow:loss = 12391.541, step = 301 (0.136 sec)
INFO:tensorflow:global_step/sec: 383.305
INFO:tensorflow:loss = 12050.561, step = 401 (0.260 sec)
INFO:tensorflow:global_step/sec: 859.832
INFO:tensorflow:loss = 11766.133, step = 501 (0.117 sec)
INFO:tensorflow:global_step/sec: 804.394
INFO:tensorflow:loss = 11509.918, step = 601 (0.125 sec)
INFO:tensorflow:global_step/sec: 753.059
INFO:tensorflow:loss = 11272.891, step = 701 (0.134 sec)
INFO:tensorflow:global_step/sec: 402.165
INFO:tensorflow:loss = 11051.979, step = 801 (0.248 sec)
INFO:tensorflow:global_step/sec: 344.022
INFO:tensorflow:loss = 10845.854, step = 901 (0.288 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train1/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.985.
Out[23]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x1a1b6ea860>
Replicați același pas cu o funcție de intrare diferită pentru a evalua modelul.
eval_input = tf.estimator.inputs.numpy_input_fn(
       x={"x": X_test},
       y=y_test,
       shuffle=False,
       batch_size=128,
       num_epochs=1)
   estimator.evaluate(eval_input,steps=None)
producție
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.158947, global_step = 1000, loss = 3215.8945
Out[24]:
{'average_loss': 32.158947, 'global_step': 1000, 'loss': 3215.8945}
În final, poți calcula predicția. Ar trebui să fie similară cu rezultatul Pandas.
test_input = tf.estimator.inputs.numpy_input_fn(
        x={"x": x_predict},
        batch_size=128,
        num_epochs=1,
        shuffle=False)
        y = estimator.predict(test_input)

predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
producție
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.961248], dtype=float32), array([27.270979], dtype=float32), array([29.299242], dtype=float32), array([16.43668], dtype=float32), array([21.460878], dtype=float32)]
Soluție TensorFlow
Ultima secțiune este dedicată unui aspect pur TensorFlow soluție. Această metodă este puțin mai complicată decât celelalte două.
Rețineți că, dacă utilizați un Jupyter caiet, trebuie să reporniți și să ștergeți kernelul pentru a rula această sesiune.
TensorFlow a construit un instrument excelent pentru a transmite datele în conductă. În această secțiune, veți construi singur funcția input_fn.
Pas 1) Definiți calea și formatul datelor
În primul rând, declarați două variabile cu calea către fișierele CSV. Rețineți că aveți două fișiere, unul pentru setul de antrenament și unul pentru setul de testare.
import tensorflow as tf
df_train = "E:/boston_train.csv"
df_eval = "E:/boston_test.csv"
Apoi trebuie să definiți coloanele pe care doriți să le utilizați din fișierul CSV. Le vom folosi pe toate. După aceea, trebuie să declarați tipul fiecărei variabile.
Variabilele cu număr de înălțimi flotante sunt definite prin [0.]
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
                "dis", "tax", "ptratio", "medv"]
RECORDS_ALL = [[0.0], [0.0], [0.0], [0.0],[0.0],[0.0],[0.0],[0.0],[0.0],[0.0]]
Pas 2) Definiți funcția input_fn
Funcția poate fi împărțită în trei părți:
- Importă datele
- Creați iteratorul
- Consumați datele
Mai jos este codul general pentru definirea funcției. Codul va fi explicat ulterior.
def input_fn(data_file, batch_size, num_epoch = None):
       # Step 1
          def parse_csv(value):
          columns = tf.decode_csv(value, record_defaults= RECORDS_ALL)
          features = dict(zip(COLUMNS, columns))
          #labels = features.pop('median_house_value')
          labels =  features.pop('medv')
          return features, labels

          # Extract lines from input files using the Dataset API.
          dataset = (tf.data.TextLineDataset(data_file) # Read text file
          .skip(1) # Skip header row
          .map(parse_csv))

          dataset = dataset.repeat(num_epoch)
          dataset = dataset.batch(batch_size)
          # Step 3
          iterator = dataset.make_one_shot_iterator()
          features, labels = iterator.get_next()
          return features, labels
Importă datele
Pentru un fișier CSV, metoda dataset citește câte o linie pe rând. Pentru a construi setul de date, trebuie să utilizați obiectul TextLineSet de date. Setul dvs. de date are un antet, așa că trebuie să utilizați skip(1) pentru a sări peste prima linie. În acest moment, citiți doar datele și excludeți antetul din fluxul de lucru. Pentru a alimenta modelul, trebuie să separați caracteristicile de etichetă. Metoda utilizată pentru a aplica orice transformare datelor este harta.
Această metodă apelează o funcție pe care o veți crea pentru a instrui cum să transforme datele. Pe scurt, trebuie să transmiteți datele în TextLineObiect Dataset, exclude antetul și aplică o transformare instruită de o funcție.
Code explicație
- tf.data.TextLineDataset(data_file): această linie citește fișierul CSV
- .skip(1): sare peste antet
- .map(parse_csv)): analizează înregistrările în tensori
Trebuie să definiți o funcție care să instruiască obiectul hărții. Puteți apela această funcție parse_csv.
Această funcție analizează fișierul CSV cu metoda tf.decode_csv și declară caracteristicile și eticheta. Caracteristicile pot fi declarate ca un dicționar sau ca un tuplu. Metoda dicționarului se utilizează deoarece este mai convenabilă.
Code explicație
- tf.decode_csv(value, record_defaults= RECORDS_ALL): metoda decode_csv folosește ieșirea TextLineSet de date pentru citirea fișierului CSV. record_defaults dă instrucțiuni TensorFlow cu privire la tipurile de coloane. În TensorFlow 2.x, acest simbol se află la tf.io.decode_csv.
- dict(zip(COLOANE, coloane)): populează dicționarul cu toate coloanele extracutilizate în timpul acestei prelucrări de date
- features.pop('medv'): exclude variabila țintă din variabilele de caracteristică și creează o variabilă de etichetă
Setul de date are nevoie de elemente suplimentare pentru a alimenta iterativ tensorii. Într-adevăr, trebuie să adăugați metoda `repeat` pentru a permite setului de date să continue la nesfârșit pentru a alimenta modelul. Dacă nu adăugați metoda, modelul va itera o singură dată și apoi va genera o eroare deoarece nu mai sunt introduse date în pipeline.
După aceea, puteți controla dimensiunea lotului cu metoda batch. Aceasta înseamnă că îi spuneți setului de date câte date doriți să fie transmise în conductă pentru fiecare iterație. Dacă setați o dimensiune mare a lotului, modelul va fi lent.
Pas 3) Creați iteratorul
Acum sunteți gata pentru al doilea pas: creați un iterator pentru a returna elementele din setul de date.
Cel mai simplu mod de a crea un operator este cu metoda make_one_shot_iterator.
După aceea, puteți crea caracteristicile și etichetele din iterator.
Pas 4) Consumați datele
Poți verifica ce se întâmplă cu funcția input_fn. Trebuie să apelezi funcția într-o sesiune pentru a consuma datele. Încerci cu o dimensiune a lotului egală cu 1.
Rețineți că afișează caracteristicile dintr-un dicționar și eticheta ca o matrice.
Va afișa prima linie a fișierului CSV. Puteți încerca să rulați acest cod de mai multe ori cu loturi de diferite dimensiuni.
next_batch = input_fn(df_train, batch_size = 1, num_epoch = None)
with tf.Session() as sess:
     first_batch  = sess.run(next_batch)
     print(first_batch)
producție
({'crim': array([2.3004], dtype=float32), 'zn': array([0.], dtype=float32), 'indus': array([19.58], dtype=float32), 'nox': array([0.605], dtype=float32), 'rm': array([6.319], dtype=float32), 'age': array([96.1], dtype=float32), 'dis': array([2.1], dtype=float32), 'tax': array([403.], dtype=float32), 'ptratio': array([14.7], dtype=float32)}, array([23.8], dtype=float32))
Pas 5) Definiți coloana caracteristică
Trebuie să definiți coloanele numerice după cum urmează:
X1= tf.feature_column.numeric_column('crim')
X2= tf.feature_column.numeric_column('zn')
X3= tf.feature_column.numeric_column('indus')
X4= tf.feature_column.numeric_column('nox')
X5= tf.feature_column.numeric_column('rm')
X6= tf.feature_column.numeric_column('age')
X7= tf.feature_column.numeric_column('dis')
X8= tf.feature_column.numeric_column('tax')
X9= tf.feature_column.numeric_column('ptratio')
Rețineți că trebuie să combinați toate variabilele într-un bucket.
base_columns = [X1, X2, X3,X4, X5, X6,X7, X8, X9]
Pas 6) Construiți modelul
Puteți antrena modelul cu estimatorul LinearRegressor.
model = tf.estimator.LinearRegressor(feature_columns=base_columns, model_dir='train3')
producție
INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_model_dir': 'train3', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1820a010f0>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Trebuie să utilizați un funcția lambda pentru a vă permite să scrieți argumentele pentru funcția input_fn. Dacă nu utilizați o funcție lambda, nu puteți antrena modelul.
# Train the estimator
model.train(steps =1000,
          input_fn= lambda : input_fn(df_train,batch_size=128, num_epoch = None))
producție
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train3/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 72.5646
INFO:tensorflow:loss = 13909.657, step = 101 (1.380 sec)
INFO:tensorflow:global_step/sec: 101.355
INFO:tensorflow:loss = 12881.449, step = 201 (0.986 sec)
INFO:tensorflow:global_step/sec: 109.293
INFO:tensorflow:loss = 12391.541, step = 301 (0.915 sec)
INFO:tensorflow:global_step/sec: 102.235
INFO:tensorflow:loss = 12050.5625, step = 401 (0.978 sec)
INFO:tensorflow:global_step/sec: 104.656
INFO:tensorflow:loss = 11766.134, step = 501 (0.956 sec)
INFO:tensorflow:global_step/sec: 106.697
INFO:tensorflow:loss = 11509.922, step = 601 (0.938 sec)
INFO:tensorflow:global_step/sec: 118.454
INFO:tensorflow:loss = 11272.889, step = 701 (0.844 sec)
INFO:tensorflow:global_step/sec: 114.947
INFO:tensorflow:loss = 11051.9795, step = 801 (0.870 sec)
INFO:tensorflow:global_step/sec: 111.484
INFO:tensorflow:loss = 10845.855, step = 901 (0.897 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train3/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Out[8]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x18225eb8d0>
Puteți evalua potrivirea modelului dvs. pe setul de testare cu codul de mai jos:
results = model.evaluate(steps =None,input_fn=lambda: input_fn(df_eval, batch_size =128, num_epoch = 1))
for key in results:
print("   {}, was: {}".format(key, results[key]))
producție
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
   average_loss, was: 32.158958435058594
   loss, was: 3215.89599609375
   global_step, was: 1000
Ultimul pas este prezicerea valorii țintei pe baza valorii matricei de caracteristici. Puteți scrie un dicționar cu valorile pe care doriți să le preziceți. Modelul dvs. are nouă caracteristici, așa că trebuie să furnizați o valoare pentru fiecare. Modelul va oferi o predicție pentru fiecare dintre ele.
În codul de mai jos, scrieți valorile fiecărei caracteristici conținute în fișierul CSV df_predict.
Trebuie să scrieți o nouă funcție input_fn deoarece nu există nicio etichetă în setul de date. Puteți utiliza API-ul from_tensors din obiectul Dataset.
prediction_input = {
          'crim': [0.03359,5.09017,0.12650,0.05515,8.15174,0.24522],
          'zn': [75.0,0.0,25.0,33.0,0.0,0.0],
          'indus': [2.95,18.10,5.13,2.18,18.10,9.90],
          'nox': [0.428,0.713,0.453,0.472,0.700,0.544],
          'rm': [7.024,6.297,6.762,7.236,5.390,5.782],
          'age': [15.8,91.8,43.4,41.1,98.9,71.7],
          'dis': [5.4011,2.3682,7.9809,4.0220,1.7281,4.0317],
          'tax': [252,666,284,222,666,304],
          'ptratio': [18.3,20.2,19.7,18.4,20.2,18.4]
     }
     def test_input_fn():
     dataset = tf.data.Dataset.from_tensors(prediction_input)
     return dataset

     # Predict all our prediction_input
     pred_results = model.predict(input_fn=test_input_fn)
În cele din urmă, imprimați predicțiile.
for pred in enumerate(pred_results):
print(pred)
producție
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
(0, {'predictions': array([32.297546], dtype=float32)})
(1, {'predictions': array([18.96125], dtype=float32)})
(2, {'predictions': array([27.270979], dtype=float32)})
(3, {'predictions': array([29.299236], dtype=float32)})
(4, {'predictions': array([16.436684], dtype=float32)})
(5, {'predictions': array([21.460876], dtype=float32)})

INFO:tensorflow:Calling model_fn. INFO:tensorflow:Done calling model_fn. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from train3/model.ckpt-5000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. (0, {'predictions': array([35.60663], dtype=float32)}) (1, {'predictions': array([22.298521], dtype=float32)}) (2, {'predictions': array([25.74533], dtype=float32)}) (3, {'predictions': array([35.126694], dtype=float32)}) (4, {'predictions': array([17.94416], dtype=float32)}) (5, {'predictions': array([22.606628], dtype=float32)})
Toate cele trei conducte returnează aceleași șase predicții, ceea ce confirmă că alegerea între Pandas, NumPy și un set de date TensorFlow nativ este o chestiune de comoditate, nu de acuratețe.
