
PyTorTutorial de învățare prin transfer cu exemple
 Evelyn Clarke
⚡ Rezumat inteligent
Transfer Learning reutilizează o rețea deja antrenată pe un set mare de date, astfel încât o sarcină nouă, conexă, să poată fi rezolvată cu mult mai puține imagini etichetate și o fracțiune din timpul de antrenament inițial.
Ce este Transfer Learning?
Transferul învățării este o tehnică de utilizare a unui model antrenat pentru a rezolva o altă sarcină conexă. Este o Invatare mecanica Metodă de cercetare care stochează cunoștințele dobândite în timpul rezolvării unei anumite probleme și utilizează aceleași cunoștințe pentru a rezolva o altă problemă diferită, dar conexă. Aceasta îmbunătățește eficiența prin reutilizarea informațiilor adunate din sarcina învățată anterior.
Este popular să se reutilizeze ponderile unui alt model de rețea, deoarece antrenarea unei rețele de la zero necesită o cantitate foarte mare de date. Pentru a reduce timpul de antrenament, se ia o rețea existentă și ponderile acesteia și se modifică ultimul strat pentru a rezolva propria problemă. Avantajul este că acest ultim strat poate fi antrenat cu un set de date mic.
Înainte de a scrie orice PyTorÎn codul ch, este util să știi cărei familii de Transfer Learning îi aparține problema ta, deoarece aceasta decide de câte date etichetate ai nevoie.
Tipuri de învățare prin transfer
Literatura de cercetare împarte tehnica în trei familii. Care dintre ele vi se aplică depinde de care parte a problemei poartă etichete, nu de cadrul pe care îl utilizați.
| Tip | Domeniu sursă | Target domeniu | Utilizare tipică |
|---|---|---|---|
| Inductiv | Etichetat | Etichetat, dar o sarcină diferită | Reorientarea unei coloane vertebrale ImageNet la o problemă Alien vs. Predator de două clase |
| Transductiv | Etichetat | Neetichetat, aceeași sarcină, distribuție diferită a datelor | Adaptarea domeniului, cum ar fi mutarea unui model din fotografii de studio în fotografii realizate cu telefonul |
| Fără supraveghere | Neetichetat | Neetichetat | Clusterreducerea dimensionalității acolo unde etichetarea fiecărei înregistrări este impracticabilă |
Exemplul construit în acest tutorial este învățarea prin transfer inductiv. VGG19 sosește cu cunoștințe ImageNet etichetate și apoi vizează o problemă etichetată cu două clase pe care nu a mai văzut-o până acum.
Expoziție de caracteristicitracțiune vs. reglaj fin
După ce este aleasă o rețea pre-antrenată, există două modalități de a o adapta. Diferența constă pur și simplu în câte straturi permiteți să continue învățarea.
| Aspect | Expoziție de prezentaretracTION | Reglaj fin |
|---|---|---|
| Straturile care se antrenează | Doar clasificatorul înlocuit | Clasificatorul plus unele sau toate blocurile convoluționale |
| requires_grad pe backbone | Fals | Adevărat pentru blocurile care sunt actualizate |
| Date necesare | Imagini mici, adesea câteva sute per clasă | Mai mari, de obicei mii |
| Costul instruirii | Cel mai mic, rulează pe un procesor | Mai sus, un GPU devine valoros |
| Precizie tipică | Bun când imaginile sursă și țintă arată la fel | De obicei, este mai bine când cele două domenii diferă |
Pașii de mai jos utilizează ex. de caracteristicitracțiune: fiecare parametru VGG19 este înghețat și doar noul strat liniar final învață. Trecerea la reglarea fină este o mică modificare, și anume lăsarea requires_grad setată la True pe blocurile pe care doriți să le actualizați și scăderea ratei de învățare, astfel încât ponderile împrumutate să nu fie distruse.
Se încarcă setul de date
Înainte de a începe să utilizați Transfer Learning cu PyTorch, trebuie să înțelegi setul de date pe care îl vei utiliza. În acest Transfer Learning PyTorDe exemplu, veți clasifica un extraterestru și un prădător din aproape 700 de imagini. Pentru această tehnică, nu aveți nevoie de o cantitate mare de date pentru antrenament. Puteți descărca setul de date de la Kaggle: Extraterestru vs. Predator.
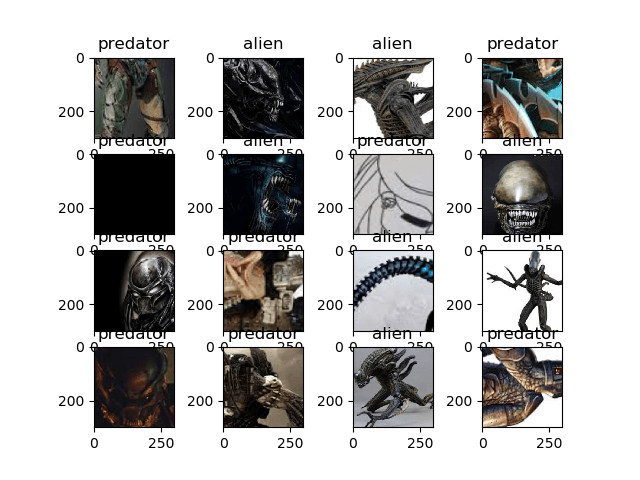
Colecția este intenționat mică, iar o mostră a imaginilor pe care le conține este prezentată mai jos.

Sursa: vs străin Predator Kaggle
Următorul în acest PyTorTutorialul Transfer Learning, veți învăța cum să aplicați Transfer Learning cu PyTorpas cu pas.
Cum se utilizează Transfer Learning?
Iată un proces pas cu pas despre cum să utilizați Transfer Learning pentru Deep Learning cu PyTorcH:
Pasul 1) Încărcați datele
Primul pas este încărcarea datelor și aplicarea unor transformări imaginilor, astfel încât acestea să corespundă cerințelor rețelei.
Veți încărca datele dintr-un folder cu torchvision.datasets. Modulul iterează peste folder pentru a împărți datele în seturi de tren și validare. Canalul de transformare utilizat aici decupează imaginile din centru, le convertește într-un tensor și le normalizează pentru Invatare profunda.
from __future__ import print_function, division
import os
import time
import torch
import torchvision
from torchvision import datasets, models, transforms
import torch.optim as optim
import numpy as np
import matplotlib.pyplot as plt

data_dir = "alien_pred"
input_shape = 224
mean = [0.5, 0.5, 0.5]
std = [0.5, 0.5, 0.5]

#data transformation
data_transforms = {
   'train': transforms.Compose([
       transforms.CenterCrop(input_shape),
       transforms.ToTensor(),
       transforms.Normalize(mean, std)
   ]),
   'validation': transforms.Compose([
       transforms.CenterCrop(input_shape),
       transforms.ToTensor(),
       transforms.Normalize(mean, std)
   ]),
}

image_datasets = {
   x: datasets.ImageFolder(
       os.path.join(data_dir, x),
       transform=data_transforms[x]
   )
   for x in ['train', 'validation']
}

dataloaders = {
   x: torch.utils.data.DataLoader(
       image_datasets[x], batch_size=32,
       shuffle=True, num_workers=4
   )
   for x in ['train', 'validation']
}

dataset_sizes = {x: len(image_datasets[x]) for x in ['train', 'validation']}

print(dataset_sizes)
class_names = image_datasets['train'].classes

device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
Acum vizualizați setul de date. Pasul de vizualizare preia următorul lot de imagini și etichete din încărcătorul de date de antrenament și le afișează cu Matplotlib.
images, labels = next(iter(dataloaders['train']))

rows = 4
columns = 4
fig=plt.figure()
for i in range(16):
   fig.add_subplot(rows, columns, i+1)
   plt.title(class_names[labels[i]])
   img = images[i].numpy().transpose((1, 2, 0))
   img = std * img + mean
   plt.imshow(img)
plt.show()
Rularea acelui fragment de cod desenează o grilă de patru pe patru cu imagini de antrenament, fiecare intitulată cu numele clasei returnat de încărcător.
Pasul 2) Definiți modelul
În acest proces de Deep Learning, veți utiliza VGG19 din modulul torchvision.
Vei folosi torchvision.models pentru a încărca vgg19 cu ponderile pre-antrenate activate. După aceea, îngheți straturile astfel încât să nu poată fi antrenate. Apoi modifici ultimul strat cu un strat liniar care se potrivește problemei, ceea ce înseamnă aici 2 clase. CrossEntropyLoss este utilizat ca funcție de pierdere, iar optimizatorul este SGD cu o rată de învățare de 0.001 și un impuls de 0.9, așa cum se arată în diagrama Py de mai jos.TorExemplu de învățare prin transfer.
## Load the model based on VGG19
vgg_based = torchvision.models.vgg19(pretrained=True)

## freeze the layers
for param in vgg_based.parameters():
   param.requires_grad = False

# Modify the last layer
number_features = vgg_based.classifier[6].in_features
features = list(vgg_based.classifier.children())[:-1] # Remove last layer
features.extend([torch.nn.Linear(number_features, len(class_names))])
vgg_based.classifier = torch.nn.Sequential(*features)

vgg_based = vgg_based.to(device)

print(vgg_based)

criterion = torch.nn.CrossEntropyLoss()
optimizer_ft = optim.SGD(vgg_based.parameters(), lr=0.001, momentum=0.9)
Notă privind versiunea: il pre-antrenat=Adevărat argumentul încă funcționează, dar a fost înlocuit de la torchvision 0.13 de către greutăți argument, deci instalările mai noi se așteaptă torchvision.models.vgg19(greutăți=VGG19_Greutăți.DEFAULT) și afișează un avertisment de perimare în caz contrar. Ambele formulare încarcă aceleași ponderi ImageNet.
Structura modelului de ieșire
Imprimarea modelului returnează graficul VGG19 complet. Citiți ultima linie a blocului clasificatorului pentru a confirma că schimbarea a funcționat: acum produce 2 ieșiri în loc de 1,000 de clase ImageNet.
VGG(
  (features): Sequential(
	(0): Conv2d(3, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(1): ReLU(inplace)
	(2): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(3): ReLU(inplace)
	(4): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(5): Conv2d(64, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(6): ReLU(inplace)
	(7): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(8): ReLU(inplace)
	(9): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(10): Conv2d(128, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(11): ReLU(inplace)
	(12): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(13): ReLU(inplace)
	(14): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(15): ReLU(inplace)
	(16): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(17): ReLU(inplace)
	(18): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(19): Conv2d(256, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(20): ReLU(inplace)
	(21): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(22): ReLU(inplace)
	(23): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(24): ReLU(inplace)
	(25): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(26): ReLU(inplace)
	(27): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(28): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(29): ReLU(inplace)
	(30): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(31): ReLU(inplace)
	(32): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(33): ReLU(inplace)
	(34): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(35): ReLU(inplace)
	(36): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  )
  (classifier): Sequential(
	(0): Linear(in_features=25088, out_features=4096, bias=True)
	(1): ReLU(inplace)
	(2): Dropout(p=0.5)
	(3): Linear(in_features=4096, out_features=4096, bias=True)
	(4): ReLU(inplace)
	(5): Dropout(p=0.5)
	(6): Linear(in_features=4096, out_features=2, bias=True)
  )
)
Pasul 3) Antrenează și testează modelul
Vom folosi câteva dintre funcțiile din aceasta PyTorTutorialul cap. pentru a ne ajuta să ne instruim și să ne evaluăm modelul.
def train_model(model, criterion, optimizer, num_epochs=25):
   since = time.time()

   for epoch in range(num_epochs):
       print('Epoch {}/{}'.format(epoch, num_epochs - 1))
       print('-' * 10)

       #set model to trainable
       # model.train()

       train_loss = 0

       # Iterate over data.
       for i, data in enumerate(dataloaders['train']):
           inputs , labels = data
           inputs = inputs.to(device)
           labels = labels.to(device)

           optimizer.zero_grad()

           with torch.set_grad_enabled(True):
               outputs  = model(inputs)
               loss = criterion(outputs, labels)

           loss.backward()
           optimizer.step()

           train_loss += loss.item() * inputs.size(0)

           print('{} Loss: {:.4f}'.format(
               'train', train_loss / dataset_sizes['train']))

   time_elapsed = time.time() - since
   print('Training complete in {:.0f}m {:.0f}s'.format(
       time_elapsed // 60, time_elapsed % 60))

   return model

def visualize_model(model, num_images=6):
   was_training = model.training
   model.eval()
   images_so_far = 0
   fig = plt.figure()

   with torch.no_grad():
       for i, (inputs, labels) in enumerate(dataloaders['validation']):
           inputs = inputs.to(device)
           labels = labels.to(device)

           outputs = model(inputs)
           _, preds = torch.max(outputs, 1)

           for j in range(inputs.size()[0]):
               images_so_far += 1
               ax = plt.subplot(num_images//2, 2, images_so_far)
               ax.axis('off')
               ax.set_title('predicted: {} truth: {}'.format(class_names[preds[j]], class_names[labels[j]]))
               img = inputs.cpu().data[j].numpy().transpose((1, 2, 0))
               img = std * img + mean
               ax.imshow(img)

               if images_so_far == num_images:
                   model.train(mode=was_training)
                   return
       model.train(mode=was_training)
În cele din urmă, în acest Transfer Learning în PyTorDe exemplu, începeți procesul de antrenament cu numărul de epoci setat la 25 și evaluați rețeaua ulterior. La fiecare pas de antrenament, modelul preia datele de intrare și prezice rezultatele. Predicția este transmisă criteriului pentru a calcula pierderea, retropropagarea calculează gradienții, iar optimizatorul actualizează ponderile cu autograd.
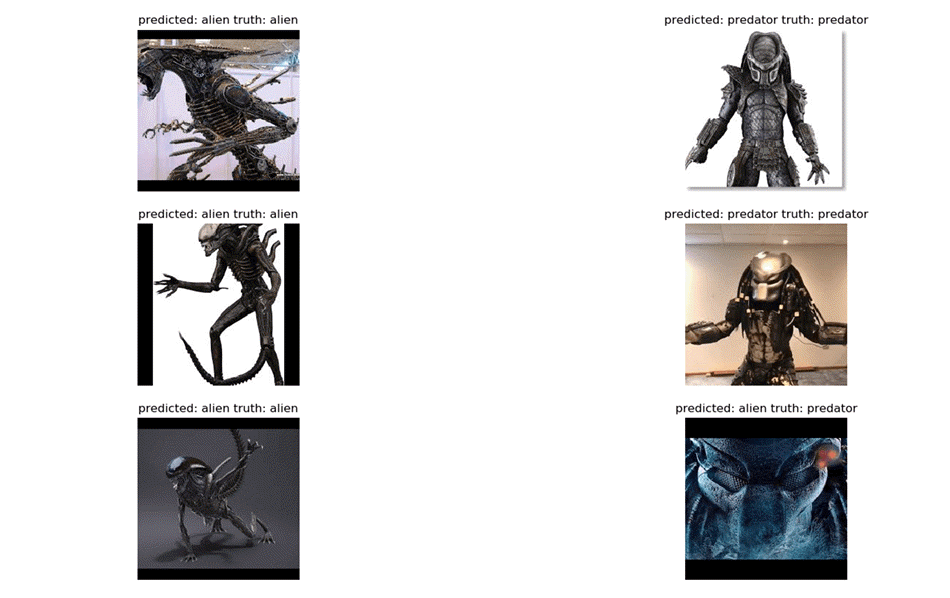
În funcția de vizualizare, rețeaua antrenată este testată cu un lot de imagini pentru a prezice etichetele, iar rezultatul este desenat cu Matplotlib.
vgg_based = train_model(vgg_based, criterion, optimizer_ft, num_epochs=25)

visualize_model(vgg_based)

plt.show()
Pasul 4) Rezultate
Precizia raportată pentru această rulare este de 92%. Jurnalul imprimat la sfârșitul antrenamentului arată pierderea de timp pentru ultimele două epoci, împreună cu timpul total de antrenament.
Epoch 23/24
----------
train Loss: 0.0044
train Loss: 0.0078
train Loss: 0.0141
train Loss: 0.0221
train Loss: 0.0306
train Loss: 0.0336
train Loss: 0.0442
train Loss: 0.0482
train Loss: 0.0557
train Loss: 0.0643
train Loss: 0.0763
train Loss: 0.0779
train Loss: 0.0843
train Loss: 0.0910
train Loss: 0.0990
train Loss: 0.1063
train Loss: 0.1133
train Loss: 0.1220
train Loss: 0.1344
train Loss: 0.1382
train Loss: 0.1429
train Loss: 0.1500
Epoch 24/24
----------
train Loss: 0.0076
train Loss: 0.0115
train Loss: 0.0185
train Loss: 0.0277
train Loss: 0.0345
train Loss: 0.0420
train Loss: 0.0450
train Loss: 0.0490
train Loss: 0.0644
train Loss: 0.0755
train Loss: 0.0813
train Loss: 0.0868
train Loss: 0.0916
train Loss: 0.0980
train Loss: 0.1008
train Loss: 0.1101
train Loss: 0.1176
train Loss: 0.1282
train Loss: 0.1323
train Loss: 0.1397
train Loss: 0.1436
train Loss: 0.1467
Training complete in 2m 47s
Predicțiile modelului sunt apoi vizualizate cu Matplotlib, așa cum se arată mai jos.
Erori frecvente de învățare prin transfer și cum să le remediați
Majoritatea erorilor dintr-un script de învățare prin transfer sunt mecanice, nu matematice. Acestea sunt cele care împiedică rularea codului de mai sus și ce înseamnă fiecare dintre ele.
- Nepotrivire de dimensiune în stratul final: Stratul liniar înlocuit trebuie să accepte valorile `in_features` raportate de clasificatorul original și să emită exact valorile `len(class_names`). Imprimarea modelului, ca în Pasul 2, este cea mai rapidă modalitate de a confirma ambele numere.
- Coloana vertebrală nu a fost niciodată înghețată: Dacă requires_grad este lăsat la True, fiecare parametru VGG19 este actualizat, iar rularea încetinește la o accelerare pe un CPU. Setați-l la False înainte ca clasificatorul să fie înlocuit.
- Neconcordanță de normalizare: media și deviația standard utilizate în transformări. Valorile normale trebuie să aibă aceleași valori la momentul antrenării și la momentul inferenței, altfel predicțiile deviază fără niciun motiv vizibil.
- Argumentul ponderilor depreciate: Pe torchvision 0.13 și versiunile ulterioare, pretrained=True generează un avertisment de depreciere, iar enumerarea ponderilor este preferată.
- num_workers activat Windows și caiete: Un DataLoader cu num_workers=4 necesită protejarea punctului de intrare, deci setează num_workers=0 dacă Python ridică o eroare de spawn sau pickling.
- Evaluarea în modul de antrenament: apelează model.eval() înainte de a calcula scorul, astfel încât Dropout și BatchNorm să se comporte determinist și revin la modul inițial cu model.train() ulterior.
