
ETL (Ex.tracProcesul t, Transformare și Încărcare) într-un depozit de date
 David Carter
Rezumat inteligent
ETL (Ex.trac(procesul t, Transformare și Încărcare) din Depozitul de Date descrie fluxul sistematic de mișcare a datelor din mai multe surse eterogene într-un depozit centralizat. Acesta asigură consecvența, acuratețea și disponibilitatea datelor pentru analiză prin intermediul unor procese structurate.tracțiune, transformare și mecanisme de încărcare optimizate.
Ce este ETL?
ETL este un proces care extracprelucrează datele din diferite sisteme sursă, apoi transformă datele (cum ar fi aplicarea de calcule, concatenări etc.) și în final încarcă datele în sistemul depozitului de date. Forma completă a ETL este Extract, Transformare și Încărcare.
Este tentant să credem că crearea unui depozit de date implică pur și simplu...traccolectarea datelor din mai multe surse și încărcarea lor într-o bază de date. Totuși, în realitate, necesită un proces ETL complex. Procesul ETL necesită contribuții active din partea diverselor părți interesate, inclusiv dezvoltatori, analiști, testeri și directori de top, și este dificil din punct de vedere tehnic.
Pentru a-și menține valoarea ca instrument pentru factorii de decizie, sistemul depozitului de date trebuie să se schimbe odată cu schimbările din cadrul afacerii. ETL este o activitate recurentă (zilnică, săptămânală sau lunară) a unui sistem depozit de date și trebuie să fie agil, automatizat și bine documentat.


De ce ai nevoie de ETL?
Există multe motive pentru adoptarea ETL în organizație:
- Ajută companiile să își analizeze datele de afaceri pentru a lua decizii de afaceri critice.
- Bazele de date tranzacționale nu pot răspunde la întrebări complexe de afaceri la care se poate răspunde printr-un exemplu ETL.
- Un depozit de date oferă un depozit comun de date
- ETL oferă o metodă de mutare a datelor din diverse surse într-un depozit de date.
- Pe măsură ce sursele de date se schimbă, depozitul de date se va actualiza automat.
- Un sistem ETL bine conceput și documentat este aproape esențial pentru succesul unui proiect de depozit de date.
- Permite verificarea regulilor de transformare, agregare și calcul a datelor.
- Procesul ETL permite compararea datelor eșantion între sistemul sursă și cel țintă.
- Procesul ETL poate efectua transformări complexe și necesită o zonă suplimentară pentru stocarea datelor.
- ETL ajută la migrarea datelor într-un depozit de date, convertind diferite formate și tipuri într-un sistem consistent.
- ETL este un proces predefinit pentru accesarea și manipularea datelor sursă în baza de date țintă.
- ETL într-un depozit de date oferă un context istoric profund pentru afacere.
- Ajută la îmbunătățirea productivității deoarece codifică și reutilizează fără a fi nevoie de abilități tehnice.
Având o înțelegere clară a valorii ETL, haideți să analizăm procesul în trei pași care face ca totul să funcționeze.
Procesul ETL în depozitele de date
ETL este un proces în 3 pași
Pasul 1) Ex.tracTION
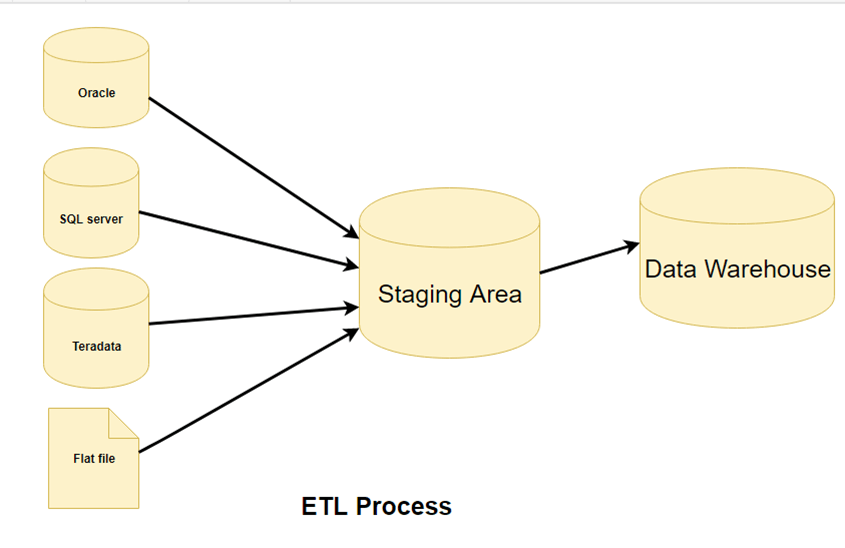
În această etapă a arhitecturii ETL, datele sunt exprimatetracdin sistemul sursă în zona de testare. Transformările, dacă există, sunt efectuate în zona de testare astfel încât performanța sistemului sursă să nu fie degradată. De asemenea, dacă datele corupte sunt copiate direct din sursă în baza de date a depozitului de date, revenirea la versiunea inițială va fi o provocare. Zona de testare oferă oportunitatea de a valida extracdatele procesate înainte de a fi mutate în depozitul de date.
Depozitul de date trebuie să integreze sisteme care au SGBD-uri, hardware, OperaSisteme de gestionare a datelor și protocoale de comunicație. Sursele pot include aplicații vechi, cum ar fi mainframe-uri, aplicații personalizate, dispozitive de punct de contact, cum ar fi bancomate, comutatoare de apel, fișiere text, foi de calcul, ERP, date de la furnizori și parteneri, printre altele.
Prin urmare, este nevoie de o hartă logică a datelor înainte ca datele să fie extrase.tracîncărcate fizic. Această hartă de date descrie relația dintre datele sursă și cele țintă.
Trei exemple de datetracmetode de țiune:
- Ex. complettracTION
- Ex parțialtracțiune - fără notificare de actualizare.
- Ex parțialtracțiune - cu notificare de actualizare
Indiferent de metoda utilizată, de exemplutracAceastă funcționalitate nu ar trebui să afecteze performanța și timpul de răspuns al sistemelor sursă. Aceste sisteme sursă sunt baze de date de producție în timp real. Orice încetinire sau blocare ar putea afecta profitul companiei.
Unele validări se fac în timpul ExtracTION:
- Reconciliați înregistrările cu datele sursă
- Asigurați-vă că nu sunt încărcate date spam/nedorite
- Verificarea tipului de date
- Eliminați toate tipurile de date duplicat/fragmentate
- Verificați dacă toate cheile sunt la locul lor.
Pasul 2) Transformare
Date extracDatele preluate de pe serverul sursă sunt brute și nu pot fi utilizate în forma lor originală. Prin urmare, trebuie curățate, mapate și transformate. De fapt, acesta este pasul cheie în care procesul ETL adaugă valoare și modifică datele astfel încât să poată fi generate rapoarte BI detaliate.
Este unul dintre conceptele ETL importante în care aplici un set de funcții pe ex.tracdate ted. Datele care nu necesită nicio transformare se numesc mișcare directă or date de transfer.
În etapa de transformare, puteți efectua operațiuni personalizate asupra datelor. De exemplu, dacă utilizatorul dorește suma veniturilor din vânzări care nu se află în baza de date. Sau dacă prenumele și numele de familie dintr-un tabel se află în coloane diferite, este posibil să le concatenați înainte de încărcare.

Următoarele sunt date Integrity Probleme:
- Ortografii diferite ale aceleiași persoane, cum ar fi Jon, John etc.
- Există mai multe moduri de a desemna numele unei companii, cum ar fi Google, Google Inc
- Utilizarea unor nume diferite, cum ar fi Cleaveland și Cleveland.
- Poate exista un caz în care diverse aplicații generează numere de cont diferite pentru același client.
- În unele cazuri, fișierele cu datele necesare rămân goale
- Produs nevalid colectat la POS, deoarece introducerea manuală poate duce la greșeli.
Validarile se fac in aceasta etapa
- Filtrare – Selectați numai anumite coloane pentru încărcare
- Utilizarea regulilor și a tabelelor de căutare pentru standardizarea datelor
- Conversia setului de caractere și manipularea codificării
- Conversia unităților de măsură, cum ar fi conversiile de dată și oră, conversiile valutare, conversiile numerice etc.
- Verificare a validării pragului de date. De exemplu, vârsta nu poate avea mai mult de două cifre.
- Validarea fluxului de date din zona de staging la tabelele intermediare.
- Câmpurile obligatorii nu trebuie lăsate necompletate.
- Curățenie (de exemplu, hartă)ping NULL la 0 sau Sex Masculin la „M” și Feminin la „F”, etc.)
- Împărțiți o coloană în mai multe coloane și îmbinați mai multe coloane într-o singură coloană.
- Transpunerea rândurilor și coloanelor,
- Utilizați căutări pentru a îmbina datele
- Folosind orice validare complexă a datelor (de exemplu, dacă primele două coloane dintr-un rând sunt goale, atunci rândul respectiv este respins automat de la procesare)
Pasul 3) Încărcare
Încărcarea datelor în baza de date a depozitului de date țintă este ultimul pas al procesului ETL. Într-un depozit de date tipic, un volum imens de date trebuie încărcat într-o perioadă relativ scurtă (nopți). Prin urmare, procesul de încărcare ar trebui optimizat pentru performanță.
În cazul unei erori de încărcare, mecanismele de recuperare ar trebui configurate să repornească din punctul de eroare fără pierderea integrității datelor. Administratorii depozitului de date trebuie să monitorizeze, să reia și să anuleze încărcările în funcție de performanța serverului.
Tipuri de încărcare:
- Încărcare inițială — popularea tuturor tabelelor din depozitul de date
- Încărcare incrementală — aplicarea periodică a modificărilor continue, după cum este necesar.
- Reîmprospătare completă — ștergerea conținutului unuia sau mai multor tabele și reîncărcarea cu date noi.
Verificarea încărcării
- Asigurați-vă că datele câmpului cheie nu lipsesc și nici nu sunt nule.
- Testați vederile de modelare pe baza tabelelor țintă.
- Verificați dacă valorile combinate și măsurătorile calculate sunt corecte.
- Verificări ale datelor atât în tabelul de dimensiuni, cât și în tabelul istoric.
- Verificați rapoartele BI pe tabelul de fapte și dimensiuni încărcate.
Pipelining ETL și procesare paralelă
Conducta ETL permite extractransformare și încărcare simultan în loc de secvențial. De îndată ce o porțiune de date este extrasătracted, este transformat și încărcat în timp ce datele noi sunt extrasetracțiunea continuă. Aceasta procesare paralelă îmbunătățește considerabil performanța, reduce timpii de nefuncționare și maximizează utilizarea resurselor sistemului.
Această procesare paralelă este esențială pentru analize în timp real, integrare de date la scară largă și sisteme ETL bazate pe cloud. Prin suprapunereping Prin intermediul sarcinilor de procesare, ETL-ul pipeline asigură o mișcare mai rapidă a datelor, o eficiență mai mare și o livrare mai consistentă a datelor pentru întreprinderile moderne.
Cum îmbunătățește inteligența artificială conductele ETL moderne?
Inteligența artificială revolutIonizează ETL prin transformarea conductelor de date în adaptive, inteligente și auto-optimizabile. Algoritmii de inteligență artificială pot mapa automat scheme, detecta anomalii și prezice reguli de transformare fără configurare manuală. Acest lucru permite fluxurilor de lucru ETL să gestioneze structurile de date în evoluție fără efort, menținând în același timp calitatea datelor.
Platformele ETL moderne, optimizate cu inteligență artificială, utilizează tehnologii precum AutoML pentru ingineria automată a caracteristicilor, harta schemelor bazată pe NLPping care înțelege relațiile semantice dintre câmpuri și algoritmi de detectare a anomaliilor care identifică problemele de calitate a datelor în timp real. Aceste capabilități reduc semnificativ efortul manual necesar în mod tradițional în dezvoltarea și întreținerea ETL.
Invatare mecanica îmbunătățește optimizarea performanței, asigurând o integrare a datelor mai rapidă și mai precisă. Prin introducerea automatizării și a inteligenței predictive, ETL bazat pe inteligență artificială oferă informații în timp real și sporește eficiența în ecosistemele de date cloud și hibride.
Pentru a implementa conceptele discutate mai sus, organizațiile se bazează pe instrumente ETL specializate. Iată câteva dintre principalele opțiuni disponibile pe piață.
Instrumente ETL
Există multe Instrumente ETL disponibile pe piață. Iată câteva dintre cele mai importante:
1. MarkLogic:
MarkLogic este o soluție de depozitare a datelor care facilitează și accelerează integrarea datelor folosind o gamă largă de funcții pentru întreprinderi. Poate interoga diferite tipuri de date, cum ar fi documente, relații și metadate.
https://www.marklogic.com/product/getting-started/
2. Oracle:
Oracle este baza de date lider în industrie. Oferă o gamă largă de soluții de depozitare a datelor atât pentru operațiuni locale, cât și în cloud. Ajută la optimizarea experiențelor clienților prin creșterea eficienței operaționale.
https://www.oracle.com/index.html
3. Amazon RoșuShift:
Amazon Redshift este un instrument de depozitare a datelor. Este un instrument simplu și rentabil pentru analizarea tuturor tipurilor de date folosind date standard. SQL și instrumentele BI existente. De asemenea, permite executarea de interogări complexe pe petaocteți de date structurate.
https://aws.amazon.com/redshift/?nc2=h_m1
Iată o listă completă de utile Instrumente pentru depozitul de date.
Cele mai bune practici pentru procesul ETL
Următoarele sunt cele mai bune practici pentru etapele procesului ETL:
- Nu încercați niciodată să curățați toate datele:
Fiecare organizație ar dori să aibă toate datele curate, dar majoritatea nu sunt dispuse să plătească pentru a aștepta sau nu sunt dispuse să aștepte. Curățarea tuturor datelor ar dura pur și simplu prea mult, așa că este mai bine să nu încercați să curățați toate datele. - Echilibrează curățenia cu prioritățile afacerii:
Deși ar trebui să evitați curățarea excesivă a tuturor datelor, asigurați-vă că câmpurile critice și cu impact ridicat sunt curățate pentru fiabilitate. Concentrați eforturile de curățare asupra elementelor de date care afectează direct deciziile de afaceri și acuratețea raportării. - Determinați costul curățării datelor:
Înainte de a curăța toate datele murdare, este important să determinați costul de curățare pentru fiecare element de date murdare. - Pentru a accelera procesarea interogărilor, aveți vizualizări și indecși auxiliare:
Pentru a reduce costurile de stocare, stocați datele rezumate pe benzi de disc. De asemenea, este necesar un compromis între volumul de date de stocat și utilizarea detaliată a acestuia. Compensație la nivelul granularității datelor pentru a reduce costurile de stocare.
