
Tutorial de regressão linear com TensorFlow [exemplos]
 Evelyn Clarke
⚡ Resumo Inteligente
A regressão linear no TensorFlow modela a relação entre características numéricas e um valor alvo contínuo. Este tutorial treina um preditor de preços de imóveis em Boston de três maneiras diferentes, usando Pandas, NumPy e os pipelines de entrada nativos do TensorFlow com o estimador LinearRegressor.
O que é regressão linear?
Regressão linear A regressão linear é uma abordagem estatística para modelar relações entre duas variáveis. Essa modelagem é feita entre uma resposta escalar e uma ou mais variáveis explicativas. A relação com uma única variável explicativa é chamada de regressão linear simples, e com mais de uma variável explicativa é chamada de regressão linear múltipla.
O TensorFlow fornece ferramentas para ter controle total dos cálculos. Isso é feito com a API de baixo nível. Além disso, o TensorFlow está equipado com uma vasta gama de APIs para realizar muitas aprendizado de máquina algoritmos. Esta é a API de alto nível, e o TensorFlow os chama de estimadores.
- API de baixo nívelConstruir a arquitetura e a otimização do modelo do zero é algo complicado para um iniciante.
- API de alto nívelDefina o algoritmo. É fácil de usar. O TensorFlow fornece um conjunto de ferramentas chamado estimador para construir, treinar, avaliar e fazer uma previsão.
Neste tutorial, você usará o estimadores apenasOs cálculos são mais rápidos e fáceis de implementar. A primeira parte explica como usar o otimizador de descida de gradiente para treinar uma regressão linear no TensorFlow. Na segunda parte, você usará o conjunto de dados de Boston para prever o preço de uma casa usando um estimador do TensorFlow.
Baixe o conjunto de dados de Boston
Como treinar um modelo de regressão linear
Antes de começarmos a treinar o modelo, vamos dar uma olhada no que é, de fato, uma regressão linear.
Imagine que você tem duas variáveis, x e y, e sua tarefa é prever o valor de y sabendo o valor de x. Se você plotar os dados, poderá ver uma relação positiva entre sua variável independente, x, e sua variável dependente, y, como mostra o gráfico de dispersão abaixo.

Você pode observar que se x=1, y será aproximadamente igual a 6, e se x=2, y será em torno de 8.5.
Este método não é muito preciso e está sujeito a erros, especialmente com um conjunto de dados que contém centenas de milhares de pontos.
Uma regressão linear é avaliada com uma equação. A variável y é explicada por uma ou mais covariáveis. No seu exemplo, há apenas uma variável dependente. Se você tiver que escrever esta equação, será:

Com:
 é o viés. Ou seja, se x=0, y=
 é o peso associado a x
 é o resíduo, ou o erro do modelo. Inclui o que o modelo não consegue aprender com os dados.
Imagine que você ajusta o modelo e encontra a seguinte solução para:
- = 3.8
- = 2.78
Você pode substituir esses números na equação e ela se tornará:
y = 3.8 + 2.78x
Agora você tem uma maneira melhor de encontrar os valores de y. Ou seja, você pode substituir x por qualquer valor que desejar para prever y. Na imagem abaixo, substituímos x na equação por todos os valores do conjunto de dados e plotamos o resultado.

A linha vermelha representa o valor ajustado, ou seja, os valores de y para cada valor de x. Você não precisa ver o valor de x para prever y; para cada x existe um valor correspondente à linha vermelha. Você também pode fazer previsões para valores de x maiores que 2.
Se você quiser estender a regressão linear para mais covariáveis, pode fazê-lo adicionando mais variáveis ao modelo. A diferença entre a análise tradicional e a regressão linear é que a regressão linear analisa como y reagirá a cada variável x considerada independentemente.
Vejamos um exemplo. Imagine que você queira prever as vendas de uma sorveteria. O conjunto de dados contém diversas informações, como o clima (chuvoso, ensolarado, nublado) e informações sobre os clientes (salário, sexo, estado civil).
A análise tradicional tenta prever a venda, por exemplo, calculando a média de cada variável e tentando estimar a venda para diferentes cenários. Isso leva a previsões imprecisas e restringe a análise ao cenário escolhido.
Se você usar regressão linear, poderá escrever esta equação:
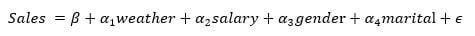
O algoritmo encontrará a melhor solução para os pesos; isso significa que ele tentará minimizar o custo, que é a diferença entre a linha ajustada e os pontos de dados.
Como o algoritmo funciona
O diagrama abaixo resume o ciclo que o algoritmo repete: escolher os pesos, prever y, medir o erro e corrigir os pesos.

O algoritmo escolherá um número aleatório para cada  e
 e substitua o valor de x para obter o valor previsto de y. Se o conjunto de dados tiver 100 observações, o algoritmo calcula 100 valores previstos.
Podemos calcular o erro, notado  , do modelo, que é a diferença entre o valor previsto e o valor real. Um erro positivo significa que o modelo subestima a previsão de y, e um erro negativo significa que o modelo superestima a previsão de y.

Seu objetivo é minimizar o quadrado do erro. O algoritmo calcula a média do quadrado do erro. Esta etapa é chamada de minimização do erro. Para regressão linear, esta é a Erro quadrado médio, também chamado de MSE. Matematicamente, é:

Onde:
 são os pesos, então
 refere-se ao valor previsto
- y são os valores reais
- m é o número de observações.
 refere-se ao valor previsto
Observe que  significa que usa a transposta das matrizes. O
 é a notação matemática da média.
O objetivo é encontrar o melhor  que minimiza o MSE.
Se o erro médio for grande, significa que o modelo tem um desempenho ruim e os pesos não foram escolhidos corretamente. Para corrigir os pesos, é necessário usar um otimizador. O otimizador tradicional é chamado Gradiente descendente.
O método do gradiente descendente calcula a derivada e diminui ou aumenta o peso. Se a derivada for positiva, o peso é diminuído. Se a derivada for negativa, o peso é aumentado. O modelo atualiza os pesos e recalcula o erro. Esse processo se repete até que o erro não mude mais. Cada iteração é chamada de passagem. iteraçãoAlém disso, os gradientes são multiplicados por uma taxa de aprendizagem, que indica a velocidade do aprendizado.
Se a taxa de aprendizado for muito baixa, o algoritmo levará muito tempo para convergir, pois exigirá muito mais iterações. Se a taxa de aprendizado for muito alta, o algoritmo poderá nunca convergir. A curva de perda abaixo representa o erro em função do número de iterações para este conjunto de dados.

Como pode ser visto na imagem acima, o modelo repete o processo cerca de 20 vezes antes de encontrar um valor estável para os pesos, atingindo assim o menor erro.
Note que o erro não é igual a zero, mas se estabiliza em torno de 5. Isso significa que o modelo apresenta um erro típico de 5. Se você deseja reduzir o erro, precisa adicionar mais informações ao modelo, como mais variáveis, ou usar estimadores diferentes.
Você se lembra da primeira equação:

Os pesos finais são 3.8 e 2.78. O vídeo abaixo mostra como o método do gradiente descendente otimiza a função de perda para encontrar esses pesos.
Como treinar uma regressão linear com TensorFlow
Agora que você entende melhor o que está acontecendo nos bastidores, está pronto para usar a API do estimador fornecida pelo TensorFlow para treinar sua primeira regressão linear usando o TensorFlow.
Nota de versão: O fluxo de trabalho do estimador mostrado abaixo foi escrito para o TensorFlow 1.x e as primeiras versões do 2.x. O TensorFlow marcou o tf.estimator e tf.feature_column As APIs foram totalmente descontinuadas na versão 2.12 e os Estimadores foram removidos na versão 2.16. Em uma instalação atual, execute este código dentro de um TensorFlow 1.15 ou 2.x-with-tf.compat.v1 ambiente, ou portá-lo para Keras, onde tf.keras.layers.Dense(1) Além disso, as camadas de pré-processamento substituem o LinearRegressor e as colunas de características. Os conceitos — características, rótulos, lotes, épocas, MSE e descida de gradiente — permanecem inalterados.
Você utilizará o conjunto de dados Boston, que inclui as seguintes variáveis.
| Variável | Descrição |
| criminoso | taxa de criminalidade per capita por cidade |
| zn | proporção de terrenos residenciais zoneados para lotes com mais de 25,000 pés quadrados. |
| indus | proporção de hectares comerciais não varejistas por cidade. |
| nox | concentração de óxidos nítricos |
| rm | número médio de quartos por habitação |
| idade | proporção de unidades ocupadas pelos proprietários construídas antes de 1940 |
| dis | distâncias ponderadas para cinco centros de emprego de Boston |
| imposto | taxa de imposto sobre a propriedade de valor total por dólares 10,000 |
| ptratio | proporção aluno-professor por cidade |
| medv | Valor médio das casas ocupadas pelos proprietários em milhares de dólares |
Você criará três conjuntos de dados diferentes:
| conjunto de dados | objetivo | forma |
| Formação | Treine o modelo e obtenha os pesos | 400, 10 |
| Avaliação | Avalie o desempenho do modelo em dados não vistos | 100, 10 |
| Prever | Use o modelo para prever o valor da casa com base em novos dados | 6, 10 |
O objetivo é utilizar as características do conjunto de dados para prever o valor da casa.
Na segunda parte do tutorial, você aprenderá como usar o TensorFlow com três maneiras diferentes de importar os dados:
- Com pandas
- Com NumPy
- Somente TensorFlow
Note que todas as três opções produzem os mesmos resultados.
Você aprenderá como usar a API de alto nível para construir, treinar e avaliar um modelo de regressão linear do TensorFlow. Se você estivesse usando a API de baixo nível, teria que definir manualmente:
- Função de perda
- Otimizador: descida de gradiente
- Multiplicação da matriz
- Gráfico e tensor
Isso é tedioso e mais complicado para um iniciante.
Solução Pandas
Você precisa importar as bibliotecas necessárias para treinar o modelo.
import pandas as pd
from sklearn import datasets
import tensorflow as tf
import itertools
Passo 1) Importe os dados com Pandas.
Você define os nomes das colunas e os armazena em COLUMNS. Você pode usar pd.read_csv() para importar os dados.
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
           "dis", "tax", "ptratio", "medv"]
Direcione cada chamada para os arquivos CSV que você baixou anteriormente.
training_set = pd.read_csv("E:/boston_train.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
test_set = pd.read_csv("E:/boston_test.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
prediction_set = pd.read_csv("E:/boston_predict.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
Você pode imprimir a forma dos dados.
print(training_set.shape, test_set.shape, prediction_set.shape)
saída
(400, 10) (100, 10) (6, 10)
Observe que o rótulo, ou seja, o seu valor de y, está incluído no conjunto de dados. Portanto, você precisa definir duas outras listas: uma contendo apenas as características e outra apenas com o nome do rótulo. Essas duas listas informarão ao seu estimador quais são as características no conjunto de dados e qual nome de coluna corresponde ao rótulo.
Isso é feito com o código abaixo.
FEATURES = ["crim", "zn", "indus", "nox", "rm",
                 "age", "dis", "tax", "ptratio"]
LABEL = "medv"
Passo 2) Converta os dados
Você precisa converter as variáveis numéricas para o formato adequado. O TensorFlow fornece um método para converter uma variável contínua: tf.feature_column.numeric_column().
Na etapa anterior, você definiu uma lista de recursos que deseja incluir no modelo. Agora você pode usar essa lista para convertê-los em dados numéricos. Se quiser excluir recursos do seu modelo, fique à vontade para remover uma ou mais variáveis da lista FEATURES antes de construir feature_cols.
Observe que você usará um Python A compreensão de lista com a lista FEATURES cria uma nova lista chamada feature_cols. Isso evita escrever tf.feature_column.numeric_column() nove vezes. A compreensão de lista é uma maneira mais rápida e limpa de criar novas listas.
feature_cols = [tf.feature_column.numeric_column(k) for k in FEATURES]
Passo 3) Defina o estimador
Nesta etapa, você precisa definir o estimador. O TensorFlow fornece seis estimadores predefinidos, três para tarefas de classificação e três para tarefas de regressão do TensorFlow:
- Regressor
- DNSRegressor
- Regressor Linear
- Regressor Combinado Linear DNN
- classificar
- Classificador DNN
- Classificador Linear
- Classificador Combinado Linear DNN
Neste tutorial, você usará o Regressor Linear. Para acessar esta função, você precisa usar tf.estimator.
A função precisa de dois argumentos:
- feature_columns: contém as variáveis a serem incluídas no modelo
- model_dir: caminho para armazenar o grafo, salvar os parâmetros do modelo e assim por diante.
O TensorFlow criará automaticamente uma pasta chamada `train` em seu diretório de trabalho. Você precisa usar esse caminho para acessar os arquivos de configuração. TensorBoard, conforme mostrado no exemplo de regressão do TensorFlow abaixo.
estimator = tf.estimator.LinearRegressor(
        feature_columns=feature_cols,
        model_dir="train")
saída
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a215dc550>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
A parte complicada do TensorFlow é a forma de alimentar o modelo. O TensorFlow foi projetado para funcionar com computação paralela e conjuntos de dados muito grandes. Devido à limitação dos recursos da máquina, é impossível alimentar o modelo com todos os dados de uma só vez. Para isso, é necessário alimentar o modelo com um lote de dados a cada vez. Observe que estamos falando de conjuntos de dados enormes, com milhões ou mais registros. Se você não adicionar um lote, acabará com um erro de memória.
Por exemplo, se seus dados contiverem 100 observações e você definir um tamanho de lote de 10, isso significa que o modelo verá 10 observações para cada iteração (10*10).
Quando o modelo tiver processado todos os dados, ele completa uma época. Uma época define quantas vezes você quer que o modelo processe os dados. É melhor definir esse valor como "nenhum" e deixar o modelo realizar um número predefinido de iterações.
Uma segunda informação importante a adicionar é se você deseja embaralhar os dados antes de cada iteração. Durante o treinamento, é crucial embaralhar os dados para que o modelo não aprenda um padrão específico do conjunto de dados. Se o modelo aprender os detalhes do padrão subjacente dos dados, terá dificuldade em generalizar a previsão para dados não vistos. Isso é chamado de sobreajuste (overfitting). O modelo tem um bom desempenho nos dados de treinamento, mas não consegue prever corretamente para dados não vistos.
O TensorFlow facilita a execução dessas duas etapas. Quando os dados chegam ao pipeline, ele sabe quantas observações precisa (lote) e se precisa embaralhar os dados.
Para instruir o TensorFlow sobre como alimentar o modelo, você pode usar a função `pandas_input_fn`. Este objeto precisa de cinco parâmetros:
- x: dados do recurso
- y: dados do rótulo
- tamanho_do_lote: lote. Por padrão 128
- num_epoch: número de épocas, por padrão 1
- Embaralhar: embaralhar ou não os dados. Por padrão, Nenhum.
Você precisa alimentar o modelo várias vezes, então define uma função para repetir esse processo. Chame essa função de get_input_fn.
def get_input_fn(data_set, num_epochs=None, n_batch = 128, shuffle=True):
         return tf.estimator.inputs.pandas_input_fn(
         x=pd.DataFrame({k: data_set[k].values for k in FEATURES}),
         y = pd.Series(data_set[LABEL].values),
         batch_size=n_batch,
         num_epochs=num_epochs,
         shuffle=shuffle)
O método usual para avaliar o desempenho de um modelo é:
- Treine o modelo
- Avalie o modelo em um conjunto de dados diferente.
- Fazer uma previsão
O estimador do TensorFlow fornece três funções diferentes para realizar essas três etapas com facilidade.
Passo 4) Treine o modelo
Você pode usar o método `train` do estimador para ajustar o modelo. O estimador `train` precisa de uma função `input_fn` e um número de passos. Você pode usar a função que criou anteriormente para alimentar o modelo. Em seguida, instrua o modelo a iterar 1000 vezes. Observe que você não especifica o número de épocas; deixe o modelo iterar 1000 vezes. Se você definir o número de épocas como 1, o modelo iterará quatro vezes, porque há 400 registros no conjunto de treinamento e o tamanho do lote é 128.
- 128 camadas
- 128 camadas
- 128 camadas
- 16 camadas
Portanto, é mais fácil definir o número de épocas como nenhum e definir o número de iterações, como mostrado no exemplo de classificação do TensorFlow abaixo.
estimator.train(input_fn=get_input_fn(training_set,
                                           num_epochs=None,
                                           n_batch = 128,
                                           shuffle=False),
                                           steps=1000)
saída
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 238.616
INFO:tensorflow:loss = 13909.657, step = 101 (0.420 sec)
INFO:tensorflow:global_step/sec: 314.293
INFO:tensorflow:loss = 12881.449, step = 201 (0.320 sec)
INFO:tensorflow:global_step/sec: 303.863
INFO:tensorflow:loss = 12391.541, step = 301 (0.327 sec)
INFO:tensorflow:global_step/sec: 308.782
INFO:tensorflow:loss = 12050.5625, step = 401 (0.326 sec)
INFO:tensorflow:global_step/sec: 244.969
INFO:tensorflow:loss = 11766.134, step = 501 (0.407 sec)
INFO:tensorflow:global_step/sec: 155.966
INFO:tensorflow:loss = 11509.922, step = 601 (0.641 sec)
INFO:tensorflow:global_step/sec: 263.256
INFO:tensorflow:loss = 11272.889, step = 701 (0.379 sec)
INFO:tensorflow:global_step/sec: 254.112
INFO:tensorflow:loss = 11051.9795, step = 801 (0.396 sec)
INFO:tensorflow:global_step/sec: 292.405
INFO:tensorflow:loss = 10845.855, step = 901 (0.341 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Você pode verificar o TensorBoard com o seguinte comando:
activate hello-tf
# For MacOS
tensorboard --logdir=./train
# For Windows
tensorboard --logdir=train
Passo 5) Avalie seu modelo
Você pode avaliar o ajuste do seu modelo no conjunto de teste com o código abaixo:
ev = estimator.evaluate(
          input_fn=get_input_fn(test_set,
          num_epochs=1,
          n_batch = 128,
          shuffle=False))
saída
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
Você pode imprimir a perda com o código abaixo:
loss_score = ev["loss"]
print("Loss: {0:f}".format(loss_score))
saída
Loss: 3215.895996
O modelo apresenta uma perda de 3215. Você pode consultar as estatísticas resumidas para ter uma ideia da magnitude do erro.
training_set['medv'].describe()
saída
count    400.000000
mean      22.625500
std        9.572593
min        5.000000
25%       16.600000
50%       21.400000
75%       25.025000
max       50.000000
Name: medv, dtype: float64
A partir das estatísticas resumidas acima, você sabe que o preço médio de uma casa é de 22 mil, com um preço mínimo de 5 mil e um máximo de 50 mil. Como a perda relatada é o erro quadrático médio, o erro típico nas unidades originais é aproximadamente a raiz quadrada de 32.16, o que equivale a cerca de 5.7 mil dólares.
Passo 6) Faça a previsão
Por fim, você pode usar o método `predict` do TensorFlow para estimar o valor de seis casas em Boston.
y = estimator.predict(
         input_fn=get_input_fn(prediction_set,
         num_epochs=1,
         n_batch = 128,
         shuffle=False))
Para imprimir os valores estimados, você pode usar este código:
predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
saída
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.96125], dtype=float32), array([27.270979], dtype=float32), array([29.299236], dtype=float32), array([16.436684], dtype=float32), array([21.460876], dtype=float32)]
O modelo prevê os seguintes valores:
| Casa | Predição |
| 1 | 32.29 |
| 2 | 18.96 |
| 3 | 27.27 |
| 4 | 29.29 |
| 5 | 16.43 |
| 6 | 21.46 |
Note que não conhecemos o valor real dessas seis casas. No tutorial de aprendizado profundo, você tentará superar o modelo linear.
Solução NumPy
Esta seção explica como treinar o modelo usando um estimador NumPy para alimentar os dados. O método é o mesmo, exceto que você usará o estimador numpy_input_fn.
Leia os mesmos três arquivos CSV, mas mantenha apenas os arrays NumPy brutos com o prefixo .values.
training_set_n = pd.read_csv("E:/boston_train.csv").values
test_set_n = pd.read_csv("E:/boston_test.csv").values
prediction_set_n = pd.read_csv("E:/boston_predict.csv").values
Passo 1) Importar os dados
Primeiramente, você precisa diferenciar as variáveis de atributos dos rótulos. Isso deve ser feito tanto para os dados de treinamento quanto para os dados de avaliação. É mais rápido definir uma função para dividir os dados.
def prepare_data(df):
        X_train = df[:, :-3]
        y_train = df[:,-3]
        return X_train, y_train
Você pode usar a função para separar o rótulo das características dos conjuntos de dados de treinamento e avaliação.
X_train, y_train = prepare_data(training_set_n)
X_test, y_test = prepare_data(test_set_n)
Você precisa excluir a última coluna do conjunto de dados de previsão porque ela contém apenas valores NaN.
x_predict = prediction_set_n[:, :-2]
Confirme o formato da matriz. Observe que o rótulo não deve ter uma segunda dimensão, ou seja, (400,).
print(X_train.shape, y_train.shape, x_predict.shape)
saída
(400, 9) (400,) (6, 9)
Você pode construir as colunas de recursos da seguinte forma:
feature_columns = [ tf.feature_column.numeric_column('x', shape=X_train.shape[1:])]
O estimador é definido como antes: você especifica as colunas de recursos e onde salvar o gráfico.
estimator = tf.estimator.LinearRegressor(
         feature_columns=feature_columns,
         model_dir="train1")
saída
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train1', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a218d8f28>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Você pode usar o estimador NumPy para alimentar o modelo com os dados e, em seguida, treiná-lo. Observe que definimos a função `input_fn` previamente para facilitar a leitura.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
           x={"x": X_train},
           y=y_train,
           batch_size=128,
           shuffle=False,
           num_epochs=None)
estimator.train(input_fn = train_input,steps=5000)
saída
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train1/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 490.057
INFO:tensorflow:loss = 13909.656, step = 101 (0.206 sec)
INFO:tensorflow:global_step/sec: 788.986
INFO:tensorflow:loss = 12881.45, step = 201 (0.126 sec)
INFO:tensorflow:global_step/sec: 736.339
INFO:tensorflow:loss = 12391.541, step = 301 (0.136 sec)
INFO:tensorflow:global_step/sec: 383.305
INFO:tensorflow:loss = 12050.561, step = 401 (0.260 sec)
INFO:tensorflow:global_step/sec: 859.832
INFO:tensorflow:loss = 11766.133, step = 501 (0.117 sec)
INFO:tensorflow:global_step/sec: 804.394
INFO:tensorflow:loss = 11509.918, step = 601 (0.125 sec)
INFO:tensorflow:global_step/sec: 753.059
INFO:tensorflow:loss = 11272.891, step = 701 (0.134 sec)
INFO:tensorflow:global_step/sec: 402.165
INFO:tensorflow:loss = 11051.979, step = 801 (0.248 sec)
INFO:tensorflow:global_step/sec: 344.022
INFO:tensorflow:loss = 10845.854, step = 901 (0.288 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train1/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.985.
Out[23]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x1a1b6ea860>
Você repete o mesmo passo com uma função de entrada diferente para avaliar seu modelo.
eval_input = tf.estimator.inputs.numpy_input_fn(
       x={"x": X_test},
       y=y_test,
       shuffle=False,
       batch_size=128,
       num_epochs=1)
   estimator.evaluate(eval_input,steps=None)
saída
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.158947, global_step = 1000, loss = 3215.8945
Out[24]:
{'average_loss': 32.158947, 'global_step': 1000, 'loss': 3215.8945}
Por fim, você pode calcular a previsão. Ela deve ser semelhante ao resultado do Pandas.
test_input = tf.estimator.inputs.numpy_input_fn(
        x={"x": x_predict},
        batch_size=128,
        num_epochs=1,
        shuffle=False)
        y = estimator.predict(test_input)

predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
saída
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.961248], dtype=float32), array([27.270979], dtype=float32), array([29.299242], dtype=float32), array([16.43668], dtype=float32), array([21.460878], dtype=float32)]
Solução TensorFlow
A última seção é dedicada a um puro TensorFlow solução. Este método é um pouco mais complicado que os outros dois.
Observe que se você usar um Jupyter cadernoPara executar esta sessão, você precisa reiniciar e limpar o kernel.
O TensorFlow criou uma ótima ferramenta para passar os dados para o pipeline. Nesta seção, você criará a função `input_fn` por conta própria.
Passo 1) Defina o caminho e o formato dos dados
Primeiramente, você declara duas variáveis com o caminho dos arquivos CSV. Observe que você tem dois arquivos, um para o conjunto de treinamento e outro para o conjunto de teste.
import tensorflow as tf
df_train = "E:/boston_train.csv"
df_eval = "E:/boston_test.csv"
Em seguida, você precisa definir as colunas que deseja usar do arquivo CSV. Usaremos todas elas. Depois disso, você precisa declarar o tipo de cada variável.
Variáveis de ponto flutuante são definidas por [0.]
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
                "dis", "tax", "ptratio", "medv"]
RECORDS_ALL = [[0.0], [0.0], [0.0], [0.0],[0.0],[0.0],[0.0],[0.0],[0.0],[0.0]]
Passo 2) Defina a função input_fn
A função pode ser dividida em três partes:
- Importar os dados
- Crie o iterador
- Consumir os dados
Abaixo está o código geral para definir a função. O código será explicado posteriormente.
def input_fn(data_file, batch_size, num_epoch = None):
       # Step 1
          def parse_csv(value):
          columns = tf.decode_csv(value, record_defaults= RECORDS_ALL)
          features = dict(zip(COLUMNS, columns))
          #labels = features.pop('median_house_value')
          labels =  features.pop('medv')
          return features, labels

          # Extract lines from input files using the Dataset API.
          dataset = (tf.data.TextLineDataset(data_file) # Read text file
          .skip(1) # Skip header row
          .map(parse_csv))

          dataset = dataset.repeat(num_epoch)
          dataset = dataset.batch(batch_size)
          # Step 3
          iterator = dataset.make_one_shot_iterator()
          features, labels = iterator.get_next()
          return features, labels
Importar os dados
Para um arquivo CSV, o método `dataset` lê uma linha por vez. Para construir o conjunto de dados, você precisa usar o objeto. TextLineConjunto de dados. Seu conjunto de dados possui um cabeçalho, então você precisa usar skip(1) para pular a primeira linha. Neste ponto, você apenas lê os dados e exclui o cabeçalho no pipeline. Para alimentar o modelo, você precisa separar os recursos dos rótulos. O método usado para aplicar qualquer transformação aos dados é map.
Este método chama uma função que você criará para instruir como transformar os dados. Em resumo, você precisa passar os dados para a função. TextLineObjeto de conjunto de dados, excluir o cabeçalho e aplicar uma transformação conforme instruído por uma função.
Code explicação
- tf.dados.TextLineDataset(data_file): esta linha lê o arquivo CSV
- .skip(1): ignora o cabeçalho
- .map(parse_csv)): analisa os registros e os transforma em tensores
Você precisa definir uma função para instruir o objeto de mapa. Você pode chamar essa função de parse_csv.
Esta função analisa o arquivo CSV com o método `tf.decode_csv` e declara as características e o rótulo. As características podem ser declaradas como um dicionário ou uma tupla. Você usa o método de dicionário porque é mais conveniente.
Code explicação
- tf.decode_csv(value, record_defaults= RECORDS_ALL): o método decode_csv usa a saída do TextLineConjunto de dados para ler o arquivo CSV. `record_defaults` instrui o TensorFlow sobre os tipos de coluna. No TensorFlow 2.x, esse símbolo reside em `tf.io.decode_csv`.
- dict(zip(COLUMNS, columns)): preenche o dicionário com todas as colunas extracdurante este processamento de dados
- features.pop('medv'): exclui a variável alvo das variáveis de características e cria uma variável de rótulo.
O conjunto de dados precisa de mais elementos para alimentar os tensores iterativamente. De fato, você precisa adicionar o método `repeat` para permitir que o conjunto de dados continue alimentando o modelo indefinidamente. Se você não adicionar o método, o modelo iterará apenas uma vez e, em seguida, lançará um erro porque não há mais dados sendo inseridos no pipeline.
Depois disso, você pode controlar o tamanho do lote com o método `batch`. Isso significa que você informa ao conjunto de dados a quantidade de dados que deseja passar para o pipeline em cada iteração. Se você definir um tamanho de lote grande, o modelo ficará lento.
Passo 3) Crie o iterador
Agora você está pronto para a segunda etapa: crie um iterador para retornar os elementos do conjunto de dados.
A maneira mais simples de criar um operador é com o método make_one_shot_iterator.
Depois disso, você pode criar os recursos e rótulos do iterador.
Passo 4) Consumir os dados
Você pode verificar o que acontece com a função `input_fn`. É necessário chamar a função em uma sessão para consumir os dados. Tente com um tamanho de lote igual a 1.
Observe que ele imprime as características em um dicionário e o rótulo como uma matriz.
Isso exibirá a primeira linha do arquivo CSV. Você pode tentar executar este código várias vezes com diferentes tamanhos de lote.
next_batch = input_fn(df_train, batch_size = 1, num_epoch = None)
with tf.Session() as sess:
     first_batch  = sess.run(next_batch)
     print(first_batch)
saída
({'crim': array([2.3004], dtype=float32), 'zn': array([0.], dtype=float32), 'indus': array([19.58], dtype=float32), 'nox': array([0.605], dtype=float32), 'rm': array([6.319], dtype=float32), 'age': array([96.1], dtype=float32), 'dis': array([2.1], dtype=float32), 'tax': array([403.], dtype=float32), 'ptratio': array([14.7], dtype=float32)}, array([23.8], dtype=float32))
Passo 5) Defina a coluna de recursos
Você precisa definir as colunas numéricas da seguinte forma:
X1= tf.feature_column.numeric_column('crim')
X2= tf.feature_column.numeric_column('zn')
X3= tf.feature_column.numeric_column('indus')
X4= tf.feature_column.numeric_column('nox')
X5= tf.feature_column.numeric_column('rm')
X6= tf.feature_column.numeric_column('age')
X7= tf.feature_column.numeric_column('dis')
X8= tf.feature_column.numeric_column('tax')
X9= tf.feature_column.numeric_column('ptratio')
Observe que você precisa combinar todas as variáveis em um único bucket.
base_columns = [X1, X2, X3,X4, X5, X6,X7, X8, X9]
Passo 6) Construa o modelo
Você pode treinar o modelo com o estimador LinearRegressor.
model = tf.estimator.LinearRegressor(feature_columns=base_columns, model_dir='train3')
saída
INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_model_dir': 'train3', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1820a010f0>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Você precisa usar um função lambda para permitir que você escreva os argumentos para a função `input_fn`. Se você não usar uma função lambda, não poderá treinar o modelo.
# Train the estimator
model.train(steps =1000,
          input_fn= lambda : input_fn(df_train,batch_size=128, num_epoch = None))
saída
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train3/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 72.5646
INFO:tensorflow:loss = 13909.657, step = 101 (1.380 sec)
INFO:tensorflow:global_step/sec: 101.355
INFO:tensorflow:loss = 12881.449, step = 201 (0.986 sec)
INFO:tensorflow:global_step/sec: 109.293
INFO:tensorflow:loss = 12391.541, step = 301 (0.915 sec)
INFO:tensorflow:global_step/sec: 102.235
INFO:tensorflow:loss = 12050.5625, step = 401 (0.978 sec)
INFO:tensorflow:global_step/sec: 104.656
INFO:tensorflow:loss = 11766.134, step = 501 (0.956 sec)
INFO:tensorflow:global_step/sec: 106.697
INFO:tensorflow:loss = 11509.922, step = 601 (0.938 sec)
INFO:tensorflow:global_step/sec: 118.454
INFO:tensorflow:loss = 11272.889, step = 701 (0.844 sec)
INFO:tensorflow:global_step/sec: 114.947
INFO:tensorflow:loss = 11051.9795, step = 801 (0.870 sec)
INFO:tensorflow:global_step/sec: 111.484
INFO:tensorflow:loss = 10845.855, step = 901 (0.897 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train3/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Out[8]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x18225eb8d0>
Você pode avaliar o ajuste do seu modelo no conjunto de teste com o código abaixo:
results = model.evaluate(steps =None,input_fn=lambda: input_fn(df_eval, batch_size =128, num_epoch = 1))
for key in results:
print("   {}, was: {}".format(key, results[key]))
saída
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
   average_loss, was: 32.158958435058594
   loss, was: 3215.89599609375
   global_step, was: 1000
O último passo é prever o valor do alvo com base nos valores da matriz de características. Você pode escrever um dicionário com os valores que deseja prever. Seu modelo possui nove características, então você precisa fornecer um valor para cada uma delas. O modelo fornecerá uma previsão para cada uma.
No código abaixo, você insere os valores de cada característica contida no arquivo CSV df_predict.
Você precisa escrever uma nova função `input_fn` porque não há rótulos no conjunto de dados. Você pode usar a API `from_tensors` do objeto `Dataset`.
prediction_input = {
          'crim': [0.03359,5.09017,0.12650,0.05515,8.15174,0.24522],
          'zn': [75.0,0.0,25.0,33.0,0.0,0.0],
          'indus': [2.95,18.10,5.13,2.18,18.10,9.90],
          'nox': [0.428,0.713,0.453,0.472,0.700,0.544],
          'rm': [7.024,6.297,6.762,7.236,5.390,5.782],
          'age': [15.8,91.8,43.4,41.1,98.9,71.7],
          'dis': [5.4011,2.3682,7.9809,4.0220,1.7281,4.0317],
          'tax': [252,666,284,222,666,304],
          'ptratio': [18.3,20.2,19.7,18.4,20.2,18.4]
     }
     def test_input_fn():
     dataset = tf.data.Dataset.from_tensors(prediction_input)
     return dataset

     # Predict all our prediction_input
     pred_results = model.predict(input_fn=test_input_fn)
Por fim, imprima as previsões.
for pred in enumerate(pred_results):
print(pred)
saída
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
(0, {'predictions': array([32.297546], dtype=float32)})
(1, {'predictions': array([18.96125], dtype=float32)})
(2, {'predictions': array([27.270979], dtype=float32)})
(3, {'predictions': array([29.299236], dtype=float32)})
(4, {'predictions': array([16.436684], dtype=float32)})
(5, {'predictions': array([21.460876], dtype=float32)})

INFO:tensorflow:Calling model_fn. INFO:tensorflow:Done calling model_fn. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from train3/model.ckpt-5000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. (0, {'predictions': array([35.60663], dtype=float32)}) (1, {'predictions': array([22.298521], dtype=float32)}) (2, {'predictions': array([25.74533], dtype=float32)}) (3, {'predictions': array([35.126694], dtype=float32)}) (4, {'predictions': array([17.94416], dtype=float32)}) (5, {'predictions': array([22.606628], dtype=float32)})
Os três pipelines retornam as mesmas seis previsões, o que confirma que a escolha entre Pandas, NumPy e um conjunto de dados nativo do TensorFlow é uma questão de conveniência, e não de precisão.
