
Como instalar e configurar o metastore HIVE com MYSQL
 David Carter
⚡ Resumo Inteligente
O metastore do Hive armazena todas as definições de tabelas, nomes de colunas e tipos de dados por trás do Apache Hive, e a migração desse repositório do banco de dados Derby padrão para MySQL É o que permite que vários usuários se conectem ao mesmo tempo.
O que é HIVE Metastore?
O metastore do Hive é um repositório que armazena metadados (nomes de colunas, tipos de dados, comentários, etc.) relacionados a Colmeia Apache utilizando MySQL or PostgreSQL. Este metastore Hive é implementado usando tabelas em um banco de dados relacional.
Nada no metastore armazena as linhas em si. Os registros permanecem no HDFS, e o metastore apenas registra onde cada tabela reside e quais são os nomes de suas colunas, razão pela qual a perda dele afeta o esquema, e não os dados.
Por que usar MySQL no Hive como Metastore
O backend do metastore é opcional, não uma parte fixa do Hive, e a configuração padrão fornecida é propositalmente minimalista. Três limitações praticamente impedem o seu uso em todas as instalações.
- Por padrão, o Hive utiliza o banco de dados Derby como metastore.
- O Derby suporta apenas um único usuário ativo por vez.
- O uso de Derby não é recomendado em ambientes de produção.
Portanto, a solução aqui é
- Uso MySQL como armazenamento de metadados no backend para conectar vários usuários ao Hive simultaneamente.
- MySQL é a melhor opção para o metastore independente
Como instalar e configurar o Hive Metastore para MySQL banco de dados
Os nove passos abaixo são executados em sequência em uma máquina que já possui o Hadoop e o Hive instalados. Cada passo termina com uma captura de tela da saída real do terminal ou shell.
Etapa 1) Instalar MySQL servidor
Nesta etapa, vamos realizar duas tarefas
- Instalação do servidor mysql
- Verificando o servidor mysql e seu processo
Com o sudo apt-get install mysql-server comando, podemos baixar MySQL servidor. Instalar MySQL como mostrado na imagem abaixo.

Após a instalação bem-sucedida, MySQL O processo será executado conforme mostrado na captura de tela abaixo, onde a verificação confirma que o serviço está em funcionamento.

Etapa 2) Instalar MySQL Java Connector
Instalando o MySQL Java conector. Isto é para Java dependências e propósitos de conexão, porque o Hive alcança MySQL via JDBC. A próxima captura de tela mostra a instalação do pacote.

Etapa 3) Criar link flexível para conector
Criando um link simbólico para o conector no diretório lib do Hive. Este é o link simbólico entre Java e MySQLE é isso que coloca o arquivo JAR do driver no classpath do Hive. O comando e seu resultado aparecem abaixo.

Etapa 4) Configurando MySQL armazenamento no Hive
O MySQL É necessário abrir o shell como usuário root antes de criar qualquer usuário do Hive, conforme mostrado a seguir.

- Digite mysql –u root –p seguido da senha
- Aqui, –u representa o nome de usuário root e –p representa a senha.
- Após inserir o comando acima, o usuário deve digitar uma senha válida e pressionar Enter.
- Então entrará em MySQL modo shell
Etapa 5) Crie nome de usuário e senha
Criar um nome de usuário e uma senha para MySQLe concedendo privilégios. A captura de tela abaixo mostra as três instruções sendo executadas dentro do MySQL Concha.

Temos que executar os comandos conforme mostrado abaixo,
mysql> CREATE USER 'hiveuser'@'%' IDENTIFIED BY 'hivepassword';
mysql> GRANT all on *.* to 'hiveuser'@localhost identified by 'hivepassword';
mysql>  flush privileges;
On MySQL 8. A forma combinada da segunda instrução não é mais analisada, porque IDENTIFIED BY foi removido de GRANT. Crie a conta primeiro e depois conceda os privilégios a ela, e repita a linha CREATE USER para o host localhost, bem como para o host curinga.
Etapa 6) Configurando o arquivo hive-site.xml
- Após a Etapa 5, um nome de usuário e uma senha são atribuídos ao MySQL banco de dados e concede privilégios.
- Aqui, configuraremos algumas propriedades no Hive para obter uma conexão com o MySQL base de dados.
O arquivo de configuração é aberto a partir do diretório conf do Hive, como mostra a próxima captura de tela.

A captura de tela a seguir mostra o arquivo finalizado com todas as quatro propriedades definidas.

A partir da captura de tela acima, observamos o seguinte. Aqui, estamos definindo 4 propriedades que são necessárias para estabelecer MySQL como o metastore no Hive.
Estes são os seguintes:
- Esta propriedade destina-se à ligação. URLAqui estamos definindo Conexão.URL Nessa propriedade, ela funciona como a string de conexão JDBC e também representa a localização do metastore.
- Esta propriedade se refere ao nome do driver de conexão. Aqui, `com.mysql.jdbc.Driver` é o valor que devemos mencionar na tag `value`.
- Essa propriedade é usada para definir o nome de usuário da conexão. Aqui, definimos “hiveuser” como o nome de usuário.
- Essa propriedade é usada para especificar a senha de conexão. Nela, definimos “hivepassword” como a senha do usuário.
Após inserir as propriedades no arquivo hive-site.xml, é necessário salvar manualmente (Ctrl+S) e fechar o arquivo. Depois de fechá-lo, é preciso criar uma tabela Hive e verificar os detalhes da tabela em MySQL armazenamento.
Coloque este código em hive-site.xml
hive-site.xml
<configuration>
	<property>
		<name>javax.jdo.option.ConnectionURL</name>
		<value>jdbc:mysql://localhost/metastore?createDatabaseIfNotExist=true</value>
		<description>metadata is stored in a MySQL server</description>
	</property>
	<property>
		<name>javax.jdo.option.ConnectionDriverName</name>
		<value>com.mysql.jdbc.Driver</value>
		<description>MySQL JDBC driver class</description>
	</property>
	<property>
		<name>javax.jdo.option.ConnectionUserName</name>
		<value>hiveuser</value>
		<description>user name for connecting to mysql server</description>
	</property>
	<property>
		<name>javax.jdo.option.ConnectionPassword</name>
		<value>hivepassword</value>
		<description>password for connecting to mysql server</description>
	</property>
</configuration>
Os dois valores acima dependem da versão do conector em uso. MySQL O Connector/J 8 renomeou a classe do driver para com.mysql.cj.jdbc.Driver e também espera uma porta explícita e uma configuração SSL, portanto, é uma versão moderna. URL Normalmente, o arquivo lê jdbc:mysql://localhost:3306/metastore?createDatabaseIfNotExist=true&useSSL=false. Como a senha está em texto não criptografado, o arquivo deve ser legível apenas pela conta de serviço do Hive.
Etapa 7) Criar tabela
Crie a tabela “guru99” no Hive, conforme mostrado no shell do Hive abaixo.

Na captura de tela acima, podemos observar o seguinte
- Criação de uma tabela chamada “guru99” com dois nomes de coluna.
- Os nomes das colunas são mencionados com seus respectivos tipos de dados, uma sendo um número inteiro e a outra uma string.
Na próxima etapa, vamos verificar se ele está armazenado em MySQL ou não.
Etapa 8) Entre em MySQL modo shell
O banco de dados metastore é selecionado primeiro, e a listagem da tabela que se segue é mostrada abaixo.

Na captura de tela acima, podemos observar o seguinte
- Primeiro, precisamos selecionar o banco de dados com a opção “usar metastore”.
- Após selecionar o metastore, podemos verificar as tabelas presentes nele usando o comando “show tables”, como mostrado na captura de tela.
- Quaisquer tabelas criadas no Hive têm seus metadados armazenados em TBLS (tabelas baseadas em tabelas). MySQL banco de dados
- A tabela “guru99” é criada no Hive, portanto os metadados correspondentes são armazenados em MySQL sob TBLS
Etapa 9) Digite select * de TBLS
Verificar se a tabela criada está presente em MySQL ou não. A consulta e seu resultado aparecem na captura de tela abaixo.
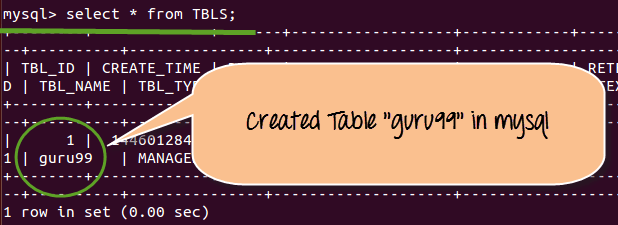
Ao inserir select * de TBLS, serão exibidas as tabelas que criamos no modo Hive Shell
Na captura de tela acima, podemos observar o seguinte:
- O nome da tabela “guru99” que foi criada no Hive pode ser exibido em MySQL modo shell
- Além disso, também fornecerá informações como a hora de criação da tabela, a hora de acesso e outras propriedades, conforme mostrado na captura de tela acima.
Como inicializar o esquema do metastore do Hive com o schematool
O sinalizador createDatabaseIfNotExist na conexão URL Cria um banco de dados metastore vazio, mas não cria as aproximadamente setenta tabelas que o Hive espera encontrar dentro dele. No Hive 1.x e versões posteriores, essa tarefa pertence ao utilitário schematool e deve ser ignorada.ping Essa é a razão mais comum pela qual um metastore recém-configurado se recusa a iniciar.
$HIVE_HOME/bin/schematool -dbType mysql -initSchema
O comando lê as mesmas quatro propriedades do arquivo hive-site.xml, conecta-se à conta hiveuser e executa o script SQL incluído que corresponde à versão do Hive. Uma execução bem-sucedida termina com uma mensagem de conclusão, após a qual o estado pode ser confirmado a qualquer momento.
$HIVE_HOME/bin/schematool -dbType mysql -info
Os indicadores abaixo abrangem todo o ciclo de vida de um esquema de metastore.
| Opção | O que ele faz |
|---|---|
| -dbType | Indica o banco de dados (backend), como mysql, derby, postgres, oracle ou mssql. |
| -initSchema | Cria as tabelas do metastore para a versão atual do Hive. |
| -informações | Relata a versão do esquema registrada no banco de dados. |
| -upgradeSchema | Migra um esquema existente após uma atualização do Hive. |
| -validar | Verifica o esquema em busca de tabelas ausentes e incompatibilidades de versão. |
Uma propriedade relacionada que vale a pena conhecer antes da primeira execução. Quando `hive.metastore.schema.verification` é verdadeiro, o Hive compara a versão do esquema em MySQL contra si próprio e se recusa a executar em caso de incompatibilidade. Essa verificação é uma medida de segurança, portanto, a resposta correta é executar a atualização em vez de desativá-la. O mesmo ocorre com o sistema. MySQL O backend é usado pela instalação do Hive abordada em Instalar o Hive em Ubuntu.
Erros comuns do metastore do Hive e como corrigi-los
A maioria das falhas nesta fase produz uma de algumas mensagens específicas, e cada uma delas aponta para uma etapa anterior, em vez de para o próprio Hive.
| Sintoma | Causa e solução |
|---|---|
| Informações de versão não encontradas no metastore | O esquema nunca foi criado. Execute o schematool com o parâmetro -initSchema no mesmo banco de dados especificado na conexão. URL |
| Exceção ClassNotFoundException para o driver JDBC | O arquivo JAR do conector está faltando no diretório lib do Hive, ou o Connector/J 8 está em uso e a classe agora é com.mysql.cj.jdbc.Driver. Verifique novamente o link simbólico da Etapa 3. |
| Acesso negado para o usuário hiveuser | Os privilégios foram concedidos a apenas um host. Crie a conta para o localhost e para o host curinga e, em seguida, execute o comando `flush privileges`. |
| Erro de sintaxe próximo a IDENTIFIED BY | MySQL 8. Removemos o IDENTIFIED BY da instrução GRANT. Execute primeiro o comando CREATE USER e, em seguida, o GRANT. |
| A recuperação da chave pública não é permitida. | Por padrão, o Connector/J 8 rejeita um handshake não criptografado. Adicione `useSSL=false` e `allowPublicKeyRetrieval=true` ao JDBC. URL em uma rede confiável |
| Tabelas estão faltando após uma atualização do Hive. | O esquema ainda corresponde à versão antiga. Execute o schematool com o parâmetro -upgradeSchema em vez de desativar a verificação de esquema. |
Assim que o metastore responder de forma confiável, as definições de tabela que ele registra serão criadas com as instruções descritas em Hive cria, altera e exclui tabelas.
