
Tutorial de junção e subconsulta do Hive com exemplos
 Equipe editorial
⚡ Resumo Inteligente
As junções do Hive combinam linhas de duas ou mais tabelas com base em uma coluna correspondente, e as subconsultas aninham uma consulta dentro de outra; ambas são demonstradas aqui em duas tabelas de exemplo carregadas de arquivos de texto simples.
Junte-se a consultas
Consultas de junção podem ser realizadas em duas tabelas presentes em ColméiaPara entender melhor os conceitos de junção, criaremos duas tabelas aqui:
- amostras_joins (relacionadas a detalhes do cliente)
- sample_joins1 (relacionado aos detalhes dos pedidos feitos pelos funcionários)
Passo 1) Criação da tabela “sample_joins” com as colunas Id, Nome, Idade, Endereço e Salário dos funcionários. A captura de tela abaixo mostra a instrução CREATE TABLE e sua confirmação.

Passo 2) Carregando e exibindo dados. A próxima captura de tela mostra o comando de carregamento seguido pelo conteúdo da tabela.
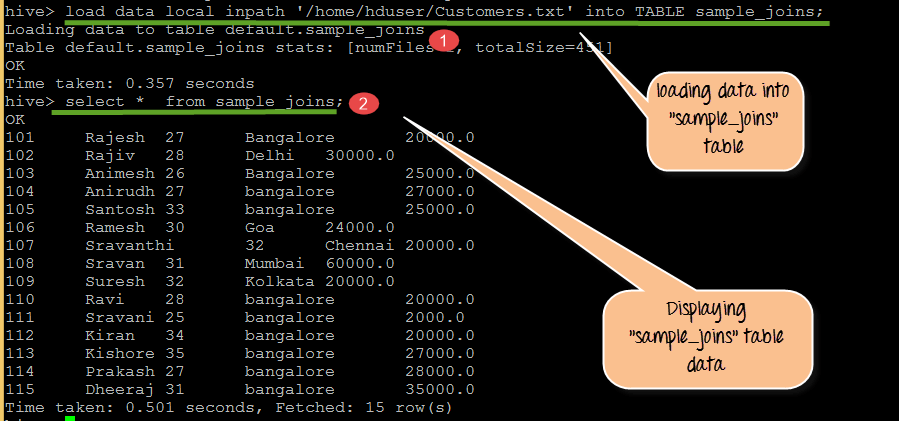
Conforme a captura de tela acima:
- Carregando dados em sample_joins de Customers.txt
- Exibindo o conteúdo da tabela sample_joins
Passo 3) Criação da tabela sample_joins1 e, em seguida, carregamento e exibição de seus dados, conforme mostrado na captura de tela abaixo.

A partir da captura de tela acima, podemos observar o seguinte:
- Criação da tabela sample_joins1 com as colunas Orderid, Date1, Id e Amount.
- Carregando dados em sample_joins1 deorders.txt
- Exibindo registros presentes em sample_joins1
A seguir, veremos os diferentes tipos de junções que podem ser realizadas nas tabelas que criamos. Antes disso, você precisa considerar os seguintes pontos sobre junções.
Alguns pontos a observar nas junções:
- Somente junções por igualdade são permitidas em junções.
- Mais de duas tabelas podem ser unidas na mesma consulta
- As junções LEFT, RIGHT e FULL OUTER existem para fornecer mais controle sobre a cláusula ON para a qual não há correspondência.
- As junções não são comutativas.
- As junções são associativas à esquerda, independentemente de serem junções ESQUERDA ou DIREITA
A restrição de igualdade reflete o Hive como era há muitos anos. A partir da versão 2.2.0, expressões complexas na cláusula ON são suportadas (HIVE-15211), portanto, uma condição de não igualdade é aceita na versão atual. Em versões mais antigas, a condição precisa ser um teste de igualdade, com qualquer outra condição sendo movida para uma cláusula WHERE.
Diferentes tipos de junções
Existem quatro tipos de junções. São elas:
- Junção interna
- Junção externa esquerda
- Junção externa direita
- Junção externa completa
Cada tipo é demonstrado abaixo em relação às mesmas duas tabelas, portanto, a única coisa que muda entre os exemplos é quais linhas não correspondentes permanecem.
Junção interna
Os registros comuns a ambas as tabelas serão recuperados por meio dessa junção interna. O resultado na captura de tela abaixo contém apenas os clientes que possuem um pedido correspondente.

A partir da captura de tela acima, podemos observar o seguinte:
- Aqui estamos realizando uma consulta de junção usando a palavra-chave JOIN entre as tabelas sample_joins e sample_joins1, com a condição de correspondência (c.Id = o.Id).
- O resultado exibe os registros comuns presentes em ambas as tabelas, selecionados verificando a condição mencionada na consulta.
Inquérito:
SELECT c.Id, c.Name, c.Age, o.Amount FROM sample_joins c JOIN sample_joins1 o ON(c.Id=o.Id);
União Externa Esquerda
- HiveQLGenericName LEFT OUTER JOIN retorna todas as linhas da tabela da esquerda, mesmo que não haja correspondências na tabela da direita.
- Se a cláusula ON não encontrar nenhum registro na tabela da direita, a junção ainda retornará um registro no resultado com NULL em cada coluna da tabela da direita.
A captura de tela abaixo mostra que todos os clientes aparecem, incluindo aqueles que não fizeram nenhum pedido.

A partir da captura de tela acima, podemos observar o seguinte:
- Aqui, estamos realizando uma consulta de junção usando a palavra-chave “LEFT OUTER JOIN” entre as tabelas sample_joins e sample_joins1, com a condição de correspondência (c.Id = o.Id). Por exemplo, aqui estamos usando o ID do funcionário como referência; verificamos se o ID é comum tanto à tabela da direita quanto à tabela da esquerda. Isso funciona como a condição de correspondência.
- A saída exibe os registros selecionados pela condição mencionada na consulta. Os valores NULL na saída acima representam colunas sem valores da tabela correta, ou seja, sample_joins1.
Inquérito:
SELECT c.Id, c.Name, o.Amount, o.Date1 FROM sample_joins c LEFT OUTER JOIN sample_joins1 o ON(c.Id=o.Id)
Junção Externa Direita
- A consulta RIGHT OUTER JOIN do HiveQL retorna todas as linhas da tabela da direita, mesmo que não haja correspondências na tabela da esquerda.
- Se a cláusula ON não encontrar nenhum registro na tabela da esquerda, a junção ainda retornará um registro no resultado com NULL em cada coluna da tabela da esquerda.
- A junção RIGHT sempre retorna registros da tabela à direita e registros correspondentes da tabela à esquerda. Se a tabela à esquerda não tiver nenhum valor correspondente à coluna, ela retornará valores NULL nesse local.
A captura de tela abaixo mostra a imagem espelhada do resultado anterior: todos os pedidos aparecem, correspondidos ou não.

A partir da captura de tela acima, podemos observar o seguinte:
- Aqui estamos realizando uma consulta de junção usando a palavra-chave “RIGHT OUTER JOIN” entre as tabelas sample_joins e sample_joins1, com a condição de correspondência (c.Id = o.Id).
- O resultado exibe os registros selecionados verificando a condição mencionada na consulta.
Inquérito:
SELECT c.Id, c.Name, o.Amount, o.Date1 FROM sample_joins c RIGHT OUTER JOIN sample_joins1 o ON(c.Id=o.Id)
Junção Externa Completa
Ela combina os registros das tabelas sample_joins e sample_joins1 com base na condição JOIN fornecida na consulta.
A função retorna todos os registros de ambas as tabelas e preenche os valores NULL nas colunas cujos valores correspondentes estão ausentes em um dos lados, conforme mostra a captura de tela abaixo.

A partir da captura de tela acima, podemos observar o seguinte:
- Aqui estamos realizando uma consulta de junção usando a palavra-chave “FULL OUTER JOIN” entre as tabelas sample_joins e sample_joins1, com a condição de correspondência (c.Id = o.Id).
- O resultado exibe todos os registros presentes em ambas as tabelas, selecionados verificando a condição mencionada na consulta. Os valores NULL no resultado indicam os valores ausentes nas colunas de ambas as tabelas.
Inquérito:
SELECT c.Id, c.Name, o.Amount, o.Date1 FROM sample_joins c FULL OUTER JOIN sample_joins1 o ON(c.Id=o.Id)
Subconsultas
As junções colocam tabelas lado a lado. Uma subconsulta faz algo diferente: ela aninha uma consulta dentro de outra, de forma que a consulta externa possa trabalhar com um resultado que já foi calculado.
Uma consulta contida dentro de outra consulta é conhecida como subconsulta. A consulta principal dependerá dos valores retornados pela subconsulta.
As subconsultas podem ser classificadas em dois tipos:
- Subconsultas na cláusula FROM
- Subconsultas na cláusula WHERE
Quando usar:
- Para obter um valor específico combinado de dois valores de colunas de tabelas diferentes
- Dependência dos valores de uma tabela em relação aos valores de outras tabelas.
- Verificação comparativa dos valores de uma coluna em relação aos valores de outras tabelas.
Sintaxe:
Subquery in FROM clause
SELECT <column names 1, 2…n>From (SubQuery) <TableName_Main >
Subquery in WHERE clause
SELECT <column names 1, 2…n> From<TableName_Main>WHERE col1 IN (SubQuery);
Exemplo:
SELECT col1 FROM (SELECT a+b AS col1 FROM t1) t2
Aqui, t1 e t2 são nomes de tabelas. A instrução interna é a subconsulta realizada na tabela t1. Aqui, a e b são colunas adicionadas na subconsulta e atribuídas a col1. Col1 é o valor da coluna presente na tabela principal. Essa coluna “col1” presente na subconsulta é equivalente à consulta da tabela principal na coluna col1.
Incorporando scripts personalizados
Enquanto uma subconsulta remodela os dados usando apenas o HiveQL, um script incorporado entrega as linhas para um código escrito fora do Hive.
O Hive permite escrever scripts específicos para atender aos requisitos do cliente. Os usuários podem escrever seus próprios scripts de mapeamento e redução para esses requisitos. Esses scripts são chamados de scripts personalizados incorporados. A lógica de codificação é definida no script personalizado, e podemos usar esse script durante o processo de ETL.
Quando optar por scripts incorporados:
- Onde os requisitos específicos do cliente exigem que os desenvolvedores escrevam e implementem scripts no Hive.
- Onde as funções integradas do Hive não funcionarão para requisitos de domínio específicos
Para isso, o Hive utiliza a cláusula TRANSFORM para incorporar os scripts de mapeamento e de redução.
Nesses scripts personalizados incorporados, devemos observar os seguintes pontos:
- As colunas serão transformadas em strings e delimitadas por TAB antes de serem passadas para o script do usuário.
- A saída padrão do script do usuário será tratada como colunas de strings separadas por tabulação.
Exemplo de script incorporado:
FROM (
	FROM pv_users
	MAP pv_users.userid, pv_users.date
	USING 'map_script'
	AS dt, uid
	CLUSTER BY dt) map_output

INSERT OVERWRITE TABLE pv_users_reduced
	REDUCE map_output.dt, map_output.uid
	USING 'reduce_script'
	AS date, count;
A partir do roteiro acima, podemos observar o seguinte. Este é apenas um roteiro de exemplo para fins de compreensão.
- pv_users é a tabela de usuários, que possui campos como userid e date, conforme mencionado em map_script.
- O script de redução é definido com base na data e na contagem da tabela pv_users.
