
Pearson & Spearman korrelasjonsmatrise i R med eksempel
 Evelyn Clarke
⚡ Smart oppsummering
Pearson og Spearman-korrelasjon i R måler hvor sterkt to variabler beveger seg sammen, ved å bruke cor() for et enkelt par og en korrelasjonsmatrise for mange. Denne gjennomgangen legger til signifikanstesting med Hmisc og visualiserer resultatet med GGally-varmekart.
Bivariat korrelasjon i R
Et bivariat forhold beskriver en sammenheng -eller korrelasjon- mellom to variabler i R. I denne opplæringen vil vi diskutere begrepet korrelasjon og vise hvordan det kan brukes til å måle forholdet mellom to variabler i R.
Korrelasjon i R-programmering
Det er to primære metoder for å beregne korrelasjonen mellom to variabler i R-programmering:
- Pearson: Parametrisk korrelasjon
- Spearman: Ikke-parametrisk korrelasjon
Pearson Correlation Matrix i R
Pearson-korrelasjonsmetoden brukes vanligvis som en primær sjekk for sammenhengen mellom to variabler.
Ocuco korrelasjonskoeffisient, skrevet r, måler styrken til lineær forholdet mellom to variabler x og y. Det beregnes som følger:
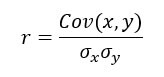
med
 er standardavviket til x
 er standardavviket til y
 er standardavviket til x
 er standardavviket til y
Korrelasjonen varierer mellom -1 og 1.
- En verdi på r nær eller lik 0 innebærer liten eller ingen lineær sammenheng mellom x og y.
- Jo nærmere r kommer 1 eller -1, desto sterkere er den lineære sammenhengen.
Du kan teste om r avviker fra null med t-statistikken nedenfor, og sammenligne den med Student-fordelingen med n – 2 frihetsgrader:
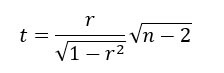
Spearman Rank Correlation i R
En rangkorrelasjon sorterer observasjonene etter rang og beregner likhetsnivået mellom rangeringene. En rangkorrelasjon har fordelen av å være robust overfor uteliggere og er ikke knyttet til datafordelingen. En rangkorrelasjon er også det riktige valget for ordinale variabler.
Spearmans rangkorrelasjon, skrevet rho, går også fra -1 til 1, og verdier nær begge ytterpunktene indikerer en sterk monoton sammenheng. Den beregnes som følger:
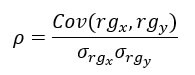
Telleren er kovariansen mellom rekkene av x og y, og nevneren er produktet av standardavvikene deres.
I R beregnes begge med cor()-funksjonen, som tar tre argumenter: x, y og method.
cor(x, y, method)
argumenter:
- x: Første vektor
- y: Andre vektor
- metode: Formelen som brukes til å beregne korrelasjonen. Tre strengverdier:
- "pearson"
- "kendall"
- "spydmann"
Et valgfritt argument kan legges til hvis vektorene inneholder manglende verdi: use = "complete.obs"
Vi vil bruke BudgetUK-datasettet. Dette datasettet rapporterer budsjettfordelingen til britiske husholdninger mellom 1980 og 1982. Det er 1519 observasjoner med ti funksjoner, blant dem:
- wfood: dele mat dele bruke
- wdrivstoff: dele drivstoffforbruk
- wcloth: budsjettandel for klærutgifter
- valk: dele alkoholforbruk
- wtrans: dele transportutgifter
- wother: andel av andre varer
- totexp: totale husholdningsforbruk i pund
- inntekt: total netto husholdningsinntekt
- alder: husstandens alder
- barn: antall barn
Eksempel
library(dplyr)
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/british_household.csv"
data <- read.csv(PATH) %>%
    filter(income < 500) %>%
    mutate(log_income = log(income),
           log_totexp = log(totexp),
           children_fac = factor(children, order = TRUE, labels = c("No", "Yes"))) %>%
    select(-c(X, X.1, children, totexp, income))
glimpse(data)
Code Forklaring
- Vi importerer først dataene og tar en titt med glimpse()-funksjonen fra dplyr-biblioteket.
- Tre husholdninger rapporterer en inntekt på 500 eller mer, så filteret (inntekt < 500) fjerner dem, og radantallet faller fra 1,519 til 1,516.
- Det er en vanlig praksis å konvertere en monetær variabel i log. Det bidrar til å redusere virkningen av uteliggere og reduserer skjevheten i datasettet.
Utgang:
## Observations: 1,516
## Variables: 10
## $ wfood        <dbl> 0.4272, 0.3739, 0.1941, 0.4438, 0.3331, 0.3752, 0...
## $ wfuel        <dbl> 0.1342, 0.1686, 0.4056, 0.1258, 0.0824, 0.0481, 0...
## $ wcloth       <dbl> 0.0000, 0.0091, 0.0012, 0.0539, 0.0399, 0.1170, 0...
## $ walc         <dbl> 0.0106, 0.0825, 0.0513, 0.0397, 0.1571, 0.0210, 0...
## $ wtrans       <dbl> 0.1458, 0.1215, 0.2063, 0.0652, 0.2403, 0.0955, 0...
## $ wother       <dbl> 0.2822, 0.2444, 0.1415, 0.2716, 0.1473, 0.3431, 0...
## $ age          <int> 25, 39, 47, 33, 31, 24, 46, 25, 30, 41, 48, 24, 2...
## $ log_income   <dbl> 4.867534, 5.010635, 5.438079, 4.605170, 4.605170,...
## $ log_totexp   <dbl> 3.912023, 4.499810, 5.192957, 4.382027, 4.499810,...
## $ children_fac <ord> Yes, Yes, Yes, Yes, No, No, No, No, No, No, Yes, ...
Vi kan beregne korrelasjonskoeffisienten mellom inntekts- og wfood-variabler med "pearson"- og "spearman"-metodene.
cor(data$log_income, data$wfood, method = "pearson")
Utgang:
## [1] -0.2466986
cor(data$log_income, data$wfood, method = "spearman")
Utgang:
## [1] -0.2501252
Før dette utvides til hvert par av variabler, er det verdt å fastslå hvordan en enkelt koeffisient skal leses.
Hvordan tolke en korrelasjonskoeffisient
En koeffisient er bare nyttig når du kan si hva den betyr. Båndene nedenfor er den konvensjonelle avlesningen, og fortegnet leses separat fra styrken.
| Absolutt verdi av r | Styrken i forholdet |
|---|---|
| 0.00 til 0.19 | Svært svak eller ingen |
| 0.20 til 0.39 | Svak |
| 0.40 til 0.59 | Moderat |
| 0.60 til 0.79 | Sterk |
| 0.80 til 1.00 | Veldig sterk |
Verdien på -0.2467 som ble beregnet tidligere mellom log_inntekt og wfood er derfor en svak negativ sammenheng: rikere husholdninger bruker en litt mindre andel av budsjettet sitt på mat.
Tre forholdsregler gjelder for hver koeffisient.
- Korrelasjon er ikke årsakssammenheng. En sterk r sier at de to variablene beveger seg sammen, aldri at den ene forårsaker den andre. En tredje, umålt variabel driver ofte begge.
- Pearson ser bare rette linjer. En perfekt U-formet relasjon returnerer en r nær null. Plott alltid dataene før du stoler på tallet.
- Størrelse teller mer enn betydning. Med 1,516 observasjoner kan en koeffisient på 0.06 være statistisk signifikant og fortsatt praktisk talt meningsløs.
Slik tester du korrelasjonssignifikans med cor.test()
cor() returnerer koeffisienten og ingenting annet. For et enkelt par legger cor.test() p-verdien og et konfidensintervall sammen i ett kall.
cor.test(data$log_income, data$wfood, method = "pearson")
Resultatet har fire deler som er verdt å lese.
- t og df: teststatistikken og dens frihetsgrader, n – 2.
- p-verdiensannsynligheten for å se en så stor koeffisient hvis den sanne korrelasjonen var null.
- 95 prosent konfidensintervall: det plausible området for den sanne korrelasjonen. Hvis den ekskluderer null, er forholdet signifikant på det nivået.
- eksempelestimatselve koeffisienten, identisk med det cor() returnerer.
Den samme funksjonen kjører de rangbaserte testene ved å endre ett argument:
# Spearman rank correlation with a p-value
cor.test(data$log_income, data$wfood, method = "spearman")

# One-sided test: is the correlation greater than zero?
cor.test(data$log_income, data$wfood, alternative = "greater")
Når man skal bruke hvilken. Bruk cor.test() når du undersøker ett spesifikt par, fordi det gir konfidensintervallet som rcorr() utelater. Bruk rcorr() fra Hmisc, vist ovenfor, når du trenger p-verdier for en hel matrise samtidig. Merk at testing av mange par blåser opp den falske positive raten, så juster p-verdiene med p.adjust(p_value, method = “BH”) før du trekker konklusjoner fra en stor matrise.
Korrelasjonsmatrise i R
En bivariat korrelasjon er en god start, men et multivariat perspektiv gir et bredere bilde. korrelasjonsmatrise er en firkantet tabell som holder den parvise korrelasjonen av hver variabel mot hverandre.
Cor()-funksjonen returnerer en korrelasjonsmatrise. Den eneste forskjellen med den bivariate korrelasjonen er at vi ikke trenger å spesifisere hvilke variabler. Som standard beregner R korrelasjonen mellom alle variablene.
En korrelasjon kan ikke beregnes for en faktor, så fjern alle kategoriske kolonner før du sender datarammen til cor().
En korrelasjonsmatrise er symmetrisk, noe som betyr at verdiene over diagonalen har samme verdier som den under. Det er mer visuelt å vise halvparten av matrisen.
children_fac er ekskludert fordi cor() ikke kan operere på en faktor.
# the last column of data is a factor level. We don't include it in the code
mat_1 <-as.dist(round(cor(data[,1:9]),2))
mat_1
Code Forklaring
- kor(data[, 1:9])Beregn korrelasjonsmatrisen på de ni numeriske kolonnene
- runde(…, 2)Rund av hver koeffisient til to desimaler
- as.dist()Skriv bare ut den nedre trekanten, siden matrisen er symmetrisk
Utgang:
##            wfood wfuel wcloth  walc wtrans wother   age log_income
## wfuel       0.11
## wcloth     -0.33 -0.25
## walc       -0.12 -0.13  -0.09
## wtrans     -0.34 -0.16  -0.19 -0.22
## wother     -0.35 -0.14  -0.22 -0.12  -0.29
## age         0.02 -0.05   0.04 -0.14   0.03   0.02
## log_income -0.25 -0.12   0.10  0.04   0.06   0.13  0.23
## log_totexp -0.50 -0.36   0.34  0.12   0.15   0.15  0.21       0.49
Signifikansnivå
En koeffisient i seg selv sier ikke om forholdet er statistisk pålitelig. rcorr()-funksjonen fra Hmisc-biblioteket returnerer p-verdien for hvert par. Vi kan laste ned biblioteket fra leilighet og kopier koden for å lime den inn i terminalen:
conda install -c r r-hmisc
rcorr() krever at en dataramme lagres som en matrise. Vi kan konvertere dataene våre til en matrise før vi beregner korrelasjonsmatrisen med p-verdien.
library("Hmisc")
data_rcorr <-as.matrix(data[, 1: 9])

mat_2 <-rcorr(data_rcorr)
# mat_2 <-rcorr(as.matrix(data)) returns the same output
Listeobjektet mat_2 inneholder tre elementer:
- r: Utgang av korrelasjonsmatrisen
- n: Antall observasjoner
- P: p-verdi
Vi er interessert i det tredje elementet, p-verdien. Det er vanlig å vise korrelasjonsmatrisen med p-verdien i stedet for korrelasjonskoeffisienten.
p_value <-round(mat_2[["P"]], 3)
p_value
Code Forklaring
- mat_2[[“P”]]: P-verdiene er lagret i elementet kalt P
- runde(matte_2[[“P”]], 3): Avrund elementene med tre sifre
Utgang:
           wfood wfuel wcloth  walc wtrans wother   age log_income log_totexp
wfood         NA 0.000  0.000 0.000  0.000  0.000 0.365      0.000          0
wfuel      0.000    NA  0.000 0.000  0.000  0.000 0.076      0.000          0
wcloth     0.000 0.000     NA 0.001  0.000  0.000 0.160      0.000          0
walc       0.000 0.000  0.001    NA  0.000  0.000 0.000      0.105          0
wtrans     0.000 0.000  0.000 0.000     NA  0.000 0.259      0.020          0
wother     0.000 0.000  0.000 0.000  0.000     NA 0.355      0.000          0
age        0.365 0.076  0.160 0.000  0.259  0.355    NA      0.000          0
log_income 0.000 0.000  0.000 0.105  0.020  0.000 0.000         NA          0
log_totexp 0.000 0.000  0.000 0.000  0.000  0.000 0.000      0.000         NA
Visualisering av korrelasjonsmatrise i R
Et varmekart er en annen måte å lese en korrelasjonsmatrise på. GGally-biblioteket utvider ggplot2 og installeres fra CRAN i stedet for conda:
install.packages("GGally")

Biblioteket inneholder forskjellige funksjoner for å vise sammendragsstatistikken, for eksempel korrelasjonen og distribusjonen av alle variablene i en matrise.
Funksjonen ggcorr() har mange argumenter. Vi vil bare introdusere argumentene vi vil bruke i opplæringen:
ggcorr-funksjonen
ggcorr(df, method = c("pairwise", "pearson"),
  nbreaks = NULL, digits = 2, low = "#3B9AB2",
  mid = "#EEEEEE", high = "#F21A00",
  geom = "tile", label = FALSE,
  label_alpha = FALSE)
argumenter:
- df: Datasett brukt
- metode: Formel for å beregne korrelasjonen. Som standard beregnes parvis og Pearson
- nbreaks: Returner et kategorisk område for fargen på koeffisientene. Som standard er det ingen pause og fargegradienten er kontinuerlig
- sifre: Avrund korrelasjonskoeffisienten. Som standard, satt til 2
- lav: Kontroller det nedre nivået av fargen
- mid: Kontroller det midterste nivået av fargen
- høy: Kontroller det høye nivået på fargen
- geom: Kontroller formen på det geometriske argumentet. Som standard, "flis"
- etikett: Boolsk verdi. Vis eller ikke etiketten. Som standard, satt til "FALSE".
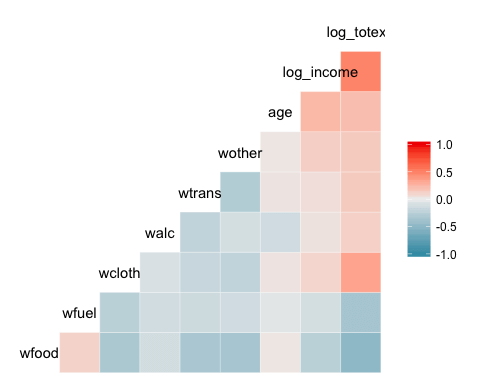
Grunnleggende varmekart
Det mest grunnleggende plottet i pakken er et varmekart. Tegnforklaringen til grafen viser en gradientfarge fra – 1 til 1, med varm farge som indikerer sterk positiv korrelasjon og kald farge, en negativ korrelasjon.
library(GGally)
ggcorr(data)
Code Forklaring
- ggcorr(data): Bare ett argument er nødvendig, som er datarammenavnet. Faktornivåvariabler er ikke inkludert i plottet.
Utgang:
Legge til kontroll til varmekartet
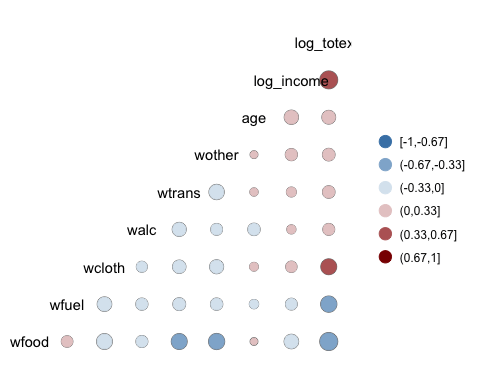
Vi kan legge til flere kontroller i grafen:
ggcorr(data,
    nbreaks = 6,
    low = "steelblue",
    mid = "white",
    high = "darkred",
    geom = "circle")
Code Forklaring
- nbreaks=6: bryte legenden med 6 rekker.
- lav = "stålblå": Bruk lysere farger for negativ korrelasjon
- mid = "hvit": Bruk hvite farger for mellomområdekorrelasjon
- høy = "mørkerød": Bruk mørke farger for positiv korrelasjon
- geom = "sirkel": Bruk sirkel som form på vinduene i varmekartet. Størrelsen på sirkelen er proporsjonal med den absolutte verdien av korrelasjonen.
Utgang:
Legge til etikett på varmekartet
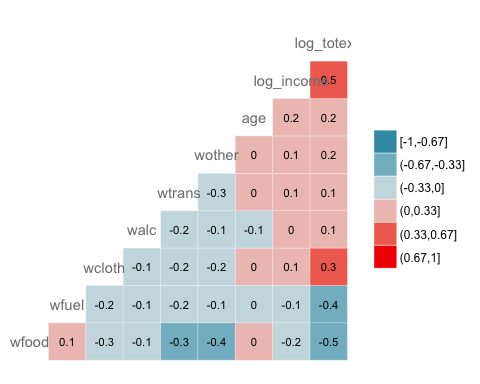
GGally lar oss legge til en etikett inne i vinduene:
ggcorr(data,
    nbreaks = 6,
    label = TRUE,
    label_size = 3,
    color = "grey50")
Code Forklaring
- etikett = TRUE: Legg til verdiene til korrelasjonskoeffisientene inne i varmekartet.
- farge = "grå50": Velg farge, dvs. grå
- label_size = 3: Sett størrelsen på etiketten til 3
Utgang:
ggpairs-funksjonen
GGally-biblioteket tilbyr også ggpairs(), som returnerer en matrise av plott. For k valgte variabler er resultatet ak ganger k rutenett: diagonalen viser fordelingen av hver variabel, mens panelene over og under diagonalen kan ha en annen beregning. Syntaksen er:
ggpairs(df, columns = 1:ncol(df), title = NULL,
    upper = list(continuous = "cor"),
    lower = list(continuous = "smooth"),
    mapping = NULL)
argumenter:
- df: Datasett brukt
- kolonner: Velg kolonnene for å tegne plottet
- tittel: Ta med en tittel
- øversteKontroller boksene over diagonalen i plottet. Må oppgi typen beregninger eller graf som skal returneres. Hvis kontinuerlig = «kor», ber vi R om å beregne korrelasjonen. Merk at argumentet må være en liste. Andre argumenter er tilgjengelige; se GGally-dokumentasjon for mer informasjon.
- lavere: Kontroller boksene under diagonalen.
- kartping: Indikerer grafens estetikk. For eksempel kan vi beregne grafen for forskjellige grupper.
Bivariat analyse med ggpair med grouping
Den neste grafen plotter tre informasjon:
- Korrelasjonsmatrisen mellom log_totexp, log_income, age og wtrans variabel gruppert etter om husholdningen har et barn eller ikke.
- Plott fordelingen av hver variabel etter gruppe
- Vis spredningsplottet med trend for gruppe
library(ggplot2)
ggpairs(data, columns = c("log_totexp", "log_income", "age", "wtrans"), title = "Bivariate analysis of revenue expenditure by the British household", upper = list(continuous = wrap("cor",
        size = 3)),
    lower = list(continuous = wrap("smooth",
        alpha = 0.3,
        size = 0.1)),
    mapping = aes(color = children_fac))
Code Forklaring
- kolonner = c(“log_totexp”, “log_income”, “age”, “wtrans”): Velg variablene som skal vises i grafen
- title = "Bivariat analyse av inntektsutgifter til den britiske husholdningen": Legg til en tittel
- øvre = liste(): Kontroller den øvre delen av grafen. Dvs over diagonalen
- kontinuerlig = wrap(“cor”, størrelse = 3)): Beregn korrelasjonskoeffisienten. Vi pakker argumentet kontinuerlig inne i wrap()-funksjonen for å kontrollere grafens estetikk (dvs. størrelse = 3) -lower = list(): Kontroller den nedre delen av grafen. Dvs. Under diagonalen.
- kontinuerlig = wrap(“glatt”,alfa = 0.3,størrelse=0.1): Legg til et spredningsplott med en lineær trend. Vi legger argumentet kontinuerlig inne i wrap()-funksjonen for å kontrollere grafens estetikk (dvs. størrelse=0.1, alfa=0.3)
- kartping = aes(farge = barnefjes)Del hvert panel etter children_fac, den ordnede faktoren merket «Nei» for husholdninger uten barn og «Ja» for husholdninger med barn
Utgang:

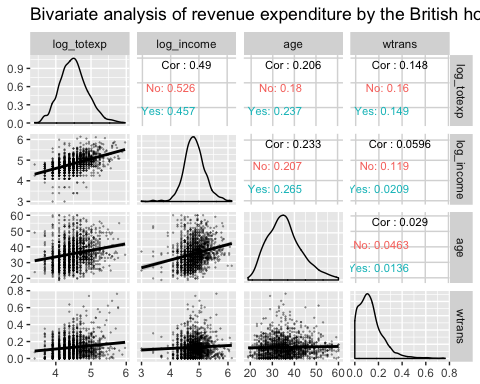
Bivariat analyse med ggpair med delvis grouping
Grafen nedenfor er litt annerledes. Vi endrer kartets posisjonping inne i det øvre argumentet.
ggpairs(data, columns = c("log_totexp", "log_income", "age", "wtrans"),
    title = "Bivariate analysis of revenue expenditure by the British household",
    upper = list(continuous = wrap("cor",
            size = 3),
        mapping = aes(color = children_fac)),
    lower = list(
        continuous = wrap("smooth",
            alpha = 0.3,
            size = 0.1))
)
Code Forklaring
- Nøyaktig samme kode som forrige eksempel bortsett fra:
- kartping = aes(color = children_fac): Flytter listen i upper = list(). Vi ønsker bare at beregningen skal være stablet gruppevis i den øvre delen av grafen.
Utgang:
Korrelasjon i R: Viktige konklusjoner og funksjonsreferanse
- Et bivariat forhold beskriver et forhold -eller korrelasjon- mellom to variabler i R.
- Det er to primære metoder for å beregne korrelasjonen mellom to variabler i R-programmering: Pearson & Spearman.
- Pearson-korrelasjonsmetoden brukes vanligvis som en primær sjekk for sammenhengen mellom to variabler.
- En rangekorrelasjon sorterer observasjonene etter rangering og beregner likhetsnivået mellom rangeringen.
- Spearmans rangkorrelasjon går fra -1 til 1, og verdier nær begge ytterpunktene indikerer en sterk monoton sammenheng.
- En korrelasjonsmatrise er en kvadratisk tabell som inneholder den parvise korrelasjonen til hver variabel.
- En p-verdi forteller deg om en observert korrelasjon er statistisk skillebar fra null.
Hver korrelasjonsfunksjon som brukes i denne veiledningen er listet opp nedenfor:
| Bibliotek | Målet | Metode | Code |
|---|---|---|---|
| Base | Bivariat korrelasjon | Pearson |
cor(dfx2, method = "pearson") |
| Base | Bivariat korrelasjon | Spearman |
cor(dfx2, method = "spearman") |
| Base | Multivariat korrelasjon | Pearson |
cor(df, method = "pearson") |
| Base | Multivariat korrelasjon | Spearman |
cor(df, method = "spearman") |
| Hmisc | P-verdi | - |
rcorr(as.matrix(data[,1:9]))[["P"]] |
| GGally | Varmekart | - |
ggcorr(df)
|
| GGally | Multivariat plottmatrise | - |
ggpairs(df, columns = c("x1", "x2")) |
