
ANOVA i R: Enveis- og toveistester med eksempler
 Evelyn Clarke
⚡ Smart oppsummering
ANOVA i R sammenligner gjennomsnittene av tre eller flere grupper ved å dele total variasjon i komponenter mellom grupper og innenfor grupper. Denne gjennomgangen kjører enveis- og toveis tester på giftdatasettet, sjekker antagelser og isolerer forskjellige par med Tukey HSD.
Hva er ANOVA?
Analyse av varianter (ANOVA) er en statistisk teknikk som brukes til å sammenligne gjennomsnittet av to eller flere grupper. Testen fungerer ved å dele den totale variasjonen i en måling inn i den delen som forklares av gruppemedlemskap og den delen som er igjen som tilfeldig støy. ANOVA i R forteller deg derfor om minst ett gruppegjennomsnitt avviker fra de andre, ikke hvilket. Det er en direkte forlengelse av t-test til situasjoner der faktorvariabelen har mer enn to nivåer.
Før du kjører en test, er det nyttig å vite hvilket medlem av ANOVA-familien som passer til designet ditt.
Typer ANOVA-tester i R
«ANOVA» er en familie av tester snarere enn én enkelt prosedyre. Valg av riktig medlem avhenger av hvor mange faktorer du har og hvordan dataene ble samlet inn.
| Test | Når skal du bruke den | R-samtale |
|---|---|---|
| Enveis ANOVA | Én faktor med tre eller flere nivåer | aov(y ~ x, data = df) |
| Toveis ANOVA | To uavhengige faktorer | aov(y ~ x1 + x2, data = df) |
| Toveis med interaksjon | Effekten av én faktor avhenger av den andre | aov(y ~ x1 * x2, data = df) |
| Gjentatte målinger ANOVA | De samme forsøkspersonene ble målt mer enn én gang | aov(y ~ x + Feil(subjekt/x)) |
| ANCOVA | En kontinuerlig kovariat må kontrolleres for | aov(y ~ x + kovariat, data = df) |
| MANOVA | To eller flere responsvariabler samtidig | manova(cbind(y1, y2) ~ x) |
Denne veiledningen dekker de tre første. De resterende variantene bruker det samme aov()-grensesnittet, så når du kan lese én utdatatabell, kan du lese dem alle.
ANOVA vs T-test i R: Viktige forskjeller
Begge testene sammenligner gjennomsnitt, så det er verdt å være presis om hvor den ene erstatter den andre.
| Kriterier | T-test | ANOVA |
|---|---|---|
| Antall grupper | Nøyaktig to | To eller flere |
| Teststatistikk | t | F, lik t i annen når det er to grupper |
| Resultat | Navngir retningen på forskjellen | Rapporterer kun at det finnes en forskjell |
| Oppfølging nødvendig | none | Post hoc-test som Tukey HSD |
| R funksjon | t.test() | aov() |
Fristelsen med tre grupper er å kjøre tre separate t-tester. Motstå den. Hver test har sin egen feilrate på 5 prosent, så tre sammenligninger øker sjansen for en falsk positiv til omtrent 14 prosent. ANOVA besvarer det samme spørsmålet med én enkelt test, og Tukey HSD håndterer deretter parvise detaljer med feilraten holdt i sjakk. For tilfellet med to grupper, se t-test veiledning.
Enveis ANOVA
Det er mange situasjoner der du må sammenligne gjennomsnittet mellom flere grupper. For eksempel ønsker markedsavdelingen å vite om tre team har samme salgsytelse.
- Lag: Faktor på 3 nivåer: A, B og C
- Salg: Et mål på ytelse
ANOVA-testen kan fortelle om de tre gruppene har lignende prestasjoner.
For å avklare om dataene kommer fra samme populasjon, kan du utføre en enveis variansanalyse (enveis ANOVA heretter). Som alle andre statistiske tester gir den bevis for om H0-hypotesen kan forkastes. Merk at det å ikke forkaste H0 ikke er det samme som å bevise at den er sann.
Hypotese i enveis ANOVA-test
- H0: Middelene mellom gruppene er identiske
- H1: I det minste er gjennomsnittet for en gruppe forskjellig
Med andre ord, hvis H0 ikke forkastes, betyr det at det ikke er nok bevis til å konkludere med at gjennomsnittet for en gruppe er forskjellig fra de andre.
Denne testen ligner på t-testen, men ANOVA er det riktige valget når det er mer enn to grupper. Med nøyaktig to grupper er de to testene likeverdige, og F-statistikken er lik kvadratet av t-statistikken.
Antagelser
Enveis ANOVA hviler på tre betingelser: observasjonene er tilfeldig utvalgt og uavhengige av hverandre, residualene innenfor hver gruppe er tilnærmet normalfordelt, og variansen er den samme i hver gruppe (homogenitet i variansen). Avsnittet om å sjekke forutsetninger nedenfor viser hvordan man tester hver enkelt i R.
Tolk ANOVA-test
F-statistikken brukes til å teste om dataene er fra signifikant forskjellige populasjoner, dvs. forskjellige utvalgsgjennomsnitt.
For å beregne F-statistikken må du dele variasjon mellom grupper over variasjon innen gruppe.
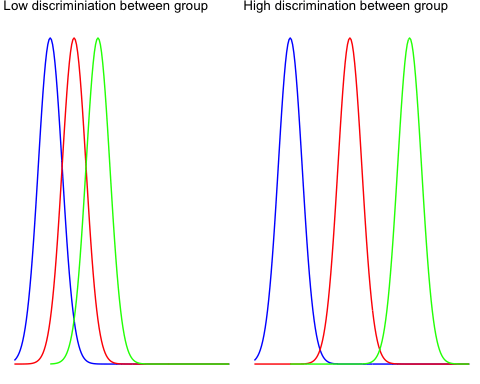
Ocuco mellom-gruppen Variabiliteten gjenspeiler hvor langt gjennomsnittet for hver gruppe er fra det totale gjennomsnittet. Sammenlign de to grafene nedenfor for å se ideen.
Den venstre grafen viser svært liten variasjon mellom de tre gruppene, så alle tre gruppegjennomsnittene ligger nær samlet mener.
Den høyre grafen plotter tre fordelinger langt fra hverandre uten overlapping, så gapet mellom det totale gjennomsnittet og gjennomsnittet for hver gruppe er stort.
Ocuco innen gruppen Variabilitet måler hvor langt individuelle observasjoner avviker fra gjennomsnittet av sin egen gruppe. Noen punkter ligger langt fra gruppegjennomsnittet, og leddet innenfor gruppen fanger opp nettopp denne spredningen, som er utvalgsfeilen.
For visuelt å forstå konseptet innen gruppevariabilitet, se på grafen nedenfor.
Den venstre delen plotter fordelingen av tre forskjellige grupper. Du økte spredningen for hvert utvalg, og det er tydelig at den individuelle variansen er stor. F-statistikken faller, så du ville ikke klare å forkaste nullhypotesen.
Den høyre delen viser utvalg med samme gjennomsnitt, men mye lavere spredning. Det hever F-statistikken og peker i favør av den alternative hypotesen.

Du kan bruke begge målene for å konstruere F-statistikken. Det er veldig intuitivt å forstå F-statistikken. Hvis telleren øker, betyr det at variasjonen mellom grupper er høy, og det er sannsynlig at gruppene i utvalget er trukket fra helt forskjellige fordelinger.
Med andre ord indikerer en lav F-statistikk liten eller ingen meningsfull forskjell mellom gruppegjennomsnittene.
Eksempel Enveis ANOVA-test
Du vil bruke giftdatasettet til å implementere enveis ANOVA-testen. Datasettet inneholder 48 rader og 3 variabler:
- Tid: Dyrets overlevelsestid
- gift: Type gift brukt: faktornivå: 1,2 og 3
- behandle: Type behandling som brukes: faktornivå: 1,2 og 3
Før du begynner å beregne ANOVA-testen, må du forberede dataene som følger:
- Trinn 1: Importer dataene
- Trinn 2: Fjern unødvendig variabel
- Trinn 3: Konverter variabel gift som bestilt nivå
library(dplyr)
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/poisons.csv"
df <- read.csv(PATH) %>%
select(-X) %>%
mutate(poison = factor(poison, ordered = TRUE))
glimpse(df)
Utgang:
## Observations: 48
## Variables: 3
## $ time   <dbl> 0.31, 0.45, 0.46, 0.43, 0.36, 0.29, 0.40, 0.23, 0.22, 0...
## $ poison <ord> 1, 1, 1, 1, 2, 2, 2, 2, 3, 3, 3, 3, 1, 1, 1, 1, 2, 2, 2...
## $ treat  <fctr> A, A, A, A, A, A, A, A, A, A, A, A, B, B, B, B, B, B, ...
Vårt mål er å teste følgende antakelse:
- H0: Det er ingen forskjell i gjennomsnittlig overlevelsestid mellom gruppene
- H1: Gjennomsnittet for overlevelsestid er forskjellig for minst én gruppe.
Med andre ord, du vil vite om det er en statistisk forskjell mellom gjennomsnittet av overlevelsestiden i henhold til hvilken type gift som gis til marsvinet.
Du vil fortsette som følger:
- Trinn 1: Sjekk formatet til den variable giften
- Trinn 2: Skriv ut sammendragsstatistikken: antall, gjennomsnitt og standardavvik
- Trinn 3: Plott et boksplott
- Trinn 4: Beregn enveis ANOVA-testen
- Trinn 5: Kjør en parvis sammenligning med Tukey HSD
Trinn 1) Sjekk giftnivåene med koden nedenfor. Du bør se tre tegn, fordi det muterte verbet konverterte kolonnen til en ordnet faktor.
levels(df$poison)
Utgang:
## [1] "1" "2" "3"
Trinn 2) Du beregner gjennomsnittet og standardavviket.
df %>%
	group_by(poison) %>%
	summarise(
		count_poison = n(),
		mean_time = mean(time, na.rm = TRUE),
		sd_time = sd(time, na.rm = TRUE)
	)
Utgang:
##
# A tibble: 3 x 4
##   poison count_poison mean_time    sd_time
##    <ord>        <int>     <dbl>      <dbl>
## 1      1           16  0.617500 0.20942779
## 2      2           16  0.544375 0.28936641
## 3      3           16  0.276250 0.06227627
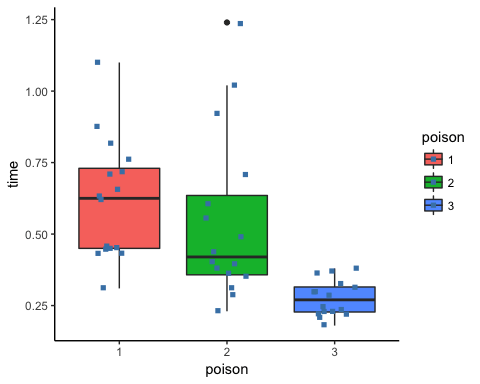
Trinn 3) I trinn tre kan du grafisk sjekke om det er forskjell mellom fordelingen. Vær oppmerksom på at du inkluderer den rystede prikken.
ggplot(df, aes(x = poison, y = time, fill = poison)) +
    geom_boxplot() +
    geom_jitter(shape = 15,
        color = "steelblue",
        position = position_jitter(0.21)) +
    theme_classic()
Utgang:
Trinn 4) Du kan kjøre enveis ANOVA-testen med kommandoen aov. Den grunnleggende syntaksen for en ANOVA-test er:
aov(formula, data)
Arguments:
- formula: The equation you want to estimate
- data: The dataset used
Syntaksen til formelen er:
y ~ X1+ X2+...+Xn # X1 +  X2 +... refers to the independent variables
y ~ . # use all the remaining variables as independent variables
Du kan nå svare på spørsmålet: er det noen forskjell i overlevelsestid mellom marsvinene, gitt hvilken type gift som gis?
Lagre modellen i et objekt og send den til summary() for å få en lesbar utskrift av resultatene.
anova_one_way <- aov(time~poison, data = df)
summary(anova_one_way)
Code Forklaring
- aov(tid ~ gift, data = df): Kjør ANOVA-testen med følgende formel
- summary(anova_one_way): Skriv ut sammendraget av testen
Utgang:
##             Df Sum Sq Mean Sq F value   Pr(>F)
## poison       2  1.033  0.5165   11.79 7.66e-05 ***
## Residuals   45  1.972  0.0438
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
P-verdien er 7.66e⁻⁶, langt under den vanlige terskelen på 0.05, og de tre stjernene markerer den sterkeste signifikanskoden. Du kan forkaste H₂ og konkludere med at minst én giftgruppe har en annen gjennomsnittlig overlevelsestid.
Slik sjekker du ANOVA-antagelser i R
En ANOVA p-verdi er bare pålitelig når de tre betingelsene som er nevnt tidligere, er oppfylt. Hver av dem har en direkte kontroll i R, og alle kjører på det tilpassede modellobjektet.
1. Observasjoners uavhengighet. Dette er en egenskap ved studiedesignet, ikke ved dataene, så ingen test kan redde den. Hvert forsøkskanin må måles én gang og tilordnes tilfeldig til sin gruppe. Hvis samme forsøksperson vises i flere rader, trenger du i stedet en modell med gjentatte målinger.
2. Normalitet av residualer. ANOVA antar at residualene, ikke rådataene, er tilnærmet normale. Undersøk QQ-plottet og bekreft med Shapiro-Wilk-testen:
par(mfrow = c(2, 2))
plot(anova_one_way)          # four diagnostic plots

shapiro.test(residuals(anova_one_way))
Punkter som omslutter diagonalen i Normal QQ-plottet indikerer normale residualer. En Shapiro-Wilk p-verdi over 0.05 betyr at du ikke kan forkaste normalitet.
3. Varianshomogenitet. Hver gruppe skal vise en lignende spredning. Residualer vs. Tilpasset-plottet skal se ut som et flatt bånd i stedet for en trakt. Bekreft dette med Levenes test, som er mer robust mot ikke-normalitet enn Bartletts:
library(car)
leveneTest(time ~ poison, data = df)

bartlett.test(time ~ poison, data = df)
En p-verdi over 0.05 støtter like varianser.
Hva man skal gjøre når en antagelse slår feil. Hvis variansene er ulik, kjør oneway.test(time ~ poison, data = df, var.equal = FALSE), Welch-korreksjonen. Hvis residualene er tydelig ikke-normale og utvalget er lite, bytt til Kruskal-Wallis rangtest, kruskal.test(time ~ poison, data = df). Med store balanserte utvalg er ANOVA ganske robust til moderate avvik fra normalitet, så et Shapiro-Wilk-resultat som grenser til det normale er sjelden fatalt.
Parvis sammenligning
En signifikant F-test forteller deg at ikke alle gjennomsnittene for gruppen er like, men ikke hvilket par som er forskjellige. Tukeys Honest Significant Difference-test gir svar på dette ved å sammenligne hvert par samtidig som den familievise feilraten kontrolleres.
TukeyHSD(anova_one_way)
Utgang:

Les utdataene én rad per par. diff kolonnen inneholder differansen mellom de to gruppegjennomsnittene, lwr og tillatelse begrenset 95 prosent konfidensintervallet for den forskjellen, og p adj er p-verdien justert for multiple sammenligninger. Et par avviker signifikant når intervallet ekskluderer null, tilsvarende når p adj er under 0.05. I dette datasettet er sammenligningene som involverer gift 3 de signifikante, noe som samsvarer med boksplottet: gruppe 3 har en klart lavere gjennomsnittlig overlevelsestid enn gruppe 1 og 2, mens gruppe 1 og 2 er statistisk umulige å skille fra hverandre.
Toveis ANOVA
En toveis ANOVA legger til en annen faktor i formelen. Den fungerer akkurat som enveistesten, bare at formelen endres:
y ~ x1 + x2
Her er y den kvantitative responsvariabelen, mens x1 og x2 begge er kategoriske faktorer.
Hypotese i toveis ANOVA-test
- H0: Gruppegjennomsnittene er like for begge faktorvariablene
- H1: Minst én gruppegjennomsnitt er forskjellig, for minst én av de to faktorene
Du legger til behandlingsvariabelen i modellen. Denne variabelen registrerer behandlingen som marsvinet har fått. Den additive formelen nedenfor tester om hver faktor påvirker overlevelsestiden alene, etter at den andre er tatt hensyn til.
Juster koden ved å legge til treat ved siden av den første uavhengige variabelen.
anova_two_way <- aov(time~poison + treat, data = df)
summary(anova_two_way)
Utgang:
##             Df Sum Sq Mean Sq F value  Pr(>F)
## poison       2 1.0330  0.5165   20.64 5.7e-07 ***
## treat        3 0.9212  0.3071   12.27 6.7e-06 ***
## Residuals   42 1.0509  0.0250
## ---
Begge p-verdiene (5.7e⁻⁶ for gift og 6.7e⁻⁶ for behandling) ligger langt under 0.05, så du forkaster H0 for begge faktorene og konkluderer med at endring av enten giften eller behandlingen påvirker overlevelsestiden.
Legge til et interaksjonsbegrep
Den additive modellen ovenfor antar at effekten av giften er den samme uavhengig av behandlingen. For å teste denne antagelsen, erstatt plusstegnet med en stjerne, som passer til både hovedeffektene og deres interaksjon:
anova_interaction <- aov(time~poison * treat, data = df)
summary(anova_interaction)
Hvis raden «gift:behandle» ikke er signifikant, er den additive modellen det bedre valget fordi den bruker færre frihetsgrader.
ANOVA i R: Hurtig testreferanse
Tabellen nedenfor viser hver test som er brukt ovenfor, R-kallet som kjører den, og hypotesen den evaluerer:
| Test | Code | Hypotese | P-verdien |
|---|---|---|---|
| Enveis ANOVA |
aov(y ~ X, data = df)
|
H1: Gjennomsnittet er forskjellig for minst én gruppe | 0.05 |
| Parvis |
TukeyHSD(ANOVA summary) |
0.05 | |
| Toveis ANOVA |
aov(y ~ X1 + X2, data = df)
|
H1: Minst ett gruppegjennomsnitt er forskjellig for begge faktorene | 0.05 |
