
Hadoop Pig Tutorial: Hva er Apache Pig? Architecture, Eksempel
 Prafulla Ranadive
⚡ Smart oppsummering
Apache Pig er en plattform på høyt nivå for å analysere store datasett på Hadoop, og kobler dataflytspråket Pig Latin med en kjøretid som kompilerer hvert skript til MapReduce, Tez eller Spark jobber automatisk.
Denne veiledningen starter med ideen bak Apache Pig, og går deretter gjennom installasjonen og kjøringen av et komplett latinsk Pig-skript fra ende til annen.
Hva er Apache Pig?
Gris er et høyt nivå programmeringsspråk nyttig for å analysere store datasett. Pig var et resultat av utviklingsarbeidet hos Yahoo!
I et MapReduce-rammeverk må programmer oversettes til en serie Map- og Reduce-faser. Dette er imidlertid ikke en programmeringsmodell som dataanalytikere er kjent med. Så for å bygge bro over dette gapet, er det nødvendig med en abstracsjon kalt Pig ble bygget oppå Hadoop.
Apache Pig lar folk fokusere mer på å analysere store datasett og bruke mindre tid på å skrive MapReduce-programmer. I likhet med griser, som spiser hva som helst, er programmeringsspråket Apache Pig designet for å jobbe med alle typer data. Det er derfor navnet Pig! Prosjektmaskoten nedenfor understreker det samme.

Prosjektet er fortsatt aktivt. Apache Pig 0.18.0 ble utgitt 15. september 2025 og legger til støtte for Hadoop 3, Tez 0.10, Hive 3, Spark 3, HBase 2 og Python 3, ifølge Apache Pig utgivelsessideGjennomgangen nedenfor ble opprinnelig skrevet mot den mye eldre 0.12.1-linjen, så noen få trinn inneholder en merknad der en nåværende utgivelse oppfører seg annerledes.
Pig Architecture
Arkitekturen til Pig består av to komponenter:
- Grise latin, som er et språk
- Et kjøretidsmiljø, for å kjøre Pig Latin-programmer.
Et Pig Latin-program består av en serie operasjoner eller transformasjoner som brukes på inndataene for å produsere utdata. Disse operasjonene beskriver en dataflyt som oversettes til en kjørbar representasjon av Hadoop Pig-utførelsesmiljøet. Under finner du resultatene av disse transformasjonene en serie med MapReduce jobber som en programmerer ikke er klar over. Så, på en måte, lar Pig i Hadoop programmereren fokusere på data snarere enn på utførelsens natur.
Pig Latin er et relativt rigid språk som bruker kjente nøkkelord fra databehandling, f.eks. Join, Group og Filter. Diagrammet nedenfor tracsender et skript fra Grunt-skallet gjennom parseren, optimalisereren og kompilatoren på vei til utførelsesmotoren.

Utførelsesmoduser
Pig i Hadoop har to utførelsesmoduser, og installasjonsgjennomgangen lenger ned bruker begge:
- Lokal modus: I denne modusen kjører Hadoop Pig-språket i én JVM og bruker det lokale filsystemet. Denne modusen er kun egnet for analyse av små datasett ved bruk av Pig i Hadoop.
- MapReduce-modus: I denne modusen blir spørringer skrevet på Pig Latin oversatt til MapReduce-jobber og kjøres på en Hadoop-klynge (klyngen kan være pseudodistribuert eller fullstendig distribuert). MapReduce-modus med en fullstendig distribuert klynge er nyttig for å kjøre Pig på store datasett.
Disse to er det klassiske paret. Nåværende utgivelser eksponerer faktisk seks utførelsestyper, eller eksekveringstyper, som hver er valgt med samme -x flagget, som dokumentert i Veiledning for å komme i gang med Pig 0.18.0.
| Exectype | Kommando | Der arbeidet går |
|---|---|---|
| lokal | gris -x lokal | En enkelt JVM mot det lokale filsystemet |
| Tez lokalt | gris -x tez_local | En enkelt JVM som bruker Tez-kjøretiden (eksperimentell) |
| Spark lokal | gris -x spark_local | En enkelt JVM som bruker Spark kjøretid (eksperimentell) |
| MapReduce | gris eller gris -x mapreduce | En Hadoop-klynge med HDFS; dette er standardinnstillingen |
| avhandling | gris -x tez | En Hadoop-klynge som kjører Tez-motoren |
| Spark | gris -x gnist | A Spark, YARN eller Mesos-klynge med HDFS |
Latinske datatyper for gris og Operatorer
Før du skriver et skript, er det nyttig å vite hva Pig kan holde og hva den kan gjøre med det. Datamodellen er fullstendig nestet, noe som lar Pig lese loggfiler og annen løst strukturert input som en relasjonstabell ville avvist.
Pig Latin tilbyr to familier av typer:
- Skalære typer:
int,long,float,double,chararray,bytearray,boolean,datetime,bigintegerogbigdecimalEksempelskriptet deklarerer senere hver kolonne somchararray. - Komplekse typer: a tuppel er et ordnet sett med felt og oppfører seg som en rad; a veske er en uordnet samling av tupler og oppfører seg som en tabell; a kart er et sett med nøkkel- og verdipar hvis nøkkel må være en
chararray.
Operatørene har et lite antall jobber, og en håndfull av dem fører nesten alle rørledninger:
| Operator | Hva det gjør |
|---|---|
| LAST / OPPREVAR | Les en relasjon fra filsystemet og skriv resultatet tilbake |
| FILTER | Behold bare tuplene som samsvarer med en betingelse |
| FOREACH … GENERER | Arbeid kolonne for kolonne, og bygg nye felt |
| GRUPPE / SAMGRUPPE | Grupper én relasjon, eller to eller flere relasjoner, etter en nøkkel |
| BLI | Kombiner relasjoner med en indre eller ytre sammenføyning |
| UNION / SPLIT | Slå sammen relasjoner, eller del én opp i flere |
| SORTER ETTER / TYDELIG / GRENSE | Sorter, dedupliser og sett en grense for antall tupler |
| DUMP / BESKRIV / FORKLAR / ILLUSTRER | Inspiser resultater, skjemaer, utførelsesplaner og prøvekjøringer |
De fire inspeksjonsoperatørene har også Grunt-snarveier, noe som sparer degping under feilsøking: \d for DUMP, \de for BESKRIV, \e for FORKLARING og \i for ILLUSTRATE.
Forutsetninger
Pig er et klientsideverktøy. Det analyserer et skript, planlegger arbeidet og sender inn jobber, men det tilbyr ikke lagring eller en egen klynge, så det må først finnes en fungerende Hadoop-installasjon. Kravlisten for Apache er kort.
| Komponent | Krav | Hvorfor det er nødvendig |
|---|---|---|
| Hadoop | Hadoop 2.x eller 3.x, med HADOOP_HOME eksportert | Leverer HDFS og utførelsesmotoren. Uten HADOOP_HOME faller Pig 0.18.0 tilbake til en innebygd Hadoop 2.7.3. |
| Java | Java 1.7 eller nyere, med JAVA_HOME satt til installasjonsroten | Pig og Hadoop-daemonene er Java programmer |
| Python (om du har) | Python 2.7 | Kun nødvendig for strømming Python brukerdefinerte funksjoner |
| Maur (valgfritt) | Maur 1.8 | Bare nødvendig når du bygger eller rekompilerer Pig fra kildekode |
To praktiske punkter står ved siden av den listen. For det første, kjør alt som en Linux-bruker som allerede har en hjemmekatalog i HDFS og tillatelse til å skrive til den; denne veiledningen bruker hduser, kontoen som ble opprettet under oppsettet av Hadoop. For det andre, start klyngen før du starter Pig i MapReduce-modus, fordi Pig feiler umiddelbart hvis NameNode og ResourceManager er nede. Hvis Hadoop ikke er installert ennå, jobb deg gjennom hvordan installere Hadoop først.
Hvordan laste ned og installere Pig
Nå i denne Apache Pig-opplæringen lærer vi hvordan du laster ned og installerer Pig:
Før vi starter med selve prosessen, sørg for at du har Hadoop installert. Endre brukeren til 'hduser' (ID-en som ble brukt under konfigurasjonen av Hadoop; du kan bytte til bruker-ID-en som ble brukt under din egen Hadoop-konfigurasjon).

Trinn 1) Last ned den nyeste stabile versjonen av Pig Hadoop fra et av speilnettstedene som er tilgjengelige på
https://pig.apache.org/releases.html
Velg tar.gz-filen (og ikke src.tar.gz) som skal lastes ned, som vist nedenfor.

Trinn 2) Når nedlastingen er fullført, naviger til mappen som inneholder den nedlastede tar-filen og flytt tar-filen til stedet der du vil sette opp Pig Hadoop. I dette tilfellet flytter vi til /usr/local.

Gå til mappen som skal inneholde Pig Hadoop-filene.
cd /usr/local
Extracinnholdet i tar-filen som vist nedenfor.
sudo tar -xvf pig-0.12.1.tar.gz

Trinn 3) Endre ~/.bashrc for å legge til Pig-relaterte miljøvariabler.
Åpne ~/.bashrc-filen i et hvilket som helst tekstredigeringsprogram du ønsker, og gjør endringene nedenfor.
export PIG_HOME=<Installation directory of Pig>
export PATH=$PIG_HOME/bin:$HADOOP_HOME/bin:$PATH

Trinn 4) Nå, bruk kommandoen nedenfor til å opprette kildekode for denne miljøkonfigurasjonen.
. ~/.bashrc

Trinn 5) Vi må kompilere Pig på nytt for å støtte Hadoop 2.2.0.
Her er trinnene for å gjøre dette.
Gå til Pigs hjemmekatalog.
cd $PIG_HOME
Installer Ant.
sudo apt-get install ant

Merk: Nedlastingen starter og vil bruke tid avhengig av internetthastigheten din.
Kompiler Pig på nytt.
sudo ant clean jar-all -Dhadoopversion=23

Vær oppmerksom på at flere komponenter lastes ned i denne rekompileringsprosessen, så systemet bør være koblet til internett.
Hvis denne prosessen også setter seg fast et sted og du ikke ser noen bevegelse på ledeteksten i mer enn 20 minutter, trykker du Ctrl + c og kjører den samme kommandoen på nytt.
I vårt tilfelle tar det 20 minutter.

Dette rekompileringstrinnet tilhører 0.12.1-æraen, da de leverte JAR-filene ble bygget mot Hadoop 1 og -Dhadoopversion=23 flag byttet Ant-bygget til Hadoop 0.23 og 2.x-linjen. Apache Pig 0.18.0 sender binærfiler som allerede kjører på Hadoop 2.7 og nyere, samt Hadoop 3, så på en nåværende utgivelse kan du vanligvis pakke ut tarballen og hoppe rett til testen nedenfor.
Trinn 6) Test Pig-installasjonen ved hjelp av kommandoen
pig -help

Eksempel Pig Script
Med Pig installert, kjører resten av denne Apache Pig-opplæringen et komplett skript. Vi bruker Pig Scripts for å finne antall produkter som selges i hvert land.
Input: Inndatasettet vårt er en CSV-fil, SalgJan2009.csv.
Trinn 1) Start Hadoop.
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Trinn 2) Pig in Big Data tar en fil fra HDFS i MapReduce-modus og lagrer resultatene tilbake til HDFS.
Kopier filen SalesJan2009.csv (lagret på det lokale filsystemet på ~/input/SalesJan2009.csv) til HDFS-hjemmekatalogen (Hadoop Distributed File System).
Her i dette Apache Pig-eksemplet er filen i mappeinndataen. Hvis filen er lagret et annet sted, oppgi det navnet i stedet.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/input/SalesJan2009.csv /

Sjekk om filen faktisk ble kopiert eller ikke.
$HADOOP_HOME/bin/hdfs dfs -ls /

Trinn 3) Griskonfigurasjon.
Først navigerer du til $PIG_HOME/conf og beholder en kopi av den opprinnelige egenskapsfilen.
cd $PIG_HOME/conf
sudo cp pig.properties pig.properties.original

Åpne pig.properties med en teksteditor du velger, og angi stien til loggfilen ved hjelp av pig.logfile.
sudo gedit pig.properties

Loggeren vil bruke denne filen til å logge feil.
Trinn 4) Kjør kommandoen «pig», som vil starte Pig-ledeteksten, et interaktivt skall for Pig-spørringer.
pig

Trinn 5) I Grunt-kommandoprompten for Pig, utfør Pig-kommandoene nedenfor i rekkefølge.
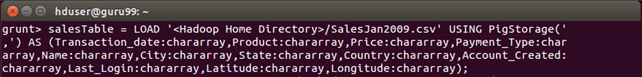
— A. Last inn filen som inneholder data.
salesTable = LOAD '/SalesJan2009.csv' USING PigStorage(',') AS (Transaction_date:chararray,Product:chararray,Price:chararray,Payment_Type:chararray,Name:chararray,City:chararray,State:chararray,Country:chararray,Account_Created:chararray,Last_Login:chararray,Latitude:chararray,Longitude:chararray);
Trykk Enter etter denne kommandoen.
— B. Grupper data etter feltet Land.
GroupByCountry = GROUP salesTable BY Country;

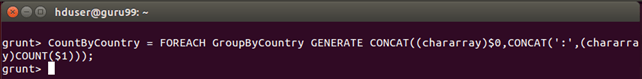
— C. For hver tuppel i 'GroupByCountry', generer den resulterende strengen på formen Navn på land: Antall solgte produkter.
CountByCountry = FOREACH GroupByCountry GENERATE CONCAT((chararray)$0,CONCAT(':',(chararray)COUNT($1)));
Trykk Enter etter denne kommandoen.
— D. Lagre resultatene av dataflyten i katalogen «pig_output_sales» på HDFS.
STORE CountByCountry INTO 'pig_output_sales' USING PigStorage('\t');

Denne kommandoen vil ta litt tid å utføre. Når den er ferdig, skal du se følgende skjermbilde.

Trinn 6) Resultatet kan sees gjennom kommandogrensesnittet som
$HADOOP_HOME/bin/hdfs dfs -cat pig_output_sales/part-r-00000

Resultatene kan også sees via et webgrensesnitt.
Åpne http://localhost:50070/ i en nettleser.
Port 50070 er NameNode-nettgrensesnittet på Hadoop 2. Hadoop 3 flyttet den samme siden til port 9870, så bruk den adressen i stedet hvis klyngen din kjører Hadoop 3.

Velg nå «Bla gjennom filsystemet» og naviger opp til /user/hduser/pig_output_sales.

Åpne part-r-00000 for å lese land- og produktantall-parene som skriptet produserte.

Apache Pig vs. Hive vs. MapReduce
Gris blir sjelden vurdert alene. Det vanlige spørsmålet er om en jobb hører hjemme i Gris, i Hive eller i et håndskrevet MapReduce-program, siden alle tre ender opp som jobber på samme klynge.
| Aspekt | KartReduser (Java) | Apache gris | Apache Hive |
|---|---|---|---|
| Interface | Java API | Pig Latin , et skriptspråk for dataflyt | HiveQL, en SQL-dialekt |
| Nivå av magemusklertracsjon | Lav | Medium | Høyt |
| Typisk bruker | Java utvikler | Dataingeniør eller forsker | Analytiker komfortabel med SQL |
| Data det passer | Alt, håndtert manuelt | Strukturert og semistrukturert; skjemaet er valgfritt ved lastetid | Strukturerte tabeller registrert i en metastore |
| Code volum | De fleste linjer | Færre linjer | Færrest linjer for en spørring |
| Kjører som | En MapReduce-jobb | Kompilerer til MapReduce, Tez eller Spark jobber | Kompilerer til MapReduce, Tez eller Spark jobber |
| Best på | Full kontroll og tilpasset logikk | Flertrinns ETL-pipelines | Ad hoc-spørringer og rapportering |
I praksis er delingen enkel. Bruk Hive når dataene allerede ser ut som en tabell og spørsmålet ser ut som SQL. Bruk Pig når inputen er rotete, når pipelinen er en kjede av transformasjoner i stedet for en enkelt spørring, eller når det samme skriptet må forgrene seg og kobles sammen på nytt. Bruk MapReduce bare når ingen av abs ser ut.tracsjon kan uttrykke logikken, fordi linjeantall vokser raskt.
Grisen sitter også komfortabelt ved siden av resten av økosystemet. Sqoop og Flume land rådataene, Pig eller Hive former dem, og en planlegger som Apache Oozie kjeder trinnene sammen til en repeterbar rørledning. For et bredere bilde av hvor disse verktøyene passer inn, se veiledningen til store data og oppsummeringen av big data-verktøy; for et kommersielt ETL-alternativ til håndskrevne skript, se Talent.
